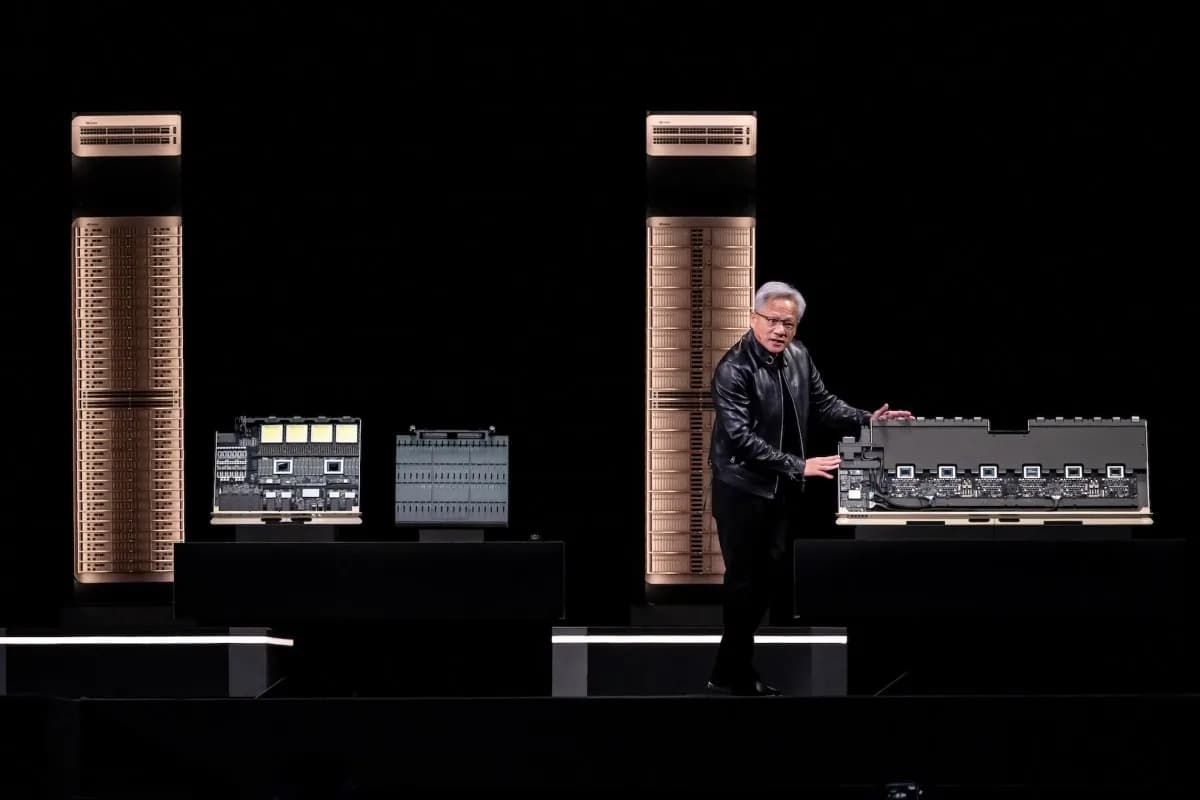
Ian Buck, vicepresidente de computación a hiperescala y de alto rendimiento de NVIDIA, habló el martes 15 de septiembre sobre eficiencia de las fábricas de IA en el AI Infra Summit, el encuentro del Centro de Convenciones de Santa Clara. La convocatoria pasó de 3.500 asistentes el año pasado a más de 8.000 este año.
La métrica con la que se mide la infraestructura de IA se está corriendo desde el rendimiento máximo hacia los tokens agénticos validados por megavatio. Es un cambio de foco que obliga a diseñar la fábrica completa en conjunto, desde el silicio hasta la red eléctrica.
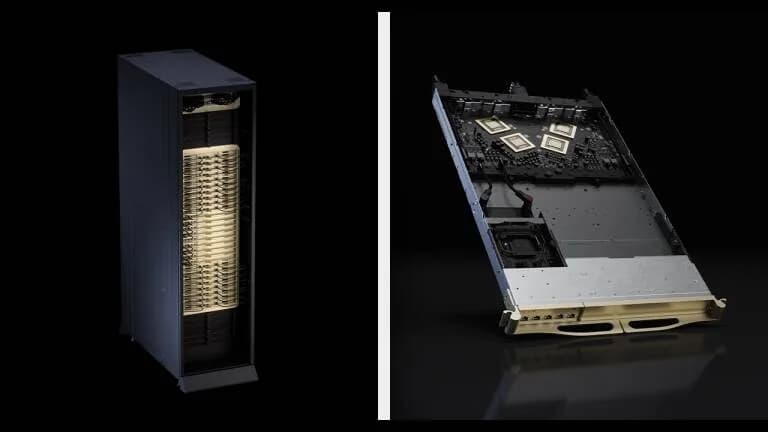
NVIDIA responde a eso con una plataforma de pila completa que abarca los sistemas Vera Rubin, el software de inferencia Dynamo, las bibliotecas NeMo y su propio equipamiento de red. Ahí entran NVLink para la computación escalada hacia arriba, Ethernet Spectrum-X y las SuperNIC ConnectX para conectar miles de nodos, y las DPU BlueField tanto para el almacenamiento de memoria de contexto como para la seguridad de la infraestructura.
Buck aprovechó la charla para anunciar colaboraciones nuevas. Annapurna Labs, de Amazon, está trabajando con NVIDIA en la tecnología de memoria de alto ancho de banda a medida NVHBM. La empresa d-Matrix, por su parte, está integrando la plataforma NVLink Fusion con sus XPU Raptor. Pinterest usa la plataforma Blackwell y el software Dynamo para llevar IA conversacional a su buscador visual.
¿Qué midió Lambda con DSX MaxLPS?
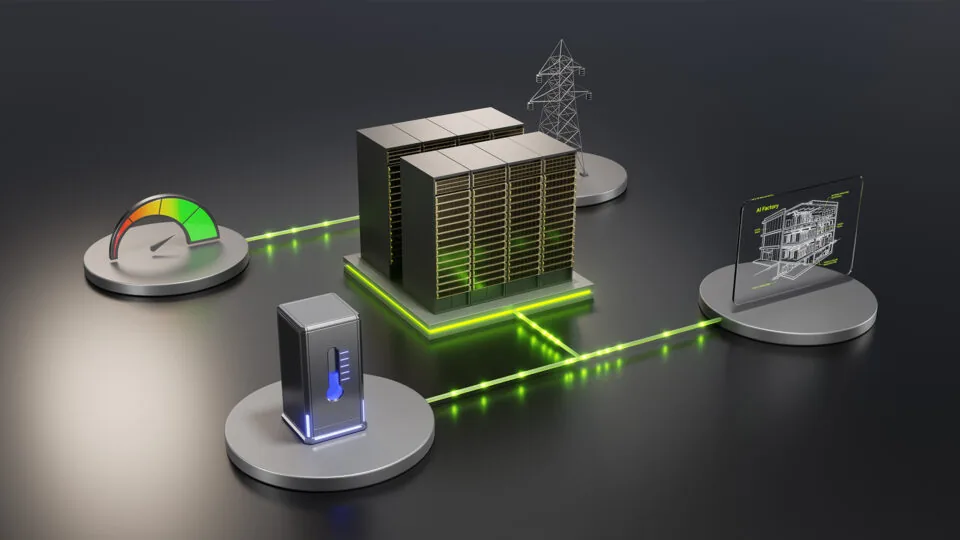
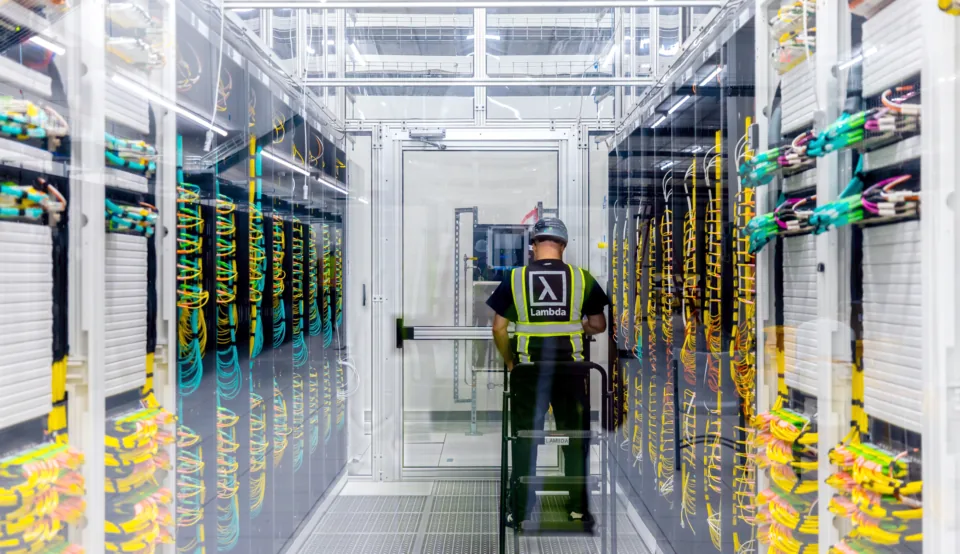
El proveedor de nube para IA Lambda publicó en el mismo evento la primera validación de NVIDIA DSX MaxLPS sobre servidores Blackwell. DSX MaxLPS vigila de forma continua el consumo eléctrico de las GPU y de los racks, mueve la potencia disponible hacia donde hace más falta y recupera la capacidad que el aprovisionamiento estático deja sin usar. Como las cargas de entrenamiento y las de inferencia tienen perfiles de consumo distintos, el software reparte la potencia entre unas y otras.
Los números que entregó Lambda son concretos. La empresa corrió 19 nodos dentro del presupuesto eléctrico que normalmente se asigna a 16 nodos a plena potencia. Con eso subió el rendimiento de tokens de todo el clúster un 24%, de unos 4 millones a unos 5 millones de tokens por segundo, y mejoró el rendimiento por watt un 23%.
Para las fábricas de IA de próxima generación construidas sobre Vera Rubin NVL72, NVIDIA sostiene que DSX MaxLPS puede habilitar hasta un 40% más de capacidad de GPU dentro del mismo presupuesto de megavatios, en los entornos de despliegue adecuados. A nivel de fábrica completa, la compañía cifra la ganancia de la optimización eléctrica en hasta 1,4 veces más tokens por megavatio.
Una fábrica de IA que le devuelve potencia a la red
Silicon Valley Power opera un programa de interconexión de carga flexible que permite a una fábrica de IA acompañar las necesidades de la red eléctrica. A través de ese programa, Emerald AI trabajó con NVIDIA para demostrar una reducción automática de consumo. El sistema respondió a cientos de señales de demanda de Silicon Valley Power sin sacrificar el rendimiento de las cargas de IA.
Emerald AI planea usar NVIDIA DSX Flex para Conductor, su software de gestión de energía que ajusta el consumo de una fábrica de IA según las señales de la red eléctrica en tiempo real y según las fuentes híbridas de energía disponibles.
DSX Flex recibe pedidos de desconexión de carga, eventos de respuesta a la demanda y señales de precio, y actúa dentro de una jerarquía de cargas definida de antemano. Los trabajos más críticos siguen corriendo. El resto se pausa un rato y después se reanuda.
Vera Rubin y el Groq 3 LPX
Dentro de cada rack, el software Intelligent Power Smoothing y un almacenamiento de energía ampliado absorben los peaks cortos de consumo, lo que deja a los sistemas trabajando más cerca de la demanda sostenida. El margen que quedaba varado pasa a ser cómputo productivo.
Para las cargas agénticas, donde los agentes encadenan pasos de razonamiento y llamadas a herramientas, la latencia y el largo del contexto se acumulan rápido. Ahí entra NVIDIA Groq 3 LPX, que agrega inferencia determinista de latencia muy baja a Vera Rubin y complementa a DSX MaxLPS. La plataforma combinada entrega hasta 35 veces más tokens por megavatio que un GB200 NVL72, en modelos de más de 2 billones de parámetros con contexto largo.
Una cifra sirve de referencia concreta. Sobre una carga de Qwen 3.8 27B con contexto de 100K, el Groq 3 LPX alcanzó 2.529 tokens de salida por segundo y por usuario.
¿Qué mide el banco de pruebas AgentX?
SemiAnalysis AgentX mide inferencia sobre sesiones reales de programación agéntica que fueron grabadas, conservando el crecimiento del contexto, la demora de las llamadas a herramientas y la creación de subagentes, en lugar de medir peticiones sueltas. Los resultados de Vera Rubin NVL72 ya están publicados en el panel de SemiAnalysis AgentX.
Sobre el modelo DeepSeek V4 Pro, Vera Rubin NVL72 entrega hasta 30 veces más rendimiento por megavatio que un NVIDIA GB300 NVL72. Los mismos resultados de AgentX muestran un costo por millón de tokens hasta 45 veces menor.
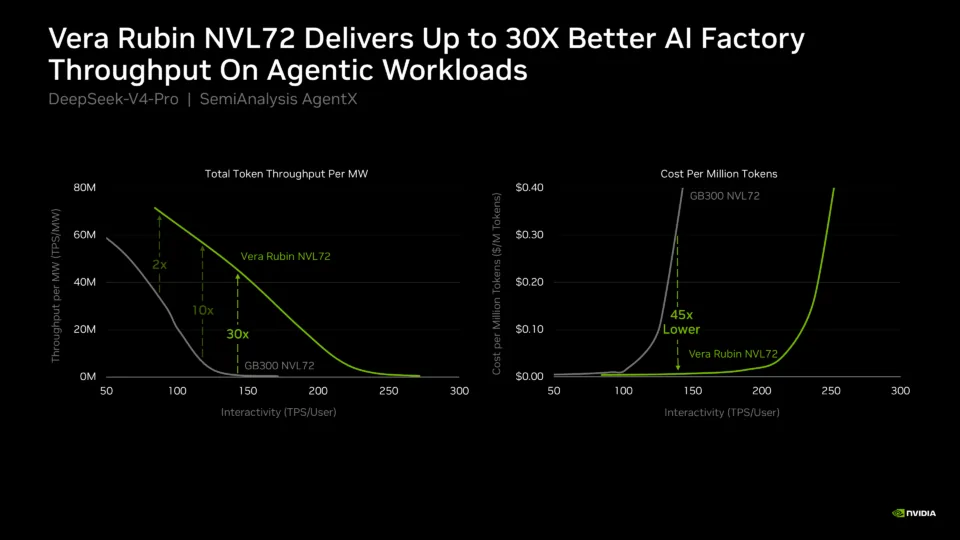
La forma de una carga agéntica se aparta de las tareas de petición y respuesta que los bancos de pruebas de inferencia venían midiendo. Una sola sesión puede acumular cientos de miles de tokens de entrada mientras el agente razona, llama herramientas y crea subagentes, cerca de 15 veces el volumen de tokens de una consulta de chat simple, con variaciones amplias de largo entre una petición y otra. Capturar eso de punta a punta exige un banco construido alrededor de trayectorias completas de agente. AgentX hace eso y complementa a las suites estandarizadas como MLPerf Inference, que miden rendimiento por petición sobre un abanico amplio de modelos y escenarios.
Según NVIDIA, ese rendimiento sale de un diseño conjunto que incluye el dominio de escalado del NVL72, la sexta generación de la interconexión NVLink, la precisión NVFP4 sobre los Tensor Core de quinta generación y una pila de inferencia formada por TensorRT LLM y Dynamo. Vera Rubin está en producción plena y escalando a través del ecosistema.