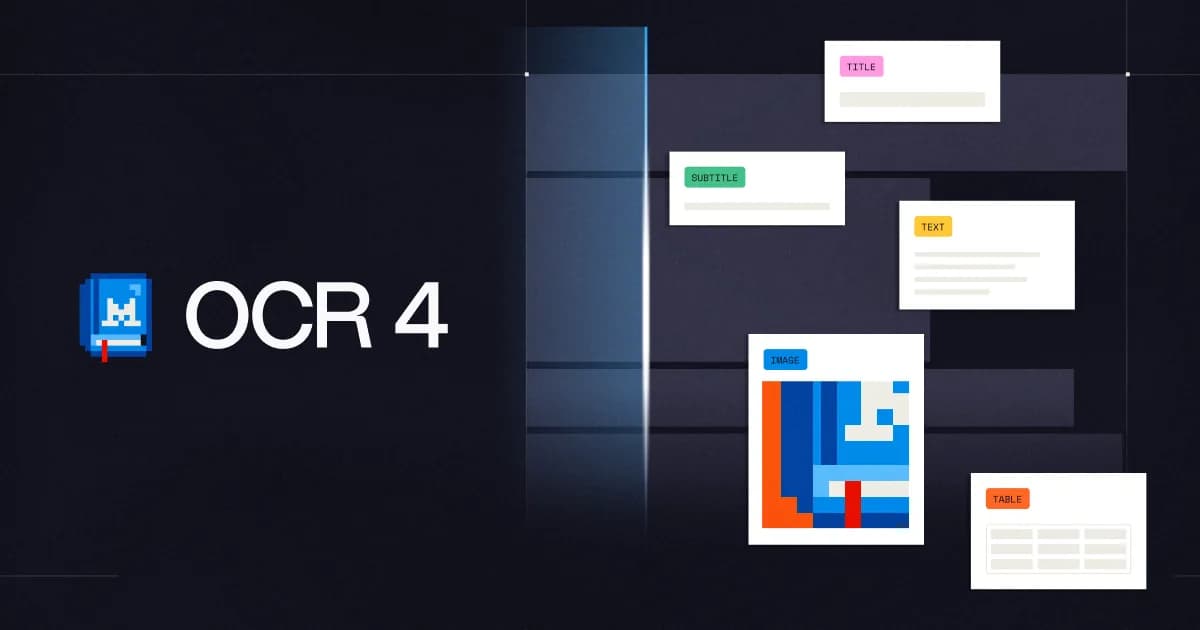
Mistral liberó OCR 4, un modelo de lectura de documentos que junto al texto extraído devuelve cajas delimitadoras, clasificación de bloques por tipo y puntajes de confianza en línea. Cubre 170 idiomas repartidos en 10 grupos lingüísticos, corre en un solo contenedor para despliegues propios y funciona como componente de ingesta para búsqueda empresarial y tuberías de recuperación aumentada.
¿Qué cambia frente a las versiones anteriores?
Las generaciones previas apuntaban a convertir una página en texto limpio y tablas. OCR 4 devuelve una representación estructurada del documento completo. Cada bloque queda localizado con una caja delimitadora, clasificado por tipo, y con puntajes de confianza generados por página y por palabra.
Los tipos de bloque que reconoce incluyen títulos, tablas, ecuaciones y firmas, entre otros. Con eso, los sistemas que vienen después no solo tienen acceso a lo que dice el documento. También saben dónde está cada elemento, qué papel cumple y cuánta confianza tiene el modelo en esa región.
Mistral señala que las cajas delimitadoras eran la capacidad más pedida por sus usuarios, porque permiten resaltar texto en contexto y armar tuberías de datos más confiables. Los tipos de bloque y los puntajes de confianza, por su parte, habilitan citas ancladas a la fuente, tachados y verificación con humano en el circuito.
Esa estructura sostiene tres cargas de trabajo distintas.
- Segmentación semántica para RAG, donde los bloques limpios y clasificados funcionan como mejores unidades de recuperación
- Primitivas estructurales para agentes, que pasan de leer documentos a operar sobre ellos en llenado de formularios, procesamiento de facturas y chequeos de cumplimiento
- Contenido estructurado para conectores, con salida tipada y consistente para tuberías de ingesta e indexación
El modelo acepta los formatos habituales de empresa, entre ellos PDF, DOC, PPT y OpenDocument. Al ser compacto y desplegable en un solo contenedor, sirve tanto para despliegues sensibles al costo como de alto volumen, y puede correr completamente autoalojado para organizaciones con requisitos de soberanía de datos.
OCR 4 también quedó integrado como componente de ingesta del Search Toolkit, el marco de búsqueda componible y de código abierto que Mistral anunció en el AI Now Summit y que hoy está en vista previa pública.
Los números, con la advertencia de la propia Mistral
Mistral comparó OCR 4 contra modelos de lectura nativos de inteligencia artificial, modelos generalistas de frontera, servicios documentales empresariales y su propio Mistral OCR 3.
Para la evaluación humana armó un conjunto de más de 600 documentos en más de 12 idiomas, conseguidos con proveedores externos para representar casos de uso reales de la industria, y pidió a anotadores independientes que rankearan a ciegas la salida de cada competidor contra la de OCR 4, documento por documento. Los anotadores prefirieron a OCR 4 en la mayoría de los documentos de todos los sistemas probados, con tasas de victoria que promedian el 72%.
_nInzA.webp?dpl=6aad049eaf4c2d00095b91e5>)
En los bancos de prueba automáticos, OCR 4 obtiene el mejor puntaje general entre los modelos evaluados en el público OlmOCRBench (85,20) y encabeza la evaluación interna Crawl Multilingual con 0,98. En OmniDocBench alcanza 93,07.
_ZrJw6x.webp?dpl=6aad049eaf4c2d00095b91e5>)
Esa última cifra viene con una advertencia que pone la propia empresa. Tanto OlmOCRBench como OmniDocBench tienen limitaciones conocidas en cómo puntúan ciertas salidas, y un único número agregado puede tanto subestimar como sobrestimar el rendimiento real.
Cuando Mistral auditó los desajustes detrás de sus puntajes, la mayoría no eran errores del modelo sino artefactos de cómo los bancos de prueba comparan la salida. Las categorías que se repiten son cinco.
- Errores en la verdad de referencia. Algunas anotaciones de referencia están mal. Texto faltante o de más, transcripciones de regiones tachadas, o erratas. El ejemplo que dan es el nombre de un autor citado, mal escrito en la referencia y leído correctamente por el modelo desde la página. La salida coincide con el documento fuente y se marca igual como incorrecta.
- Notación matemática equivalente. LaTeX distinto que se renderiza idéntico se cuenta como desajuste. La ecuación renderizada está bien, la comparación de cadenas no.
- Segmentación de ecuaciones. Que una expresión se emita como una sola ecuación o partida en varios fragmentos en línea afecta la coincidencia, aunque el contenido renderizado sea idéntico, porque el comparador no puede alinear las piezas.
- Orden de lectura en varias columnas. Palabras cortadas en el borde de una columna, como "certifi-cados", y los supuestos de ordenamiento de columnas hacen que extracciones correctas se puntúen como fallas de orden de lectura.
- Atribución de tipo de bloque. El banco de prueba no espera encabezados ni pies de página en la salida. Mistral los quita antes de puntuar, y entonces el test busca una cadena que además resulta ser el título de la página, que sí debería estar presente, y la marca mal.
Estos artefactos se concentran en documentos matemáticos, científicos y a varias columnas, y penalizan más seguido una salida correcta de lo que premian una incorrecta. Por eso la empresa trata el puntaje agregado como direccional y no como definitivo. Agrega además que todos los puntajes de los competidores corresponden a reproducciones internas, y recomienda evaluar sobre los documentos propios.
Dos clientes citados en el anuncio aportan sus propias mediciones.
"Comparamos Mistral OCR 4 contra los principales analizadores documentales agénticos sobre un conjunto de preguntas y respuestas financieras denso en gráficos y figuras, y alcanzamos una precisión equivalente a aproximadamente 8 veces menos costo y 17 veces menos latencia. Para casos de uso en producción a escala, esa diferencia se acumula rápido", dijo Aidan Donohue, ingeniero de inteligencia artificial en Rogo.
"Mistral OCR es aproximadamente 4 veces más rápido por página que nuestro proveedor anterior, un resultado impresionante para los flujos de trabajo de registro de alto volumen donde la velocidad es crítica para manejar los plazos de propiedad intelectual de nuestros clientes", dijo Ivan Mihailov, ingeniero de inteligencia artificial en Anaqua.
Dónde se abre la brecha multilingüe
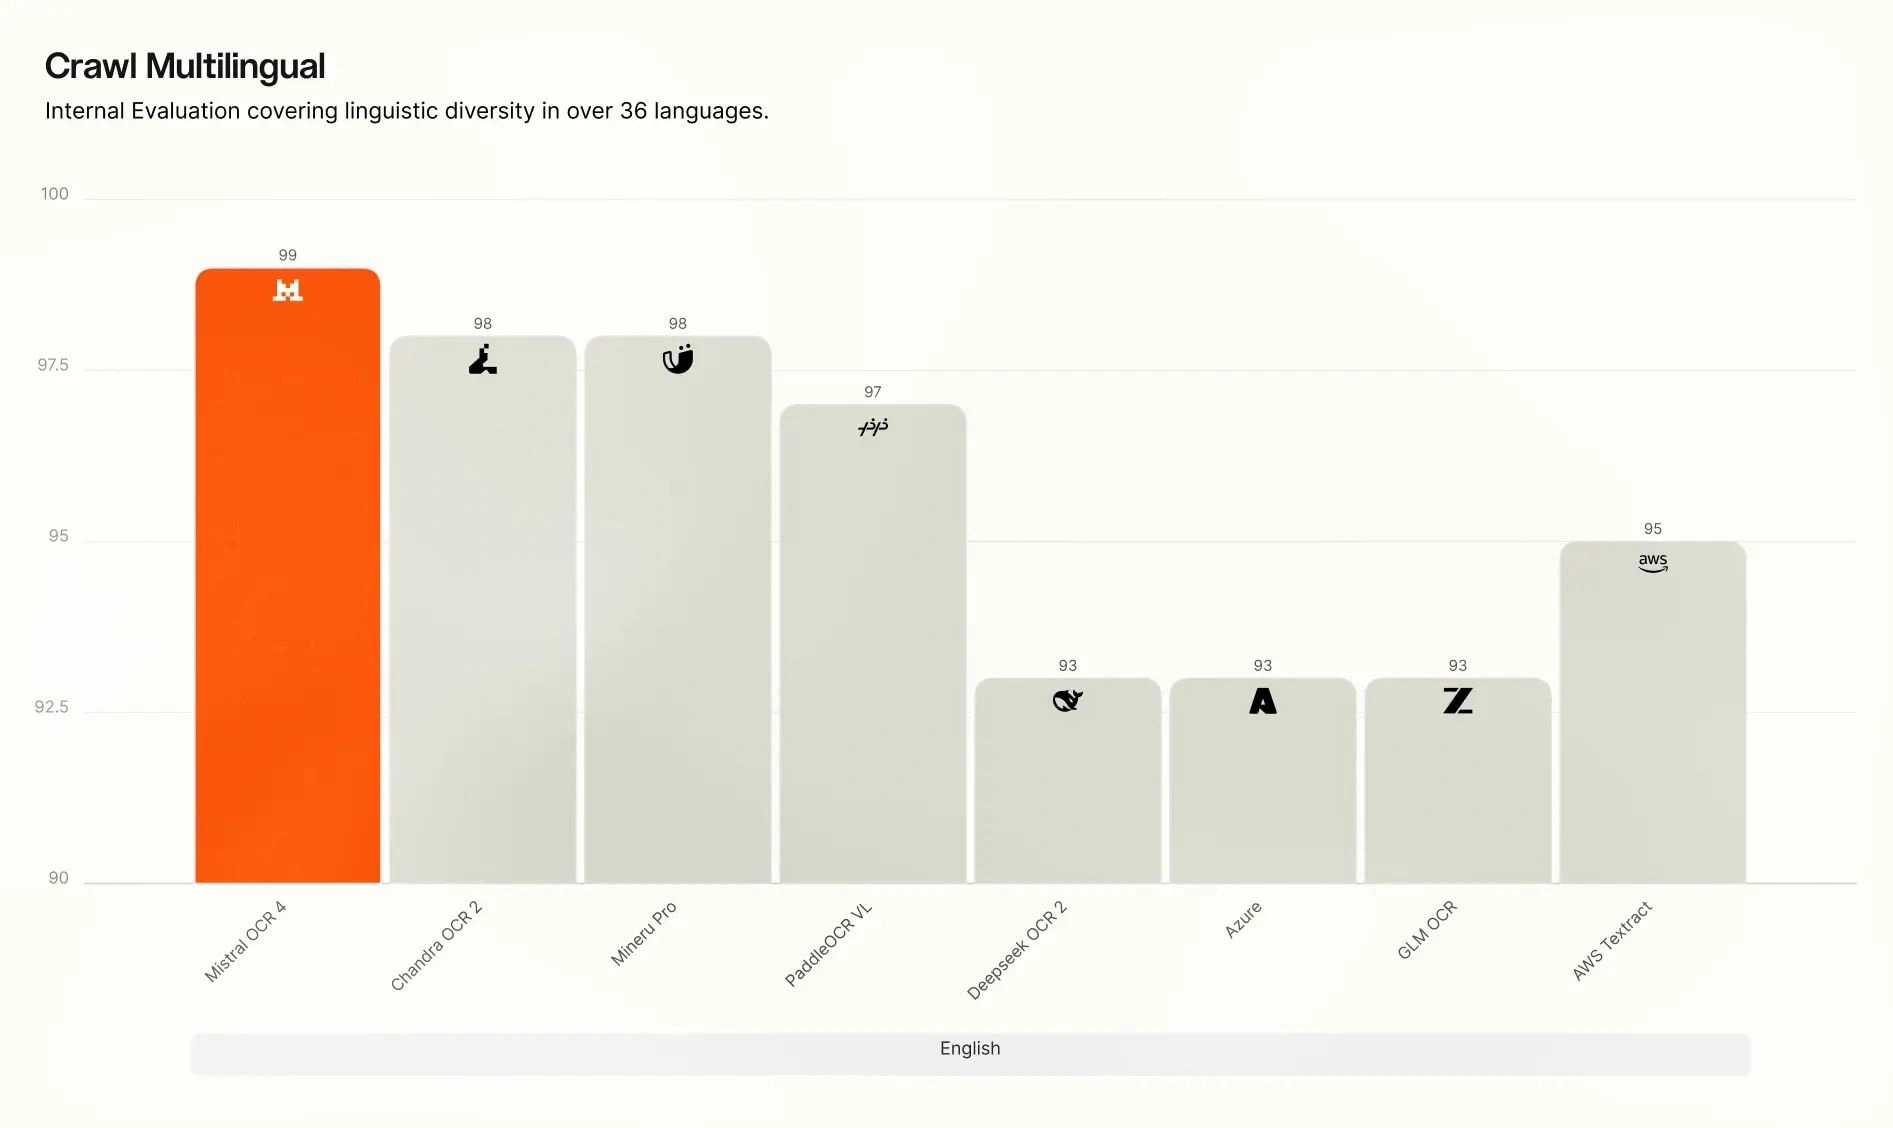
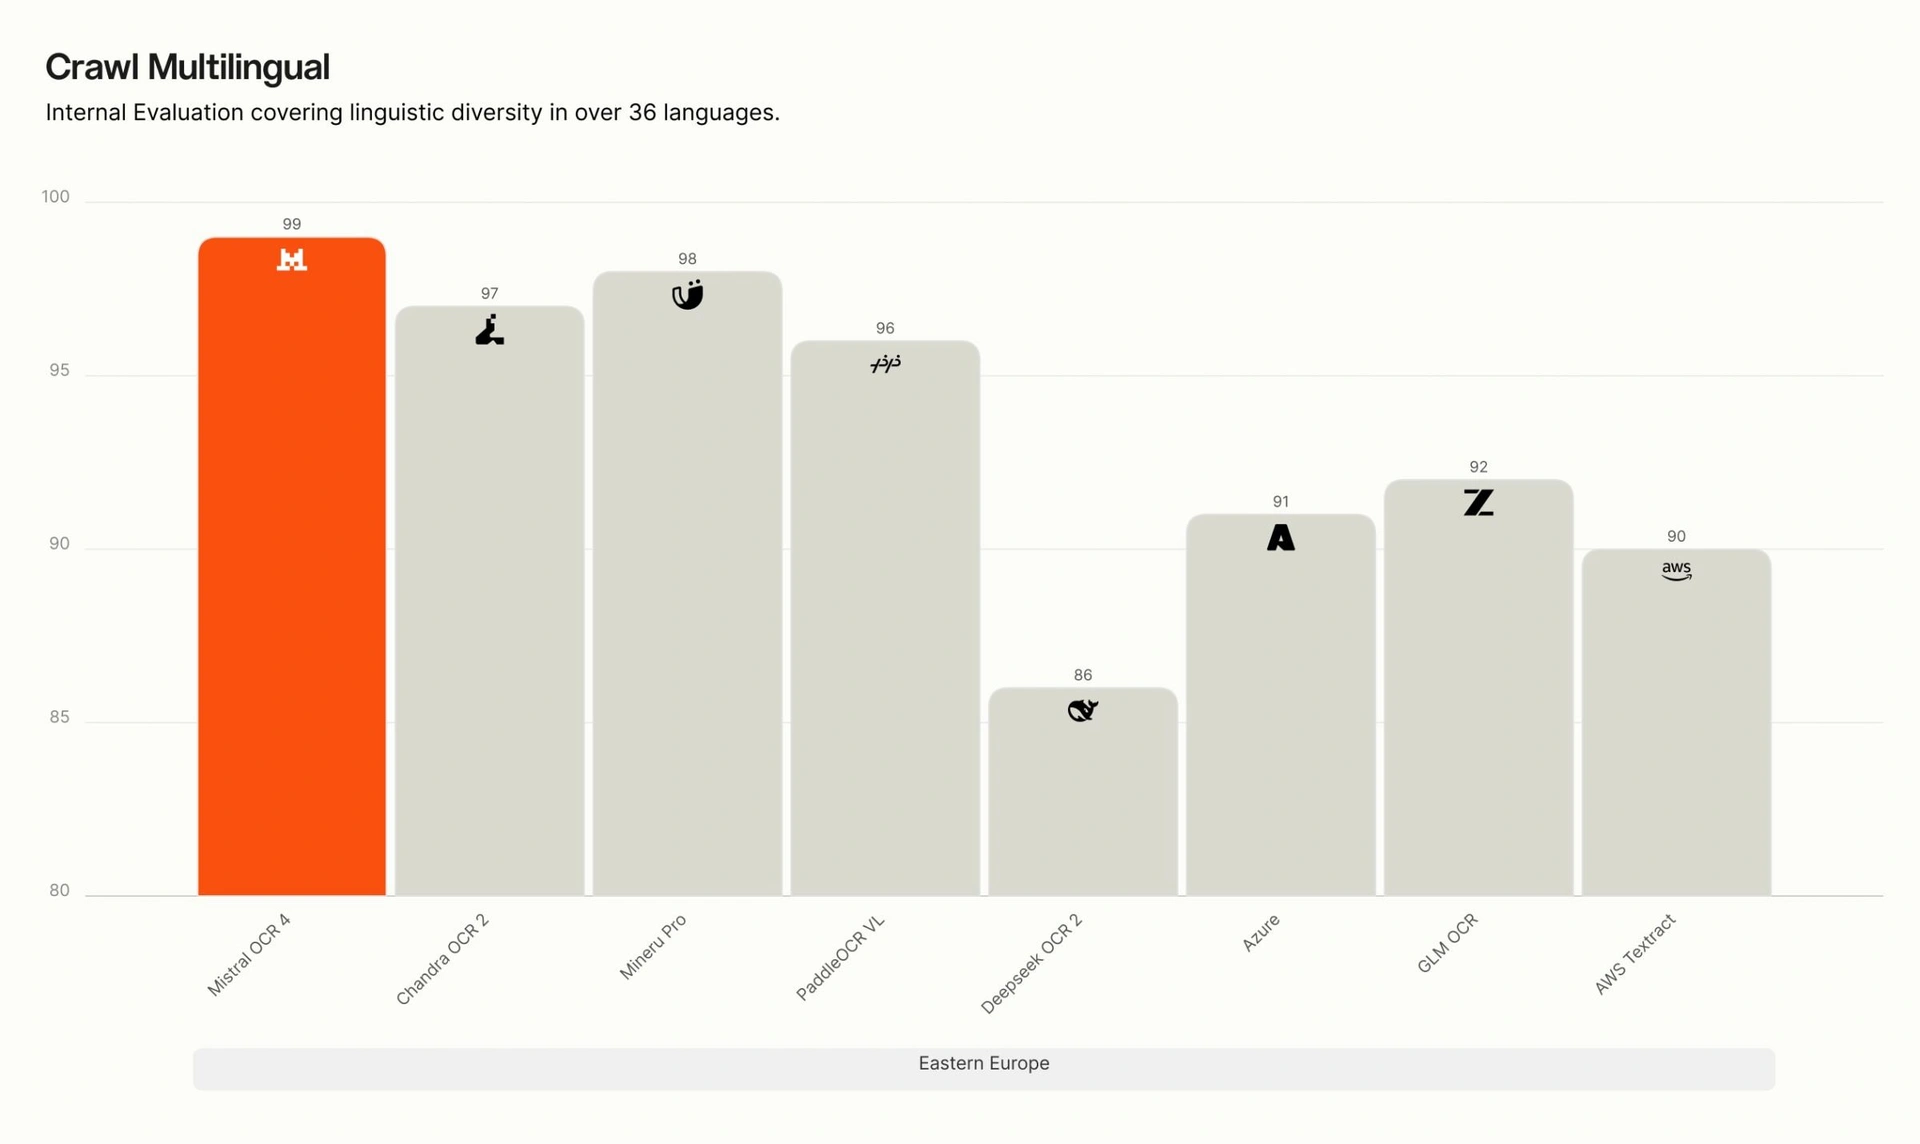
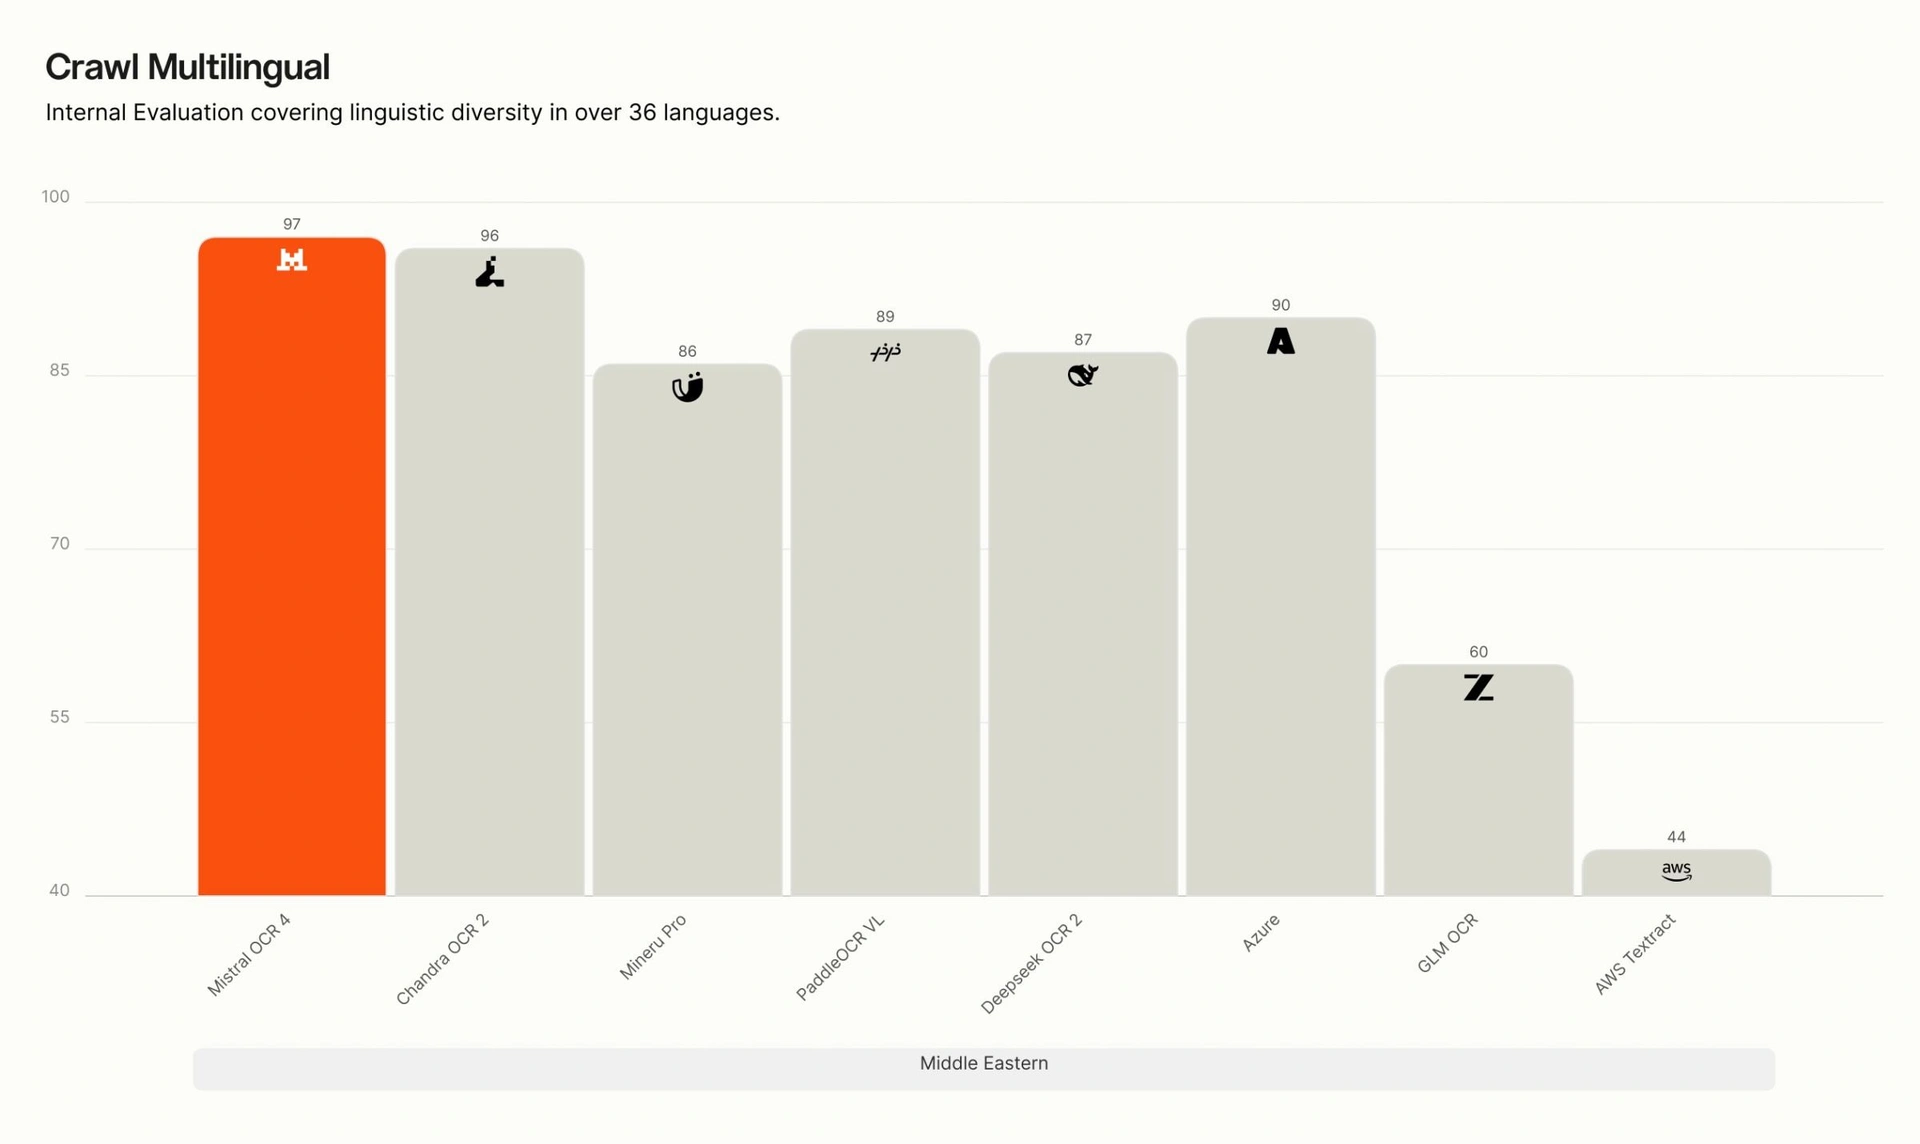
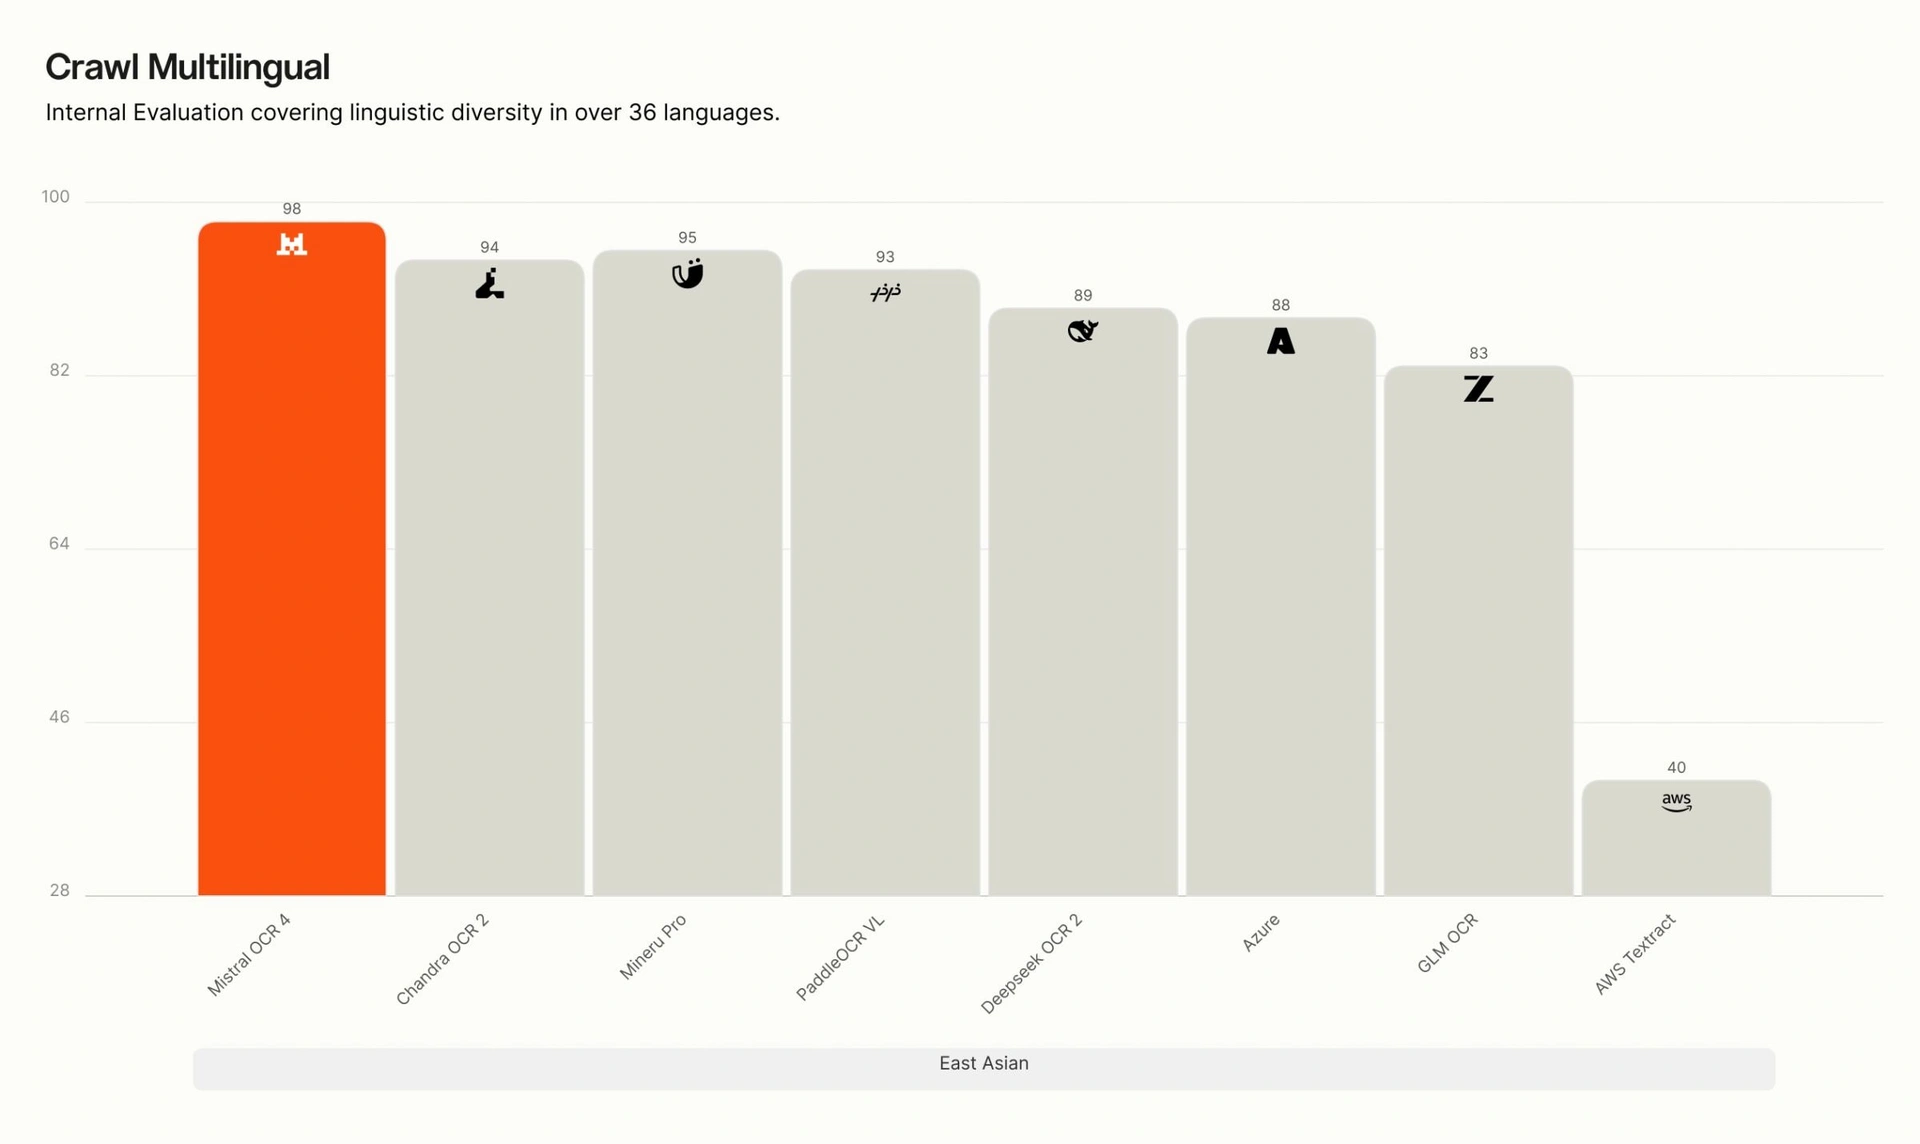
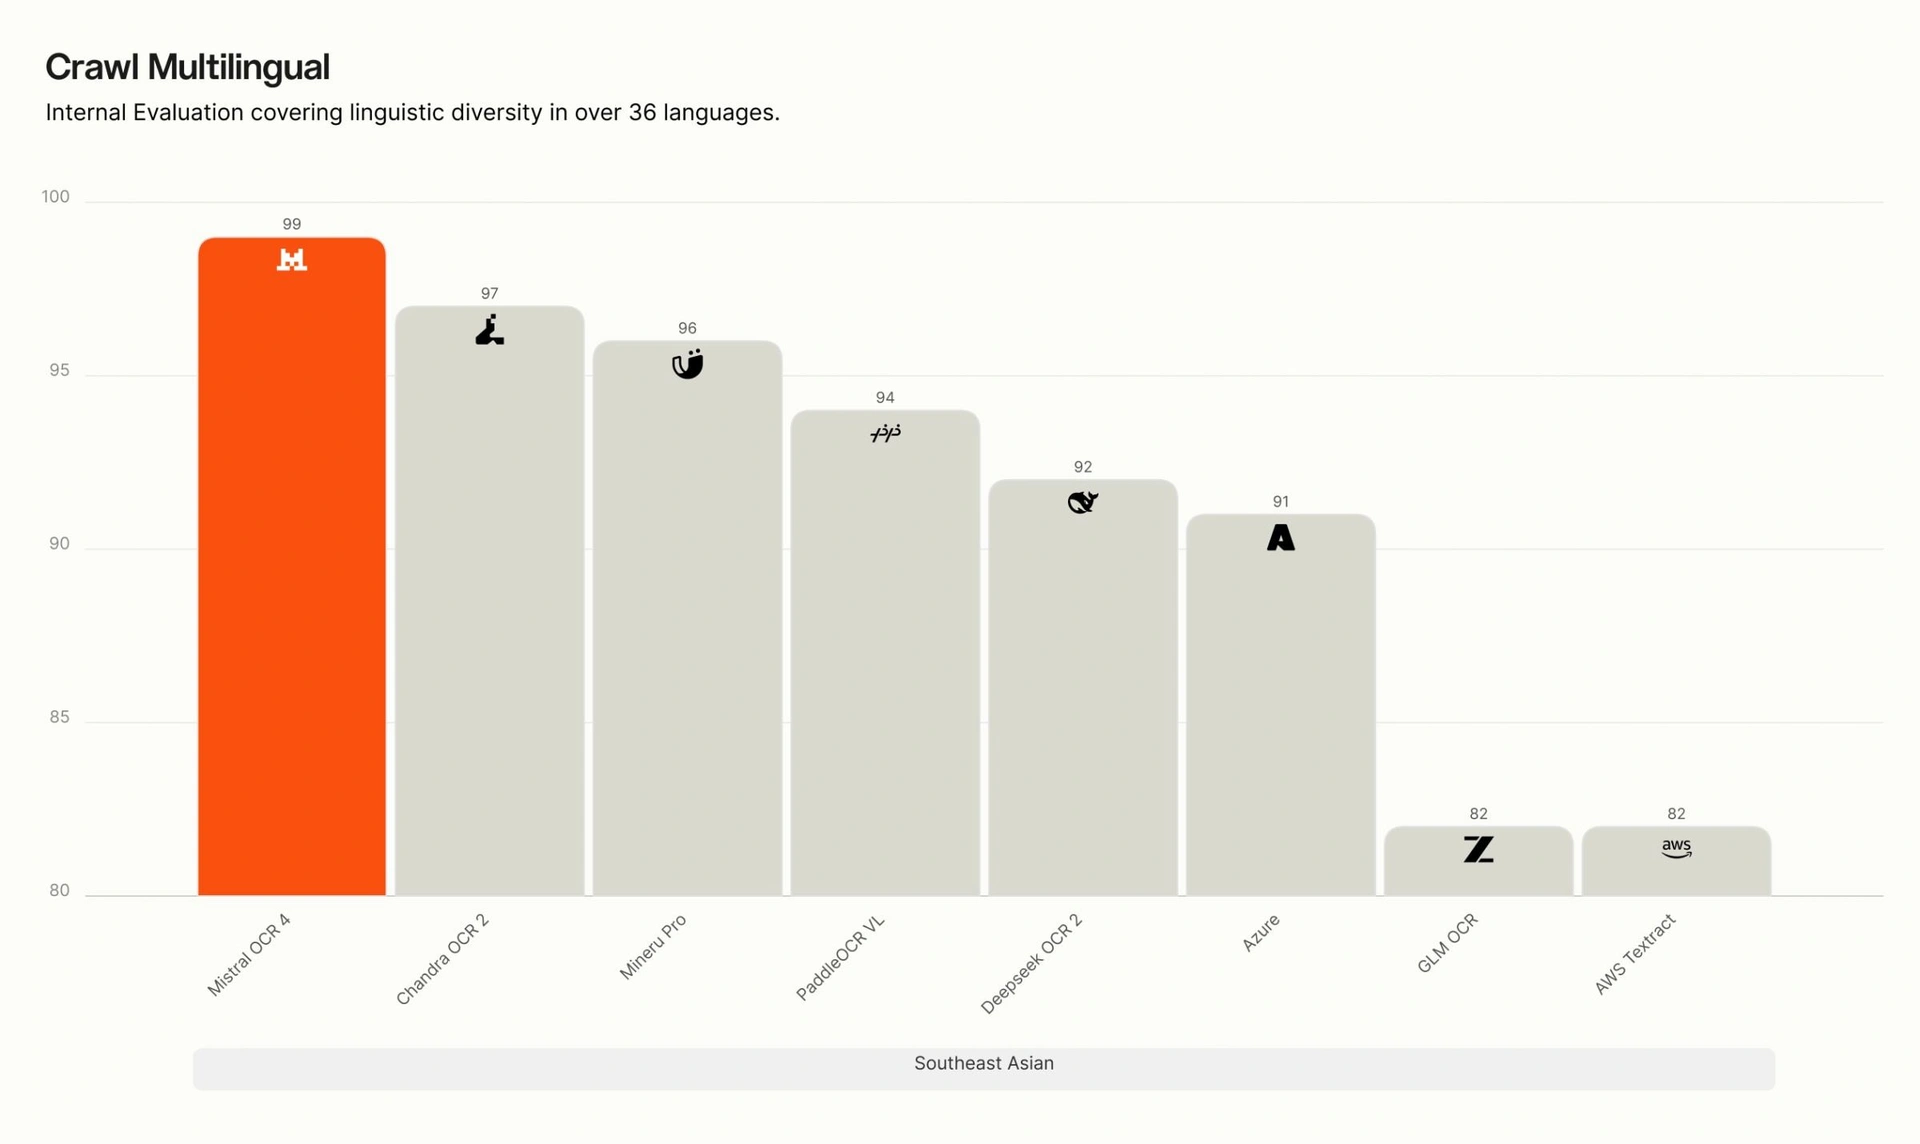
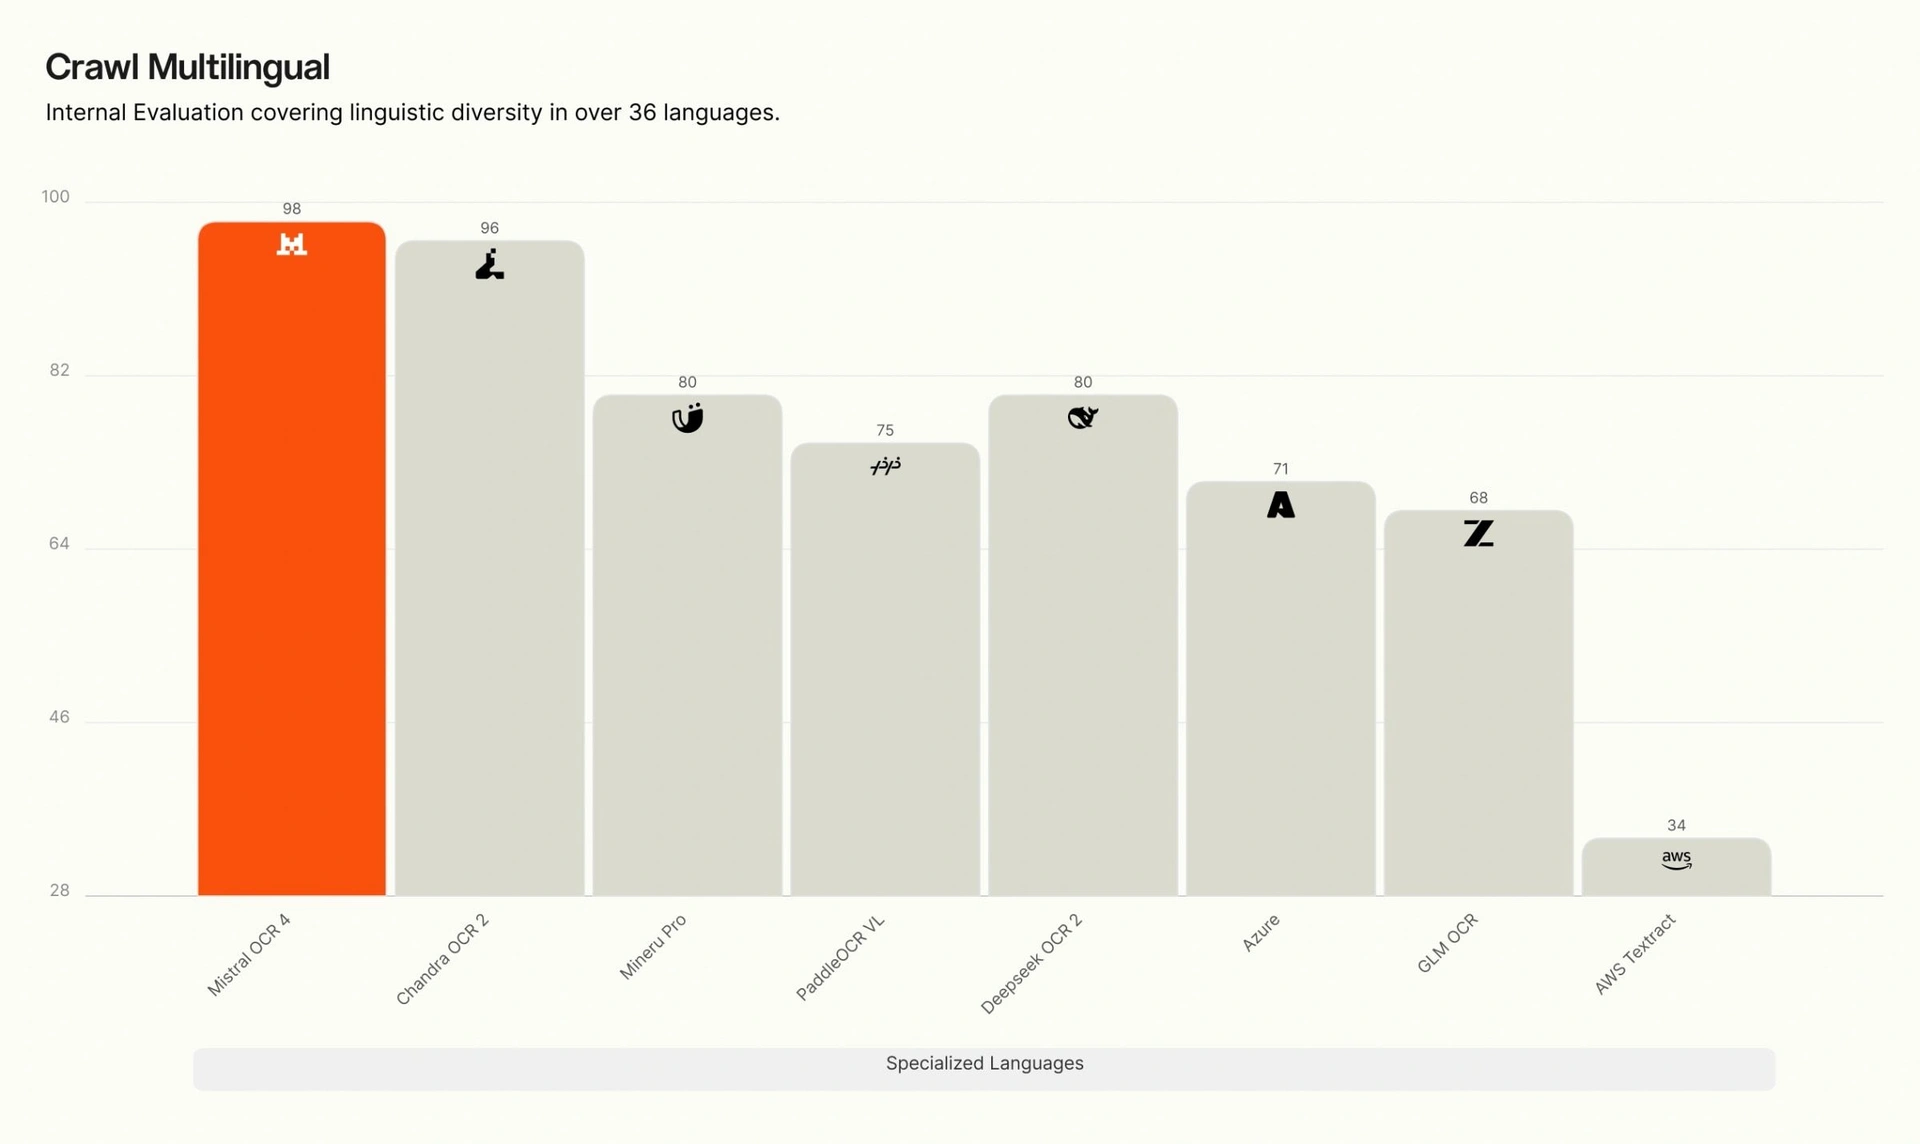
En la evaluación multilingüe interna, OCR 4 encabeza los ocho grupos de idiomas medidos. Inglés, Europa occidental, Europa oriental, Medio Oriente, chino, Asia oriental, sudeste asiático e idiomas especializados, categoría que incluye hindi, japonés, georgiano, bengalí, armenio, hebreo, griego, guyaratí, tamil, malayalam, canarés y telugu.
La brecha se abre más en los idiomas especializados y de bajos recursos, donde varios sistemas competidores se degradan con fuerza mientras OCR 4 mantiene su precisión. Mistral publicó un gráfico por grupo de idiomas.
¿Cuánto cuesta procesar mil páginas?
Los desarrolladores integran el modelo por API, y los equipos que prefieren una vía sin código pueden usar Document AI dentro de Mistral Studio, que corre el mismo motor a nivel de aplicación.
| Vía de acceso | Precio por 1.000 páginas |
|---|---|
| API de Mistral OCR 4 | 4 dólares |
| API en modo por lotes, con 50% de descuento | 2 dólares |
| Document AI en Mistral Studio | 5 dólares |
El despliegue autogestionado está disponible para clientes empresariales, y mantiene los datos del documento dentro del entorno de la organización por motivos de residencia, soberanía y cumplimiento.
Para qué sirve y para qué no
Entre los casos de uso recomendados aparecen el análisis y extracción de documentos multilingües complejos, la generación aumentada por recuperación con contenido listo para citar, los flujos agénticos de llenado de formularios y procesamiento de facturas en áreas legales, financieras y de salud, las tuberías de datos estructurados que usan los puntajes de confianza para dosificar la verificación humana, y la búsqueda empresarial con bases de conocimiento.
Los primeros usuarios lo están aplicando a convertir facturas en campos estructurados, digitalizar archivos de empresas, extraer texto limpio de informes técnicos y científicos, y alimentar buscadores internos.
La propia Mistral acota el alcance. OCR 4 es un modelo de comprensión de documentos y no un tomador de decisiones. La empresa señala que no está pensado para diagnóstico médico, asesoría o juicio legal, decisiones financieras de alto riesgo, sistemas críticos de seguridad, procesamiento en tiempo real sensible a la latencia, ni entradas que no sean documentos, como audio o video crudos.
El modelo está disponible a través de un único punto de acceso de la API. Cada solicitud corre el mismo modelo de fondo y siempre devuelve el contenido extraído, las cajas delimitadoras, los tipos de bloque, los puntajes de confianza y el texto estructurado en markdown. Lo que cambia entre modos es cuánto se le agrega encima.