
IA
Mistral OCR 4 devuelve cajas y confianza por palabra
El modelo entrega la posición de cada bloque, su tipo y un puntaje de confianza junto al texto extraído, corre en un solo contenedor y cubre 170 idiomas.
Mistral AI News
6 notas publicadas
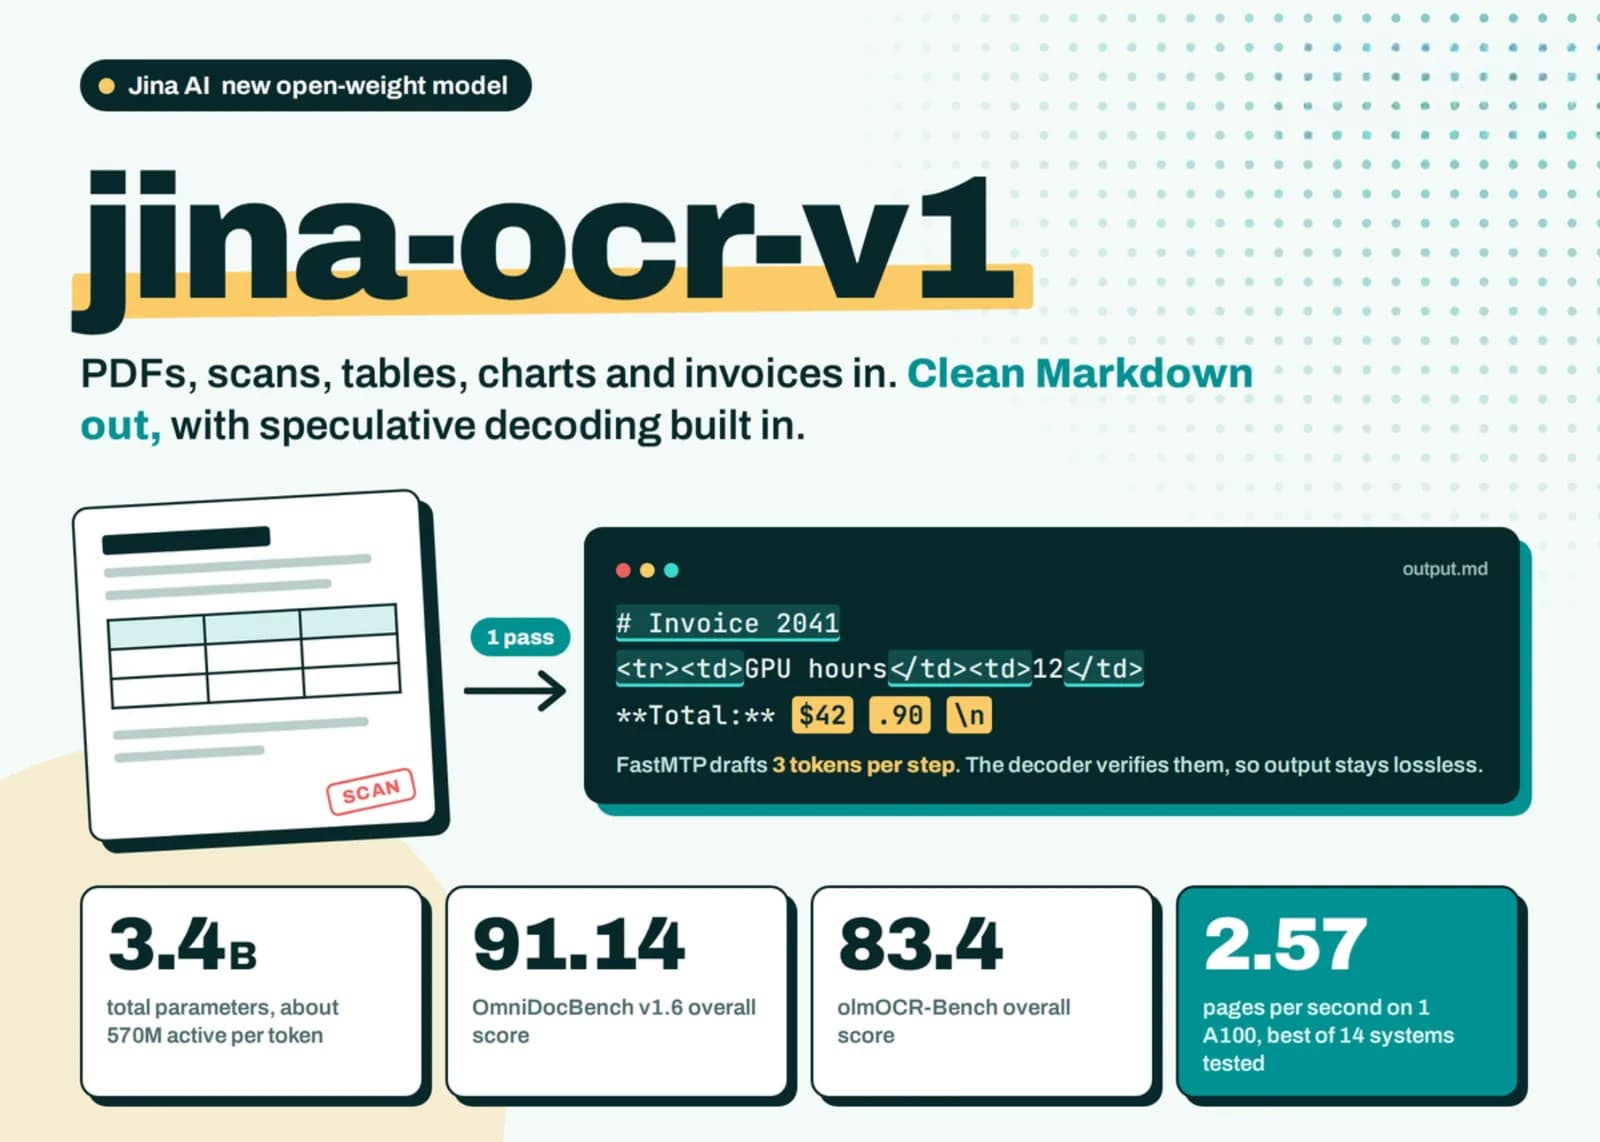
El lector de documentos tiene 3.400 millones de parámetros, activa unos 570 millones por token y trae adentro una cabeza de decodificación especulativa que casi duplica la velocidad en una NVIDIA L4.
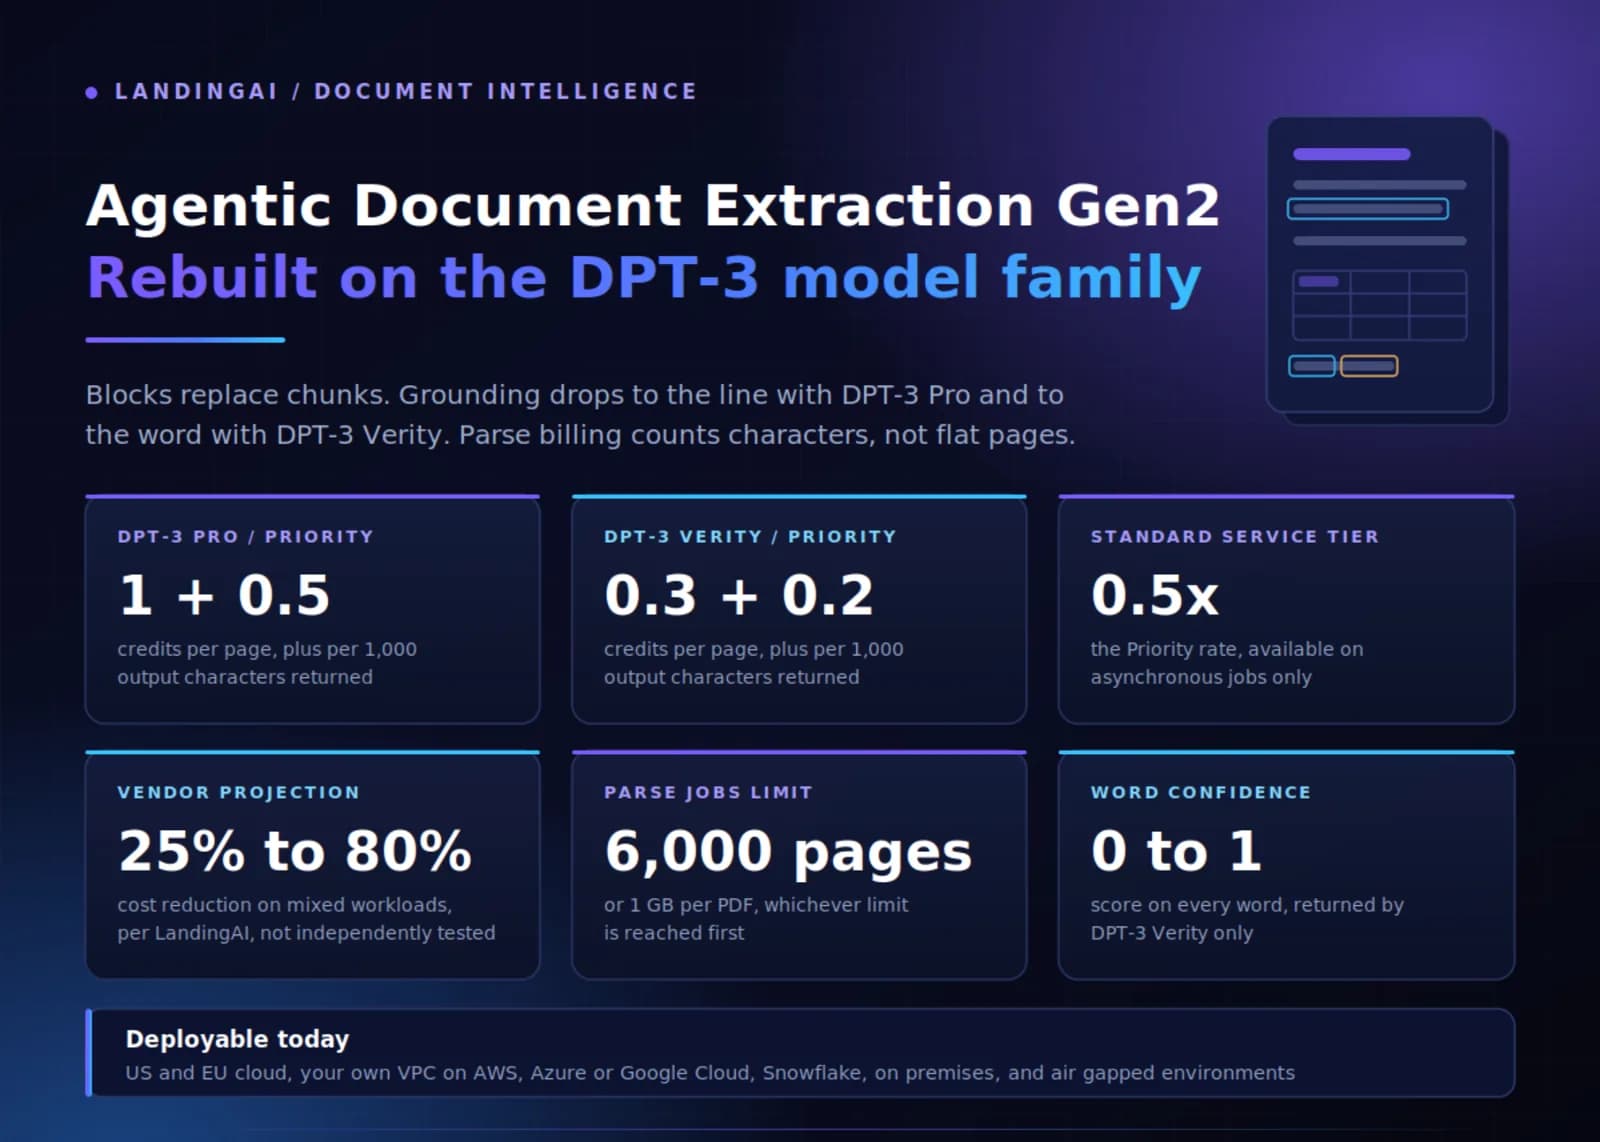
La segunda generación de Agentic Document Extraction reemplaza el cobro plano por página, abandona los fragmentos en favor de un árbol de bloques y devuelve la posición exacta de cada palabra.
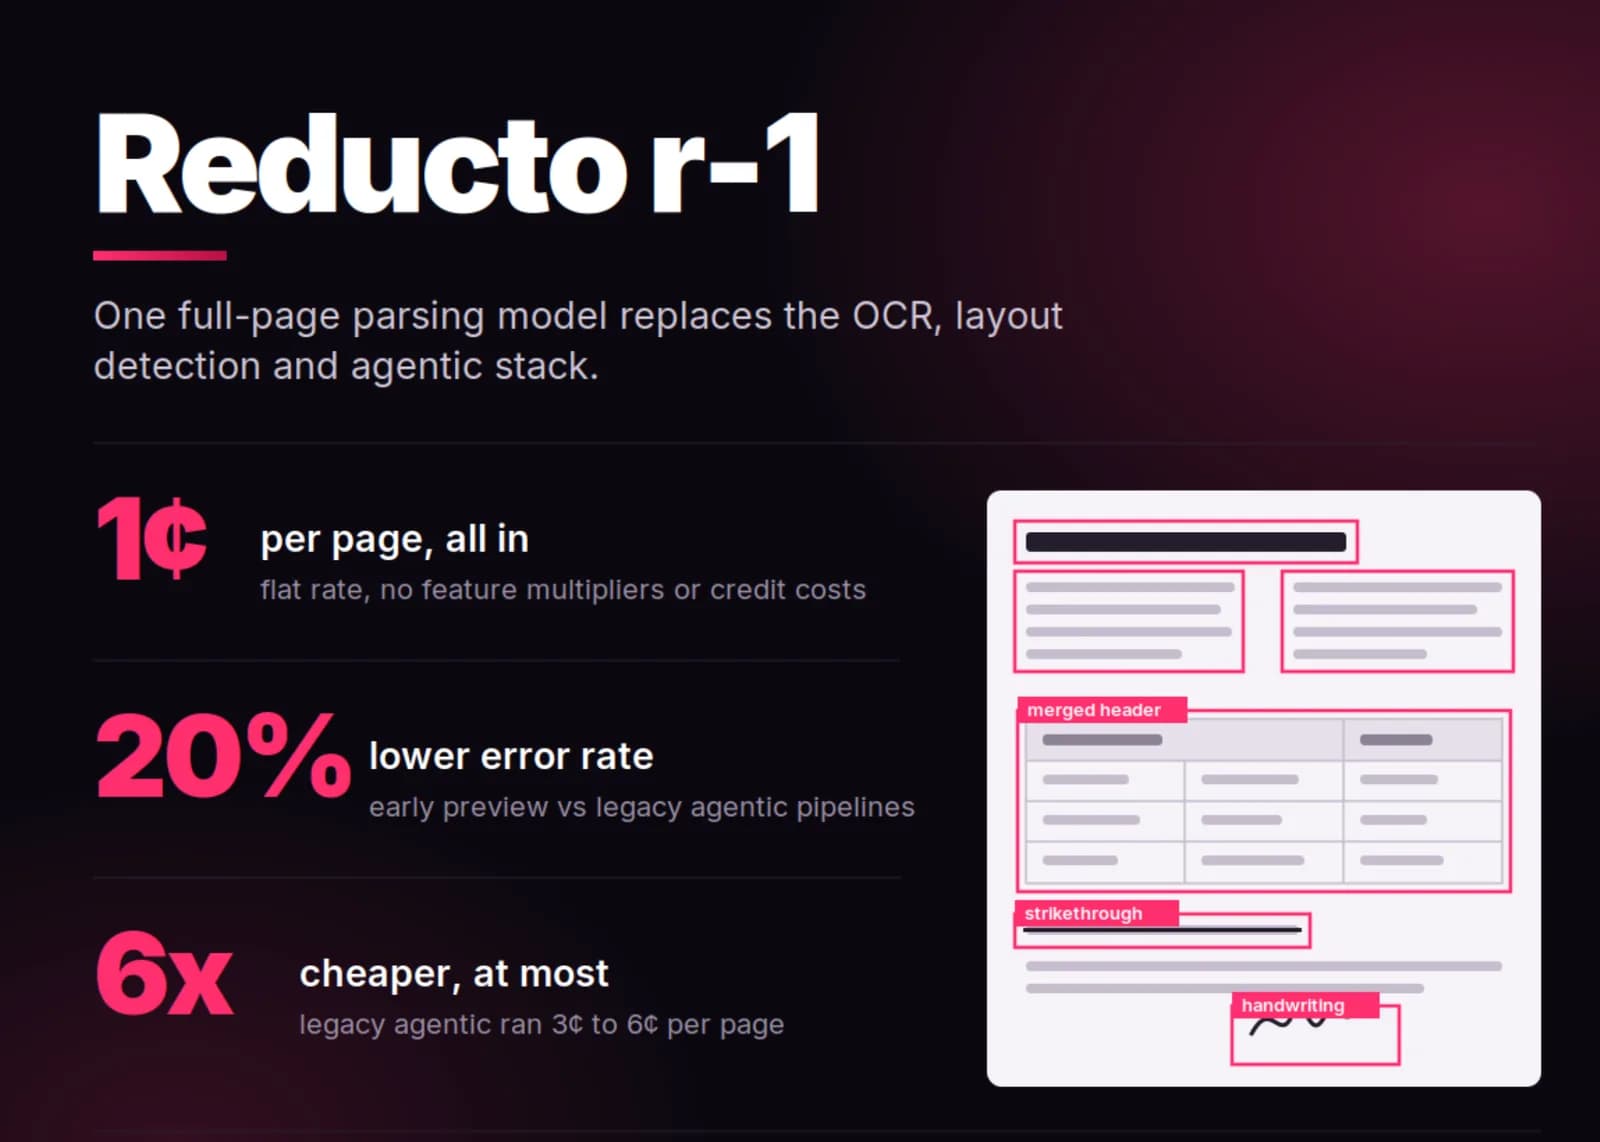
El nuevo modelo reemplaza la cadena de OCR por etapas con una sola pasada sobre la página completa, y baja el precio de entre 3 y 6 centavos a uno solo.
El modelo de visión y lenguaje de 2.300 millones de parámetros apunta a la ingesta documental masiva de empresas, con precio de 1,50 dólares cada mil páginas.
El modelo rediseña la atención (R-SWA) para mantener el KV cache constante y procesar más de 40 páginas sin degradación de memoria ni velocidad.
Otros temas que aparecen junto a #ocr en nuestra cobertura editorial.