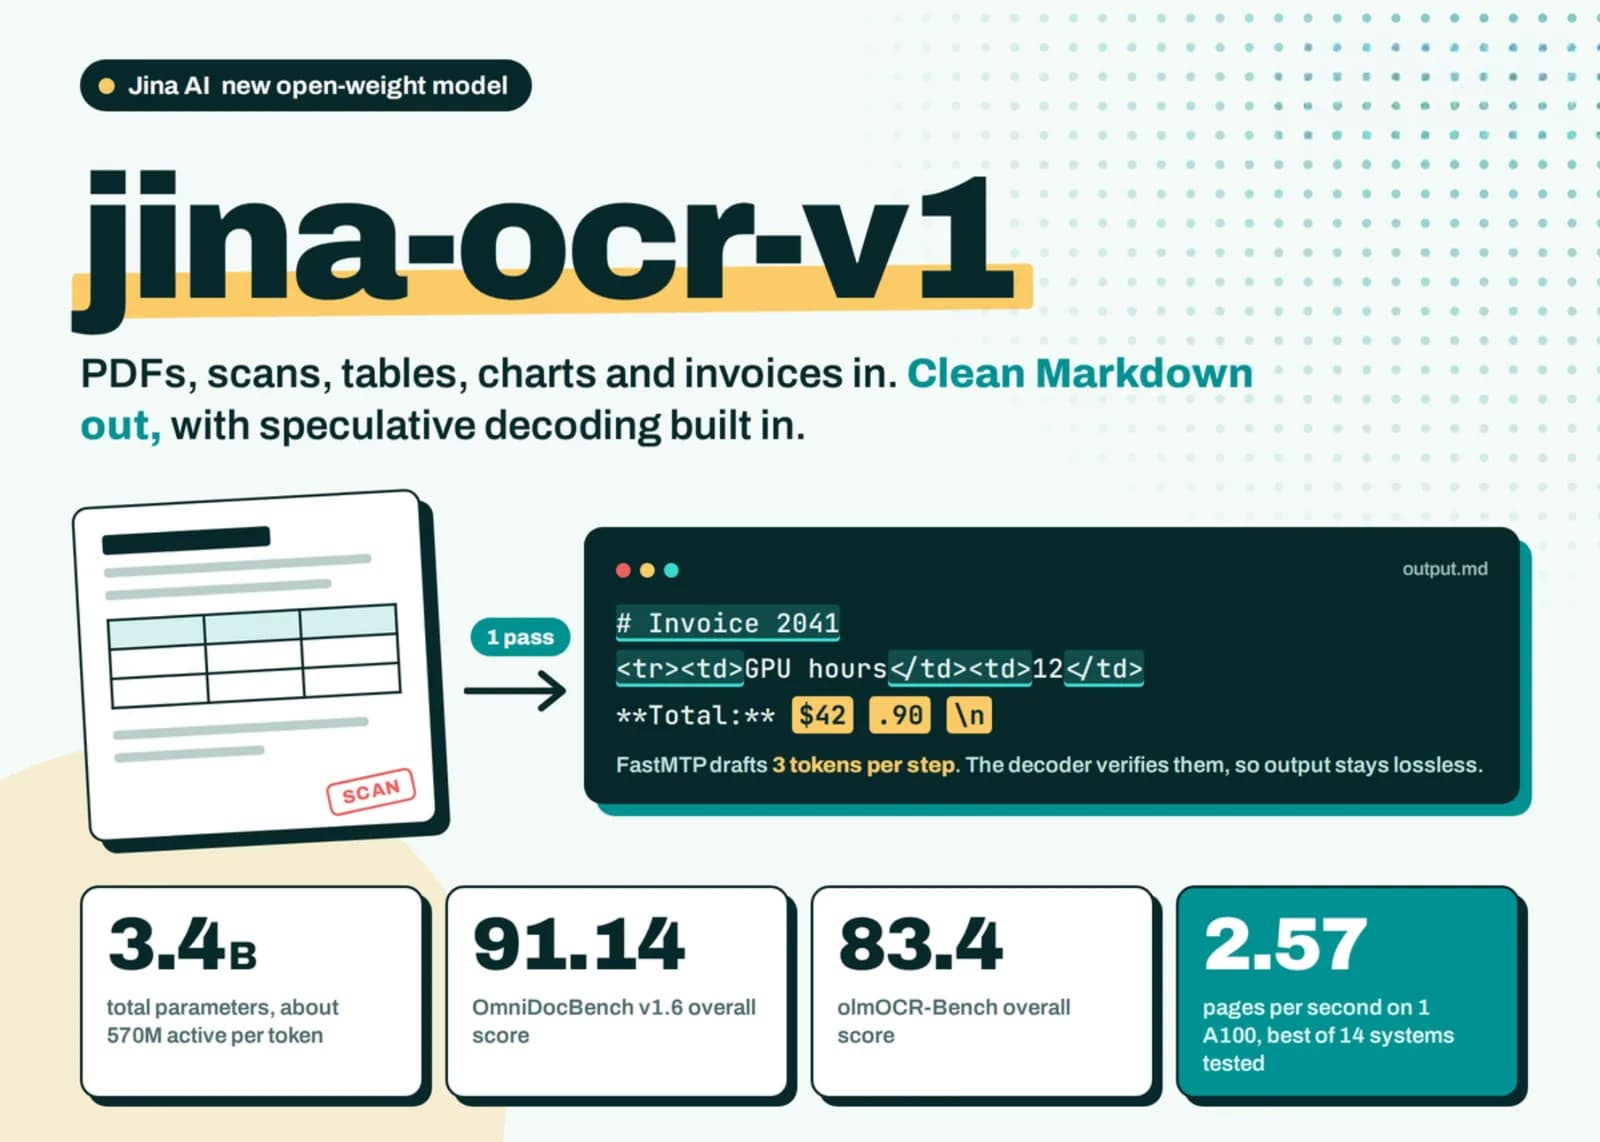
Jina AI, parte de Elastic, publicó jina-ocr-v1, un lector visual de documentos de punta a punta. Toma PDF, escaneos, tablas, gráficos o facturas y devuelve Markdown limpio en una sola pasada. El modelo suma 3.400 millones de parámetros en total, de los cuales unos 570 millones del decodificador quedan activos por token, y trae una cabeza de decodificación especulativa dentro del mismo archivo de pesos. Jina AI lo construyó para servir sobre GPU de bajo presupuesto, como la NVIDIA L4. El reporte técnico anota 91,14 en OmniDocBench v1.6 y 83,4 en olmOCR-Bench.
Se puede desplegar, aunque con un límite. Los pesos abiertos pesan cerca de 6,8 GB en BF16 y corren sobre Transformers o vLLM, pero la licencia CC BY-NC 4.0 cubre investigación y uso no comercial. Para uso comercial hay que hablar con la empresa.
¿Qué trae adentro jina-ocr-v1?
El modelo parte de un post entrenamiento sobre DeepSeek-OCR y conserva sus dos componentes de eficiencia. El primero, DeepEncoder, ronda los 380 millones de parámetros y encadena SAM, un compresor convolucional de 16 veces y CLIP-L. Con eso convierte una vista de página de 1024 por 1024 píxeles, que son 4.096 parches, en apenas 256 tokens visuales. Un modo de resolución dinámica agrega hasta 9 mosaicos locales de 100 tokens cada uno, de manera que una página nunca pasa de 1.156 tokens visuales.
El segundo es el decodificador, un DeepSeek-3B-MoE de 12 capas con 64 expertos enrutados y 2 compartidos. El enrutamiento top-6 deja activos unos 570 millones de parámetros por token. El límite de posición es de 32.768. La salida es Markdown, con las tablas en HTML y las fórmulas en LaTeX.
¿Cómo funciona la decodificación especulativa?
La salida de un OCR es casi determinista y está estructurada de manera local, así que calza bien con la decodificación especulativa. Jina AI suma una cabeza FastMTP, un bloque denso de borrador que se aplica de forma recursiva durante K igual a 3 pasos. Los parámetros del borrador se mantienen constantes a medida que crece la profundidad.
Después el decodificador verifica esos borradores de manera voraz. Acepta el prefijo más largo que coincide con sus propias elecciones y él mismo confirma un token más. Si los 3 borradores coinciden, ese token extra es ganancia. El texto confirmado siempre es igual al que saldría de una decodificación voraz común, así que la aceleración no cuesta calidad. Con K igual a 3, el modelo confirma 2,73 tokens por paso en promedio.
Recompensas verificables en el post entrenamiento
El post entrenamiento combina alineamiento por instrucciones, ajuste de robustez sobre páginas degradadas y GRPO. Cada término de recompensa es código determinista que se evalúa contra una transcripción de referencia. Los términos cubren contenido, fórmulas, tablas, validez estructural, pruebas unitarias, repetición y formato.
Esos términos se multiplican entre sí y cada uno se califica por grado, de manera que una página parcialmente correcta recibe crédito parcial. Los términos de estructura, pruebas unitarias y formato tienen un piso de 0,2, y el de tablas un piso de 0,1. El de repetición no tiene piso, porque los bucles pueden inflar el puntaje de contenido.
En páginas naturales, las recompensas de fórmulas y de tablas aplican a pocas muestras. Por eso Jina AI armó JinaOCRSynth, páginas sintéticas cargadas de ambas cosas, cada una con pruebas unitarias al estilo de olmOCR-Bench. Un agente también fusiona los candidatos a punto de control bajo un presupuesto fijo de evaluación. La cabeza de borrador se entrena al final, contra el verificador ya congelado.
¿Dónde queda contra el resto?
En exactitud no lidera. PaddleOCR-VL-1.6 y HunyuanOCR-1.5, este último con 94,74, puntúan más alto en OmniDocBench. chandra-ocr-2 y dots.mocr, con 83,9, quedan arriba en olmOCR-Bench. Lo que sí aporta el post entrenamiento son 7,4 puntos sobre el DeepSeek-OCR del que parte, medidos en olmOCR-Bench.
El resultado que Jina AI pone adelante es el rendimiento. Sobre una A100 de 40 GB con concurrencia 32, jina-ocr-v1 procesa 2,57 páginas por segundo, la cifra más alta de los 14 sistemas que la empresa midió.
| Sistema | Páginas por segundo en una A100 |
|---|---|
| jina-ocr-v1 | 2,57 |
| olmOCR-2 | 1,22 |
| chandra-ocr-2 | 0,38 |
Además emite 1.085 tokens de salida por página, que según Jina AI es la salida más corta entre los sistemas que puntúan sobre 83. En una NVIDIA L4 con lote de 1, la decodificación sin optimizar sube de 42,7 a 83,1 tokens por segundo, o sea 1,95 veces más rápido con una tasa de aceptación de 57,6%. Con gráficos CUDA la línea base ya está en 158,3 tokens por segundo, y ahí lo que mejor funciona es K igual a 1, que llega a 185,6 tokens por segundo, una ganancia de 1,17 veces.
Cómo se ejecuta
La vía más corta es Jina Reader. Se manda una URL a r.jina.ai con la cabecera X-Respond-With: jina-ocr-v1, y Reader busca la página o el PDF, corre el modelo y devuelve Markdown. Una cabecera X-Page transcribe una sola página de un documento largo.
Jina AI también hospeda un endpoint compatible con la API de OpenAI en https://api.jina.ai/v1/chat/completions, y dejó una demostración para pruebas rápidas.
Para autohospedarlo, los pesos y el código personalizado vienen en un mismo repositorio y se cargan con trust_remote_code=True. FastMTP exige vLLM 0.21 o superior y una llamada única a register(). El camino de Transformers corre solo el decodificador MoE e ignora los pesos del borrador. El anuncio de la empresa tiene el resto de los detalles.