NASA e IBM Research, junto a varias instituciones académicas, liberaron el NASA-IBM Lunar Foundation Model, que las dos organizaciones describen como uno de los primeros modelos fundacionales de código abierto para ciencia lunar. Lo publicó The Decoder el 4 de octubre. El modelo vuelve utilizables para aprendizaje automático décadas de observaciones de la Luna y se destaca al predecir depósitos de hielo en los polos y al detectar cráteres.
"La NASA ha pasado décadas construyendo un registro científico extraordinario de la Luna, pero recolectar datos es solo una parte del trabajo", dijo Kevin Murphy, director de datos científicos de la NASA. Según Murphy, esos datos también tienen que ser más fáciles de usar para los científicos.
A diferencia de los algoritmos hechos para una sola tarea, un modelo fundacional se preentrena con grandes volúmenes de datos sin etiquetar y después se adapta a tareas concretas con pocos ejemplos etiquetados. El equipo ve ahí la ventaja principal para la investigación lunar, donde sobran observaciones y faltan etiquetas.
¿Con qué datos se entrenó?
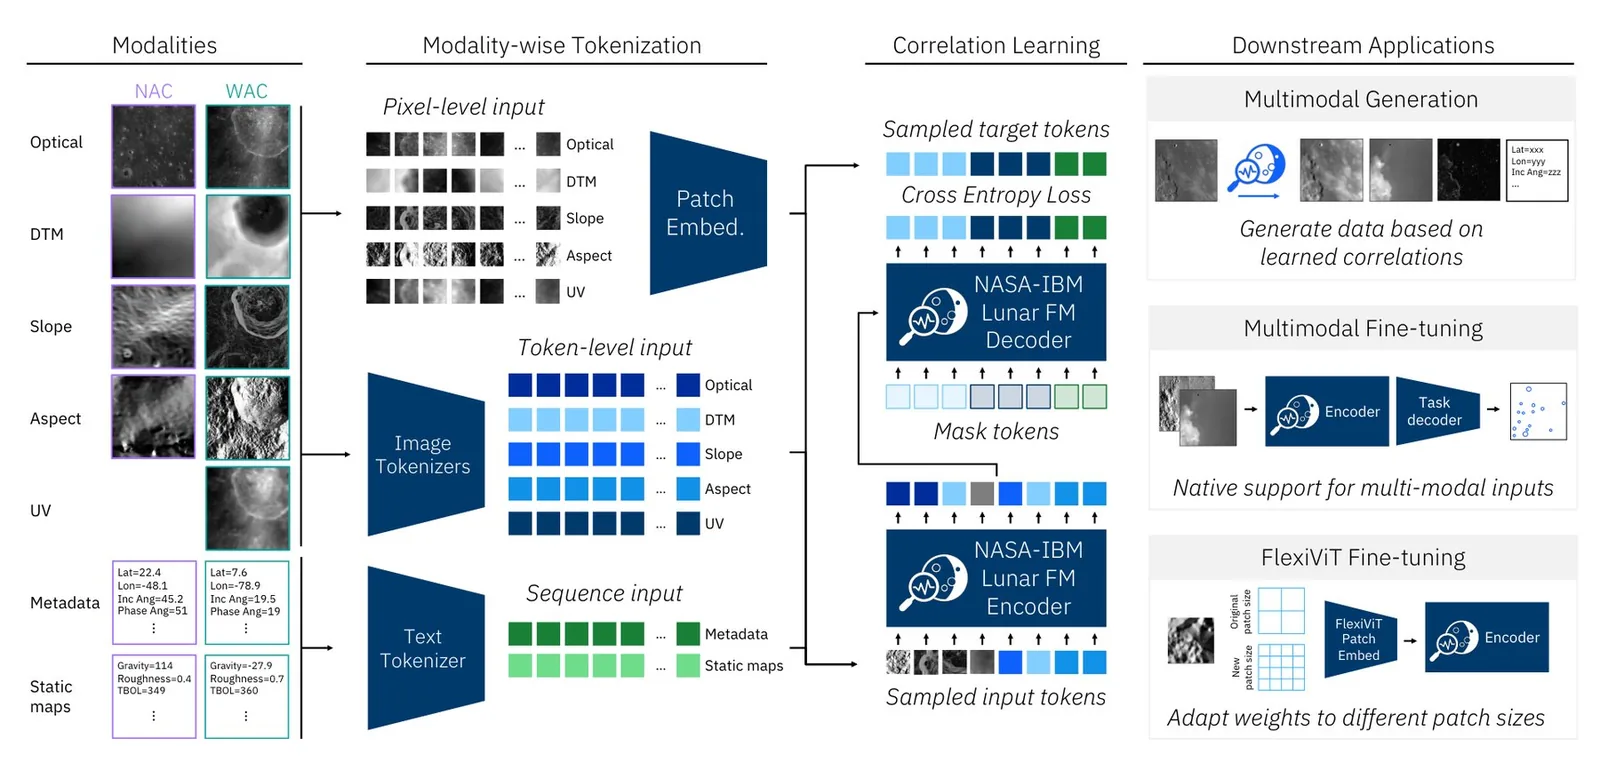
El equipo entrenó el modelo desde cero con SomBench, que según los autores es el corpus lunar multimodal corregistrado más grande hasta la fecha. Reúne casi 2 millones de bloques de imágenes en 11 modalidades y dos escalas espaciales. Cerca de 1 millón de imágenes de alta resolución vienen de la Narrow Angle Camera (NAC), a unos 1 metro por píxel, y algo menos de 964.000 imágenes multiespectrales salen de la Wide Angle Camera, a 100 metros por píxel.
La mayor parte de los datos proviene de 17 años de observaciones del Lunar Reconnaissance Orbiter (LRO). Según la NASA, el volumen de datos de esa sonda supera al de todas sus otras misiones planetarias juntas. La colección se completó con datos de la misión GRAIL (campo gravitatorio), del Lunar Prospector (hidrógeno) y de la sonda Kaguya/SELENE de JAXA (mineralogía).
En total, el conjunto reúne más de 30 capas de datos alineadas espacialmente, de nueve instrumentos y cuatro misiones. Para que no se filtre información entre los datos de entrenamiento, validación y prueba, el corpus se divide geográficamente por zonas del mapa en vez de repartir los bloques al azar.
El modelo recibe la iluminación como dato
El modelo parte de la arquitectura de TerraMind, un modelo multimodal de observación de la Tierra, pero los investigadores lo entrenaron desde cero en lugar de ajustarlo. Para cada bloque, el modelo recibe la geometría de captura como contexto explícito, con los ángulos de iluminación, la posición del Sol y la extensión del bloque. En la Luna, la geometría de la luz determina cómo se ve la superficie mucho más que sus propiedades reales. En vez de obligar al modelo a corregir eso desde los píxeles en bruto, el equipo le entrega esa información directamente.
El modelo divide las imágenes lunares, los datos de elevación y la geometría de captura en tokens, y aprende sus relaciones prediciendo partes enmascaradas. También aprende en una sola corrida de entrenamiento con imágenes de alta y baja resolución, con lo que capta tanto el detalle fino como el contexto de gran escala. Una técnica llamada FlexiViT permite que el mismo modelo entrenado se adapte a tareas con distintos tamaños de parche de imagen sin volver a entrenarlo.
¿Dónde rinde mejor?
El equipo probó el modelo en detección de cráteres a escalas de 100 metros y de 1 metro, y en la predicción de depósitos de hielo polar. También tuvo que segmentar Irregular Mare Patches (IMP), formaciones volcánicas jóvenes que ponen en duda las cronologías aceptadas del enfriamiento lunar. Según el informe técnico, en todas las tareas el modelo preentrenado igualó o superó a los modelos de referencia habituales y a un modelo de control con la misma arquitectura e inicialización aleatoria.
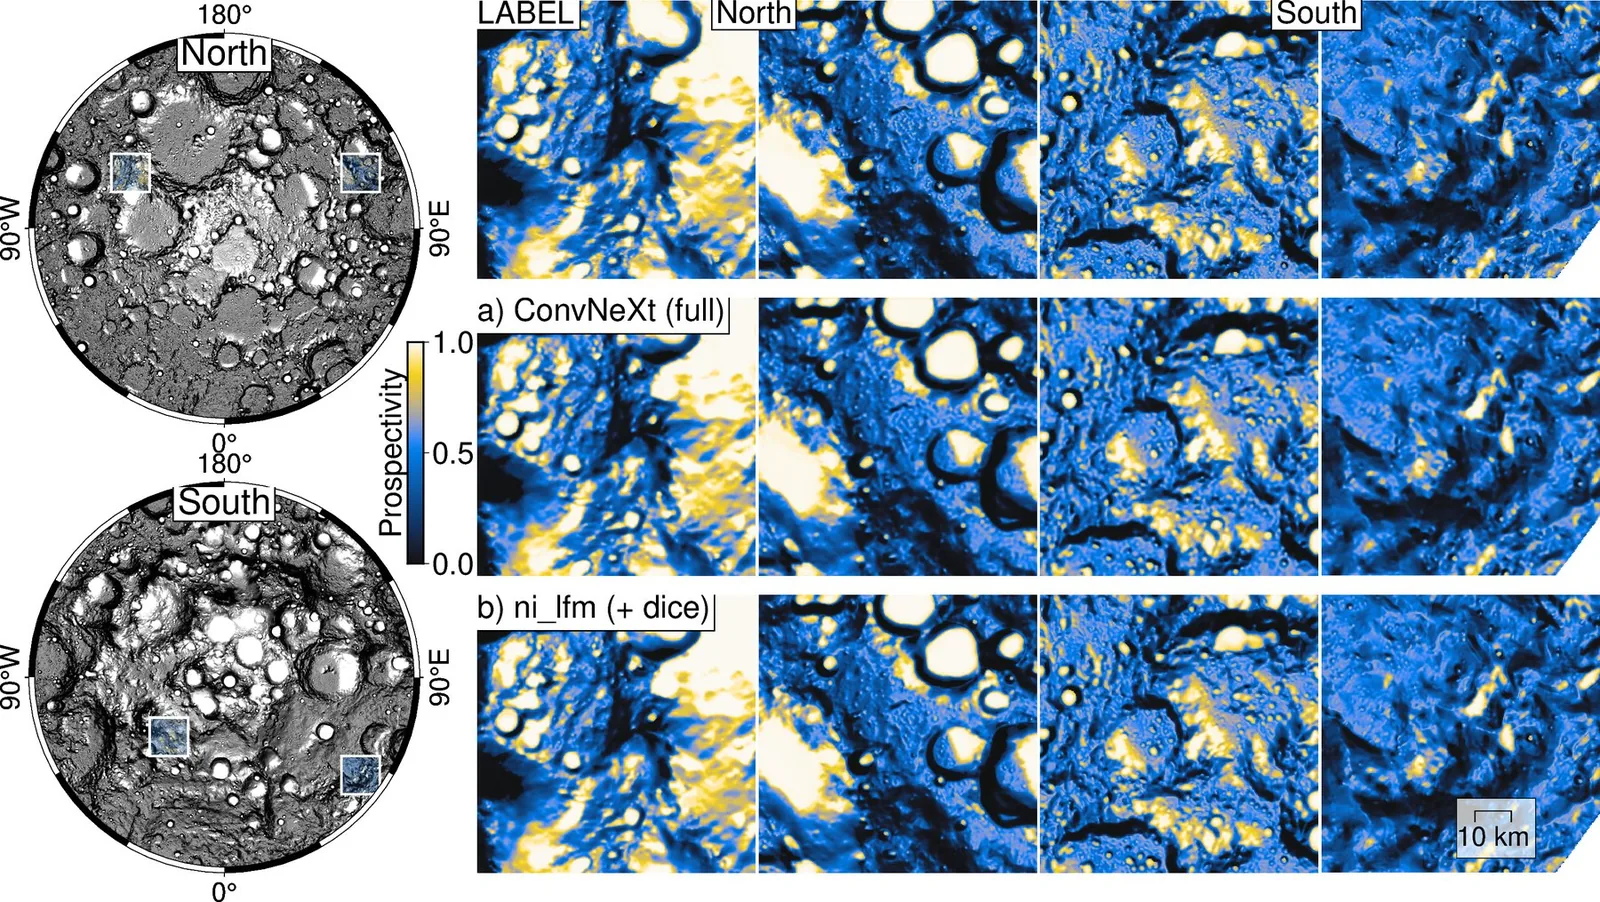
Las mayores ganancias aparecieron en la predicción de depósitos de hielo. Las regiones polares en sombra permanente se mantienen lo bastante frías como para conservar hielo de agua durante miles de millones de años, y se consideran una posible fuente de agua, oxígeno y combustible para cohetes. Según IBM, el modelo redujo el error de predicción hasta 22% frente al mejor modelo de referencia, SwinV2-B. En los mapas de referencia de distribución potencial de hielo en los polos, el modelo reproduce de cerca los patrones finos.
En la detección de cráteres a escala gruesa, el modelo superó a SwinV2-B por casi 19%, según IBM. Esa cifra sale de entrenar con solo la mitad de los datos, lo que sugiere que el modelo necesita menos ejemplos etiquetados para rendir bien. En los ejemplos de detección de cráteres, el modelo de NASA e IBM y el SwinV2-B preentrenado con ImageNet rinden de forma parecida, y todos los modelos empeoran con las imágenes de alta resolución de la NAC.
Parte de la ventaja viene de cómo trata los datos
Incluso el modelo de control con inicialización aleatoria superó a cinco de siete modelos de referencia en la predicción de hielo, sin ningún preentrenamiento lunar. Según los investigadores, parte de la ventaja viene de la forma en que el modelo maneja los distintos tipos de datos. Asigna a cada capa de datos su propia ruta de procesamiento, mientras que los modelos de referencia tratan todas las entradas como canales apilados.
En la detección de cráteres a escala de metros y en la segmentación de IMP, el modelo queda más o menos empatado con los mejores modelos de referencia, con diferencias que caben dentro de la variación entre corridas de entrenamiento. IBM afirma una ventaja de 3% sobre SwinV2-B en los IMP, aunque los resultados se ven más comparables que claramente mejores. En uno de los ejemplos de segmentación, el modelo de NASA e IBM detecta zonas que los dos modelos de referencia pasan por alto.
Según los investigadores, LoRA, un método de ajuste más liviano que entrena solo una fracción de los parámetros, rindió a la par del ajuste completo en todas las pruebas y fue mejor en la detección de cráteres. El ajuste completo solo gana en las dos tareas más pequeñas.
Útil para análisis, no reemplaza a las mediciones físicas
Juan Bernabé-Moreno, director de IBM Research Europe, dijo que el modelo conecta observaciones de distintos instrumentos y revela patrones difíciles de ver por separado.
La investigación muestra que el modelo no sirve para posicionamiento geodésico absoluto. En pruebas de generación, la latitud y la longitud se desviaron en decenas de grados en algunos casos, y las estructuras de elevación podían aparecer con alturas absolutas corridas aunque su forma se reconstruyera bien.
Los autores lo presentan como una base reutilizable para tareas posteriores, no como reemplazo de los instrumentos de medición física. Todavía faltan experimentos controlados que aíslen el aporte de cada novedad, y algunos conjuntos de prueba son pequeños.
¿Dónde se puede descargar?
El modelo está disponible en Hugging Face, el código está en GitHub y viene integrado en TerraTorch, una caja de herramientas de código abierto. El equipo también publicó los conjuntos de datos de preentrenamiento listos para aprendizaje automático y las colecciones de pruebas.
El modelo es parte de la colaboración "AI for Science" entre NASA e IBM. Las dos organizaciones trabajan en modelos fundacionales bajo un Space Act Agreement desde comienzos de 2022. En agosto de 2023 publicaron en Hugging Face el primer modelo Prithvi, entrenado con imágenes de Landsat y Sentinel-2 de todo el territorio continental de Estados Unidos y adaptado para mapear inundaciones e incendios forestales.
IBM había anunciado Prithvi como parte de su plataforma Watsonx. TerraMind, la base del modelo lunar, lo desarrolló IBM en 2025 junto a la ESA y el Forschungszentrum Jülich para observación de la Tierra. Google DeepMind sigue un enfoque parecido con AlphaEarth Foundations, que comprime imágenes satelitales ópticas, radar, escaneos lidar y simulaciones climáticas en representaciones compactas de la superficie terrestre.