Las aplicaciones de IA en el borde suelen necesitar varias redes neuronales funcionando dentro de un presupuesto de cómputo y de energía limitado. Las plataformas Deep Learning Accelerator (DLA) de NVIDIA son hardware dedicado a la inferencia. En el NVIDIA Jetson AGX Orin, el DLA ejecuta las operaciones de red que soporta y le quita esa carga a la GPU. Eso puede mejorar la eficiencia energética y deja capacidad de GPU libre para otras tareas.
cuDLA es la API de runtime de NVIDIA para manejar la ejecución en ese acelerador. Las aplicaciones la usan para crear dispositivos DLA, cargar redes compiladas, registrar buffers de memoria y enviar tareas de inferencia. El módulo cuda.bindings.cudla expone esas API directamente a Python, así que se puede integrar el DLA en una aplicación sin escribir código C++ para manejar el runtime.
La guía de NVIDIA, publicada en su blog para desarrolladores, recorre el ciclo de inferencia en el Jetson AGX Orin con un ejemplo de clasificación de imágenes. Cubre la instalación y la compilación de un modelo a un loadable de DLA, y después sigue la ejecución completa, desde crear el dispositivo y cargar la red hasta manejar los buffers, sincronizar y leer la salida. También muestra cómo trabajan juntas las etapas de GPU y de DLA en una sola aplicación de Python.
¿Dónde entra cuDLA en una aplicación de Python?
El DLA es un acelerador de función fija. Ejecuta con eficiencia operaciones fijas, como convoluciones y pooling, que son comunes en las arquitecturas de redes neuronales actuales. Soporta menos tipos de capa que la GPU, pero cubre muchas de las que usan las arquitecturas más populares. Para saber cuándo y por qué conviene usarlo, NVIDIA remite a su guía Getting Started with the Deep Learning Accelerator on NVIDIA Jetson Orin.
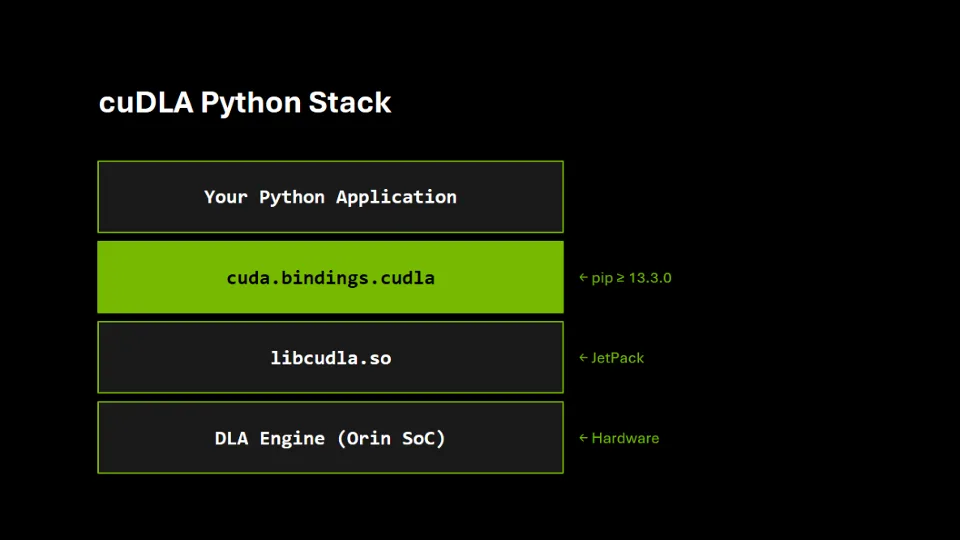
cuda.bindings.cudla llegó en cuda-bindings 13.3.0, como parte del proyecto CUDA Python. Es una capa delgada de Python, generada con Cython, sobre la API C++ de cuDLA para flujos en modo híbrido. Expone 13 funciones, 9 tipos de datos y 8 enumeraciones para ese modo, en el que los streams de CUDA coordinan la ejecución del DLA con el trabajo de la GPU. En el Jetson Orin, NVIDIA JetPack aporta el runtime de base, libcudla.so.
Los bindings de Python exponen ese runtime directo a la aplicación, mientras la inferencia corre en el hardware del DLA. Complementan el flujo existente en C++ y permiten dejar en Python el manejo del runtime y la orquestación de la inferencia. Aunque la guía se centra en Jetson, NVIDIA señala que NVIDIA RTX Spark lleva por primera vez la inferencia en DLA a portátiles Windows para desarrolladores de IA. La API de cuda.bindings.cudla es idéntica en las dos plataformas, así que todo lo relativo a cuDLA aplica también a RTX Spark.
Requisitos e instalación
En un NVIDIA Jetson Orin con JetPack, libcudla.so viene con la instalación de JetPack y los bindings lo encuentran solos. No hay nada más que instalar para el runtime del DLA. No hace falta un SDK de cuDLA aparte ni bibliotecas extra.
Para instalar los bindings de Python de cuDLA:
pip install "cuda-bindings>=13.3.0"El Python que trae JetPack por defecto puede ser anterior a la 3.10, que es la versión mínima. Si hace falta, se puede instalar Python 3.12 desde el PPA deadsnakes:
sudo apt update && sudo apt install -y software-properties-common
sudo add-apt-repository -y ppa:deadsnakes/ppa
sudo apt update && sudo apt install -y python3.12 python3.12-venv python3.12-dev
python3.12 -m venv ~/dla-env
~/dla-env/bin/pip install "cuda-bindings>=13.3.0"
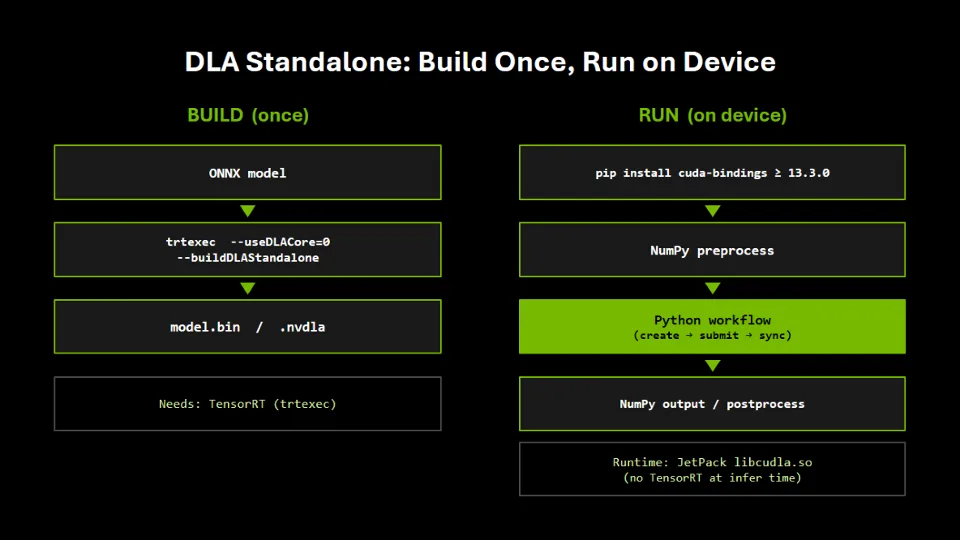
TensorRT solo se necesita para compilar un modelo entrenado a un loadable de DLA. Para ejecutar un loadable que ya existe basta con libcudla.so, que viene con JetPack.
Cómo se compila un loadable de DLA
Un loadable de DLA es el binario que produce la herramienta trtexec de TensorRT. Codifica una red entrenada en un formato que el hardware DLA ejecuta directamente. El ejemplo de compilación apunta a TensorRT 11.4.1 con CUDA 13.4 Update 1 en un Jetson AGX Orin con JetPack 7.2.2 o posterior. Para un loadable FP16 CHW16, a partir de un modelo ONNX con tipos FP16 y dimensiones de entrada fijas, el comando es este:
trtexec \
    --onnx=your_model_fp16.onnx \
    --useDLACore=0 \
    --inputIOFormats=chw16 \
    --outputIOFormats=chw16 \
    --memPoolSize=dlaSRAM:1 \
    --saveEngine=model.bin \
--buildDLAStandalone--useDLACore=0apunta al primer motor DLA del Orin.--buildDLAStandaloneproduce un loadable de DLA puro, que no necesita TensorRT al momento de la inferencia.- Las opciones de formato de entrada y salida eligen la disposición CHW16.
TensorRT 11 deduce la precisión a partir de los tipos de tensor del modelo, y las opciones --fp16 y --int8 ya no existen. Como el ejemplo supone dimensiones de entrada fijas, se omite --shapes. Esto refleja la ruta FP16 actual del ejemplo y los cambios de opciones de TensorRT 11.
No todas las capas de una red son compatibles con el DLA, y muchas veces hay que preprocesar el grafo ONNX para recortar las capas incompatibles del inicio y del final. El flujo de Python que sigue funciona con cualquier archivo .bin o .nvdla que se genere. La figura 2 muestra la separación entre la compilación, que se hace una vez, y el runtime en el equipo.
El flujo en Python
Para las llamadas de CUDA y cuDLA bastan tres importaciones:
import numpy as np
from cuda.bindings import cudla
from cuda.bindings import driver, runtime
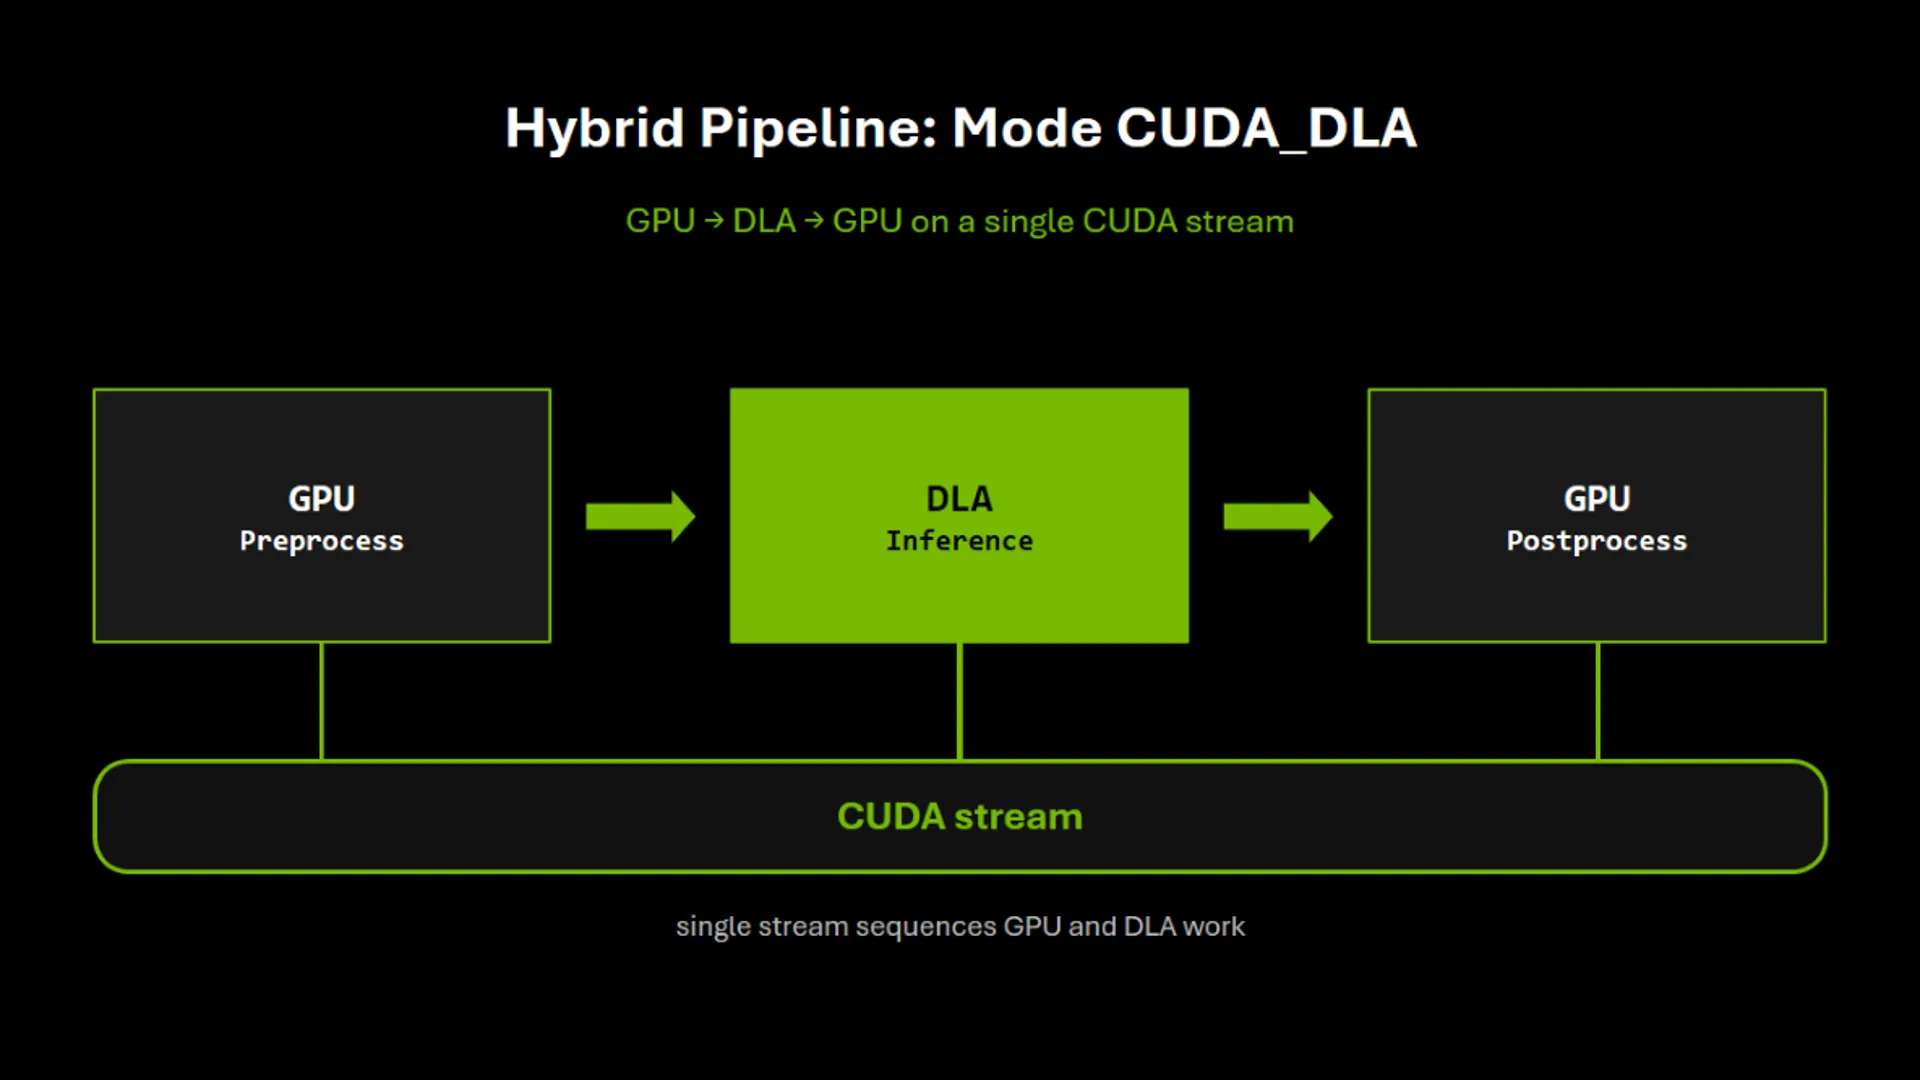
cudla es el módulo nuevo. driver y runtime son los bindings de cuda-python que ya existían para las API de driver y runtime de CUDA, y acá se usan para manejar el stream, reservar memoria y transferir datos. Todo corre por un solo stream de CUDA, que es el punto de coordinación entre el DLA y la GPU en modo híbrido.
Paso 1. Inicializar CUDA y crear un dispositivo DLA
cudla.Mode.CUDA_DLA elige el modo híbrido, en el que las tareas del DLA se envían por un stream de CUDA. Eso permite armar cadenas GPU y DLA, con kernels de preprocesamiento, inferencia en el DLA y kernels de posprocesamiento encolados en el mismo stream y ejecutados en orden.
driver.cuInit(0)
runtime.cudaSetDevice(0)

cudla_device = cudla.create_device(0, int(cudla.Mode.CUDA_DLA))
Esta versión no soporta el modo independiente, que requiere las primitivas de buffer y sincronización NvSci. Si se pide, create_device lanza CudlaError(ErrorUnsupportedOperation).
Paso 2. Cargar el loadable
El loadable se pasa como un objeto bytes de Python directo a module_load_from_memory. No hace falta ruta de archivo ni manejador del sistema de archivos, solo los bytes, así que se puede cargar igual de fácil desde archivos mapeados en memoria, recursos embebidos o flujos de red.
with open("model.bin", "rb") as f:
    loadable_data = f.read()

module_handle = cudla.module_load_from_memory(
    cudla_device, loadable_data, len(loadable_data), 0
)
Paso 3. Consultar el módulo cargado
Antes de reservar memoria, se le pregunta al módulo qué tensores espera exactamente:
num_inputs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.NUM_INPUT_TENSORS)
)
num_outputs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.NUM_OUTPUT_TENSORS)
)
input_descs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.INPUT_TENSOR_DESCRIPTORS)
)
output_descs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.OUTPUT_TENSOR_DESCRIPTORS)
)
Cada descriptor es un cudla.ModuleTensorDescriptor con propiedades para el tamaño del buffer (size_), la forma del tensor (n, c, h, w), el nombre, el formato de datos y el stride. Todas las reservas de memoria posteriores se basan en desc.size_, sin tamaños escritos a mano en ninguna parte. Esta consulta es lo que hace que el flujo no dependa del modelo. El mismo código sirve para cualquier loadable, sea cual sea la arquitectura de la red.
Paso 4. Reservar memoria en la GPU
input_gpu  = runtime.cudaMalloc(input_descs[0].size_)[1]
output_gpu = runtime.cudaMalloc(output_descs[0].size_)[1]
Las llamadas del driver y del runtime de CUDA devuelven un código de estado como primer elemento de una tupla. El ejemplo completo envuelve cada una de esas llamadas en una función que revisa el estado y lanza una excepción si falla. Los fragmentos de la guía la omiten para que se lean mejor, pero en código de producción la revisión de errores es indispensable. En modelos con varias entradas o salidas, se recorren input_descs y output_descs y se reserva un buffer por tensor. El campo size_ de cada descriptor da el número exacto de bytes.
Paso 5. Registrar los buffers de GPU en cuDLA
Este es el paso propio de cuDLA. Los buffers de GPU tienen que registrarse en el dispositivo DLA antes de aparecer en una tarea. El registro devuelve un manejador del lado del DLA, que el hardware usa para acceder al buffer:
input_registered  = cudla.mem_register(
    cudla_device, int(input_gpu), input_descs[0].size_, 0
)
output_registered = cudla.mem_register(
    cudla_device, int(output_gpu), output_descs[0].size_, 0
)
La conversión con int() extrae el puntero crudo del objeto de memoria de CUDA. cuda.bindings devuelve objetos manejadores opacos, y int() es la forma de pasarlos a API de nivel C que esperan un puntero.
Paso 6. Preparar los datos de entrada y copiarlos a la GPU
El preprocesamiento (normalizar valores y respetar el stride y el formato de datos que espera el tensor) es el único código del script que depende del modelo. Los campos stride, data_format y data_type del descriptor dicen exactamente cómo ordenar los datos. En un modelo con varias entradas, la copia se repite para cada buffer. Todo lo que va antes y después de este bloque es idéntico, sin importar qué red tenga el loadable.
stream = driver.cuStreamCreate(driver.CUstream_flags.CU_STREAM_NON_BLOCKING)[1]

# Preprocess your input into a numpy array `input_cpu`
# matching the tensor layout described by input_descs[0] ...

runtime.cudaMemcpyAsync(
    input_gpu, input_cpu, input_descs[0].size_,
    runtime.cudaMemcpyKind.cudaMemcpyHostToDevice, stream
)
runtime.cudaMemsetAsync(output_gpu, 0, output_descs[0].size_, stream)
Paso 7. Armar la tarea y enviarla
cudla.Task envuelve la estructura C cudlaTask. Al asignar una lista de Python a task.input_tensor o task.output_tensor, el campo de conteo correspondiente se actualiza solo. submit_task encola la inferencia en el stream de CUDA y la ordena junto a cualquier kernel de GPU que vaya antes o después en ese mismo stream.
task = cudla.Task()
task.module_handle = module_handle
task.input_tensor  = [int(input_registered)]
task.output_tensor = [int(output_registered)]
task.wait_events   = 0
task.signal_events = 0

cudla.submit_task(cudla_device, int(task), 1, int(stream), 0)
El paso siguiente de la guía sincroniza el stream y lee la salida de vuelta desde la GPU.