Buena parte del tiempo de cálculo de muchas simulaciones científicas, de la química molecular a la ciencia de materiales, se va en multiplicar matrices densas de alta precisión (GEMM). Esas operaciones se llaman DGEMM cuando trabajan con números reales de punto flotante de 64 bits y ZGEMM cuando son números complejos de 64 bits. cuBLAS, la biblioteca de NVIDIA que acelera GEMM y otras rutinas de álgebra lineal básica (BLAS) en sus GPU, es muy usada en aplicaciones de HPC y de IA. El avance rápido del hardware de baja precisión empujó una clase nueva de algoritmos, que entregan resultados de doble precisión completa sobre los Tensor Cores de enteros, que son más rápidos.
Con CUDA Toolkit 13.4.2, cuBLAS ya no tiene que elegir entre exactitud y velocidad, según explicó NVIDIA en su blog para desarrolladores. La biblioteca descompone cada número de doble precisión en trozos enteros, los multiplica en los Tensor Cores de la GPU y vuelve a armar el resultado exacto. Las respuestas mantienen la exactitud de doble precisión, pero el trabajo corre en hardware más rápido.
Dos algoritmos nuevos lo hacen más eficiente. Ozaki-II necesita menos multiplicaciones enteras que el enfoque anterior, Ozaki-I, y el método 2M reduce una multiplicación de matrices complejas de cuatro multiplicaciones reales a dos. Ambos se apoyan en el marco de precisión dinámica automática (ADP), presentado en el artículo Unlocking Tensor Core Performance with Floating Point Emulation in cuBLAS. Ese marco mejora el rendimiento de la multiplicación de matrices en doble precisión (FP64) llevando la aritmética FP64 a los Tensor Cores de enteros, con la misma exactitud que FP64 nativo.
cuBLAS acelera DGEMM y ZGEMM de forma automática, sin cambios en el código de la aplicación. NVIDIA validó velocidad y exactitud en dos aplicaciones reales, el método coupled cluster singles and doubles (CCSD) de química cuántica y BerkeleyGW, de ciencia de materiales.
¿Cuánto más rápido es?
Estas son las mejoras que NVIDIA reporta para cuBLAS en CUDA Toolkit 13.4.2:
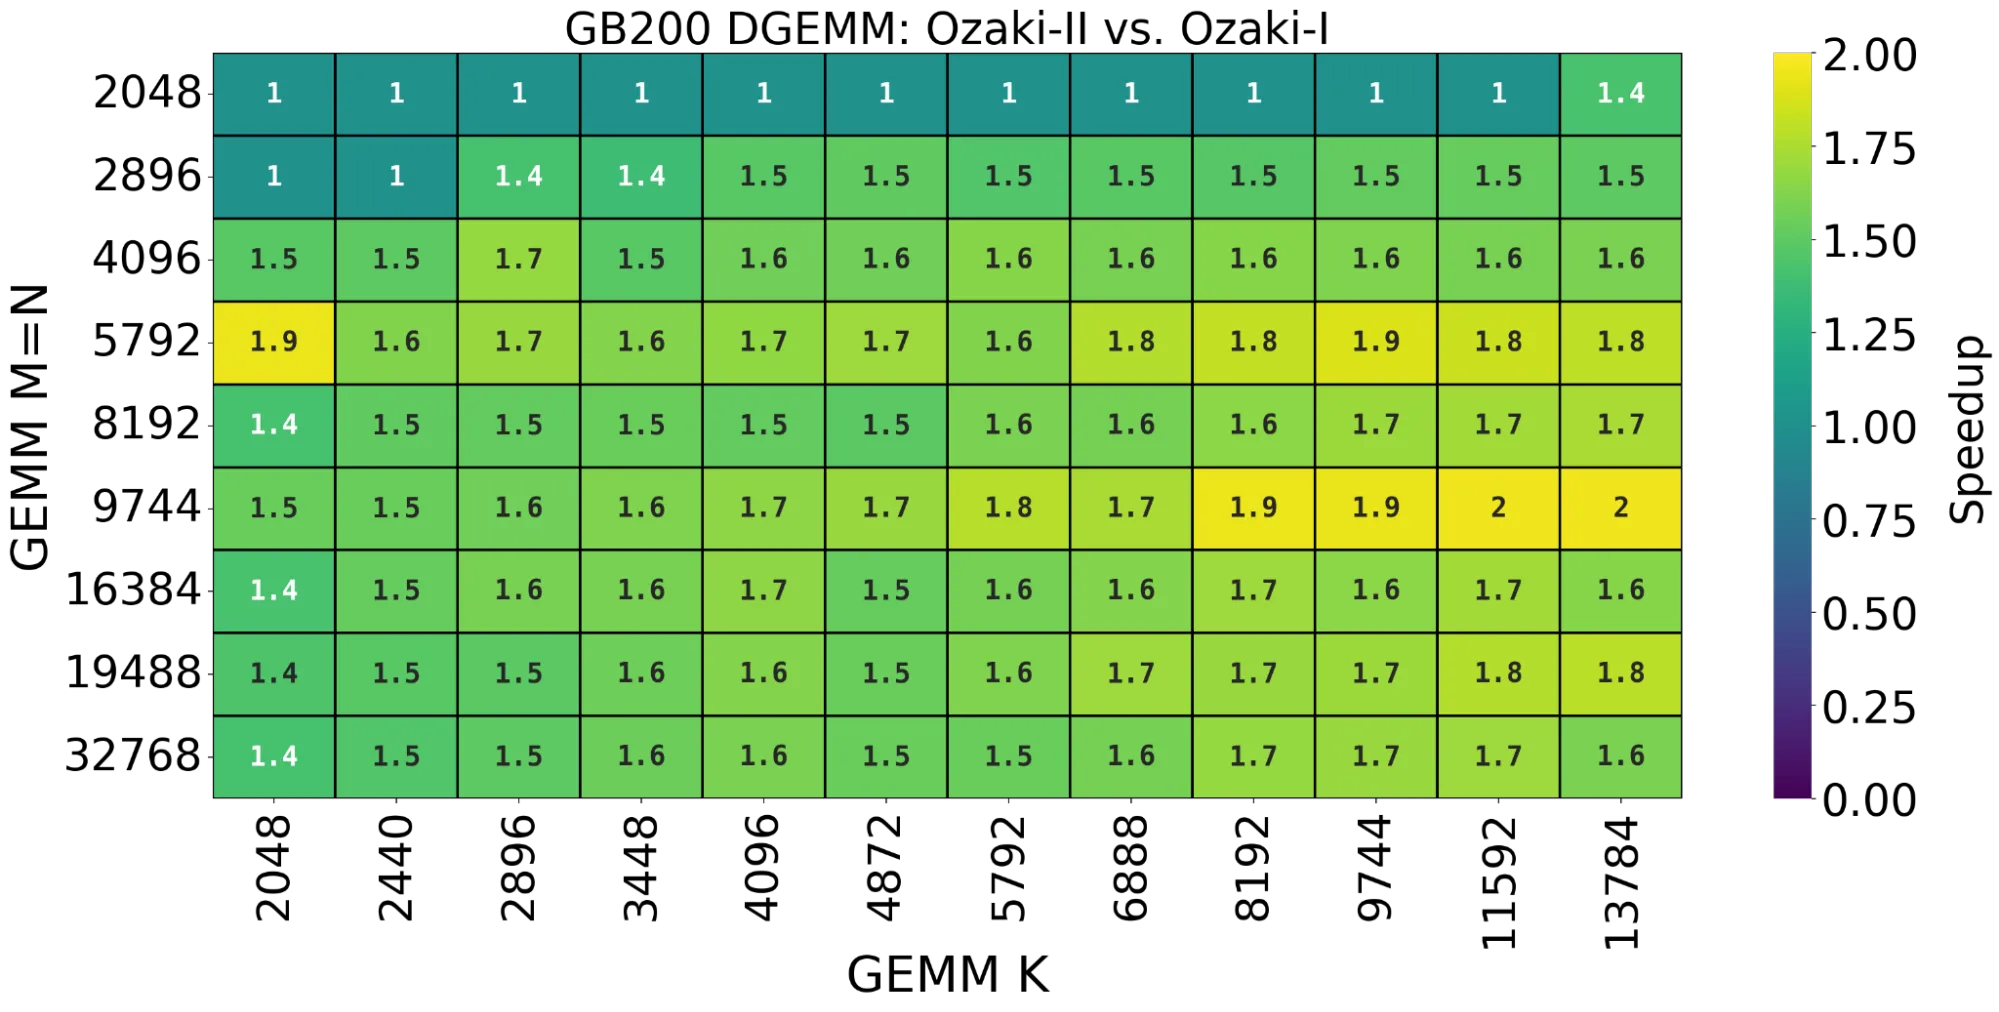
- DGEMM con Ozaki-II corre 5,5 veces más rápido que FP64 nativo en NVIDIA VR NVL72 y 3,9 veces más rápido en NVIDIA GB200. En GB200 también duplica la velocidad de Ozaki-I.
- El caso de CCSD con DGEMM y Ozaki-II logra una aceleración de punta a punta de 2 veces en VR NVL72 y de 1,4 veces en GB200 frente a FP64 nativo, manteniendo FP64. En el modo de precisión mixta propio del dominio, la aceleración sube a 5 y 3,5 veces, respectivamente.
- ZGEMM con el algoritmo 2M alcanza 5 veces la velocidad del FP64 complejo nativo (CFP64) en NVIDIA GB200.
- El caso de BerkeleyGW con ZGEMM y 2M logra 6,6 veces la velocidad del ZGEMM nativo en VR NVL72 y 3,9 veces en GB200.
- DGEMM con Ozaki-II llega hasta 175, 147 y 37 TFLOPS en NVIDIA VR NVL72, NVIDIA GB200 y NVIDIA RTX PRO 6000, respectivamente.
De Ozaki-I a Ozaki-II
Los dos esquemas comparten el primer paso y se separan en cómo resuelven la multiplicación de enteros grandes. Ambos alinean los exponentes de las matrices de entrada y las convierten a una representación entera de largo variable con exponente compartido, de modo que los productos se acumulen de forma exacta en los Tensor Cores de enteros. cuBLAS elige entre Ozaki-I y Ozaki-II con heurísticas para obtener el mejor rendimiento. El ancho de los enteros lo decide ADP en tiempo de ejecución, o el usuario puede fijarlo a mano.
Ozaki-I corta cada entero grande en tajadas de 8 bits y multiplica las tajadas de A contra las de B en un patrón triangular. Por eso la cantidad de GEMM en Tensor Cores crece con el cuadrado del número de tajadas.
Ozaki-II usa un algoritmo de multiplicación de enteros grandes más rápido, basado en el teorema chino del resto (CRT). Reduce cada operando cuantizado módulo un conjunto de enteros pequeños coprimos entre sí, hace exactamente una GEMM entera por módulo y reconstruye el producto exacto a partir de los restos. Con Ozaki-II la cantidad de GEMM crece de forma lineal con el número de módulos, mientras que en Ozaki-I crece con el cuadrado de las tajadas, así que la ventaja aumenta a medida que sube la exactitud pedida. Para igualar la exactitud de FP64, Ozaki-I necesita cerca del doble de GEMM en Tensor Cores que Ozaki-II.
Como Ozaki-II genera un par de restos por cada módulo, una implementación ingenua ocuparía mucho más espacio de trabajo que Ozaki-I. cuBLAS ya aplica a Ozaki-II el mosaico de bajo consumo de memoria que introdujo para Ozaki-I en CTK 13.3, y descarta cada par de restos apenas termina su GEMM. Así el espacio de trabajo queda en un tamaño manejable.
El marco ADP de cuBLAS está diseñado para dar garantías de exactitud comparables o mejores que las de los algoritmos GEMM de punto flotante estándar. Si en tiempo de ejecución la cantidad de bits de mantisa necesaria para mantener una exactitud equivalente a FP64 supera el valor por defecto de la biblioteca o el máximo fijado por el usuario, cuBLAS vuelve a un camino de código que usa las instrucciones MMA de FP64 nativas. Según NVIDIA, eso permite usar cuBLAS en producción sin preocuparse por la exactitud numérica.
Rendimiento de DGEMM
¿Qué cambia con NVIDIA Rubin?
Rubin introduce un formato numérico nuevo, TI16, un entero de 12 bits en formato signo y magnitud con rango de -2047 a +2047, pensado para acelerar los cálculos del esquema Ozaki. cuBLAS 13.4 usa TI16 para acelerar Ozaki-I y Ozaki-II a través de la instrucción tcgen05.mma en las GPU Rubin (capacidad de cómputo 10.7). La figura 2 muestra la aceleración de DGEMM con Ozaki-II frente a FP64 nativo en VR NVL72.
Química cuántica con CCSD
Para mostrar el efecto de Ozaki-II en una aplicación, NVIDIA usó el método CCSD. Es un método fundamental de estructura electrónica posterior a DFT que, junto con la corrección perturbativa (T), que aquí no se consideró, forma el "estándar de oro" de la química cuántica.
La respuesta de CCSD a distintas perturbaciones da lugar al tratamiento EOM-CCSD de estados electrónicos excitados y al tratamiento CCSD lambda para el cálculo de propiedades. CCSD se caracteriza por el altísimo costo de sus contracciones tensoriales densas en FP64, que Ozaki-II puede acelerar bastante.
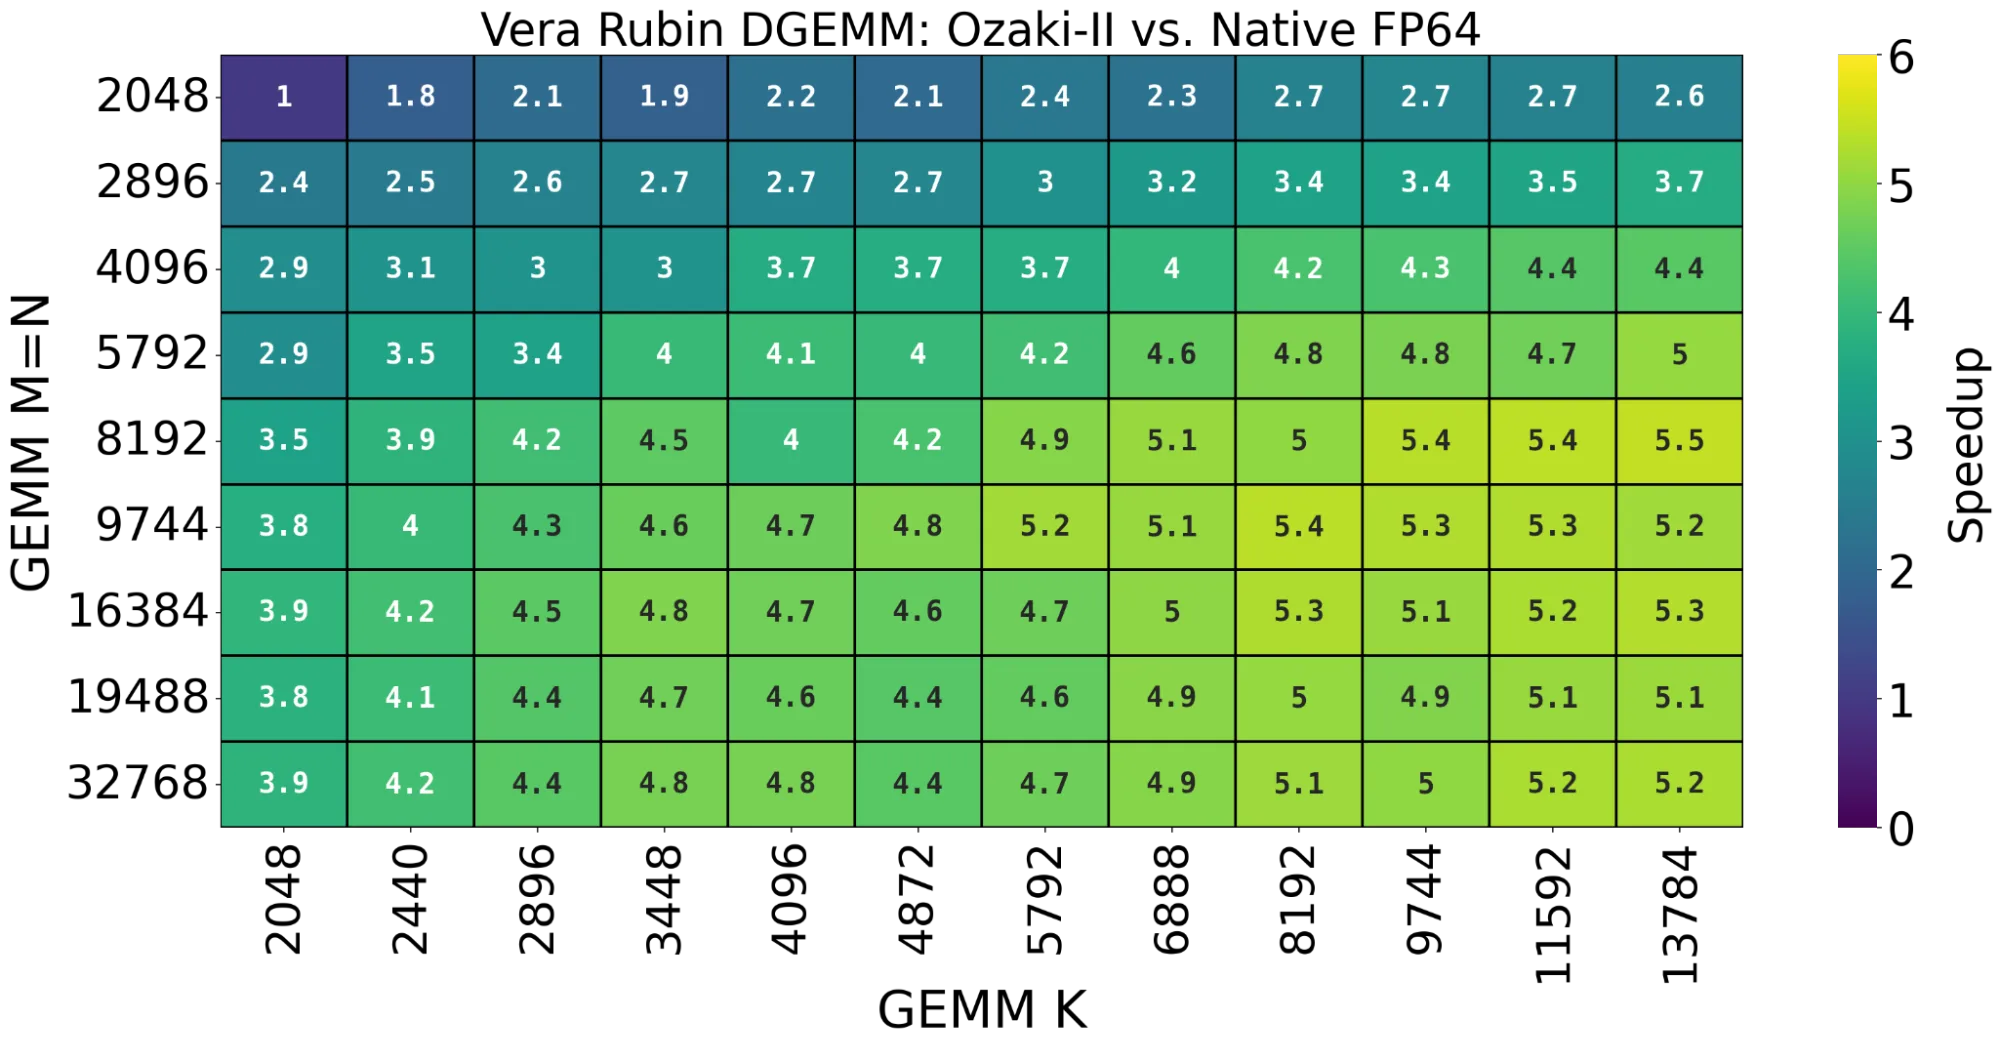
La demostración usó cuBLAS de CTK 13.4.2 para las contracciones tensoriales principales, con la preparación del problema acelerada por cuEST v0.2.2. Se construyó un CCSD restringido estándar con transformación T1, en una sola GPU y en FP64, en la representación de ajuste de densidad. La figura 3 muestra el rendimiento de CCSD/cc-pVTZ con núcleo congelado para cinco sistemas medianos de la base de datos S22, de 24 a 28 átomos y entre 590 y 630 orbitales atómicos.
Con Ozaki-II y ESC garantizando la precisión FP64 completa, el rendimiento sube en cada generación de GPU, hasta una aceleración total de 4,7 veces de Rubin sobre A100. Otra opción es un modo de precisión mixta propio de la aplicación, con un presupuesto fijo de 32 bits de mantisa para Ozaki-II. Ese modo también mejora en cada generación, con una aceleración total de 11,5 veces sobre FP64 nativo en A100. Con ESC en calidad FP64 completa, los resultados no se distinguen de la precisión FP64 nativa, y los errores en la energía de correlación de CCSD quedan bajo 10⁻¹⁴ Eh.
La emulación con Ozaki-II permite usar una precisión fija más baja, de 32 bits de mantisa, y aun así entregar exactitud suficiente para la gran mayoría de las aplicaciones prácticas. Los errores en la energía quedan bajo 10⁻¹⁰ Eh y las ecuaciones de amplitud convergen a un residuo de 10⁻⁹ o mejor.
En Rubin, para el dímero de uracilo con CCSD/cc-pVTZ y núcleo congelado, la precisión fija de 32 bits de mantisa alcanza un rendimiento de punta a punta de 173 TFLOPS. Las GEMM individuales llegan hasta 368 TFLOPS, con un promedio de 200 TFLOPS. Se obtienen cifras parecidas al resolver las ecuaciones de respuesta CCSD lambda necesarias para calcular propiedades moleculares, que no aparecen en el gráfico.
GEMM complejas, de 4M a 3M y a 2M
Una GEMM compleja se calcula de forma convencional como cuatro GEMM reales (4M) del mismo tamaño:
A = Ar + i(Ai); B = Br + i(Bi)

C = A x B = (Ar·Br − Ai·Bi) + i(Ar·Bi + Ai·Br)
El conocido algoritmo 3M lo reduce a tres GEMM reales más un preprocesamiento y un posprocesamiento de tiempo cuadrático. En aritmética de punto flotante, 3M se usa con cautela, porque formar las sumas Ar + Ai y Br + Bi y restar los productos intermedios en la reconstrucción puede degradar la estabilidad numérica.
Con el esquema Ozaki-II, las sumas, las restas y los productos son operaciones enteras exactas, así que el método de multiplicación compleja ya no afecta la exactitud del resultado. Dos números complejos no se pueden multiplicar con menos de tres multiplicaciones reales, pero los productos de matrices en este entorno entero exacto no están sujetos a ese límite. El algoritmo 2M calcula un producto complejo con solo dos GEMM reales en vez de cuatro. En la práctica, una ZGEMM pasa a costar cerca del doble de una GEMM real del mismo tamaño, en lugar de cuatro veces. La derivación completa está en el artículo del método 2M.
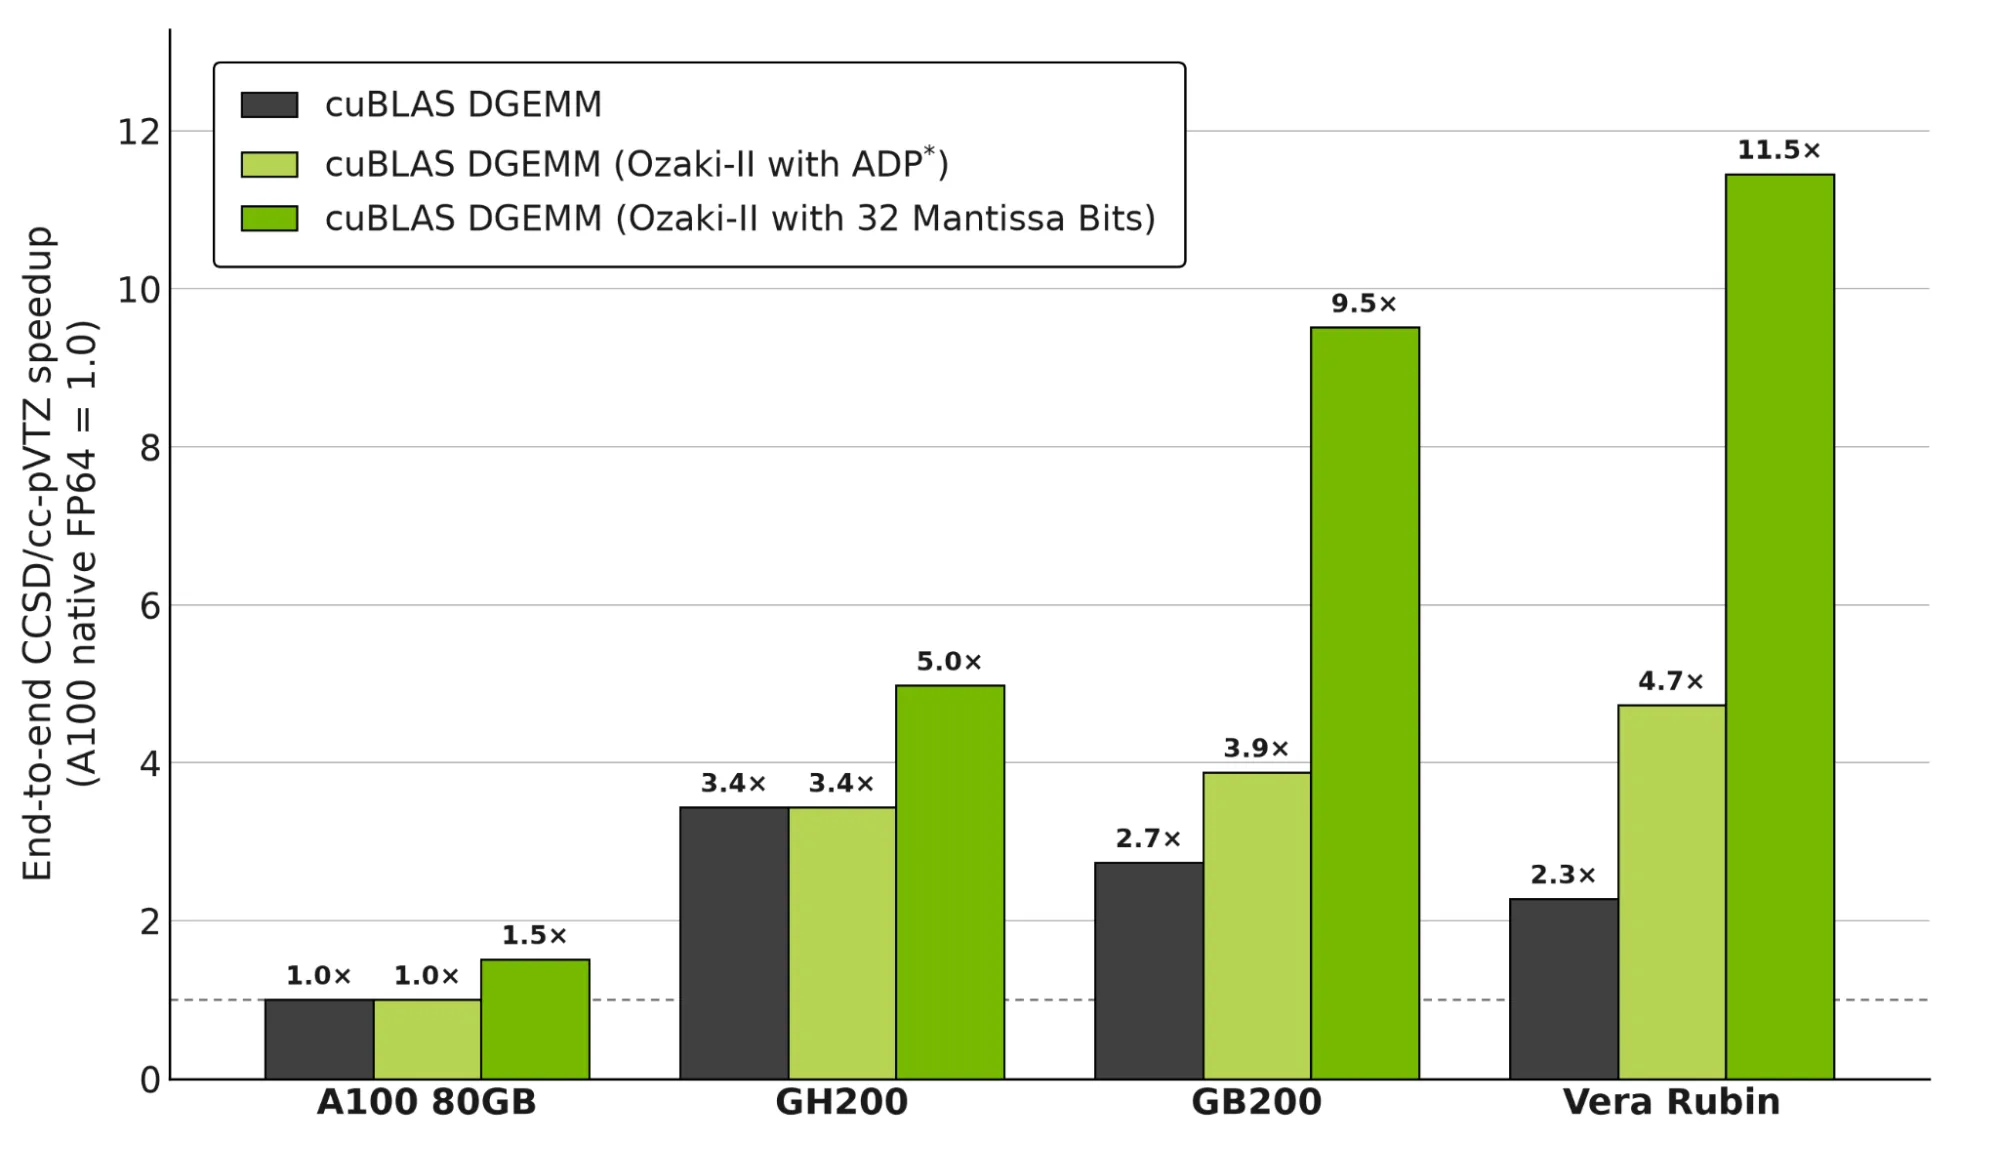
Desde CUDA Toolkit 13.4, cuBLAS usa el algoritmo 2M para acelerar ZGEMM. La figura 4 muestra la aceleración del esquema 2M con Ozaki-II frente al método 4M tradicional en GB200.
Ciencia de materiales con BerkeleyGW
Los investigadores usan el código BerkeleyGW para estudiar las propiedades físicas de los materiales que surgen de cómo los electrones cambian de estado de energía. Es un código masivamente paralelo que ya corrió a escala completa en supercomputadores de primer nivel. Con GPU, BerkeleyGW llega a ser 86 veces más rápido que la versión que usa solo CPU, y las mejoras más recientes de ZGEMM en cuBLAS lo aceleran todavía más.