La desagregación encode-prefill-decode, conocida como EPD, es una técnica de optimización de inferencia para modelos multimodales que separa la etapa del encoder de visión de las etapas de prefill y decode. Su mayor efectividad aparece en peticiones cargadas de imágenes, con salidas de longitud corta a media y en modelos de mezcla de expertos cuantizados.
NVIDIA documenta cuándo y cómo usar esta desagregación con NVIDIA Dynamo para alcanzar hasta 5 veces menos tiempo al primer token, métrica conocida como TTFT, y hasta 7 veces menos tiempo de respuesta de extremo a extremo. También aborda los escenarios donde la técnica no se recomienda.
Dynamo es un marco de inferencia de código abierto para servir modelos de IA en entornos distribuidos. Soporta desagregación EPD, separando estas fases en etapas escalables de forma independiente en lugar de ejecutarlas juntas con patrones de planificación y escalado fuertemente acoplados. Trabajadores dedicados al encoder pueden mejorar el agrupamiento, la eficiencia de memoria y el rendimiento general.
¿Por qué importa desagregar el encoder?
Una petición multimodal agrega trabajo antes de que pueda comenzar el prefill del modelo de lenguaje. La pila de servicio debe preprocesar el archivo y ejecutar el transformador de visión, o ViT, para producir los embeddings. En el servicio agregado, la codificación de visión, el prefill y el decode comparten un mismo trabajador y un mismo dominio de planificación. Este diseño simple funciona bien cuando el procesamiento de medios representa apenas una porción menor de la carga.
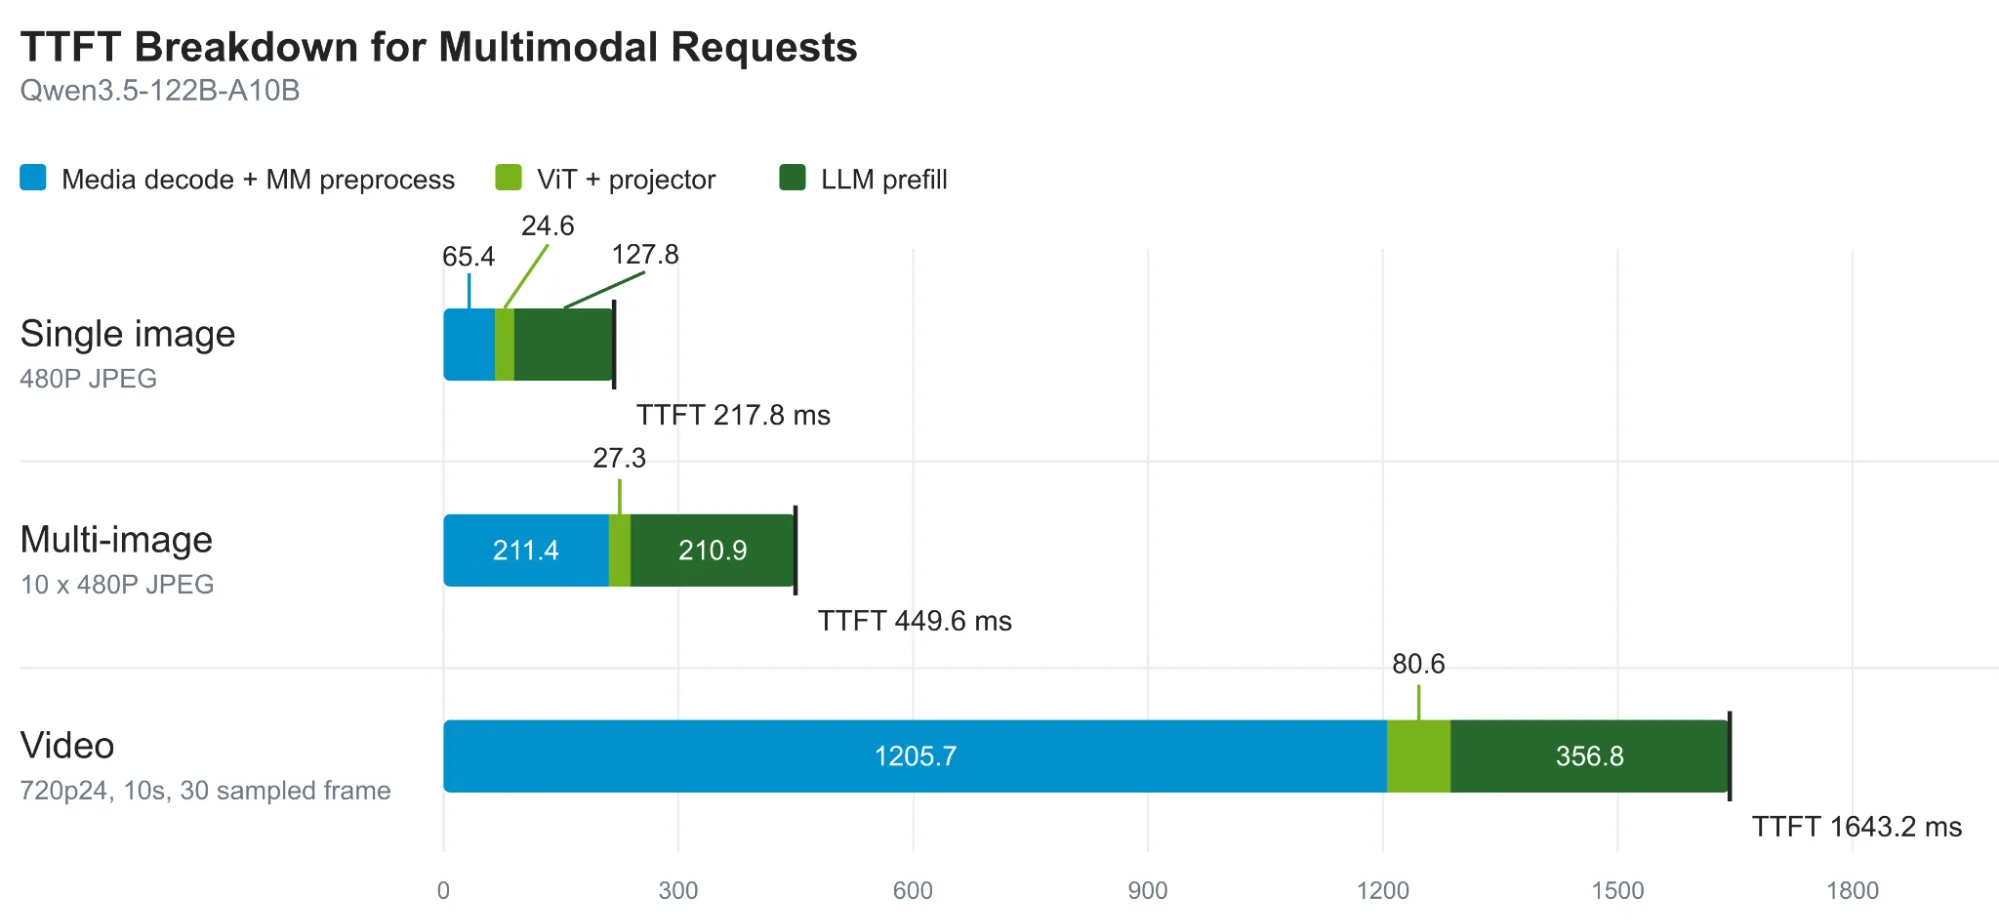
El equilibrio cambia a medida que las peticiones contienen más imágenes o video. La codificación de visión puede tomar cientos de milisegundos o más. Como el encoder y el modelo de lenguaje comparten la misma GPU, una petición cargada de medios puede retrasar su propio prefill y competir con el trabajo concurrente. Bajo tráfico mixto, incluso las peticiones de solo texto pueden quedar esperando detrás de las multimodales, aunque no requieran codificación de visión.
Dynamo implementa el servicio EPD separando los roles de encoder y de trabajador PD sin fijar su ubicación de hardware. Los trabajadores de encoder producen los embeddings de visión, mientras que los trabajadores PD los consumen y ejecutan el modelo de lenguaje. Esta separación permite que las etapas se agrupen, planifiquen y escalen de forma independiente, transfiriendo los embeddings mediante la biblioteca NIXL.
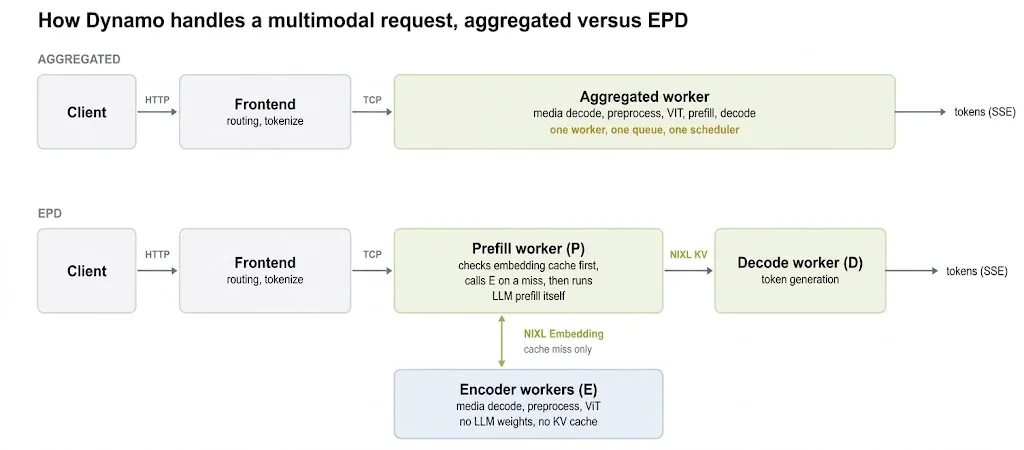
La desagregación del encoder puede reducir el TTFT y aumentar el rendimiento útil bajo un mismo acuerdo de servicio solo en ciertos escenarios. El trabajo de codificación que se aísla tiene que ser lo bastante grande como para compensar la coordinación entre trabajadores y el costo de transferir los embeddings.
Tres topologías de ubicación
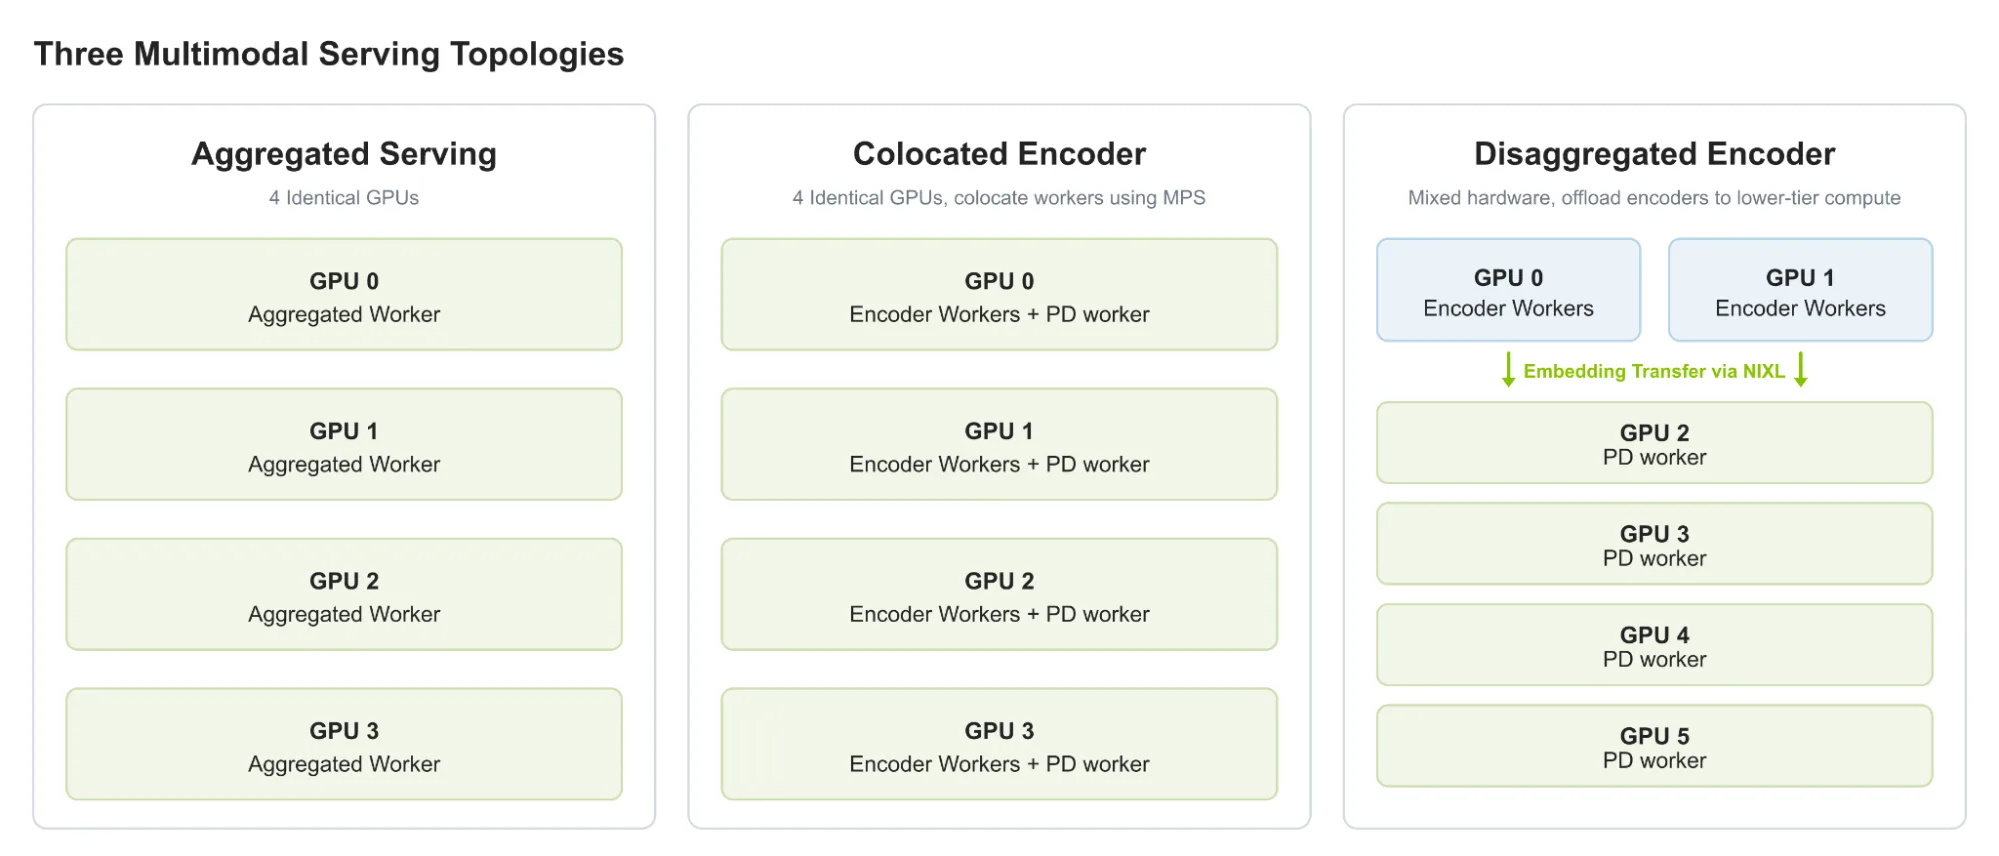
La Figura 3 compara el servicio agregado con las dos topologías desagregadas, colocada y desagregada:
- Agregado: cada GPU ejecuta un único trabajador agregado cuyo planificador gestiona codificación de visión, prefill y decode como parte del mismo ciclo de vida de la petición.
- Encoder colocado: cada GPU ejecuta uno o más trabajadores de encoder junto a un trabajador PD. Comparten el cómputo de la GPU pero mantienen colas y agrupamientos separados. En un clúster homogéneo suele ser la mejor opción, porque el encoder de visión es liviano frente al modelo de lenguaje y reservarle una GPU completa de la misma clase deja buena parte de ese hardware subutilizado.
- Encoder desagregado: se vuelve atractivo cuando el clúster incluye un nivel de GPU más barato y mejor ajustado al trabajo del encoder, mientras el nivel principal aloja los trabajadores PD. En el entorno de prueba, dos GPU NVIDIA RTX 6000D ejecutaron los trabajadores de encoder y cuatro NVIDIA GB200 los trabajadores PD.
La disponibilidad de hardware determina dónde puede correr el encoder, y las características de la carga determinan si separarlo rinde o no.
¿Qué define el beneficio de la desagregación?
El beneficio depende de cómo se reparte el trabajo entre codificación de visión, prefill y decode. EPD resulta más útil cuando la codificación representa una porción significativa del tiempo de procesamiento o limita el rendimiento. Las peticiones cargadas de medios suelen crear esa condición, pero la carga de medios por sí sola no determina el resultado: la longitud de salida, el tamaño y la precisión del modelo, y la mezcla de tráfico también alteran el balance.
Todos los benchmarks se corrieron con Qwen3.5 122B A10B en NVFP4, salvo en los experimentos de ablación de precisión, sobre cuatro GPU GB200 y con GPU RTX 6000D adicionales en el montaje desagregado. La transferencia de embeddings usó NIXL sobre UCX RC/TCP Ethernet, con un máximo medido de 20 Gbps. El acuerdo de servicio para el rendimiento útil fija la latencia entre tokens bajo 100 milisegundos.
Carga cargada de imágenes
La comparación usó peticiones de diez imágenes, con un tope de 256 tokens por imagen y una longitud de salida de 1.024 tokens, para simular una carga visual moderadamente pesada con salida larga.
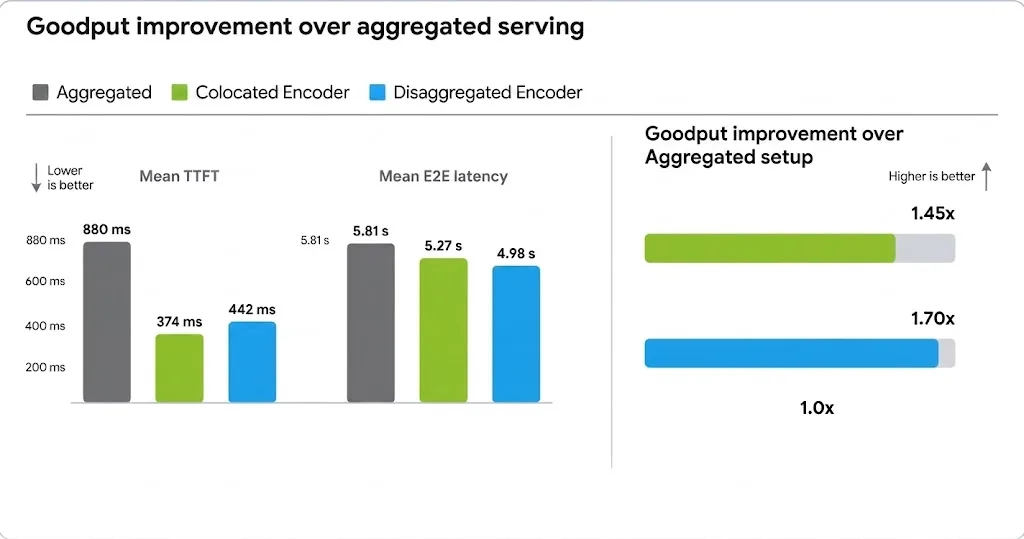
El TTFT cae 58% con encoder colocado y 50% con la configuración heterogénea. Las mejoras de extremo a extremo son modestas, porque una salida de 1.024 tokens implica que el tiempo de decode no se reduce al desagregar el encoder. La señal más fuerte está en el rendimiento útil: el nivel heterogéneo atiende 70% más tráfico con la misma latencia comprometida, porque se sumó capacidad de codificación sin tocar el presupuesto de las GB200.
¿Cómo influyen la carga de imágenes y la salida?
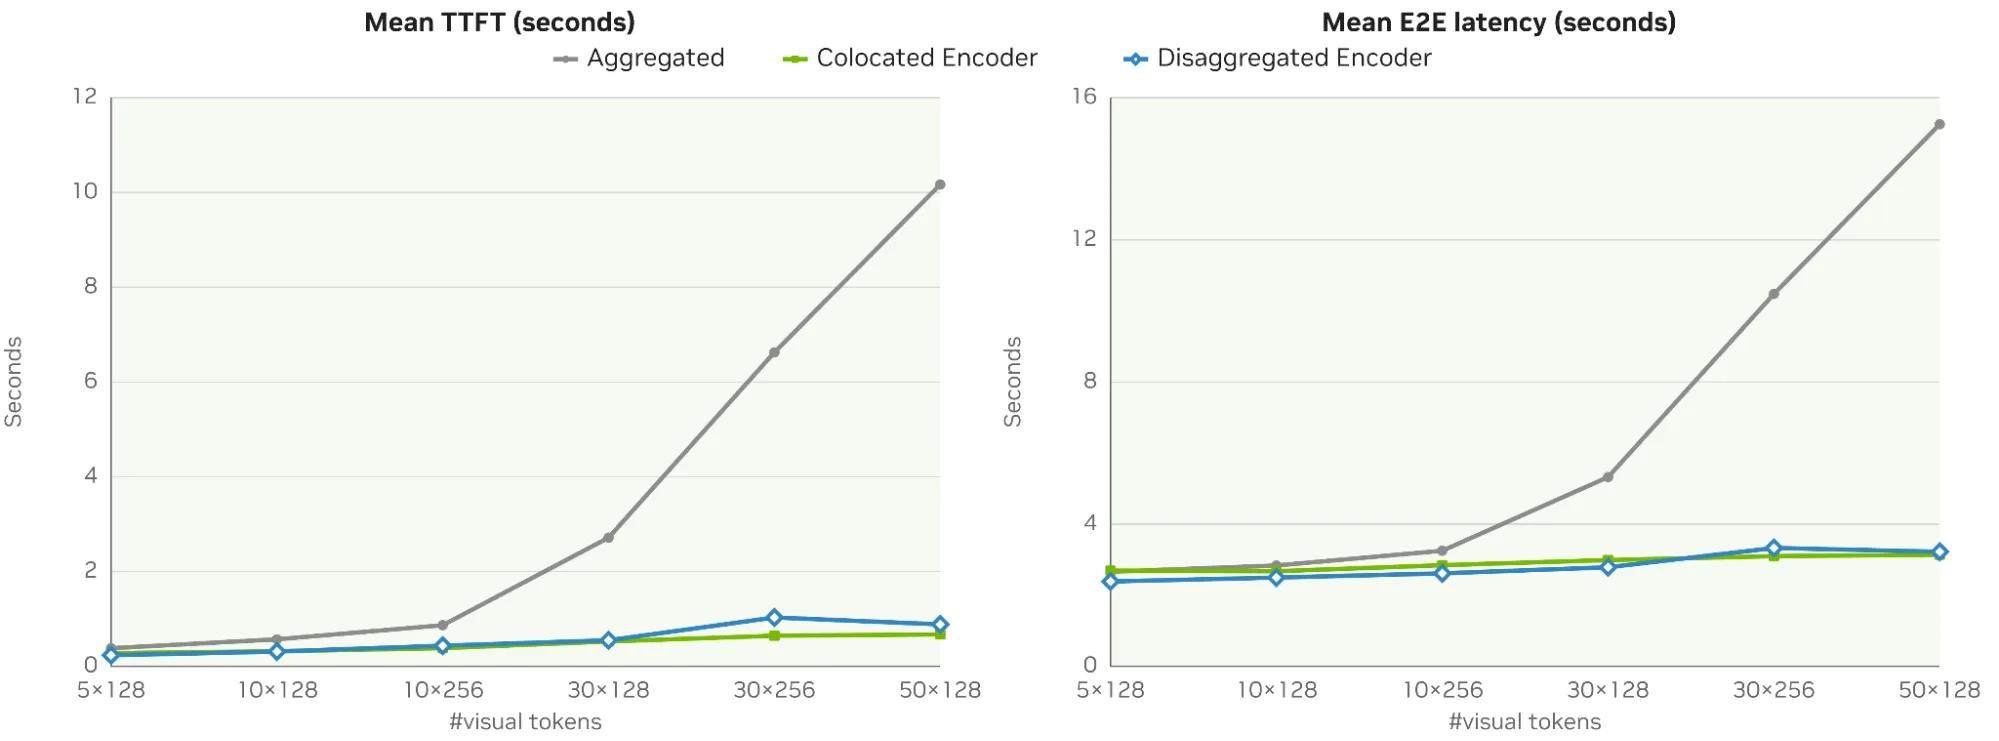
Los experimentos con entre 5 y 50 imágenes, cada una con presupuesto de 128 o 256 tokens y salida constante, muestran que el rendimiento se degrada en el escenario agregado, mientras se mantiene relativamente estable en ambas topologías desagregadas.
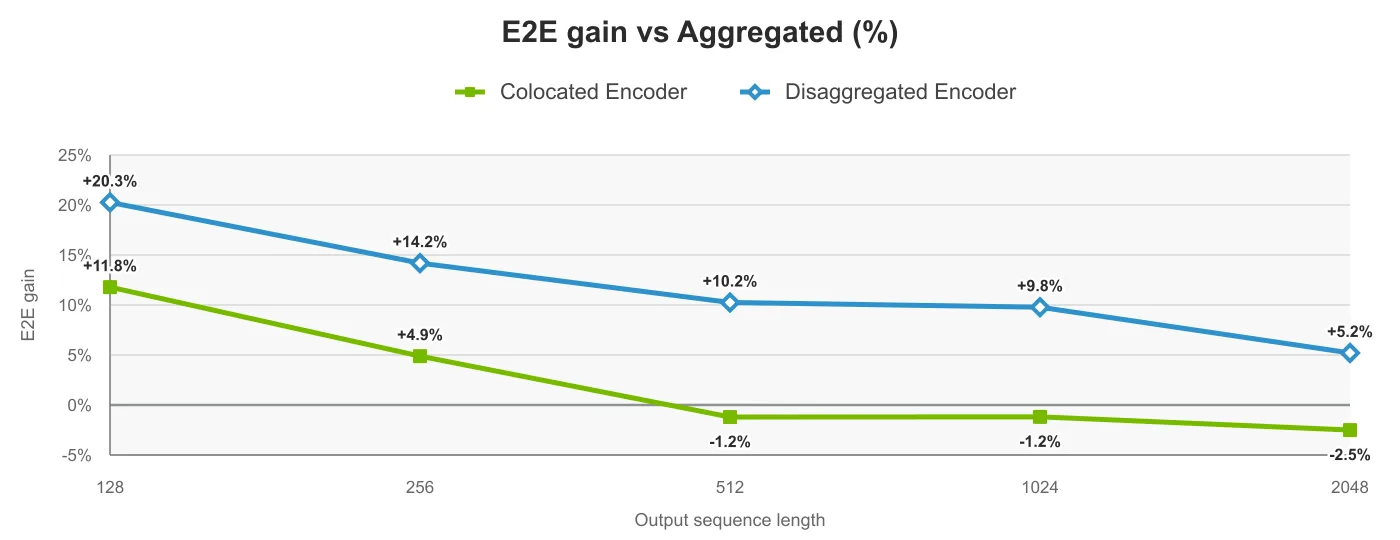
Al variar la longitud de salida entre 128 y 2.048 tokens con la carga fija en cinco imágenes, el TTFT permanece prácticamente igual, pero el tiempo de decode pasa a dominar la latencia total. La ganancia del EPD heterogéneo se angosta de 20,3% a 5,2%. El encoder colocado pasa de una ganancia de 11,8% a una regresión de 2,5%, porque sus trabajadores adicionales comparten las mismas GPU que los trabajadores PD.
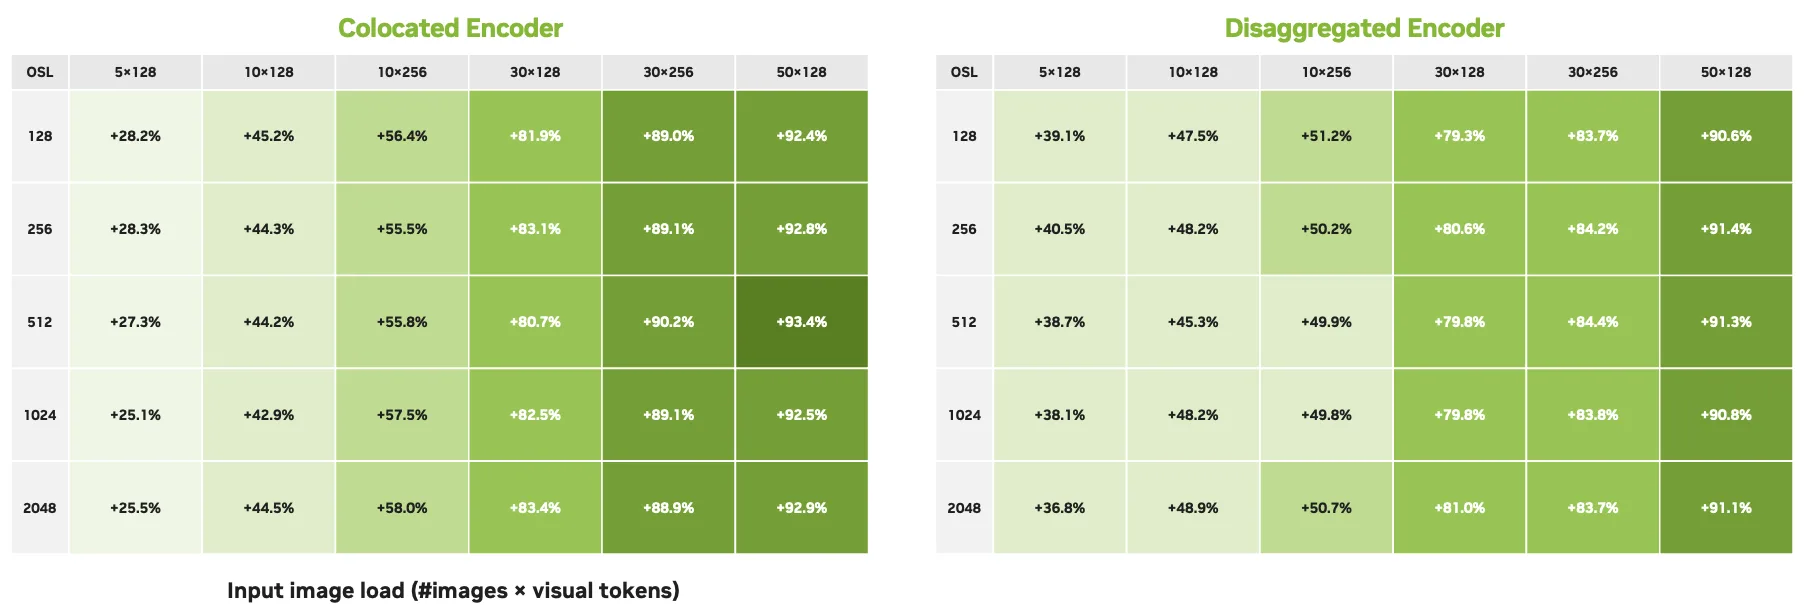
La desagregación del encoder entrega su mayor valor con alta carga de medios de entrada en casi todos los escenarios. En cambio, con salidas largas y poca carga de imágenes, desagregar el encoder compromete el rendimiento.
¿Qué pasa al cambiar el tamaño del modelo?
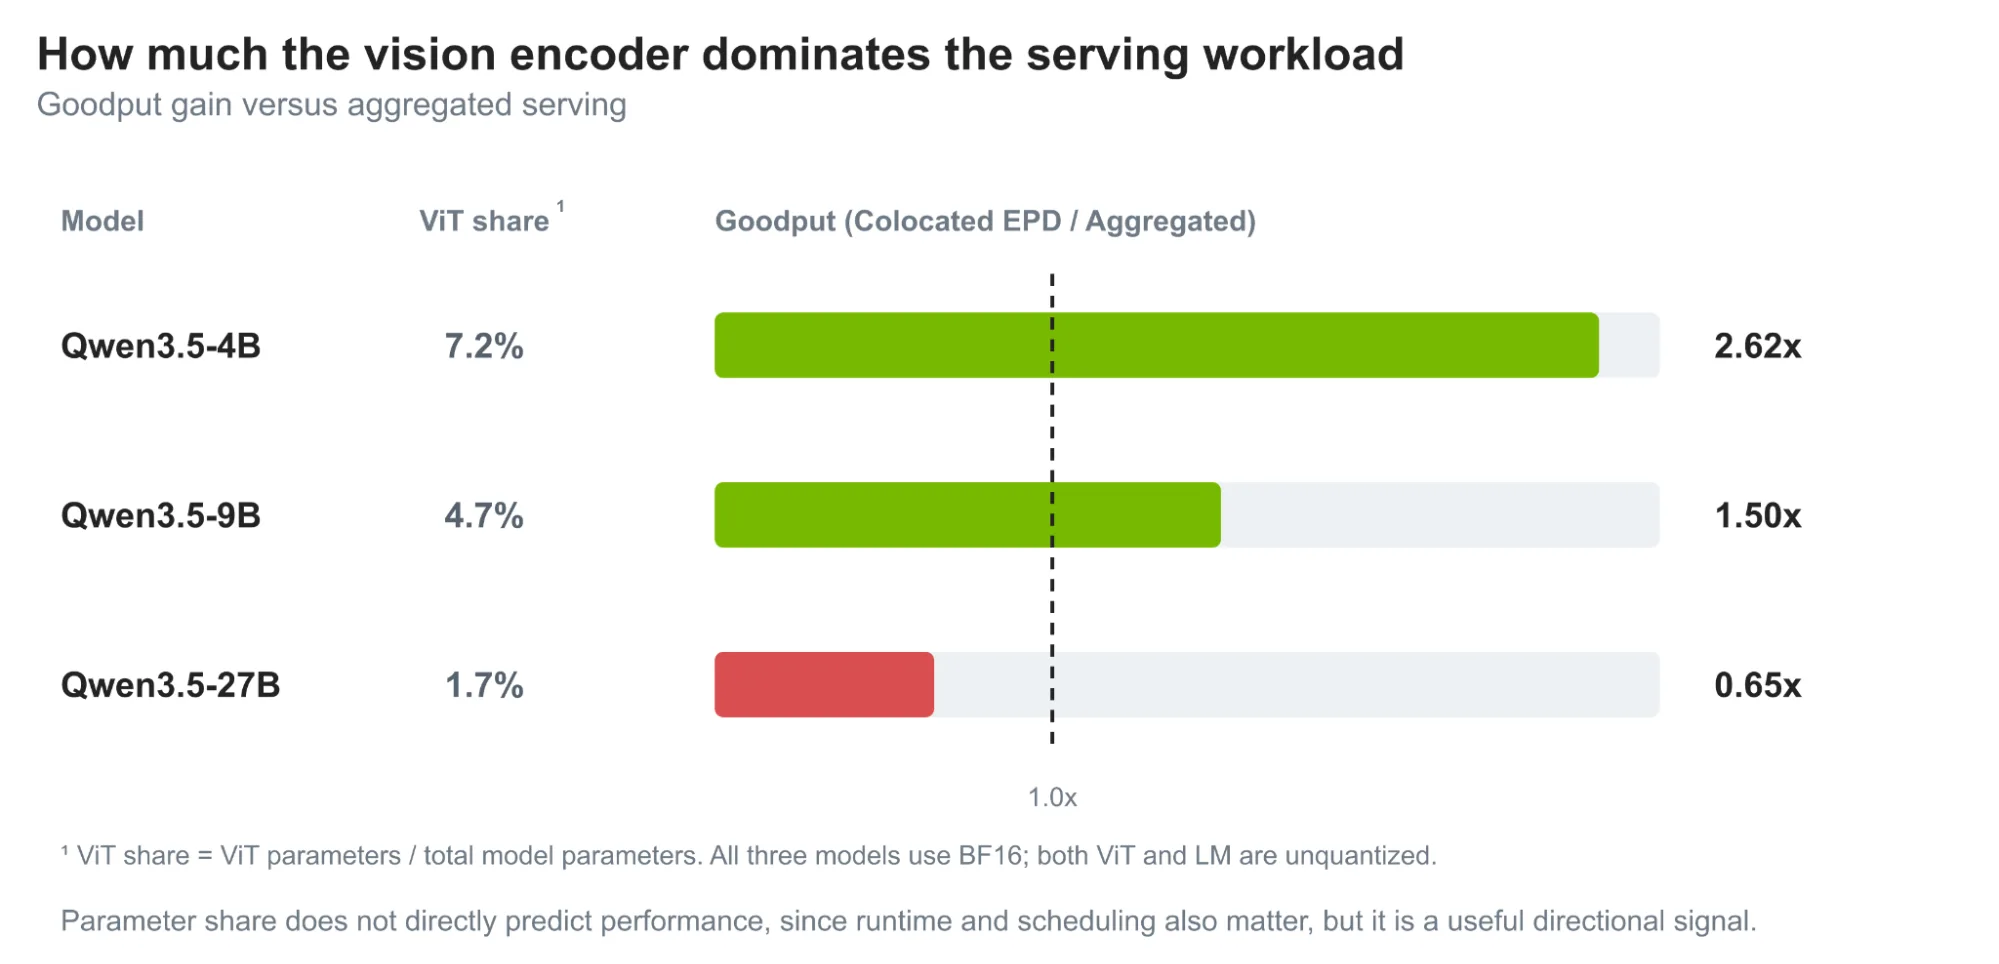
A medida que el modelo crece, el modelo de lenguaje representa una porción mayor de la carga mientras el encoder de visión mantiene aproximadamente el mismo tamaño. La ablación sobre Qwen3.5 de 4B, 9B y 27B muestra que la participación de parámetros del ViT baja de 7,2% a 4,7% y luego a 1,7%. El EPD colocado sigue la misma curva, entregando 2,62 veces, 1,50 veces y 0,65 veces el rendimiento útil del servicio agregado, respectivamente. En la configuración de 27B, el costo del modelo de lenguaje supera el beneficio de separar el encoder.
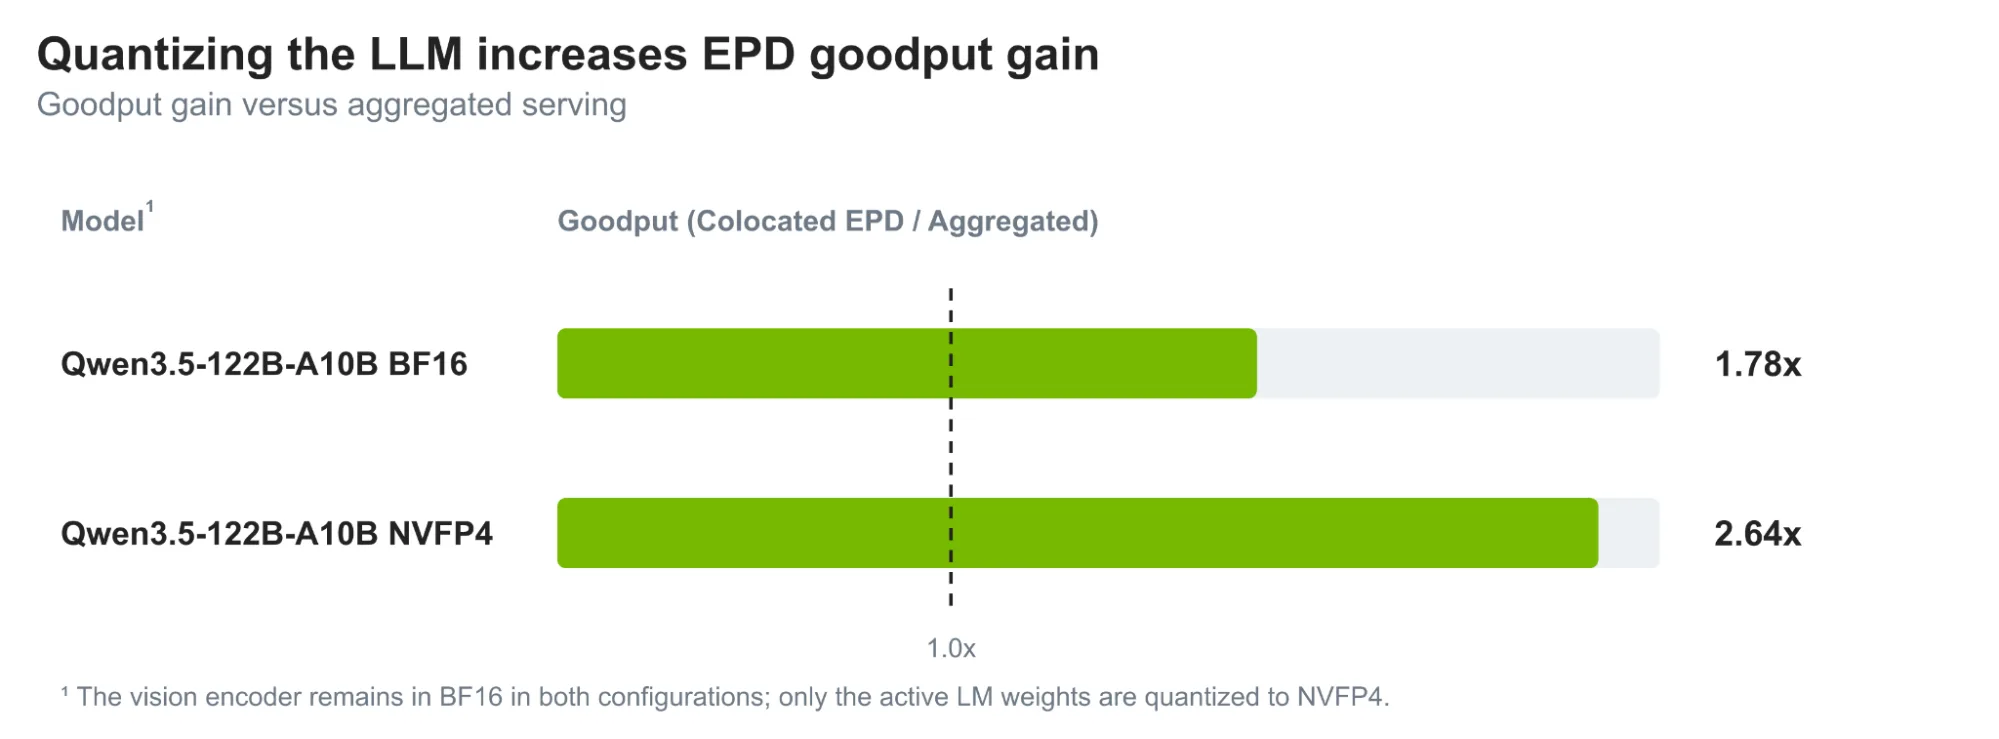
La precisión también mueve la aguja. Con encoder de visión y modelo de lenguaje en BF16, el EPD colocado entregó 1,78 veces el rendimiento útil del servicio agregado. Cuantizar solo los pesos activos del modelo de lenguaje a NVFP4 elevó esa ganancia a 2,64 veces.
La conclusión práctica es que la participación de parámetros es apenas un indicador indirecto del factor que realmente manda: el balance en tiempo de ejecución entre el paso del ViT, el prefill y el decode.