La mezcla de expertos, o MoE, se volvió una de las tendencias arquitectónicas que definen el entrenamiento de modelos grandes. DeepSeek, Qwen y Mixtral son ejemplos de modelos MoE que igualan o superan el desempeño de sus equivalentes densos con una fracción del cómputo de entrenamiento.
Los modelos MoE entrenan de forma eficiente gracias al cómputo condicional. En lugar de una red densa de propagación hacia adelante compartida por todos los tokens, el MoE la reemplaza por muchas redes expertas más chicas y un enrutador aprendido que decide cuáles Top-K expertos activar.
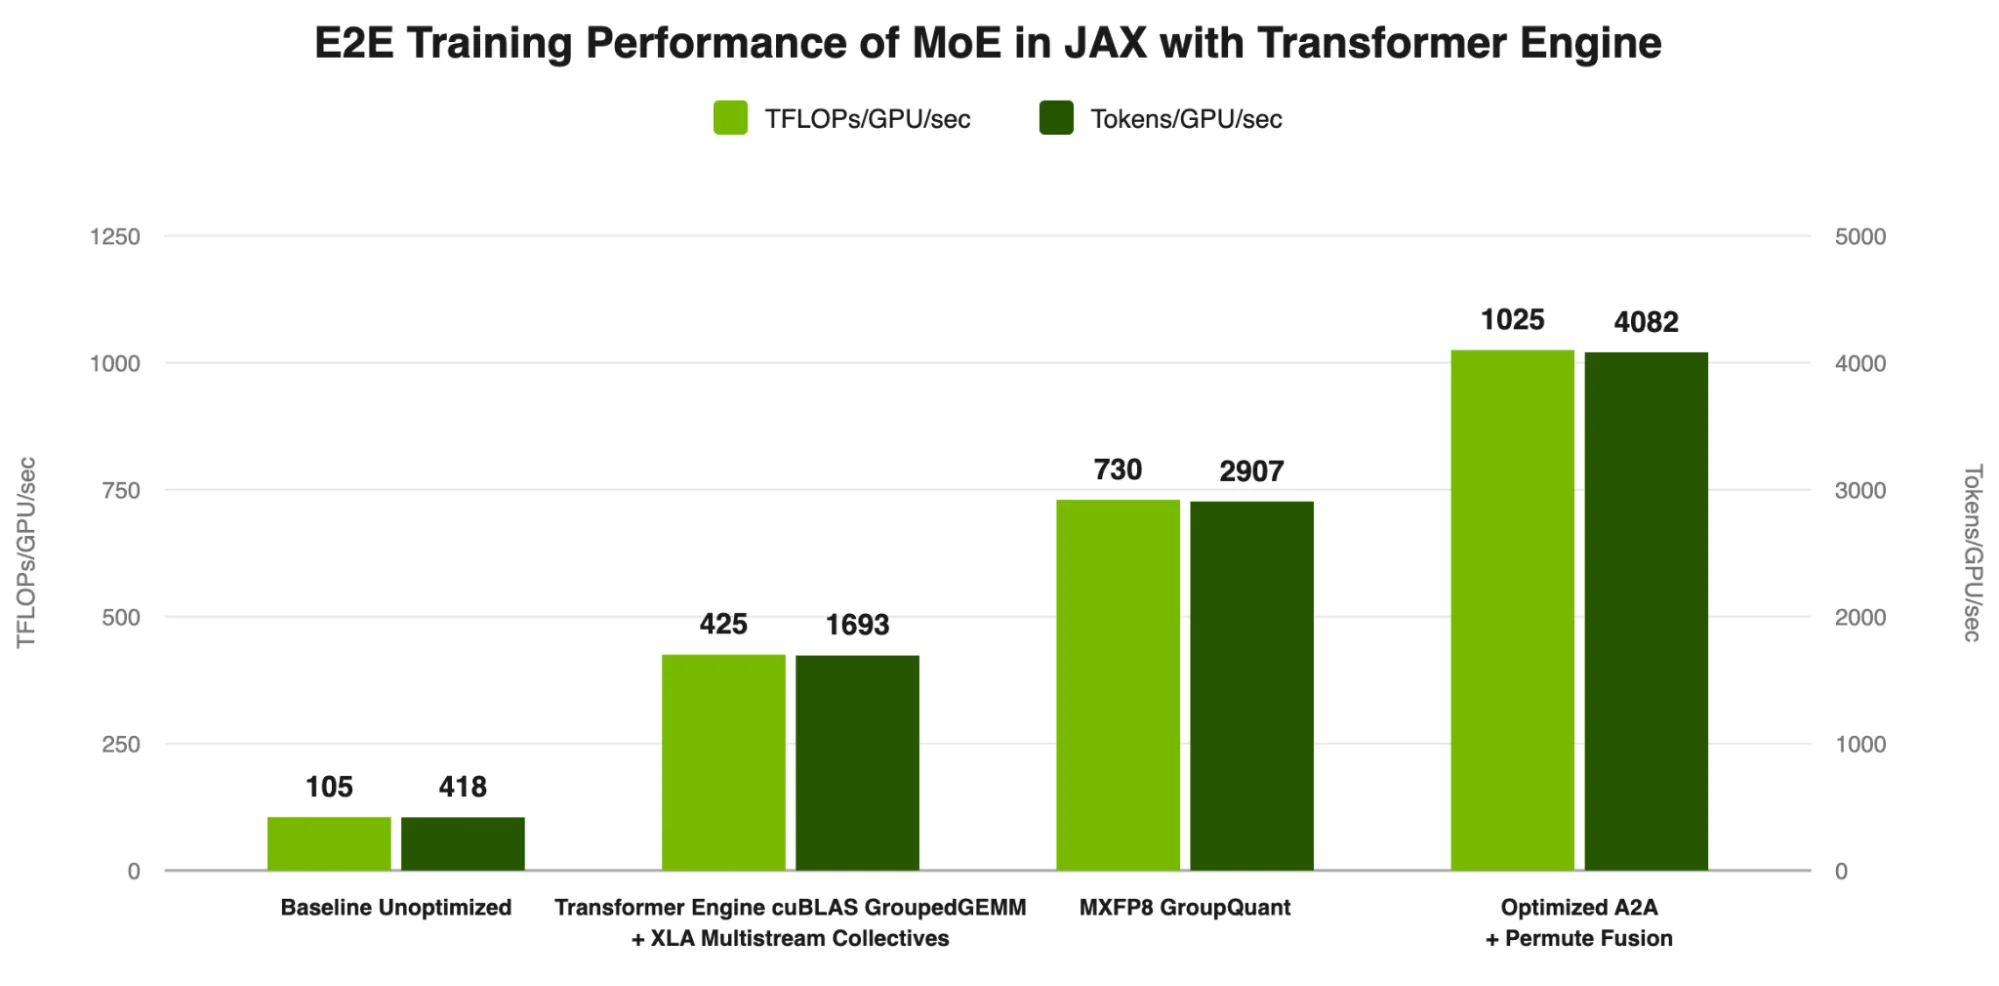
Hacer eficiente ese entrenamiento a escala es difícil. En el entrenamiento de DeepSeek-V3 sobre NVIDIA GB200, una línea base sin optimizar alcanzaba apenas 103 TFLOPS por GPU, con la comunicación entre GPU consumiendo el 84% del tiempo acumulado de kernel. Con la biblioteca JAX de Python y las optimizaciones de kernel dirigidas de NVIDIA Transformer Engine, ese número subió a 1.068 TFLOPS por GPU, una mejora de 10,4 veces.
¿Qué hace difícil entrenar un MoE?
El entrenamiento MoE a escala de producción introduce cuellos de botella que no existen con modelos densos. El enrutamiento de tokens, el despacho y la recolección de expertos, la comunicación de todos contra todos y los GEMM irregulares de expertos.
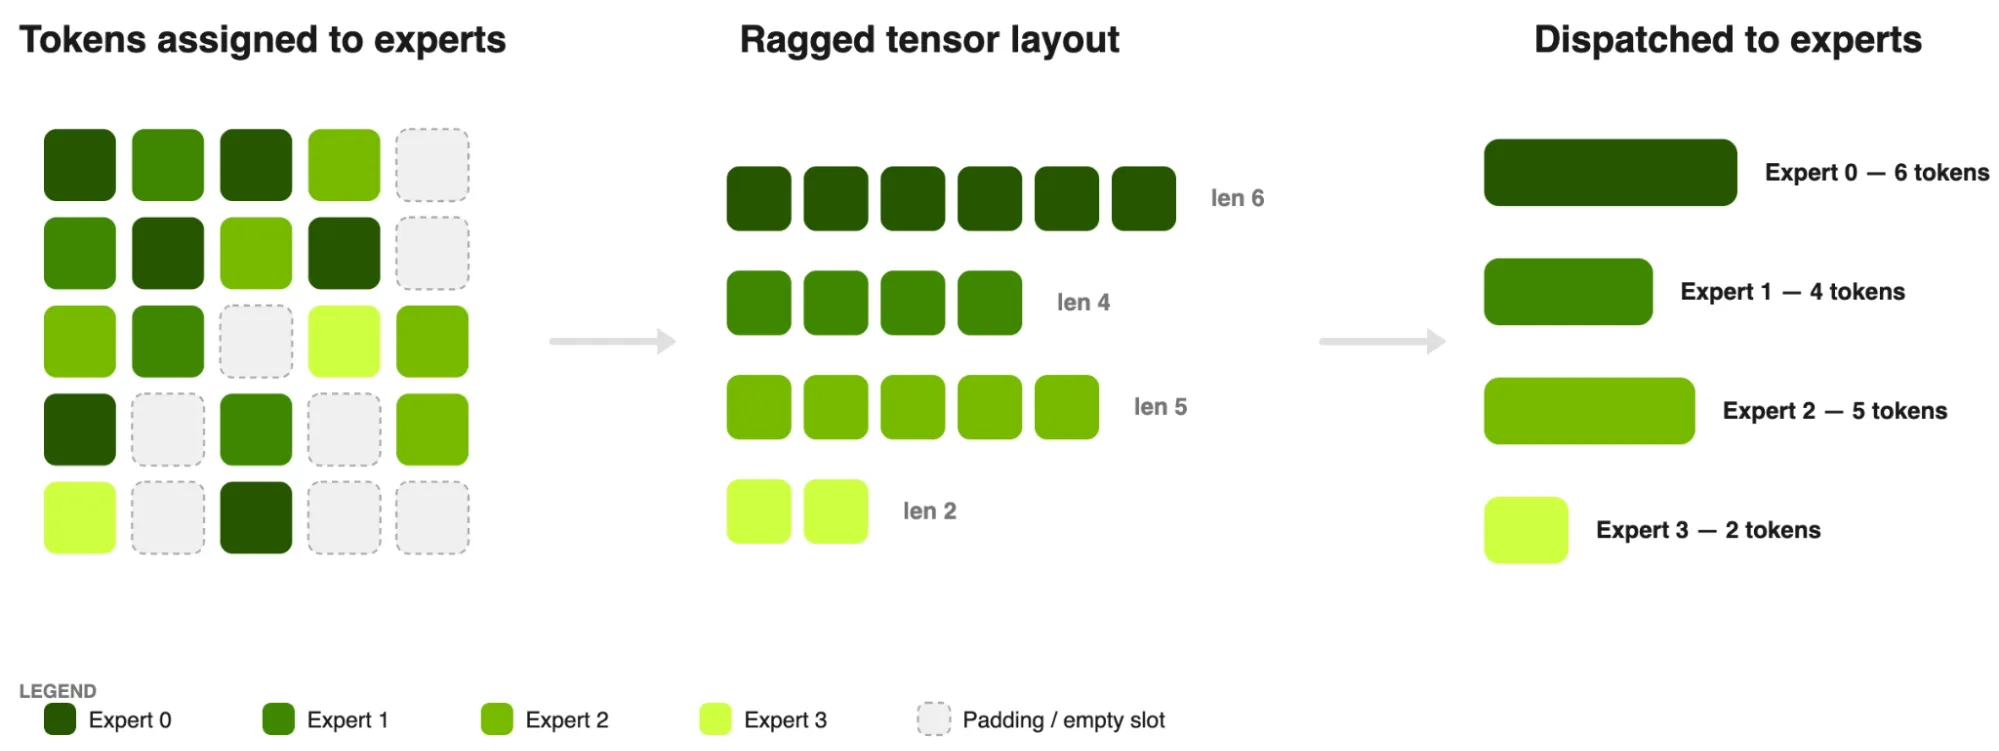
El problema se agrava porque el enrutador es aprendido. A lo largo del entrenamiento, la distribución puede quedar muy sesgada a medida que el enrutador desarrolla preferencias por ciertos expertos. No hay dos lotes que produzcan la misma carga de expertos y, dentro de un mismo lote, un experto puede recibir muchos más tokens que otro. Como cada experto recibe una cantidad distinta de tokens, no queda un GEMM rectangular limpio que agrupar y despachar. De ahí salen los tensores irregulares.
En el MoE, los tokens se enrutan dinámicamente hacia distintos expertos. Eso significa que la cantidad de tokens asignada a cada experto varía de forma impredecible, y el resultado son ragged tensors, tensores irregulares. Ahí está la dificultad, porque la mayoría de las bibliotecas están altamente optimizadas para operaciones tensoriales que esperan estructuras de datos uniformes y rectangulares.
Con paralelismo de expertos, los tokens deben despacharse y las salidas deben combinarse y restaurarse al orden original de los tokens. Si la ruta de despacho y combinación no está optimizada, la comunicación domina y las GPU quedan subutilizadas. Una operación de todos contra todos mal optimizada obliga a las GPU a detenerse y esperar datos antes de hacer cualquier trabajo útil.
Resolver esto exige kernels especializados capaces de manejar de forma nativa las disposiciones irregulares. Es exactamente el problema que las optimizaciones MoE de Transformer Engine están diseñadas para resolver.
¿En qué se diferencia el MoE sin descartes del MoE por capacidad?
El MoE sin descartes y el MoE por capacidad son dos maneras distintas de manejar el enrutamiento de tokens hacia los expertos.
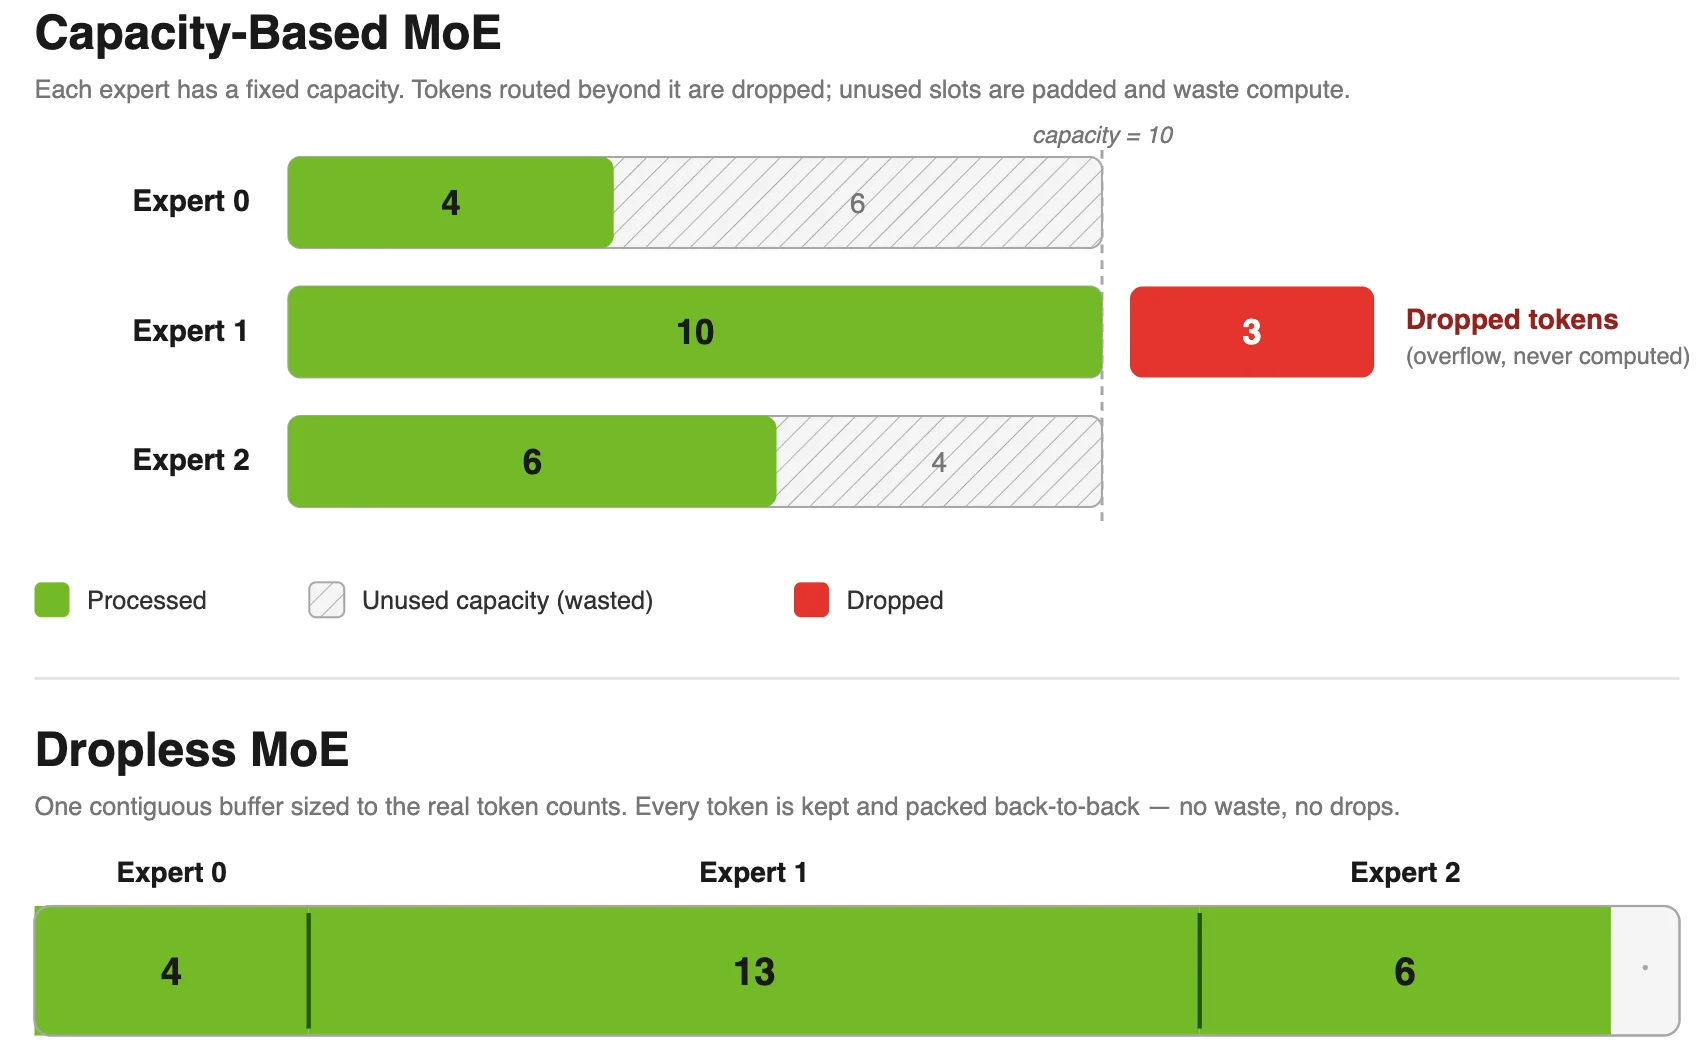
En el MoE sin descartes, cada token es procesado por el experto que le tocó, sin importar lo desbalanceada que quede la carga. Eso resulta atractivo para la calidad del modelo y exigente para el sistema. El trabajo MegaBlocks, entrenamiento disperso eficiente con mezcla de expertos lo abordó reformulando el cómputo de expertos como multiplicación de matrices dispersas por bloques, lo que permite que cada experto opere sobre una cantidad distinta de tokens sin descartar ni rellenar. Eso requiere kernels de GPU dispersos por bloques nuevos, GEMM agrupado optimizado, y primitivas de despacho y combinación diseñadas específicamente para conteos variables de tokens.
Los marcos de entrenamiento MoE por capacidad, en cambio, esquivan la complejidad del enrutamiento dinámico restringiéndolo. A cada experto se le asigna un presupuesto fijo de tokens, y todo lo que se desborda se recorta o se rellena para entrar. Eso mantiene el cómputo regular y amable con el hardware, al costo de un intercambio directo entre calidad del modelo y eficiencia.
| MoE por capacidad | MoE sin descartes | |
|---|---|---|
| Tokens por experto | presupuesto fijo | variable, según el enrutador |
| Qué pasa con el desborde | se recorta o se rellena | nada, todos se procesan |
| Forma del cómputo | regular y amable con el hardware | irregular, exige kernels propios |
| Costo | datos incompletos o cómputo y memoria desperdiciados | complejidad de implementación |
¿Qué optimizaciones específicas exige el MoE sin descartes?
Comprometerse con el MoE sin descartes significa que la pila de entrenamiento ya no puede apoyarse en formas fijas de experto. Cada kernel que toca cómputo de expertos tiene que manejar con eficiencia conteos variables de tokens. Significa además que el conteo de tokens de cada experto es variable y depende de los datos, así que los kernels deben aceptar formas dinámicas y funcionar también cuando esas formas quedan inaccesibles desde la CPU, para habilitar los grafos CUDA y evitar la recompilación.
Transformer Engine entrega los siguientes bloques de construcción que vuelven práctico este enfoque en JAX.
- Una cuantización MXFP8 consciente de grupos.
- Un GEMM agrupado MXFP8 sobre las multiplicaciones de matrices de expertos.
- Operaciones de paralelismo de expertos optimizadas para despacho y combinación.
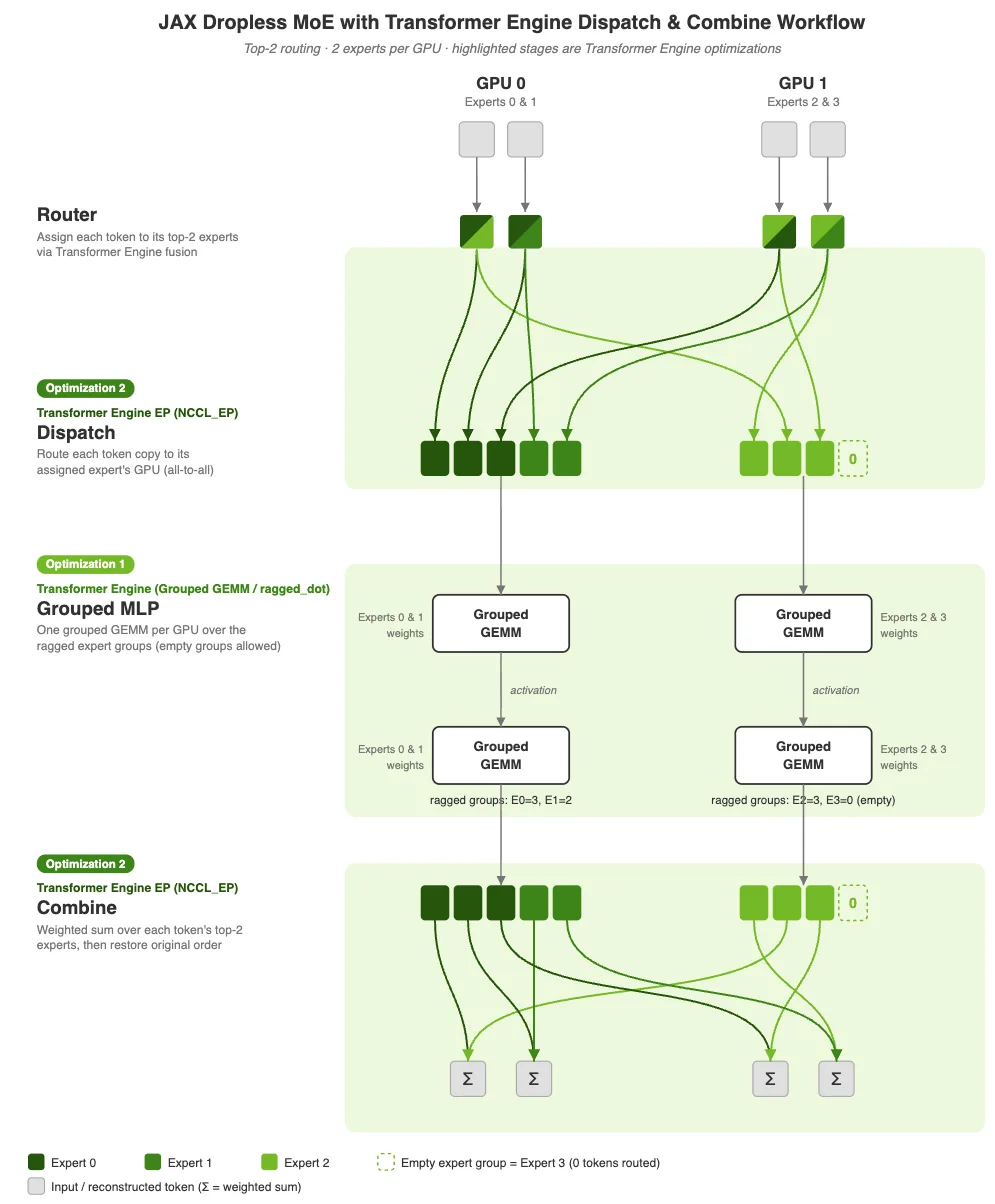
La Figura 3 muestra una capa MoE con paralelismo de expertos repartida en dos GPU. El enrutador asigna cada token a un experto y el despacho mueve los tokens hacia la GPU de su experto. El perceptrón multicapa agrupado corre dos GEMM agrupados sobre esos grupos de largo variable, y la combinación revierte el intercambio para restaurar el orden original de los tokens.
Optimización 1, el GEMM agrupado
En una red densa de propagación hacia adelante, cada token pasa por la misma matriz de pesos. En el MoE, el enrutador distribuye los tokens de forma despareja, así que cada experto recibe una cantidad distinta de tokens por paso y se rompe la forma regular de GEMM para la que están optimizados los kernels típicos.
Los enfoques anteriores incluían un bucle de kernels GEMM y los GEMM por lotes. El bucle exigía copias de dispositivo a host de los conteos de tokens. Eso queda en la ruta crítica, lo que suma la latencia de la transferencia de dispositivo a host y rompe los grafos CUDA. El GEMM por lotes calculaba la capacidad de tokens del peor caso incluso cuando se usaban menos, porque se rellenan para forzar un cómputo fijo de experto, lo que agrega cómputo extra.
Un GEMM agrupado resuelve esto manejando todas las multiplicaciones de matrices de expertos en una sola llamada de kernel, cada una con su conteo real de tokens. Calcula únicamente las regiones con tokens válidos, y por eso rinde más.
El grouped_gemm /ragged_dot de Transformer Engine respalda esto con cuBLAS y cuBLASLt, mapeando directamente sobre las bibliotecas GEMM de NVIDIA de mejor rendimiento para entregar utilización completa de los Tensor Core incluso con formas irregulares de experto. En GPU NVIDIA Blackwell, esta ruta abre además el escalado por bloques MXFP8 para las multiplicaciones de matrices de expertos, usando los kernels de cuantización agrupada de Transformer Engine.
Optimización 2, paralelismo de expertos para integrar despacho y combinación
Después de que los kernels fusionados del enrutador asignan cada token a sus expertos, el modelo tiene que mover físicamente esos tokens a los dispositivos correctos, procesarlos y traer los resultados de vuelta. El proceso se parte en dos etapas distintas.
- Despacho. Es donde ocurre el movimiento de tokens. Los tokens se permutan y se envían a través de las GPU hacia los expertos que les fueron asignados, un paso que involucra reordenamiento local y comunicación entre varias GPU.
- Combinación. Es donde los tokens procesados se enrutan de vuelta a sus GPU originales y sus resultados por experto se acumulan.
En una implementación ingenua, estas etapas corren como una cadena serial de operaciones separadas, con la GPU detenida entre pasos, los datos leídos y escritos en memoria varias veces, y la comunicación mayormente ociosa mientras corre el cómputo, y viceversa.
La implementación de paralelismo de expertos de Transformer Engine integra las etapas de despacho y combinación en una ruta de kernel fuertemente fusionada. Esa integración se apoya en NCCL EP, un backend de comunicación afinado específicamente para los patrones de tráfico irregulares y desbalanceados que produce el enrutamiento con paralelismo de expertos.
NCCL EP emplea además un mecanismo de deduplicación de tokens. Cuando un token se despacha a varios expertos en el mismo rango, o a varios rangos en un nodo InfiniBand remoto, atraviesa la red una sola vez y se replica en el nodo receptor, lo que conserva ancho de banda de red. El paralelismo de expertos es la contraparte del GEMM agrupado. El GEMM agrupado maneja lo que ocurre dentro de cada experto, y el paralelismo de expertos maneja todo lo que pasa alrededor.
Otras optimizaciones
Entre las optimizaciones adicionales están la descarga al host de JAX y las colectivas multistream de XLA.
Descarga al host en JAX
Las activaciones intermedias no tienen que quedar guardadas en el dispositivo durante todo el pase hacia adelante. JAX entrega APIs de rematerialización para descargar activaciones a la memoria del host. Para ahorrar memoria en el entrenamiento de DSv3, se descargan al host los resultados de las proyecciones de consulta y de valor. Hay más detalle en Reducing High-Bandwidth Memory Bottlenecks in JAX-Based LLM Training with Host Offloading.
Colectivas multistream de XLA
Mientras el paralelismo de expertos lo mueve NCCL EP de Transformer Engine, el FSDP optimizado lo maneja XLA de forma nativa. Por defecto, XLA corre la comunicación en un solo flujo, así que las colectivas que podrían ejecutarse en paralelo quedan serializadas y algunas terminan expuestas en la ruta crítica.
Las colectivas multiflujo dejan que el compilador planifique colectivas independientes de manera concurrente a lo largo de flujos CUDA separados, solapando las transferencias InfiniBand entre nodos con la comunicación NVIDIA NVLink dentro del nodo, para tirar de las dos redes a la vez en lugar de esperar un flujo serializado.
El planificador que esconde latencia, el Latency Hiding Scheduler, decide qué colectivas se pueden solapar sin riesgo analizando sus grupos de réplicas y revisando el riesgo de bloqueo mutuo. Así las ganancias de ancho de banda de memoria salen automáticas y no requieren anotación manual. Eso reduce de forma importante el porcentaje de colectivas expuestas en el entrenamiento de DSv3.
¿Cuál es el impacto en el rendimiento de entrenamiento?
NVIDIA observó una ganancia de 10 veces en throughput de extremo a extremo sobre DeepSeek-V3 de 671B, con MoE en JAX y las optimizaciones de Transformer Engine.
Conviene recordar que la pila de entrenamiento JAX de línea base estaba dejando sin usar la mayor parte del potencial del hardware. Atacando la pila capa por capa, se agregaron el GroupedGEMM de cuBLAS, las colectivas multiflujo de XLA, el GroupQuant MXFP8, la descarga de activaciones al host y, por último, una implementación optimizada de paralelismo de expertos.
El plan a futuro contempla sumar NVFP4, cuantización fusionada con el GEMM y solapamiento de todos contra todos. Hay más sobre las fusiones de kernel que vendrán en los enlaces de Transformer Engine para JAX en Boosting MoE Training Throughput with Advanced Fusion Kernels.
Escalar a varios racks con JAX
Entrenar modelos grandes a escala exige optimización agresiva. A escala de producción esto suma billones de tokens e ineficiencias considerables de tamaño de lote. Mientras en un nodo único resultan despreciables, a lo largo de miles de GPU se acumulan rápido, y eso vuelve crítico atacar cada cuello de botella de cómputo, de memoria y de comunicación.