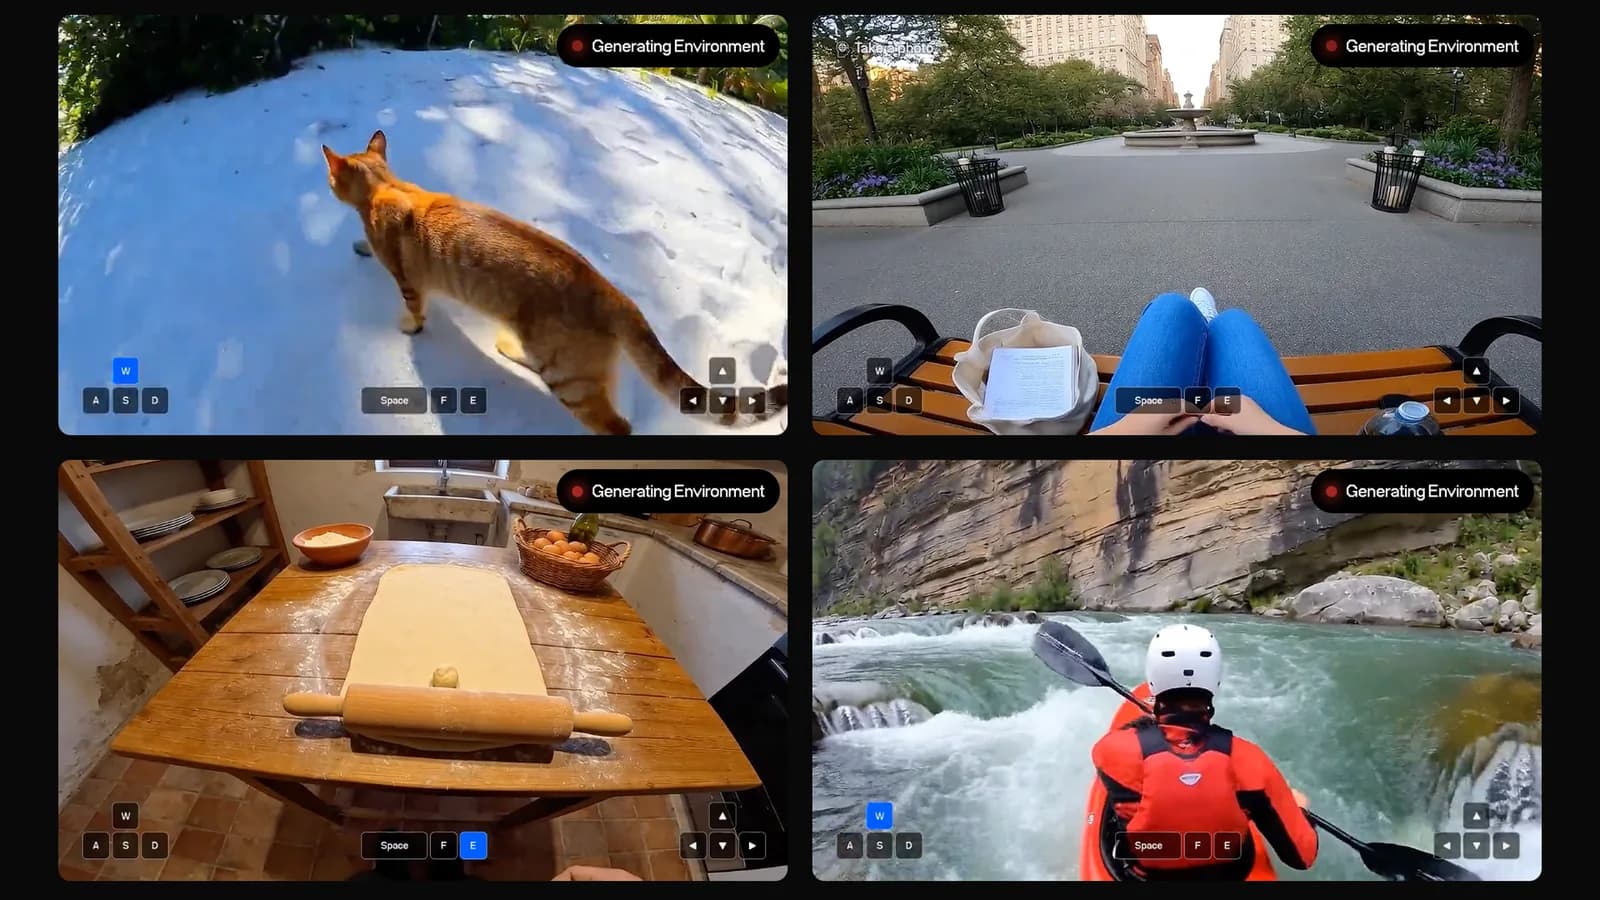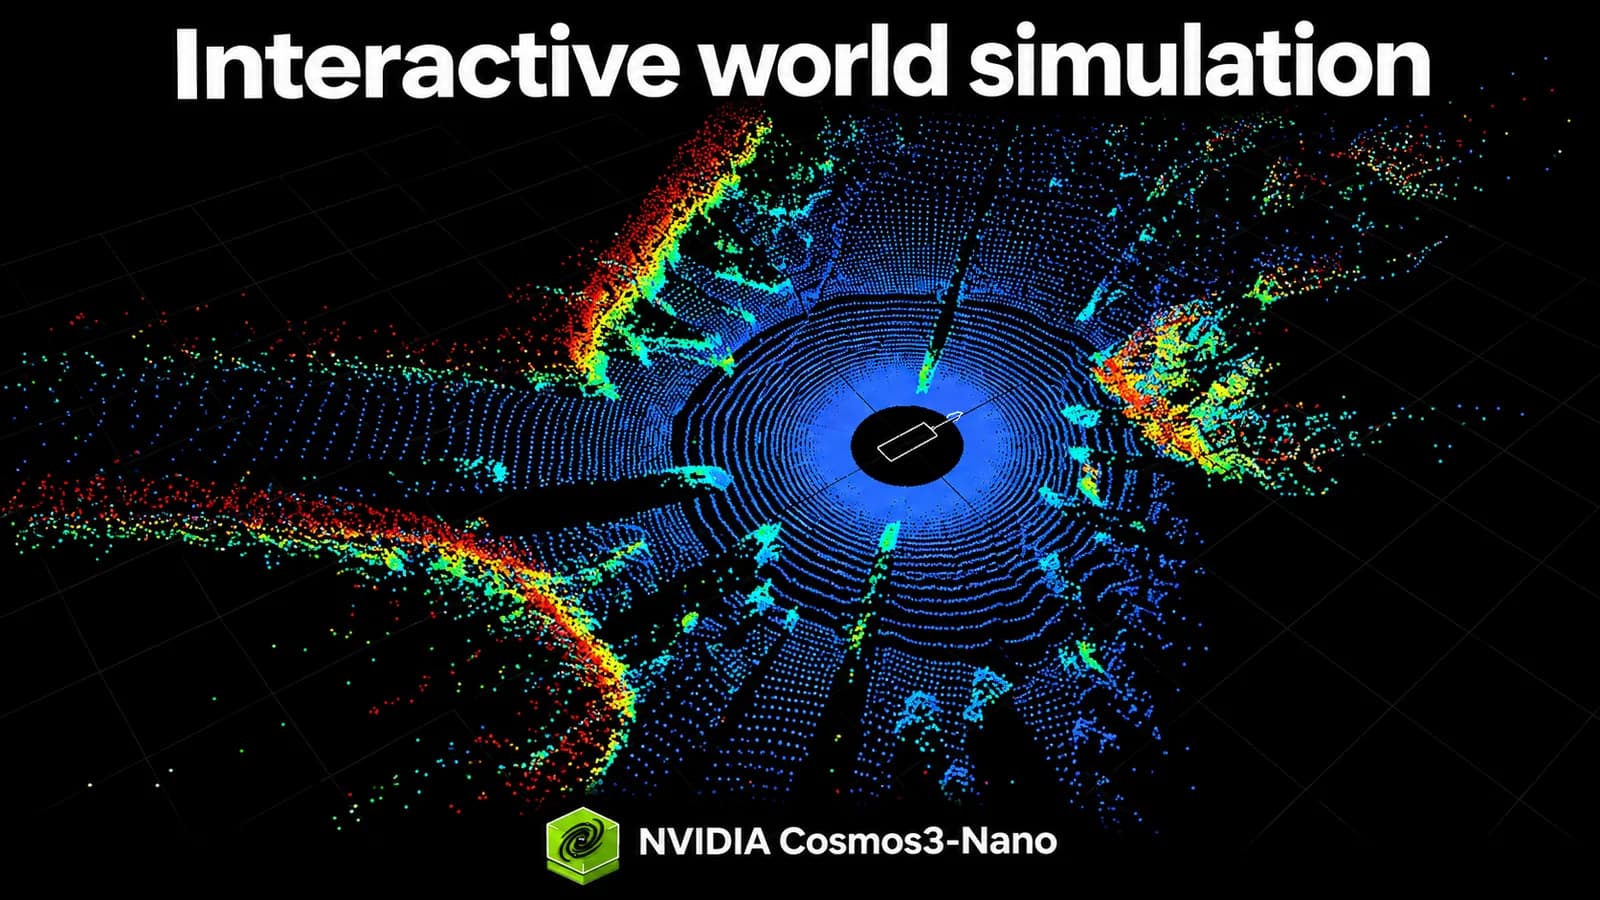
NVIDIA sumó cuatro checkpoints de pesos abiertos a la familia Cosmos 3, según el anuncio que la empresa publicó el 5 de noviembre en el blog de Hugging Face. Los modelos generan simulaciones interactivas y escenas de conducción con varias cámaras y sensores. NVIDIA Cosmos es la plataforma de la compañía para desarrollar modelos de mundo.
Los cuatro son estos:
- Cosmos3-Nano-Transfer-Auto, que genera datos de conducción desde varias vistas con distinto clima, iluminación y hora del día.
- Cosmos3-Nano-Sim-Auto, que entrega en streaming observaciones sincronizadas de cámara y LiDAR para simular conducción.
- Cosmos3-Nano-Sim-Transfer, que convierte los controles de un simulador y una instrucción de texto en video fotorrealista.
- Cosmos3-Nano-Sim-Bimanual, que predice el video que resulta de las acciones de un robot o de la cámara.
Los cuatro son ejemplos con post-entrenamiento de Cosmos 3 Nano y tienen 16.000 millones de parámetros entrenables. Usan la licencia OpenMDW 1.1, que permite el uso comercial y no comercial bajo sus términos. Los checkpoints se descargan acá, el informe técnico está en PDF y hay demostraciones en video.
¿Para qué sirven estos checkpoints?
La robótica necesita entornos que respondan a una acción aunque cambien la escena y el punto de vista. NVIDIA plantea dos caminos complementarios para construirlos. Sim-Bimanual predice las consecuencias visuales de una acción, y Sim-Transfer convierte los controles de un simulador físico en observaciones generadas.
En conducción autónoma, la apariencia y la geometría tienen que coincidir. Generar cámara y LiDAR de forma sincronizada conecta lo que se ve con la medición en 3D. Los controles de escena y de semáforos permiten variar el trazado de las calles y el estado de las luces, y luego estudiar cómo responde una política de conducción.
Cada observación puede influir en la siguiente acción. La generación en streaming une la predicción de video con una interacción continua, y eso permite estudiar cómo se encadenan acciones y observaciones.
NVIDIA dice que su objetivo es ayudar a investigadores y desarrolladores a crear mundos simulados más ricos. Los pesos abiertos y las recetas de post-entrenamiento son un punto de partida común para adaptar modelos, comparar métodos y aportar mejoras. La empresa reconoce que falta medir en qué casos los modelos sirven de verdad para aprender y evaluar políticas, entender sus límites y corregir donde fallan.
Transfer-Auto, de escenarios de conducción a datos multisensor
Cosmos3-Nano-Transfer-Auto es un modelo bidireccional para generar datos sintéticos de conducción fuera de línea. Produce video sincronizado de hasta 11 cámaras, incluidas ojos de pez, y admite la generación conjunta de RGB y LiDAR. Los controles World Scenario Map (WSM) de cada cámara fijan la estructura de la escena y el movimiento del tráfico, y el texto define la apariencia.
Se pueden variar las condiciones ambientales para ampliar la cobertura de entrenamiento y evaluación, con imágenes RGB iniciales opcionales que anclan el aspecto de la escena. La generación de LiDAR usa además controles de mapas HD alineados. Transfer-Auto también es la base para adaptar Cosmos a un juego de sensores y a un dominio de conducción propios. Se parte con un post-entrenamiento sobre datos propios para ajustar la disposición de cámaras, la configuración del LiDAR y el entorno. El modelo adaptado sirve directo para generar datos fuera de línea, o puede pasar por entrenamiento causal y una destilación de pocos pasos para simular en streaming. Ese fue el camino que dio origen a Sim-Auto.
NVIDIA publicó una skill abierta para correr la inferencia pensada para agentes de programación, y también un notebook de Transfer-Auto.
Sim-Auto, de controles de manejo a observaciones en streaming
Cosmos3-Nano-Sim-Auto es la variante de Transfer-Auto destilada de forma causal para streaming. Genera pedazos cortos y sucesivos de video de cámara y LiDAR sincronizados en pocos pasos de eliminación de ruido. Usa como historial lo que ya generó y los controles de manejo actualizados, lo que permite recorridos largos e interactivos.
Recibe una descripción por cámara y controles WSM sincronizados, con imágenes RGB iniciales opcionales. Para el LiDAR se suman controles de rango del mapa HD alineados con los de cámara. La interacción en lazo cerrado requiere un entorno de simulación y un renderizador WSM que actualicen esos controles a partir de las entradas de manejo. Para un juego de sensores nuevo, primero se adapta Transfer-Auto y después se destila en Sim-Auto.
También tiene su skill de inferencia y un notebook de Sim-Auto.
Sim-Transfer, de controles del simulador a imagen RGB
El simulador calcula el movimiento, los contactos y el estado físico. Sim-Transfer toma sus controles espaciales y una instrucción de texto, y genera las imágenes en color que consume una política. El ciclo va de la acción a la actualización del simulador, de ahí a los controles espaciales, luego a la imagen generada y por último a la siguiente acción.
Los controles disponibles son cuatro:
- Profundidad, la distancia relativa a la cámara.
- Segmentación, las regiones y los bordes de cada objeto.
- Bordes, los contornos de la escena.
- Desenfoque, la apariencia y la disposición generales.
El texto guía la apariencia. La física y el estado real se quedan en el simulador. Hay skill de inferencia y un notebook de Transfer.
Sim-Bimanual, de acciones a video
Cosmos3-Nano-Sim-Bimanual simula cómo cambia un entorno ante las acciones de un robot de dos brazos. Admite simulación interactiva para los robots YAM y AgiBot, controlados por una política o por una persona con joysticks.
Se parte de una imagen, se mueve el robot o la cámara y el modelo genera las observaciones siguientes. Una misma secuencia de control puede alternar entre cambios de punto de vista y manipulación.
El ejemplo de acciones mixtas usa 59 valores de control, que se rellenan hasta 64 durante el entrenamiento. Su esquema define marcos de coordenadas, rotaciones, calibración de la pinza, máscaras de validez y dominios de control, y hay que respetar esas convenciones para que cada valor describa el movimiento buscado. El tiempo tiene que quedar alineado. T transiciones necesitan T+1 observaciones. El entrenamiento transforma las capturas en bruto a la representación de acciones del modelo, y las acciones de inferencia publicadas ya vienen normalizadas.
La diferencia con Sim-Transfer es de dónde sale la imagen. Sim-Transfer la genera desde el estado actualizado de un simulador físico, y Sim-Bimanual genera la observación siguiente directo desde la escena y las acciones del robot. Los detalles están en el contrato de datos y en el esquema de acciones.
¿Qué hardware pide?
Linux, una GPU de NVIDIA, Docker y el NVIDIA Container Toolkit. La configuración publicada con vLLM-Omni se probó en una GB200, y NVIDIA aclara que eso no es un requisito mínimo de memoria. El servidor descarga los pesos y los clientes bajan las entradas de ejemplo. Para Sim-Bimanual hay skill de inferencia y un notebook de Bimanual.
¿Cómo funciona la generación en streaming?
La columna vertebral de Cosmos 3 es una mezcla de transformers que conecta, mediante atención, una red que procesa texto con otra que genera imagen. El generador predice cada segmento corto a partir de la instrucción, los controles disponibles y el historial ya generado. Luego decodifica las imágenes y actualiza ese historial.
La eliminación de ruido refina representaciones de video comprimidas y con ruido hasta obtener un segmento. La atención causal en el tiempo deja leer el historial y los controles, y bloquea las observaciones futuras. Una caché de claves y valores guarda la información de atención para la predicción siguiente.
El modelo trabaja sobre esas representaciones comprimidas, llamadas latents. Después de la imagen inicial, cada paso de tiempo latente equivale a cuatro cuadros RGB. Transfer predice un paso por bloque, y la configuración optimizada de Bimanual del informe predice dos. Con bloques más chicos, los controles nuevos afectan la generación más seguido.
La receta de entrenamiento en cuatro etapas
- Etapa 0, adaptación bidireccional. El modelo aprende el dominio y la relación entre controles y video desde clips grabados completos.
- Etapa 1, teacher forcing. Predice cada bloque desde observaciones grabadas anteriores y los controles disponibles, con la respuesta correcta y los objetivos futuros ocultos.
- Etapa 2, destilación por consistencia. Un modelo maestro congelado entrena a un alumno que genera cada bloque en cuatro pasos de eliminación de ruido.
- Etapa 3, self-forcing. El entrenamiento usa el historial que generó el propio alumno, y un maestro congelado junto a un modelo auxiliar de puntaje entregan la señal de ajuste de distribución.
La última etapa existe porque los errores se acumulan. Un objeto mal predicho pasa a ser contexto de los cuadros siguientes, y el self-forcing expone al modelo a ese historial generado durante el entrenamiento. La destilación y la caché bajan el costo de producir cada observación.
Adaptarlos con datos propios
Las recetas de post-entrenamiento parten de Cosmos3-Nano o de pesos base compatibles y cubren las cuatro etapas. NVIDIA recomienda guardar los checkpoints completos de entrenamiento para poder retomarlo, porque los pesos exportados para inferencia no incluyen el estado del optimizador.
- Transfer-Auto, para post-entrenar con datos de conducción propios, adaptarlo al juego de sensores y generar datos sintéticos fuera de línea.
- Sim-Auto, para aplicar entrenamiento causal y destilación a un Transfer-Auto ya adaptado.
- Sim-Transfer, para post-entrenar con preparación local de datos, configuración por etapa y retoma.
- Sim-Bimanual, para post-entrenar según el robot con validación de datos, configuración por etapa, traspaso de checkpoints y exportación.