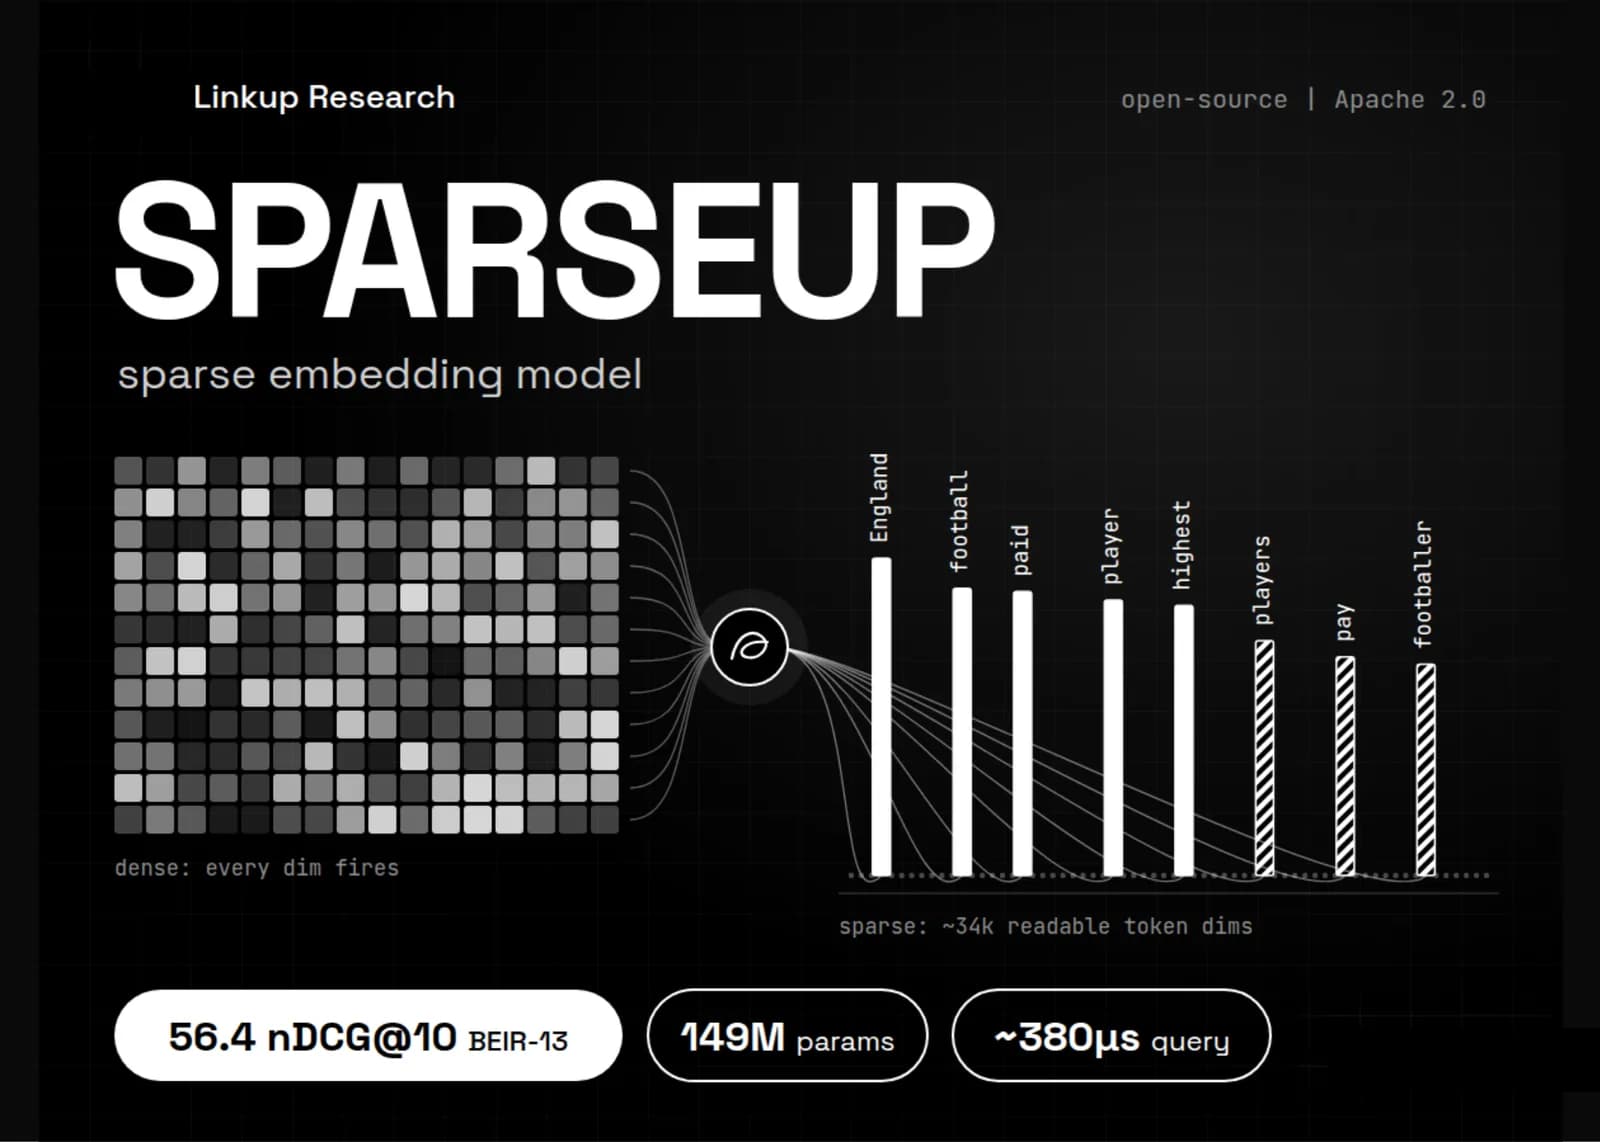
Linkup Research liberó SPARSEUP, un modelo de embeddings dispersos aprendidos que corre sobre un backbone ModernBERT de 149 millones de parámetros y sale bajo licencia Apache 2.0. El equipo reporta 56,4 de nDCG@10 promedio en BEIR-13 y lo describe como el codificador disperso público más fuerte basado en vocabulario que conoce por debajo de los 150 millones de parámetros.
Se puede usar hoy. Los pesos están en Hugging Face bajo Apache 2.0, y el modelo carga desde Transformers o Sentence Transformers con trust_remote_code=True.
¿Por qué un modelo disperso?
La mayoría de los modelos abiertos de recuperación son densos, o sea entregan un vector por texto. Los dispersos, en cambio, reparten pesos sobre el vocabulario. Cada dimensión corresponde a un token real, así que los vectores entran en un índice invertido y una persona puede leerlos. Además suelen calzar bien con las palabras poco frecuentes.
El disparador fue la publicación de DenseOn y LateOn, de LightOn, que liberó datos abiertos, una receta de entrenamiento, un modelo denso y uno de interacción tardía. SPARSEUP llena la casilla dispersa que faltaba. Usa la misma familia de backbone y los mismos datos de ajuste fino, de modo que los tres estilos de recuperación quedan comparables lado a lado.
¿Cómo está construido?
El entrenamiento parte desde LateOn-unsupervised. Ese punto de control no traía cabezal de modelado de lenguaje enmascarado, así que el equipo le injertó de vuelta el original de ModernBERT. El ajuste fino se hizo con la mezcla de datos de LightOn, solo con aprendizaje contrastivo. Cada consulta recibe 7 negativos difíciles tomados de un conjunto de 50, más los negativos del propio lote. No hay destilación desde un cross-encoder y el entrenamiento cabe en una sola H100.
Un SPLADE corriente sobre este backbone producía bolsas enormes llenas de palabras vacías. Linkup lo corrigió con tres cambios.
- Desplazamiento de logits. El codificador calcula
log(1 + ReLU(x - 15)). Los logits del cabezal de ModernBERT quedaban demasiado altos, saturaban el logaritmo y dejaban las bolsas densas desde la inicialización. - Top-k por posición. Cada token de entrada conserva solo sus 12 dimensiones de vocabulario más fuertes antes del max pooling. Eso limita la expansión por token, no el tamaño total del vector.
- Plegado de mayúsculas. El BPE a nivel de bytes guarda
heat,Heat,ĠheatyĠHeatcomo identificadores distintos. SPARSEUP los pliega en uno solo y se queda con el peso mayor. Las dimensiones de salida bajan de unas 50 mil a unas 34 mil.
Las consultas y los documentos llevan prefijos [Q] y [D], y el puntaje es un producto punto. En la evaluación, el largo máximo es de 128 tokens para consultas y 512 para documentos.
Los números contra DenseOn y LateOn
La comparación controlada es menos halagadora que el titular. Con el backbone y los datos fijos, LateOn anota 58,9, DenseOn 57,9 y SPARSEUP 56,4. Hay una diferencia de método que conviene tener presente, porque SPARSEUP mide con búsqueda aproximada Seismic mientras LightOn reporta búsqueda exacta.
SPARSEUP gana en ArguAna y en Touché, y le saca ventaja a DenseOn en HotpotQA. Se queda atrás en los conjuntos más semánticos, con FiQA marcando la brecha mayor y DBPedia como el otro punto débil. Sobre BEIR descontaminado la distancia con DenseOn se achica a 0,17 puntos, aunque Linkup advierte que las versiones descontaminadas de NQ y MS MARCO tienen apenas 21 y 46 consultas, así que ese resultado es ruidoso.
Velocidad y dispersión
En MS MARCO, SPARSEUP promedia 47 términos distintos de cero por consulta y 190 por documento. SPLADE-v3 promedia 25 y 170. Con el índice invertido Seismic alcanza más de 97% de recall contra la búsqueda exacta en unos 380 microsegundos por consulta, en un solo hilo. Linkup señala que inflar el tamaño del vector podría sumar entre 1 y 2 puntos de BEIR, y que prefirió mantenerlo disperso. Los detalles técnicos están en el blog de la empresa.