El entrenador AsyncGRPOTrainer de TRL ya puede entrenar un adaptador LoRA y sincronizar solamente ese adaptador hacia vLLM. La función llegó con el PR 7017 y se despacha con TRL v1.14. Un adaptador de rango 1 pesa unos pocos megabytes, así que puede viajar por un bucket de almacenamiento montado en cada Job en lugar de cruzar por NCCL.
El entrenador y las réplicas de vLLM corren como Jobs separados de Hugging Face, en máquinas separadas. Un proxy chico puesto delante de las réplicas agrega la cabecera de autenticación, enruta cada despliegue hacia la réplica que ya tiene su prefijo de caché KV, y difunde las cargas de adaptador a todas las réplicas. Cinco corridas llevaron la misma receta de 3 horas 27 minutos a 53 minutos para 500 pasos.
¿Por qué LoRA encaja tan bien en aprendizaje por refuerzo?
El entrenamiento con LoRA es particularmente apropiado para aprendizaje por refuerzo, como muestra el artículo LoRA Without Regret de Thinking Machines. Ahí demuestran que LoRA puede igualar al ajuste fino completo en aprendizaje por refuerzo por gradiente de política, incluso con rango 1. Eso nace de que la función de ventaja entrega apenas del orden de un bit de información por episodio, así que no hay tanto que aprender en cada paso desde el punto de vista de la cantidad total de bits. Un adaptador de rango 1 tiene capacidad suficiente para absorberlo.
El entrenamiento con LoRA tiene además una consecuencia de sistemas. Un adaptador de rango 1 para un modelo de 1,5B pesa unos pocos megabytes, mientras el modelo completo ronda los 3 GB. En vez de mandar la política completa a los trabajadores de inferencia después de cada actualización, basta con mandar el adaptador. vLLM además puede mantener varios adaptadores cargados a la vez. Los despliegues antiguos terminan con la política con la que partieron, y los nuevos usan la última.
El problema de correr esto sobre Hugging Face Jobs
El AsyncGRPOTrainer de TRL ya separa entrenamiento y generación. El entrenador y vLLM pueden correr en máquinas distintas y a su propio ritmo. Eso es fácil en un nodo único o en un clúster, donde los dos procesos comparten sistema de archivos o pueden formar un grupo NCCL.
Lo que se buscaba era correr el mismo montaje con Hugging Face Jobs. En esencia, un Job de HF es un contenedor corriendo en una máquina virtual. Eso significa que un Job no puede levantar varios nodos, al menos por ahora, para sostener un entrenador y una flota de servidores vLLM, con un tope de 8xH200 por nodo. El AsyncGRPOTrainer está construido justo para esa escala, así que la pregunta pasó a ser hasta dónde se llega si se abandona el requisito de que el entrenador y los servidores de inferencia compartan nodo.
Con una sincronización de pesos completos, la respuesta sería "no muy lejos". Cada actualización tendría que mover gigabytes entre máquinas, que es para lo que existe NCCL en un clúster denso, y los Jobs no pueden comunicarse entre nodos. No hay disco local compartido y obviamente tampoco hay localhost compartido.
Con LoRA, una sincronización pesa apenas unos megabytes. Para la parte de sistema de archivos, los Jobs de HF ofrecen volúmenes respaldados por Storage Buckets. Esos buckets se montan como sistema de archivos FUSE en cada Job y alcanzan para funcionar como sistema compartido entre nodos. No hace falta ninguna ruta de red entre los Jobs.
El montaje terminó siendo bastante chico.
- Un Job entrenador corriendo
AsyncGRPOTrainercon LoRA, y con FSDP. - Dos Jobs de vLLM, cada uno sirviendo el modelo base más el adaptador que el entrenador haya publicado por última vez.
- Un bucket de almacenamiento montado en los tres al mismo path, que es por donde el adaptador llega del entrenador a los servidores.
- Un servidor proxy, que enruta cada despliegue hacia la réplica con más probabilidad de tener su caché KV, y difunde cada actualización de adaptador a todas las réplicas.
Cómo viaja el adaptador
La nueva ruta de sincronización de solo adaptador en AsyncGRPOTrainer funciona así. El entrenador no manda tensores a vLLM. Cada varios pasos del optimizador guarda el adaptador bajo <output_dir>/.vllm_lora/trl-policy-v{N}, publica el directorio con un renombrado atómico, y después manda su ruta al endpoint /v1/load_lora_adapter de vLLM. vLLM carga los archivos desde disco, y entonces el trabajador de despliegue puede pedir model="trl-policy-v{N}".
Así es como ya funciona la carga de adaptadores en tiempo de ejecución en vLLM. El endpoint recibe una ruta y no tensores, así que el entrenador y el servidor tienen que compartir sistema de archivos. En un clúster Slurm eso es el sistema de archivos de red. Sobre Jobs se consigue lo mismo montando un bucket de almacenamiento como volumen, al mismo path en cada Job. Por debajo usa hf-mount, que expone el bucket como sistema de archivos POSIX dentro del contenedor.
hf jobs run ... -v hf://buckets/aminediroHF/asyncgrpo-lora-buckets:/lora ...Nada en TRL ni en vLLM tuvo que cambiar para esto. El entrenador escribe en /lora/<run>/.vllm_lora/ y los servidores leen desde ese mismo path. La ruta que va en la petición POST ya es válida dentro de cada contenedor.
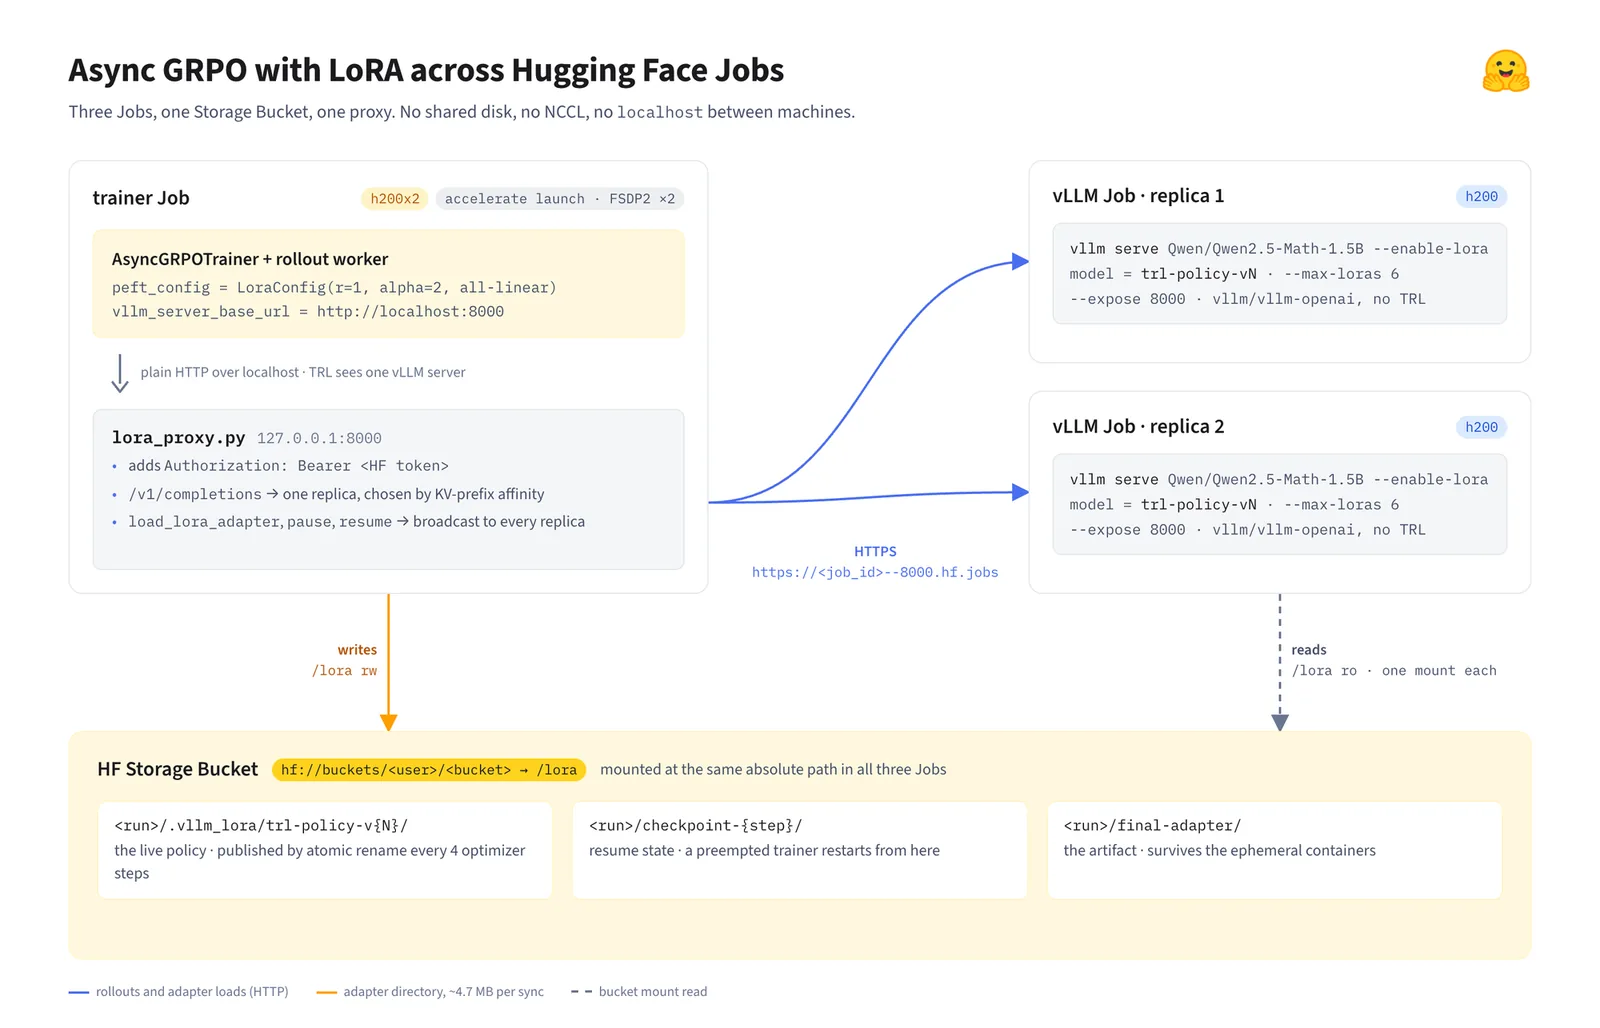
En el bucket se guardan también los puntos de control y el adaptador final. Los Jobs de HF son efímeros, pero un entrenador desalojado puede retomar el entrenamiento, porque el adaptador final siempre queda persistido en el bucket y nunca se pierde cuando el Job se detiene.
¿Cuántas ranuras de adaptador hay que reservar?
Cada réplica usa una GPU y la imagen estándar vllm/vllm-openai. Solo hay que habilitar la carga de LoRA en tiempo de ejecución y reservar suficientes ranuras de adaptador.
El número de ranuras se desprende de max_staleness. En AsyncGRPOTrainer, cada sincronización de pesos sube la versión de la política en uno, y max_staleness es cuántas versiones puede quedar atrasada una muestra de despliegue respecto de la política actual antes de que el entrenador la descarte. Con max_staleness=4, una muestra generada bajo trl-policy-v3 todavía se usa para entrenar cuando el entrenador va en v7.
Un despliegue que partió bajo v3 también tiene que poder terminar bajo v3. Entonces, en cualquier momento, vLLM tiene que servir la política actual más las cuatro anteriores. Por eso el entrenador mantiene registradas max_staleness + 1 versiones de adaptador y descarga cualquiera más antigua. Cada sincronización carga la versión nueva antes de descargar la más vieja, lo que exige una ranura más durante el intercambio. De ahí sale --max-loras 6. Con solo cinco, vLLM desalojaría en silencio una política que todavía tiene despliegues en vuelo, en cada sincronización.
for replica in 1 2; do
hf jobs run --detach --flavor h200 --timeout 8h --secrets HF_TOKEN     --expose 8000     -v "hf://buckets/${BUCKET}:/lora:ro"     -e VLLM_ALLOW_RUNTIME_LORA_UPDATING=1     -e VLLM_SERVER_DEV_MODE=1     -- vllm/vllm-openai:v0.27.1     vllm serve Qwen/Qwen2.5-Math-1.5B --host 0.0.0.0 --port 8000         --max-model-len 4096 --logprobs-mode processed_logprobs --generation-config vllm         --enable-lora --max-lora-rank 1 --max-loras 6
done
vLLM queda fijado en v0.27.1. vLLM se mueve rápido, y las banderas de arriba y los endpoints de LoRA en tiempo de ejecución son los que expone esa versión, así que conviene tratar la versión como parte de la receta.
Había otro diseño posible, con el entrenador guardando solo el último adaptador y publicándolo siempre bajo el mismo nombre. No tomaron ese camino, porque vLLM indexa su caché de prefijos por nombre de adaptador. Con un nombre único, los bloques KV calculados bajo los pesos anteriores seguirían calzando después del intercambio, el prellenado no se reharía, y un despliegue podría sacar su prefijo de una versión de la política y su decodificación de la siguiente. El entrenador no tendría manera de darse cuenta, y aparecería como el ratio alejándose de 1. Los nombres versionados hacen imposible eso, porque un nombre siempre significa un conjunto de pesos, y un prefijo en caché nunca puede calzar con una versión más nueva.
El conjunto de datos Sanity
Eligieron sail/Sanity-Test-R1D-1.5B, el conjunto de datos del paper Defeating the Training-Inference Mismatch via FP16 de Qi y otros, de 2025. El código de reproducción está en sail-sg/Precision-RL.
Los autores generaron 40 respuestas para cada problema de MATH con DeepSeek-R1-Distill-Qwen-1.5B. Se quedaron con los problemas cuya tasa de éxito caía entre 20% y 80%, lo que dejó 1.460 preguntas. El conjunto sirve para validar aprendizaje por refuerzo porque las preguntas no están ya resueltas ni resultan del todo imposibles para ese modelo, así que el modelo recibe buena señal temprana para entrenar y mejorar.
Sirve además como prueba de extremo a extremo. Si una réplica de vLLM sirve en silencio el modelo base bajo un nombre de adaptador, eso se ve en la curva dentro de unas pocas decenas de pasos. El conjunto además es lo bastante chico para recorrerlo entero en menos de dos horas.
Los hiperparámetros salen de los scripts de LoRA del propio paper, en oat/scripts/lora.
| Parámetro | Valor |
|---|---|
| Modelo | Qwen/Qwen2.5-Math-1.5B |
| Rango LoRA | 1, con alfa 2 |
| Tasa de aprendizaje | 4e-5 |
| Muestras por prompt | 8 |
| Completaciones por paso | 128 |
| Tokens generados como máximo | 3.000 |
| Contexto | 4.096 tokens |
El entrenador
El entrenador usa la misma imagen vllm/vllm-openai:v0.27.1 con TRL instalado encima. En su momento corrieron la rama del PR, y ese mismo código hoy se despacha en TRL v1.14. El script de entrenamiento es un script normal de AsyncGRPOTrainer. Los únicos valores específicos del Job son el directorio de salida y la URL del servidor.
from peft import LoraConfig
from trl.experimental.async_grpo import AsyncGRPOConfig, AsyncGRPOTrainer

config = AsyncGRPOConfig(
    output_dir="/lora/sanity-lora-r1",
    vllm_server_base_url="http://localhost:8000",
    max_staleness=4,
    weight_sync_steps=4,
    save_strategy="steps", save_steps=50,
    ...
)
trainer = AsyncGRPOTrainer(
    model="Qwen/Qwen2.5-Math-1.5B",
    args=config,
    peft_config=LoraConfig(r=1, lora_alpha=2, target_modules="all-linear"),
    ...
)
Durante la inicialización, TRL llama a /server_info. Si encuentra un lora_config, usa sincronización de solo adaptador. Las configuraciones que vLLM no puede servir directamente, como DoRA, modules_to_save o un rango por sobre --max-lora-rank, caen de vuelta a sincronización de pesos fusionados con una advertencia. El registro debería contener Adapter-only vLLM sync enabled.
¿Para qué sirve el proxy?
Hace falta un proxy entre el entrenador y los Jobs de vLLM por dos razones.
Los puertos expuestos de un Job exigen una cabecera Authorization: Bearer <HF token> en cada petición. El proxy es donde se agrega esa cabecera, así que TRL no necesita saber nada de ella.
La segunda razón es querer más de una GPU generando. En un servidor vLLM único, la vía habitual para eso es --data-parallel-size > 1, pero TRL rechaza la sincronización de solo adaptador en ese modo, y con razón. Una llamada a /v1/load_lora_adapter alcanza únicamente al rango de paralelismo de datos que la responde, así que los demás rangos seguirían sirviendo el modelo base bajo el nombre de la política nueva. Sobre Jobs la pregunta ni siquiera aparece, porque cada réplica es su propia máquina. Entonces el paralelismo de datos tiene que vivir un nivel más arriba, en algo que abra en abanico la carga del adaptador hacia todas las réplicas.