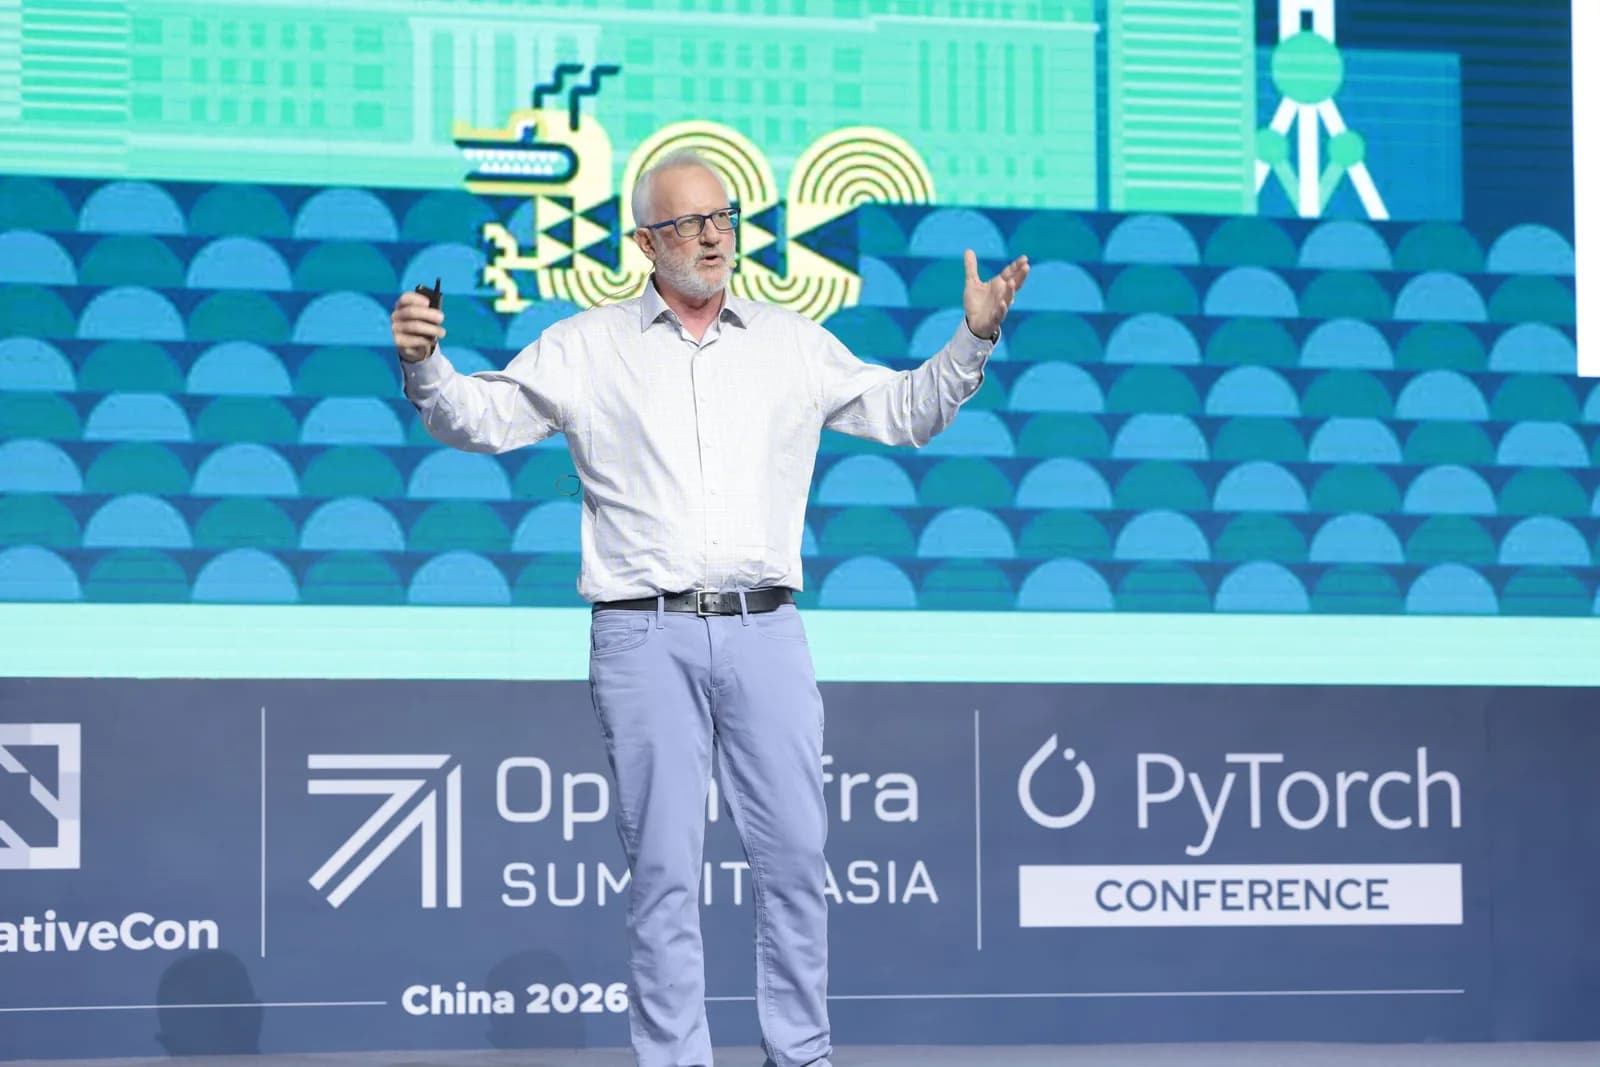
La PyTorch Conference China 2026 reunió a la comunidad en Shanghái los días 8 y 9 de septiembre, en paralelo con KubeCon + CloudNativeCon y OpenInfra Summit y después de los eventos co-localizados del 7 de septiembre organizados por los patrocinadores. Las discusiones técnicas abarcaron modelos, frameworks, entrenamiento distribuido, inferencia, hardware, infraestructura cloud native y agentes.
El lema "Open Source para la era de la IA" enmarcó el trabajo a lo largo de esas capas. Entre sesiones co-localizadas, charlas principales, demostraciones técnicas, una conferencia de prensa de la PyTorch Foundation, reuniones de comunidad y conversaciones en el stand de PyTorch, el programa cubrió adaptación de hardware, entrenamiento y servido de modelos, infraestructura abierta, integración de aceleradores y colaboración entre comunidades de código abierto.
¿Quiénes se sumaron a la fundación?
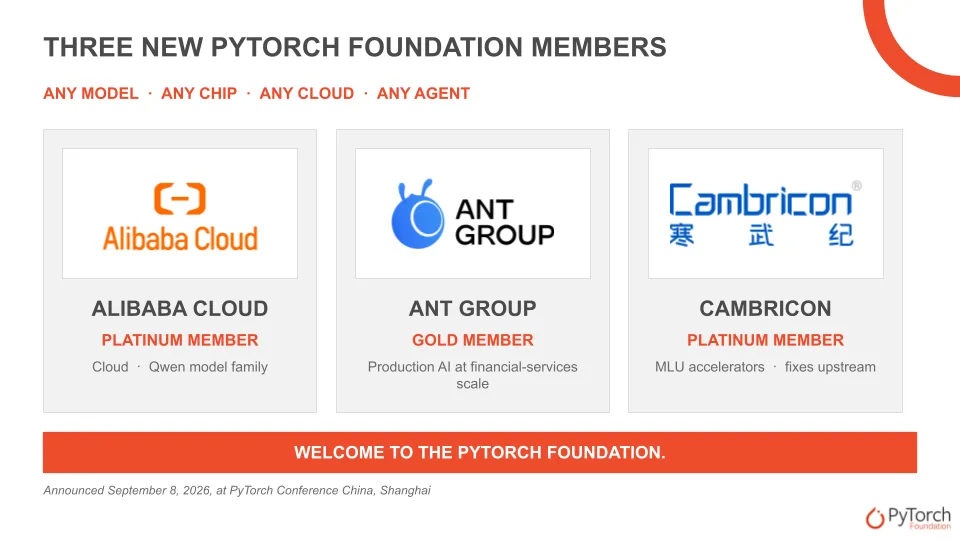
La PyTorch Foundation anunció tres nuevos miembros en Shanghái el 8 de septiembre, que se suman a Huawei y al resto de los integrantes existentes.
- Alibaba Cloud ingresó como miembro Platinum, con trabajo que abarca infraestructura de nube y la familia de modelos Qwen.
- Ant Group entró como miembro Gold, aportando experiencia en inteligencia artificial en producción a escala de servicios financieros.
- Cambricon ingresó como miembro Platinum. La compañía desarrolla aceleradores MLU y sigue un enfoque de Upstream First en sus contribuciones a PyTorch, que cubren torch.compile, operadores en modo Eager, Device Runtime, computación distribuida, AMP, Dataloader y Profiler.
Representantes de Alibaba Cloud, Ant Group, Cambricon y Huawei subieron al escenario principal para hablar del stack abierto de inteligencia artificial en hardware, modelos e infraestructura.
¿Cómo define la fundación el stack abierto?
En la conferencia de prensa del 8 de septiembre, la PyTorch Foundation delineó un stack de inteligencia artificial de código abierto que abarca aplicaciones y agentes, construcción y entrega de inteligencia, ejecución y escalamiento de cargas, infraestructura y aislamiento, y cómputo heterogéneo.
PyTorch, vLLM y Ray representaron la capa enfocada en construir y entregar inteligencia. Kubernetes, KServe, Kueue, OpenTelemetry y llm-d, la capa de ejecución y escalamiento de cargas. OpenStack y Kata Containers, la de infraestructura y aislamiento. Esas capas de software corren sobre NPU, CPU, GPU y otros aceleradores.
Los miembros de la fundación trabajan en cuatro áreas: cualquier modelo (laboratorios y constructores de modelos), cualquier chip (silicio y sistemas), cualquier nube (nubes y plataformas) y cualquier agente (producción y servicios). Muchos abarcan más de una capa.
"Ninguna organización por sí sola construye el sistema completo. En conjunto, nuestros miembros lo abarcan", resumió la fundación.
¿Cuánto pesa China en el ecosistema?
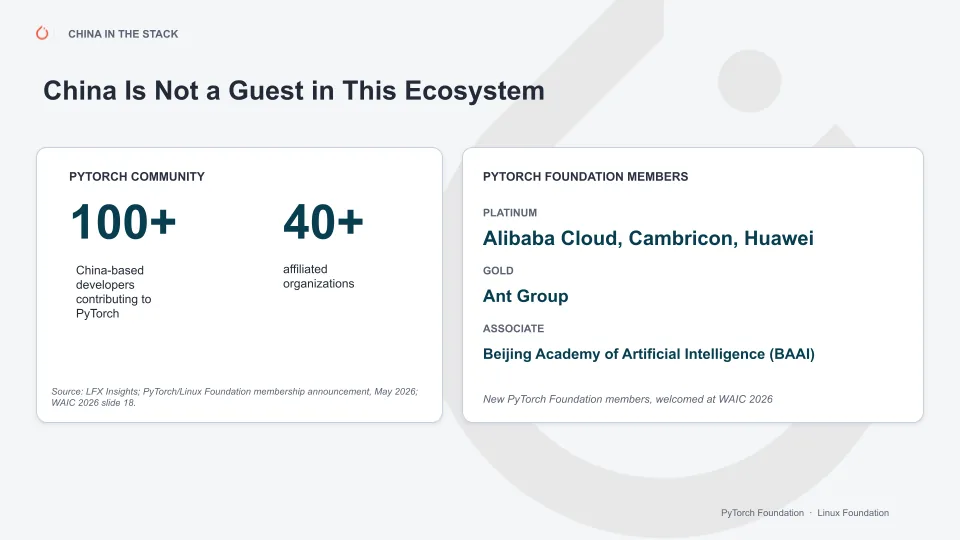
Más de 100 desarrolladores radicados en China contribuyen a PyTorch a través de más de 40 organizaciones afiliadas. Entre los miembros de la fundación representados en el panorama enfocado en ese país figuran Alibaba Cloud, Cambricon y Huawei como miembros Platinum, Ant Group como Gold y la Beijing Academy of Artificial Intelligence (BAAI) como miembro Asociado.
El anuncio del 8 de septiembre agregó que más de 250 organizaciones en China contribuyen a proyectos de la PyTorch Foundation, incluidos DeepSpeed, Helion, PyTorch, Ray, Safetensors y vLLM.
La conferencia también destacó el desarrollo y la optimización de modelos abiertos a través de la capa de software. Para DeepSeek-R1, un caso de estudio recorrió la optimización mediante kernels, enrutamiento, paralelismo y servido sobre el mismo hardware GB300 seis meses después. En la configuración presentada, el sistema optimizado entregó 2,77 veces más throughput y un 60 por ciento menos de costo por token. La fuente citada en el material de la conferencia fue NVIDIA, 2026.
Un segundo ejemplo mostró la participación del tráfico de tokens en OpenRouter servido por modelos de pesos abiertos desarrollados en China: subió del 2 por ciento a fines de 2024 al 45 por ciento en abril de 2026. La fuente citada fue Mozilla.
Integración de aceleradores: el problema de fondo
El hardware de cómputo para inteligencia artificial enfrenta desafíos de heterogeneidad, con altos costos de adaptación y falta de estándares unificados. El grupo de trabajo de integración de aceleradores del TAC de PyTorch, co-presidido por Huawei e Intel, entrega guías estandarizadas de incorporación de hardware, un mecanismo de pruebas de integración continua entre repositorios, suites de pruebas genéricas conscientes del dispositivo y flujos de incubación de plataformas.
Zesheng Zong presentó los logros y la hoja de ruta futura del grupo durante la conferencia, incluidas APIs refinadas independientes del dispositivo y una matriz de pruebas multi-backend ampliada. Los fabricantes de hardware y desarrolladores interesados en co-construir ese ecosistema pueden sumarse a un grupo de trabajo de la fundación.
Ese punto es el que más importa para quien mira desde fuera de las grandes nubes. Cada acelerador nuevo obliga hoy a repetir trabajo de integración en operadores, compiladores, frameworks de entrenamiento e inferencia y comunicaciones. Una API independiente del dispositivo es lo que separa un chip que solo sirve para demostraciones de uno que puede correr código existente sin reescribirlo.
La próxima cita es la PyTorch Conference North America 2026, en San José, el 20 y 21 de octubre, con mantenedores de PyTorch, vLLM, DeepSpeed y Ray entre los expositores.