Xiaomi liberó su familia MiMo-V2.6 y el modelo mayor quedó primero entre los modelos de pesos abiertos, con un costo por tarea que es una fracción del que cobra la competencia. El salto de rendimiento viene de una ronda de aprendizaje por refuerzo mucho más grande que la anterior. Sobre la misma empresa pesa la acusación de Anthropic de haber tomado prestado de Claude.
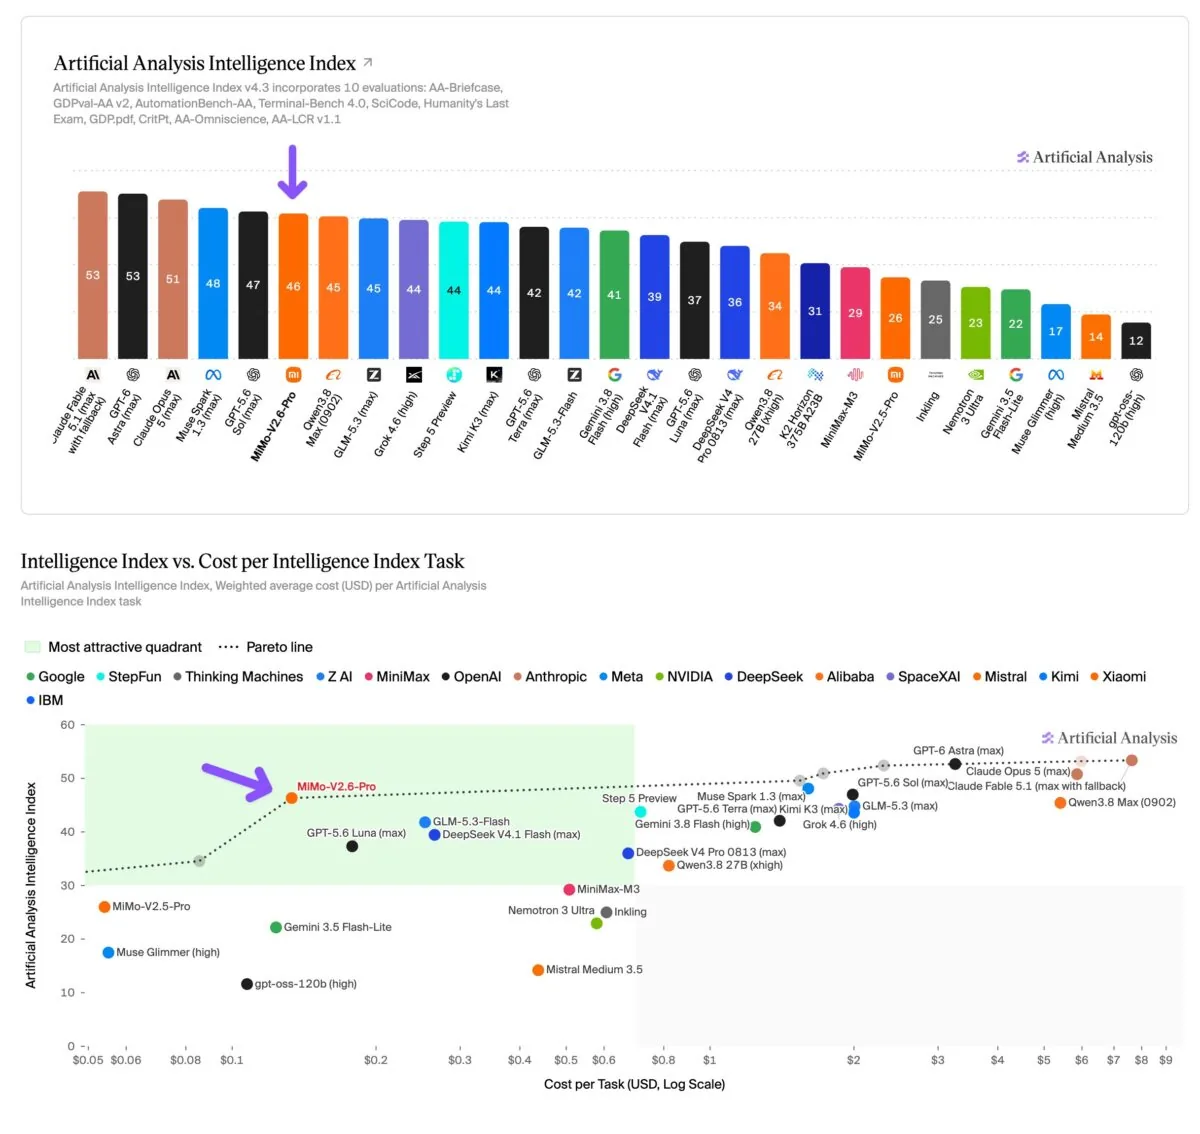
Según Xiaomi, el mayor de los dos modelos nuevos, MiMo-V2.6-Pro, anota 46 puntos en el Intelligence Index de la firma de análisis Artificial Analysis. Eso lo deja como el modelo abierto más fuerte del momento, por delante de rivales como Kimi K3 y Qwen.
El precio es lo que remata la comparación. 0,435 dólares por millón de tokens de entrada y 0,87 dólares por millón de tokens de salida. Con las cuentas de Artificial Analysis, una tarea de prueba cuesta alrededor de 0,13 dólares, una fracción de lo que cobran modelos de capacidad parecida. Eso ubica al modelo en la llamada frontera de Pareto entre inteligencia y costo.
Pro es un modelo de mezcla de expertos con 1,02 billones de parámetros, de los cuales solo 42.000 millones se activan en cada consulta. A su lado va el MiMo-V2.6-Flash, más chico y más eficiente.
¿De dónde salió el salto de rendimiento?
Xiaomi atribuye la mejora a un aprendizaje por refuerzo ampliado con fuerza, es decir entrenamiento por ensayo, retroalimentación y recompensa. La empresa escaló esa fase en tres ejes. Más datos por paso de entrenamiento, entornos de tareas más variados y más cómputo para calificar las soluciones.
La corrida tomó menos de seis días, dice Xiaomi, y costó unos 2,62 millones de dólares para Pro y 0,85 millones para Flash.
| Modelo | DeepSWE antes | DeepSWE después | Costo de la corrida |
|---|---|---|---|
| MiMo-V2.6-Pro | 58,4 | 72,6 | 2,62 millones de dólares |
| MiMo-V2.6-Flash | 48,8 | 65,7 | 0,85 millones de dólares |
Para mantener estable el entrenamiento a esa escala, Xiaomi congeló el mecanismo interno de distribución del modelo y sumó varias capas de protección contra el reward hacking, los trucos con que un modelo gana la recompensa sin resolver de verdad la tarea.
Unas 7.000 tareas con calificadores automáticos
Junto a los modelos, Xiaomi despacha una variante especialmente rápida llamada Pro-UltraSpeed, con hasta 20 veces la velocidad de salida. Lo que más resalta es que la empresa está abriendo su herramental de aprendizaje por refuerzo. Ahí entran el informe técnico, el marco de entrenamiento completo, un modelo más pequeño para seguir entrenando y unas 7.000 tareas listas con calificadores automáticos para desarrollo de software, ciberseguridad, trabajo de oficina y diseño web, más cerca de 1.000 tareas de composición musical.
Las tareas vienen de orígenes mezclados. Parte del código sale de pull requests reales de GitHub hechos por empleados y de consultas de usuarios, mientras que otras descripciones de tareas las genera un modelo de lenguaje. Las tareas de ciberseguridad se apoyan en OSS-Fuzz, una colección con decenas de miles de vulnerabilidades reales de software, y los entornos de oficina se reconstruyen de forma sintética.
¿Qué dice exactamente la acusación de Anthropic?
Esta demostración de apertura contrasta con las acusaciones que Anthropic levantó apenas dos semanas antes. En su informe de inteligencia de amenazas, Anthropic examinó casos de abuso de Claude detectados entre diciembre de 2025 y agosto de 2026, y nombró siete laboratorios chinos ligados a campañas contra el modelo. Alibaba, Moonshot AI, DeepSeek, Zhipu, Xiaomi, MiniMax y SenseTime.
En total, se atribuye a esos laboratorios cerca de 190 millones de intercambios para extraer capacidades de Claude y entrenar sus propios modelos, una técnica que Anthropic llama destilación ilegal.
Xiaomi aparece con nombre y apellido. En un caso etiquetado GTG-16008, Anthropic rastreó más de 400.000 intercambios a lo largo de 20 días, en marzo y abril de 2026, en los que Xiaomi pasó conversaciones de usuarios y sesiones de programación de sus propios modelos MiMo hacia Claude, por medio de OpenClaw y OpenCode, con el objetivo de enriquecer datos de entrenamiento para modelos futuros.
El informe casi no documenta de dónde salieron los datos de entrenamiento y los datos de maestro anteriores para la destilación interna de modelos maestros.
Dicho de otro modo, el informe sostiene que Xiaomi grabó las conversaciones de sus usuarios con los modelos MiMo y después las alimentó a Claude para extraer datos de entrenamiento, los mismos datos que ahora la tienen en el primer lugar del ranking de modelos abiertos.