Shopify comprime a diario las fallas de producción dentro de los pesos de su modelo, supera la calidad de los modelos de frontera y recorta el costo de servicio en 96%. Así resume la empresa el caso de estudio que publicó en el blog de PyTorch sobre el circuito de aprendizaje continuo que armó con PyTorch y vLLM.
Los modelos de frontera suelen ser la vía más rápida para lanzar un producto de inteligencia artificial. Un equipo chico pone algo útil frente a los usuarios en poco tiempo y aprende del uso real. Pero cuando el uso crece, la economía cambia, y esos modelos resultan demasiado lentos y caros para atender cada solicitud a escala.
Un modelo de frontera es de propósito general y no está hecho a la medida de un producto. Más importante todavía, no aprende de producción por su cuenta. Una corrección del usuario, una salida rechazada o una falla recurrente no hacen mejor la respuesta siguiente. Cada falla es conocimiento ganado con esfuerzo sobre el producto, y el aprendizaje continuo empieza por capturar ese conocimiento y devolverlo al sistema.
Además, los pesos del modelo desplegado están congelados. No tiene forma de internalizar lo que producción le enseña. Las mejoras se acumulan en los artefactos discretos que lo rodean, ediciones de prompt, ejemplos de recuperación, reglas de enrutamiento y código del arnés. El conocimiento de producción se apila en palabras y en código mientras los pesos del modelo quedan intactos. La respuesta de Shopify es el volante de inercia, un circuito de aprendizaje continuo que comprime la experiencia de producción en el espacio continuo de los pesos.
El agente de GraphQL de Shopify es el ejemplo más claro de ese circuito corriendo en producción, con mayor calidad que los modelos de frontera, menor latencia y ese recorte de costos de 96%.
Primero se define la calidad, porque se vuelve la señal de recompensa
Definir la calidad es el paso más importante del circuito y el que los equipos apuran más seguido. Parte como una especificación de cómo se ve lo bueno y termina siendo la señal de recompensa que guía el aprendizaje. Si las evaluaciones o las especificaciones salen mal, todo lo que viene después optimiza el comportamiento equivocado.
La calidad arranca con una rúbrica que convierte los requisitos de producto en unos pocos criterios puntuados, completitud, ejecución, calidad de respuesta y seguridad. Cada uno lleva anclas concretas para lo que significa cada puntaje. Es el contrato de calidad para todo lo que sigue, y lo que usan los anotadores para transformar conversaciones en verdad de referencia. Esa verdad de referencia tiene que incluir tráfico muestreado al azar, no solo ejemplos curados. Los conjuntos dorados prueban los casos que uno ya sabe que hay que mirar, y las muestras aleatorias revelan cómo se ven de verdad lo bueno y lo malo en producción.
Con la rúbrica lista, Shopify hace que sus dos mejores anotadores o expertos de producto anoten a ciegas 25 muestras al azar y registra el acuerdo entre ambos. Usan la kappa de Cohen, que mide el acuerdo por encima del azar. Si sale muy baja, alrededor de 0,2, la rúbrica es ambigua y hay que volver a reunirse e iterarla. Si la rúbrica confunde a varios expertos de producto que trabajan en eso todos los días, también va a confundir a un modelo de lenguaje.
Ese acuerdo es el techo del juez automático. Ni siquiera los anotadores expertos coinciden el 100% de las veces, porque hay conversaciones genuinamente ambiguas. La meta es un juez que calce con los humanos más o menos tan bien como los humanos calzan entre ellos. La perfección nunca estuvo sobre la mesa.
Al recolectar anotaciones hay que exigir detalle. Un puntaje y una oración no le alcanzan a los algoritmos de calibración para aprender. Lo que se busca es el por qué detrás de cada puntaje.
¿Cómo se calibra el juez automático?
La rúbrica es apenas el punto de partida. Es el primer prompt del juez, pero todavía no aprendió nada de la verdad de referencia. La calibración toma esa rúbrica y la convierte en un juez que se puede correr sobre infinitos datos de producción.
En Shopify usan DSPy para esto, y calibran con optimizadores basados en reflexión como GEPA y Agentic Context Engineering. GEPA hace evolucionar el prompt reflexionando sobre trazas de falla en lenguaje natural y mantiene una frontera de Pareto de candidatos en vez de quedarse con un único ganador. ACE cura un manual estructurado mediante ediciones pequeñas e incrementales.
El juez es la métrica que se optimiza antes de salir a producción, pero es solo un sustituto, así que hay que establecer que refleja el desempeño sobre tráfico real y que está alineado con la métrica en línea. Se hace retroprueba contra pruebas A/B anteriores, verificando si el juez recupera la dirección de aciertos y fracasos ya conocidos en interacción, retención o el comportamiento que el producto busca generar.
Después vienen las pruebas de degradación dirigidas, sea fuera de línea o sobre una porción de tráfico bien controlada. Se empeora un comportamiento a propósito y se confirma que el criterio correspondiente responde. Si el sistema deja de intentar cumplir el objetivo del usuario, el puntaje de cumplimiento de objetivo tiene que bajar específicamente.
Cada juez conviene mantenerlo chico y acotado en vez de meter todo el comportamiento del producto en uno solo. Los jueces enfocados hacen más fáciles de interpretar esas pruebas y más confiables las métricas que salen de ahí.
Exprimir el sistema de frontera antes de tocar los pesos
Con un juez confiable se puede mejorar el producto inicial impulsado por el modelo de frontera, el que se construyó para llegar rápido a los usuarios. En esta etapa se empuja ese sistema hasta donde dé sin tocar los pesos. Cada mejora aterriza en prompts, definiciones de herramientas y código del arnés.
Mejorar ese sistema base es un problema distinto al de construir el juez. Ya es una aplicación en producción, con prompts ensamblados de forma dinámica, bucles de control propios y orquestación a medida repartida en una base de código grande. Ningún prompt por sí solo determina su comportamiento, así que ajustar prompts alcanza a una parte chica del sistema. El objetivo de optimización es el arnés completo.
Por eso lo tratan como un problema de autoresearch, en la línea del proyecto reciente de Karpathy. Un agente propone un cambio a un prompt, a una definición de herramienta o al arnés, lo evalúa contra el juez, conserva el cambio si el puntaje mejora y lo descarta si no. Todo se configura en un único archivo markdown legible, con de dónde sacar los datos, qué directorios puede editar el agente, el juez como métrica, el optimizador a usar y el bucle de proponer, evaluar y conservar o descartar.
De los artefactos discretos a los pesos del modelo
Cuando las mejoras del arnés se estancan, empieza la optimización en el espacio de parámetros, minando tráfico de producción anonimizado en busca de negativos difíciles, conversaciones que el juez puntúa bajo con razón y que exponen dónde el modelo está más débil.
A lo largo de millones de comerciantes distintos, el tráfico real produce un flujo continuo de casos difíciles. Contexto parcial, pedidos ambiguos, flujos de trabajo propios de cada negocio, fallas de herramientas y muchas maneras de expresar la misma intención. En un flujo tradicional cada falla termina como reporte de error o hilo de Slack. En el volante de inercia, esas fallas entran de forma automática a una cañería que se repara sola, donde un panel de modelos de razonamiento de frontera las convierte en señal de entrenamiento que el aprendizaje por refuerzo pliega de vuelta hacia los pesos del modelo.
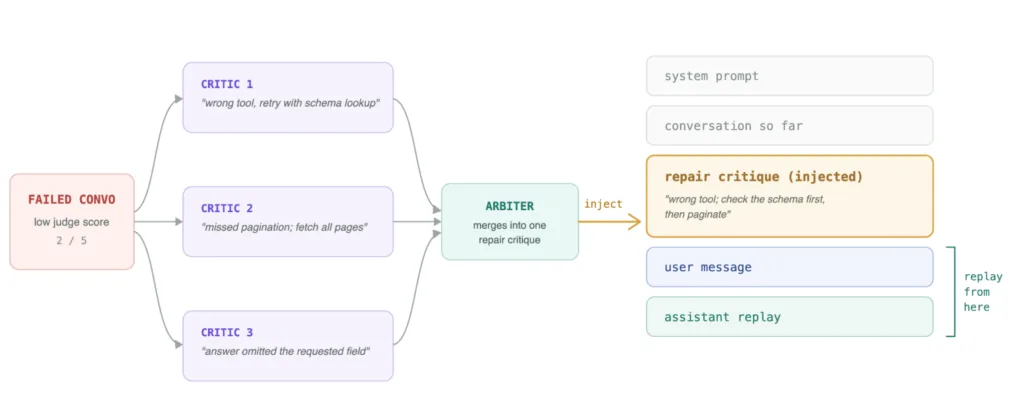
Un panel de modelos de razonamiento de frontera critica cada falla. Un árbitro fusiona esas críticas en una sola instrucción de reparación, que se inyecta antes del turno del usuario, una técnica que a veces se llama hinting. La conversación se vuelve a reproducir desde ese punto y el juez la puntúa otra vez. Si la reparación pasa, la repetición se convierte en una trayectoria para aprendizaje por refuerzo, con el puntaje del juez como recompensa. Si igual falla, se marca para anotación humana. Ahí entra Toloka, cuyos anotadores expertos corrigen las conversaciones que los críticos no pudieron arreglar, puntuándolas contra la misma rúbrica con que se calibró el juez.
El entrenamiento avanza en dos etapas. Primero destilan las trayectorias sanadas hacia un modelo más chico con ajuste fino supervisado, entrenando sobre las trayectorias completas, incluido el razonamiento que las produjo, y no solo sobre las respuestas finales. Esa destilación de cadena de pensamiento le deja al modelo chico heredar comportamiento que no podría aprender solo de las respuestas.
Segundo, aplican GRPO usando el juez calibrado como señal de recompensa. Para cada prompt el modelo muestrea un grupo de respuestas, los jueces las puntúan y GRPO refuerza las que rinden mejor. El ajuste fino supervisado le enseña al modelo trayectorias exitosas para imitar, y GRPO lo optimiza directo contra la definición de calidad.
La cañería que se repara sola corre a diario y suma trayectorias nuevas al corpus de entrenamiento sin parar. Con esa misma cadencia se corre un ajuste fino de parámetros completos sobre los datos acumulados y después se repite GRPO. Entrenar sobre trayectorias nuevas y previas a la vez limita la deriva y el olvido catastrófico entre ciclos. A medida que el volante gira, la calidad sube y termina superando a la línea base impulsada por el modelo de frontera.
Usamos PyTorch para distribuir el entrenamiento entre GPU con paralelismo de tensores, de contexto y de datos, lo que hace práctico el ajuste fino de parámetros completos a escala.
Comprimir el prompt para servirlo más rápido
Un modelo mejor igual tiene que correr, y el prompt de sistema de un agente es largo y estático. La atención escala con el largo de la secuencia, así que cada token generado atiende sobre todo ese prefijo. Un prompt largo es un impuesto fijo sobre la latencia y el costo de servicio, que se paga en cada solicitud.
La compresión por gist saca casi todo ese impuesto. Shopify corre el mismo modelo de dos maneras, un maestro con el prompt de sistema completo y un alumno con una secuencia corta de tokens gist aprendidos en su lugar. Construyeron un entrenador propio en PyTorch que aprende esos embeddings igualando la distribución de salida del maestro mientras mantiene congelados los pesos del modelo. El resultado es un puñado de tokens que reproducen el comportamiento del prompt con una fracción del largo, sin pérdida de calidad medible en el juez.
El volante en acción, el agente de GraphQL
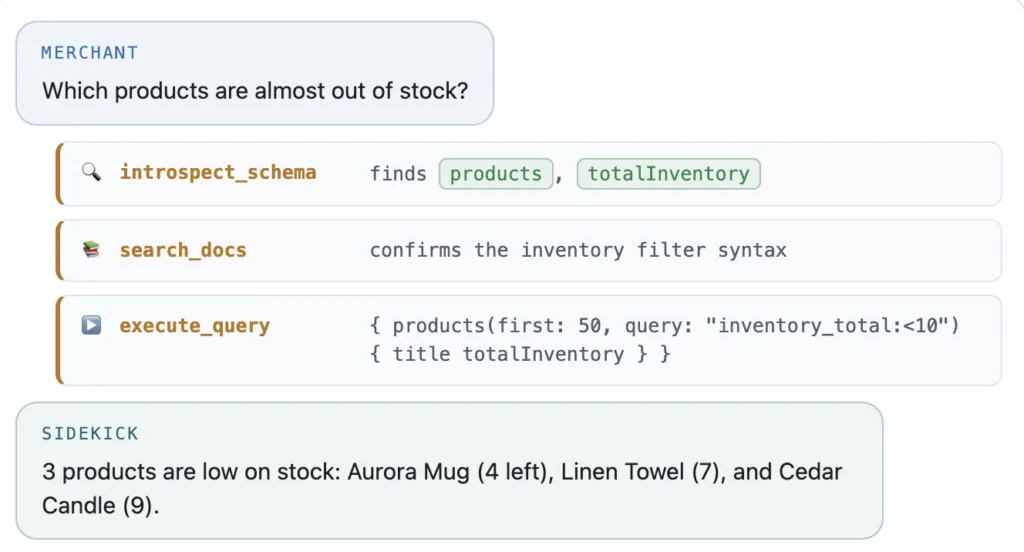
El lugar más claro para ver el circuito completo trabajando es el agente de GraphQL, que atiende hasta 2.000 solicitudes por minuto en producción. Responde preguntas de los comerciantes sobre su tienda escribiendo y ejecutando consultas contra la Admin GraphQL API de Shopify. Un comerciante puede preguntar qué productos están por quedarse sin stock, y el agente arma la consulta correcta, la ejecuta contra la tienda y convierte el resultado en una respuesta en lenguaje corriente.
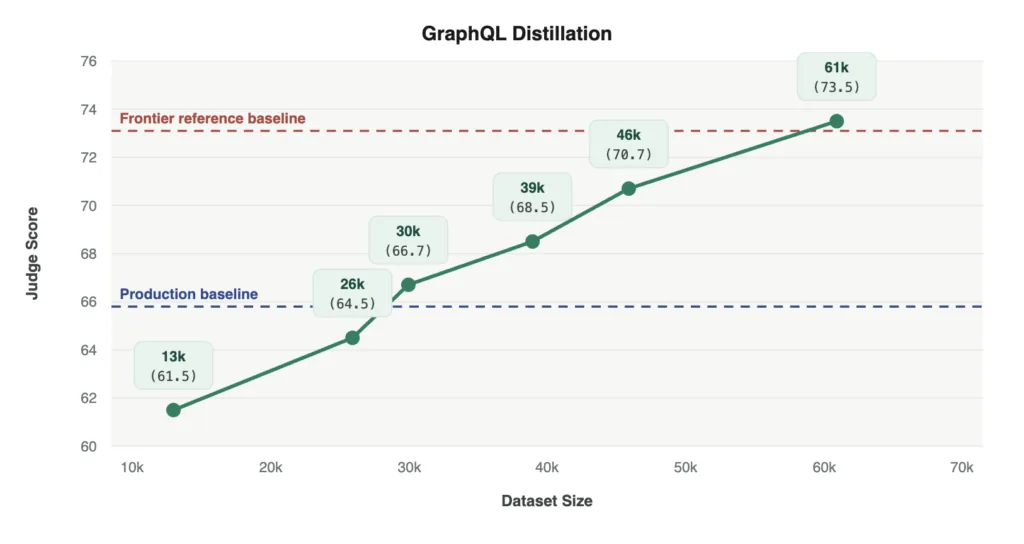
La cañería que se repara sola convierte las conversaciones de producción con puntaje bajo en trayectorias exitosas, y le da al modelo un flujo continuo de lecciones sacadas de necesidades reales de comerciantes. Juntos, el ajuste fino supervisado y el aprendizaje por refuerzo permiten que el modelo especializado supere el desempeño del modelo de frontera.