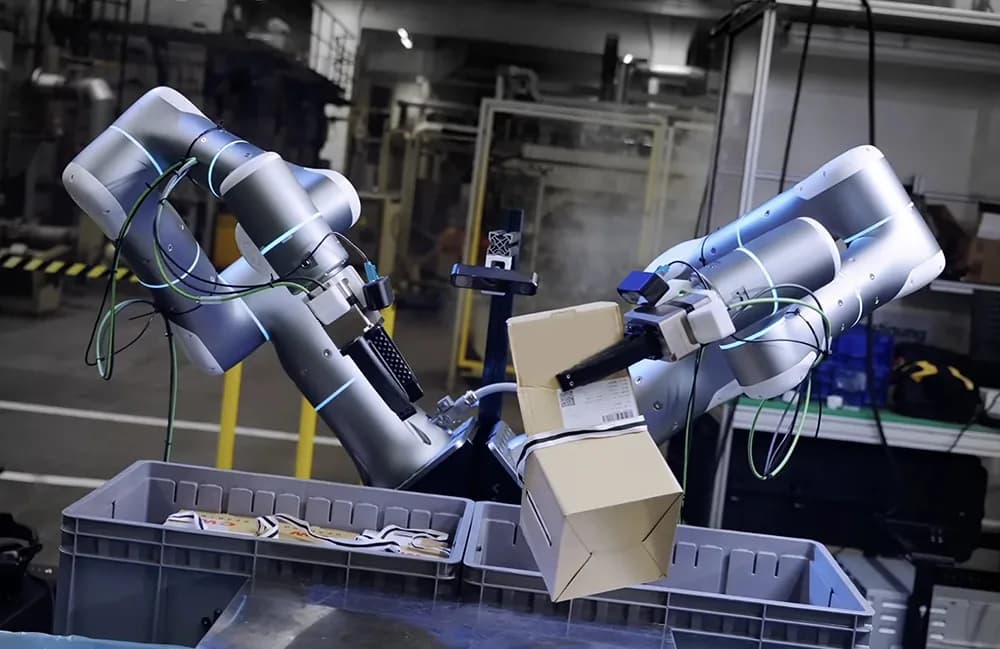
Rhoda AI salió este año de 18 meses de sigilo con una ronda Serie A de 450 millones de dólares. La empresa de Palo Alto, California, trabaja con clientes de la industria automotriz, la manufactura, la logística y el comercio electrónico para llevar a producción su modelo de acción directa por video, o DVA (direct video action), según contó su CEO a The Robot Report.
"Estamos enfocados en desplegar en el mundo real, y eso significa que tienes que lidiar con el desorden del mundo real. Cada ejecución puede ser distinta", dijo Jagdeep Singh, cofundador y CEO de Rhoda AI. "Cada configuración puede ser distinta, y necesitas un modelo realmente robusto. Para construir un modelo robusto, necesitas un conjunto de datos de entrenamiento masivo".
Un conjunto de datos enorme es justo lo que permitió que modelos de lenguaje como ChatGPT avanzaran tan rápido en los últimos años. La IA física quedó atrás porque ese mismo volumen de datos no existe para el mundo físico, explicó Singh.
"Cada palabra que alguna vez se puso en internet, desde Shakespeare hasta Reddit, se usó para entrenar estos modelos de IA. En el mundo de la IA física no había un conjunto de datos a escala de internet", dijo. "La gente intentó reunir sus propios datos teleoperando robots, y ese enfoque dio demostraciones de laboratorio interesantes con robots que podían doblar poleras o preparar café, pero ninguna de esas demostraciones fue lo bastante robusta para pasar al mundo real. La cantidad de robots con manipulación autónoma que están resolviendo problemas reales hoy es, en la práctica, cero".
Rhoda AI apuesta por el video para cerrar esa brecha y llegar a una robótica de verdad generalista.
¿Cómo funciona un modelo DVA?
Muchos desarrolladores de IA física construyen modelos de visión, lenguaje y acción (VLA), que permiten a un robot aprender a partir de imágenes o videos de su entorno y de instrucciones en texto. Según Rhoda AI, esos modelos todavía tienen problemas para lidiar con la variabilidad del mundo real.
La empresa afirma que su modelo DVA, al que hace poco sumó una versión móvil llamada mobile DVA, combina manipulación y desplazamiento en una sola política.
"Lo que hace el modelo es mirar un historial de cuadros de video, de tokens de acción y de tokens de lenguaje. A partir de ese historial, o de ese contexto, hace una predicción en video para los próximos cientos de milisegundos, el próximo medio segundo más o menos", explicó Singh. "Predice la escena y lo que cree que va a pasar en esa escena. Una vez que tienes esa predicción, se la pasas a una segunda parte del modelo, que es un convertidor de acciones. Toma la escena en video y entrega acciones para el robot".
"Una vez que tienes esa salida en el espacio de acciones, puedes ejecutarlas en un robot real. El robot se mueve durante ese medio segundo, y después haces una nueva observación, porque el estado del mundo cambió, y haces una nueva predicción para el siguiente medio segundo", continuó. "Básicamente es hacer una observación, una predicción de lo que debería pasar después, una conversión a acción, la ejecución de esa acción, y luego cierras el ciclo y haces una nueva observación y una nueva predicción a partir de ella".
El ciclo, en orden, queda así:
- El modelo observa el historial de video, acciones y lenguaje.
- Predice en video el siguiente medio segundo de la escena.
- El convertidor de acciones traduce esa predicción en movimientos del robot.
- El robot los ejecuta y el ciclo parte de nuevo con una observación fresca.
¿Por qué Rhoda AI apuesta por la cantidad de datos?
Según Singh, cualquier modelo de IA entrenado con un conjunto de datos chico va a ser muy frágil. Puede funcionar si los datos que ve al momento de la inferencia se parecen mucho a los del entrenamiento. Cuando esas dos distribuciones se separan, el modelo empieza a fallar.
"Para entrenar el modelo se usaron cientos de años de video, así que el modelo ha visto una diversidad increíble de todo: videos de béisbol, gente lanzando dardos, olas rompiendo en una playa o árboles moviéndose con el viento", dijo Singh. "No solo videos con humanos. Cada video tiene algo que enseñarle al modelo sobre cómo funciona el mundo. En esencia, internet entero se convierte en una especie de sala de clases de física".
Rhoda AI usa ese video para el preentrenamiento. "Una vez que tienes ese preentrenamiento, aplicas una pequeña cantidad de entrenamiento específico para la tarea, quizás de 10 a 20 horas, parecido a como entrenarías a un trabajador nuevo en una línea de ensamblaje", dijo Singh. "Ya llegan con ciertas habilidades, y tienes que enseñarles el flujo de trabajo de tu empresa en particular. Con ese poco de postentrenamiento, el modelo es capaz de hacer cosas que los robots tradicionales no pueden hacer".
La empresa busca un modelo que entienda el mundo de forma general. Por eso no limita sus datos a videos centrados en personas.
"Revisamos videos más curados, que solo tenían manipulación humana en primera persona", contó Singh. "Había una duda sobre si quizás esos videos eran mejores para entrenar. Encontramos que los modelos con mejor desempeño fueron los entrenados con los conjuntos de datos más amplios, incluidas cosas que no tenían una relación obvia con la manipulación".
Esa generalización también le permite al modelo pasar de un tipo de robot a otro. La forma física específica del robot recién entra en juego en la etapa de postentrenamiento.
¿Cómo vende Rhoda AI sus modelos?
Singh describió a Rhoda AI como una empresa de pila completa, que ofrece su tecnología de varias maneras.
"Siempre somos dueños de la capa de IA, ese es el núcleo", dijo Singh. "En cuanto al cuerpo o la capa de hardware, podemos funcionar con nuestro cuerpo o con el de un tercero. En cuanto a las habilidades, podemos ser nosotros quienes entrenamos las habilidades, o podemos dejar que terceros las entrenen. Eso entrega el conjunto más amplio de soluciones a nuestros clientes, y esa es realmente nuestra misión".
Puertas adentro, Rhoda AI concentra el desarrollo de habilidades en manufactura y logística.
"Vamos por esas áreas porque ahí hay un problema inmediato", agregó Singh. "Muchas empresas de manufactura y logística tienen escasez de mano de obra. Muchas industrias se llevaron al extranjero durante décadas porque es demasiado caro fabricar en esas economías. Esta tecnología ofrece un camino para traer de vuelta algunas de esas industrias".
La empresa quiere seguir sacando su modelo al mundo real. Singh cree que el "momento ChatGPT" de la robótica va a llegar antes de lo que la gente espera.
"El tipo de enfoque que estamos tomando realmente tiene el potencial de llevarnos ahí, porque la única forma de alcanzar ese nivel de generalidad es entrenar con un conjunto de datos que tenga a la vez la escala de internet y la diversidad de internet", dijo Singh. "Si no tienes esas dos cosas, tus modelos no van a poder generalizar lo suficiente".