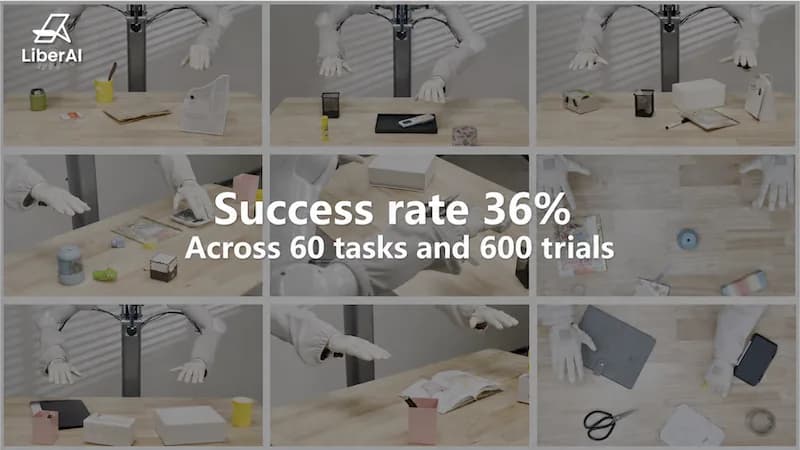
LiberAI, una startup de IA física que desarrolla sistemas fundacionales para robots de propósito general, lanzó Liber-0, un modelo de acción del mundo (World Action Model, WAM) preentrenado con más de 2,2 millones de horas de experiencia humana. Su objetivo es ayudar a los robots a aprender cómo interactuar con el mundo físico.
Liber-0 combina video humano a gran escala con movimientos de la mano registrados directamente, alineación visual y corporal, y aprendizaje condicionado por el cuerpo que ejecuta la acción. La idea es convertir la experiencia humana en capacidades de manipulación que un robot pueda generalizar.
LiberAI se fundó en diciembre de 2025 y se puso una meta ambiciosa, llevar robots domésticos de propósito general a la vida cotidiana encontrando una forma más escalable de enseñarles tareas físicas.
Aprender de lo que ya saben las personas
La idea detrás de Liber-0 es fácil de entender. Las personas, en conjunto, acumulan una cantidad enorme de conocimiento sobre cómo interactuar con el mundo físico.
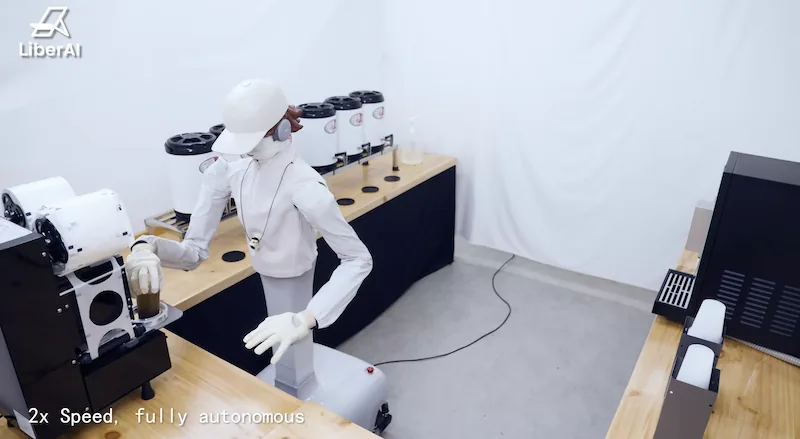
Sabemos tomar una taza, abrir un cajón, doblar una toalla, girar una perilla, destapar una botella, preparar comida y hacer miles de otras acciones en las que casi nunca pensamos de forma consciente. LiberAI quiere que los robots aprovechen esa experiencia acumulada.
Tradicionalmente, enseñarle a un robot a manipular objetos ha dependido de demostraciones grabadas con los propios robots. Esos datos valen porque registran acciones que la máquina puede ejecutar, pero reunirlos exige tener el hardware del robot y el esfuerzo repetido de un operador. La experiencia humana, en cambio, existe a una escala enorme.
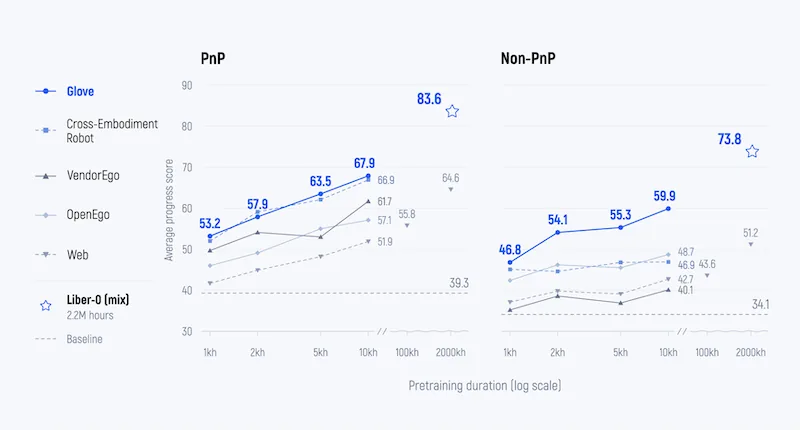
Liber-0 es el intento de LiberAI de aprovechar ese recurso. La empresa lo describe como un WAM diseñado para aprender la relación entre lo que se observa, las acciones físicas y lo que pasa después en el mundo.
Cuando LiberAI dice que Liber-0 se preentrenó con más de 2,2 millones de horas de experiencia humana, no quiere decir que alguien pasó millones de horas mostrándole tareas una por una a un robot. Gran parte de esa experiencia es video de actividad humana a gran escala, que expone al modelo a personas, objetos, entornos e interacciones físicas.
Datos más detallados, como demostraciones humanas capturadas con guantes instrumentados y demostraciones hechas con robots, ayudan a conectar lo que el modelo ve con las acciones físicas que producen ese resultado. El objetivo es pasar de mirar a hacer.
¿Por qué no basta con mirar video?
A primera vista, el video parece entregar casi todo lo que un robot necesita. Una persona ve a otra abrir una botella y entiende al tiro lo que pasa. Pero el video no le dice a un sistema de IA con precisión cómo se movieron los dedos, con cuánta fuerza se sostuvo el objeto, cómo giró la muñeca ni qué secuencia de movimientos produjo el resultado.
LiberAI identifica tres problemas para transferir experiencia humana a un robot:
- El visual. Las grabaciones humanas y las cámaras del robot pueden ver la misma actividad desde puntos de vista muy distintos.
- La brecha de supervisión de la acción. Las posiciones y trayectorias de la mano que se deducen de un video común pueden quedar incompletas o erradas por oclusiones, errores al estimar profundidad y otras limitaciones.
- La brecha corporal. Las personas y los robots tienen cuerpos distintos. Una mano, una muñeca y un brazo humanos pueden lograr una acción con movimientos que un robot concreto no puede reproducir igual.
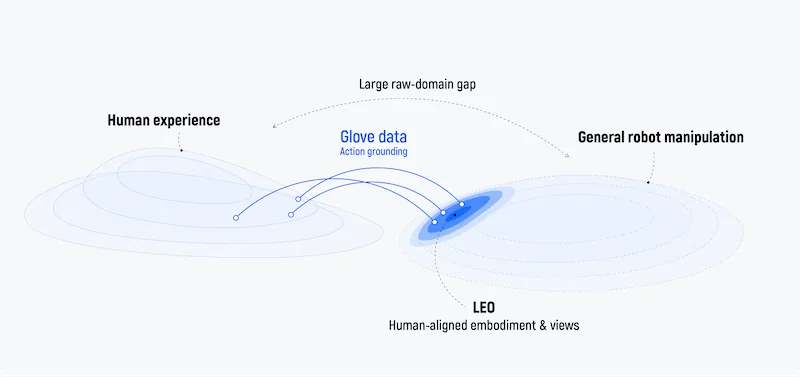
Para cerrar esas brechas, LiberAI combina varios tipos de material de entrenamiento. Grandes cantidades de video humano le dan a Liber-0 una experiencia visual amplia de objetos, entornos e interacciones. Las demostraciones con robots aportan ejemplos de acciones que una máquina puede ejecutar. Entre ambas está uno de los elementos más interesantes de la investigación, las demostraciones humanas grabadas con guantes instrumentados.
Los guantes livianos de la empresa registran la pose y la trayectoria de la mano mientras una persona manipula objetos. Al mismo tiempo graban una cámara en primera persona y dos cámaras montadas en las muñecas.
Eso entrega bastante más información que un video común, porque el sistema puede asociar lo que se ve con mediciones de cómo se mueven de verdad las manos. LiberAI configura las cámaras para que se parezcan a los puntos de vista de su plataforma robótica, LEO, y diseñó los guantes para que interfieran lo menos posible con el movimiento natural de la mano y los dedos. El resultado es un puente entre ver la actividad humana y entender las acciones físicas que hay detrás.
Enseñar a los robots con experiencia humana
El método de los guantes tiene una ventaja práctica. Reunir datos de manipulación humana no requiere que haya un robot presente. En vez de necesitar un robot y un operador para cada demostración, las personas con el equipo de captura de LiberAI pueden hacer tareas mientras se graban sus movimientos y lo que ven. Eso podría convertir la experiencia humana en una fuente mucho más escalable de datos para entrenar IA física.
Por eso Liber-0 no debería entenderse como un catálogo de programas sueltos, una aplicación para "hacer café", otra para "freír un huevo" o un script para "abrir una botella" que se instala en el robot para darle una habilidad nueva. LiberAI intenta algo más de fondo, construir un modelo base de la acción física que aprenda de la experiencia previa y generalice lo aprendido a distintos objetos y tareas.
Del mismo modo, "aprender de las personas" no significa que un robot se pare junto a alguien, mire una tarea nueva una vez y la repita de inmediato. Las demostraciones humanas pasan a ser parte de la experiencia acumulada con que se entrena el modelo. El objetivo a largo plazo es que esa experiencia produzca capacidades físicas cada vez más generales y reduzca la cantidad de demostraciones específicas de robot necesarias para enseñar conductas nuevas.
¿Cuántas demostraciones de robot ahorran los guantes?
LiberAI ya probó la idea combinando demostraciones de robot con demostraciones humanas grabadas con guantes.
En una evaluación de ocho tareas, una política entrenada con el 25% del conjunto completo de demostraciones de robot más el 100% del conjunto de guantes logró un puntaje de progreso de 75,6. Una política entrenada con el 100% de las demostraciones de robot obtuvo 72,8.
Según LiberAI, los conjuntos completos de robot y de guantes tenían la misma cantidad de demostraciones, lo que indica que la experiencia humana grabada con guantes puede complementar una cantidad menor de datos específicos de robot.
La comparación no significa que el total de datos de entrenamiento bajara en 75%, porque se sumó una cantidad importante de demostraciones humanas. Lo que sí sugiere es que la experiencia humana puede hacer más útil una colección relativamente chica de demostraciones de robot.
| Datos de entrenamiento | Puntaje de progreso |
|---|---|
| 25% de demostraciones de robot + 100% de guantes | 75,6 |
| 100% de demostraciones de robot | 72,8 |
LiberAI también investigó si los guantes podían enseñar conductas de manipulación que faltaban en las demostraciones de robot. Cuando las demostraciones de robot cubrían solo tareas de tomar y dejar objetos, la política resultante marcó un puntaje de progreso de 2,2 en otros tipos de manipulación. Al sumar demostraciones con guantes de acciones distintas a tomar y dejar, el puntaje subió a 47,5, y con datos de guantes más amplios llegó a 54,6, cerca del 56,3 de la referencia Teleop All.
Para LiberAI es un paso hacia la meta mayor, usar la experiencia humana no solo para mejorar conductas que el robot ya conoce, sino para ampliar las capacidades físicas que una política puede aprender.
Un robot que se parece más a quien le enseña
LiberAI ataca el problema de persona a robot también desde el hardware. Si la IA va a aprender habilidades físicas de las personas, ayuda que el robot pueda reproducir al menos algunos de los movimientos que ellas usan.
Por eso el robot LEO tiene manos diestras, muñecas articuladas y una cintura ajustable, y sus cámaras están ubicadas para dar vistas más parecidas a las grabaciones humanas usadas en el entrenamiento.
Basta pensar en destapar una botella. Los dedos tienen que tomar y mantener un agarre mientras gira la muñeca. Abrir un cajón exige que los dedos enganchen la manilla mientras la mano, la muñeca y el brazo coordinan el tirón. Recoger algo cerca del suelo puede requerir que se mueva también el torso. LiberAI sostiene que reducir las diferencias innecesarias entre el movimiento humano y el del robot hace más fácil transferir la experiencia humana.
En pruebas descritas en el material técnico de la empresa, LiberAI entrenó políticas separadas para LEO y para otra plataforma robótica, Tianji, con las mismas grabaciones de guantes y la misma cantidad de datos de teleoperación para cada robot.
| Tarea | LEO | Tianji |
|---|---|---|
| Girar una perilla | 91,3 | 76,3 |
| Ordenar pantuflas | 80,0 | 35,0 |
| Abrir un cajón | 100,0 | 75,0 |
| Promedio | 90,4 | 62,1 |
Junto con el enfoque de hardware, Liber-0 usa lo que la empresa llama Unified Embodiment Representation, una representación unificada del cuerpo. Le da al modelo información sobre el cuerpo que ejecuta la acción. Rasgos humanos como la estatura, el largo del brazo, la configuración corporal y la geometría de la mano se representan junto con la geometría y las capacidades de movimiento de los brazos robóticos y las manos diestras.
La idea es que el modelo no tenga que suponer que todo cuerpo hace una tarea de la misma forma. El cuerpo pasa a ser parte del contexto desde el cual se predice la acción adecuada. Una persona alta, una más baja y un robot pueden abrir el mismo cajón con movimientos algo distintos, y LiberAI quiere que su modelo aprenda la conducta física de fondo tomando en cuenta esas diferencias.
Un modelo base para la acción física
Liber-0 se puede entender como parte de la nueva generación de modelos fundacionales para robótica, aunque LiberAI lo describe específicamente como un modelo de acción del mundo.
La analogía con los grandes modelos de lenguaje sirve. Esos modelos aprenden de cantidades enormes de lenguaje humano en vez de programarse con una respuesta para cada pregunta posible. LiberAI sigue una idea parecida en el mundo físico, exponer un modelo a cantidades enormes de experiencia humana y enseñarle la relación entre percepción, acción y resultado físico.
Pero la IA física suma una complicación. El texto les da a los computadores una representación relativamente común del conocimiento humano, y las acciones físicas no. Una mano humana y una pinza robótica son mecanismos muy distintos, e incluso dos robots pueden necesitar movimientos diferentes para lograr la misma tarea.
Liber-0 intenta resolverlo con varias etapas de entrenamiento. Primero, el modelo aprende predicción visual amplia a partir de videos que cubren actividades humanas, objetos y entornos diversos. En la etapa siguiente combina la predicción de observaciones visuales futuras con la predicción de acciones, y junta el video humano con la información de movimiento de las grabaciones con guantes y con robots.