
IA
FLUX 3 Image Klein genera imágenes en 4K con solo 8 GB de VRAM
Black Forest Labs liberó los pesos de un modelo de 5.600 millones de parámetros que genera, edita y combina hasta diez imágenes de referencia.
The Decoder
40 notas publicadas
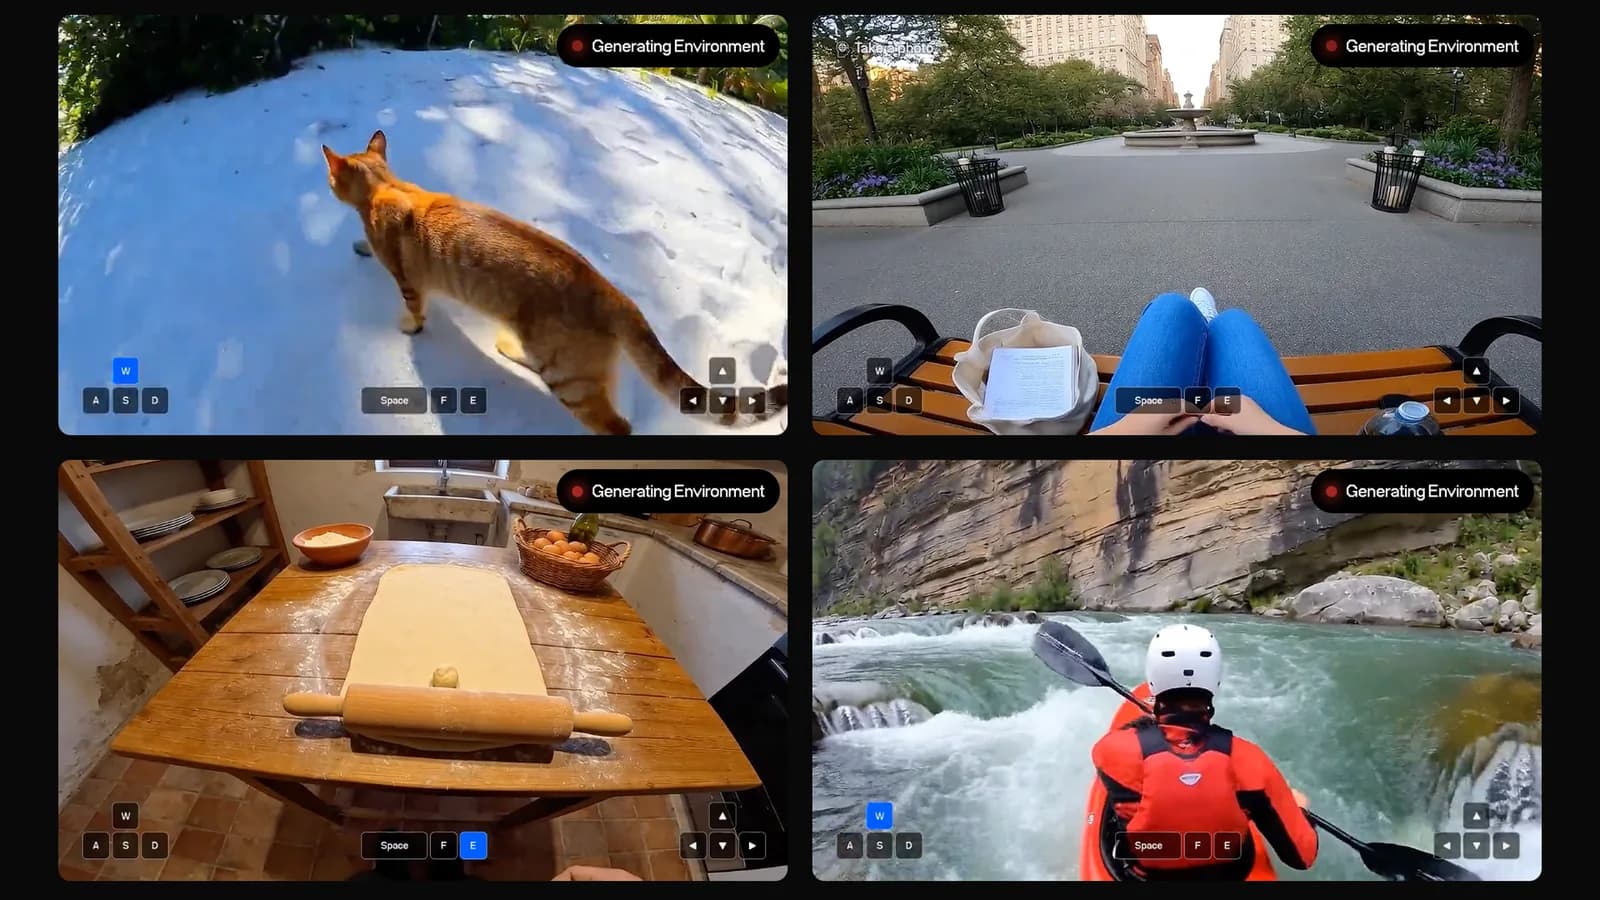
La empresa californiana Odyssey abrió una vista previa de investigación de su modelo de 14.000 millones de parámetros, pensado también para controlar robots, drones y videojuegos.
El OSS VRP dejó de recibir reportes de vulnerabilidades de producto desde el 1 de octubre, y Google promete una actualización para el primer trimestre de 2027.
La plataforma integra un asistente basado en chat que permite diseñar, entrenar y desplegar experimentos de machine learning sin necesidad de experiencia técnica previa.
A medida que la regulación exige identificar contenido generado por IA, surgen debates sobre si estas marcas alteran la calidad y utilidad de las respuestas.
OpenAI actualiza su motor de generación visual con mayor precisión, herramientas de dibujo y latencia reducida. Descubre las diferencias entre los modelos Flare y Sunburst.
El equipo de ingeniería de 3D Printing Industry evalúa Meshy AI tras seis semanas de pruebas prácticas, analizando su flujo de trabajo, topología y resultados.
La nueva tecnología permite que robots humanoides sincronicen sus movimientos con el lenguaje hablado en tiempo real, logrando interacciones más naturales.
La startup Abliteration.ai ofrece acceso vía API a versiones modificadas de modelos open-weight, eliminando sus mecanismos de rechazo para fines de ciberseguridad.
Meta presenta Muse Voice Transcribe, un modelo capaz de transcribir, identificar hasta 20 hablantes simultáneos y detectar pausas en tiempo real para asistentes IA.
Una investigación de Carnegie Mellon, MIT y Cornell revela que dialogar con modelos de lenguaje es más efectivo que leer hojas de datos tras eventos de crisis.
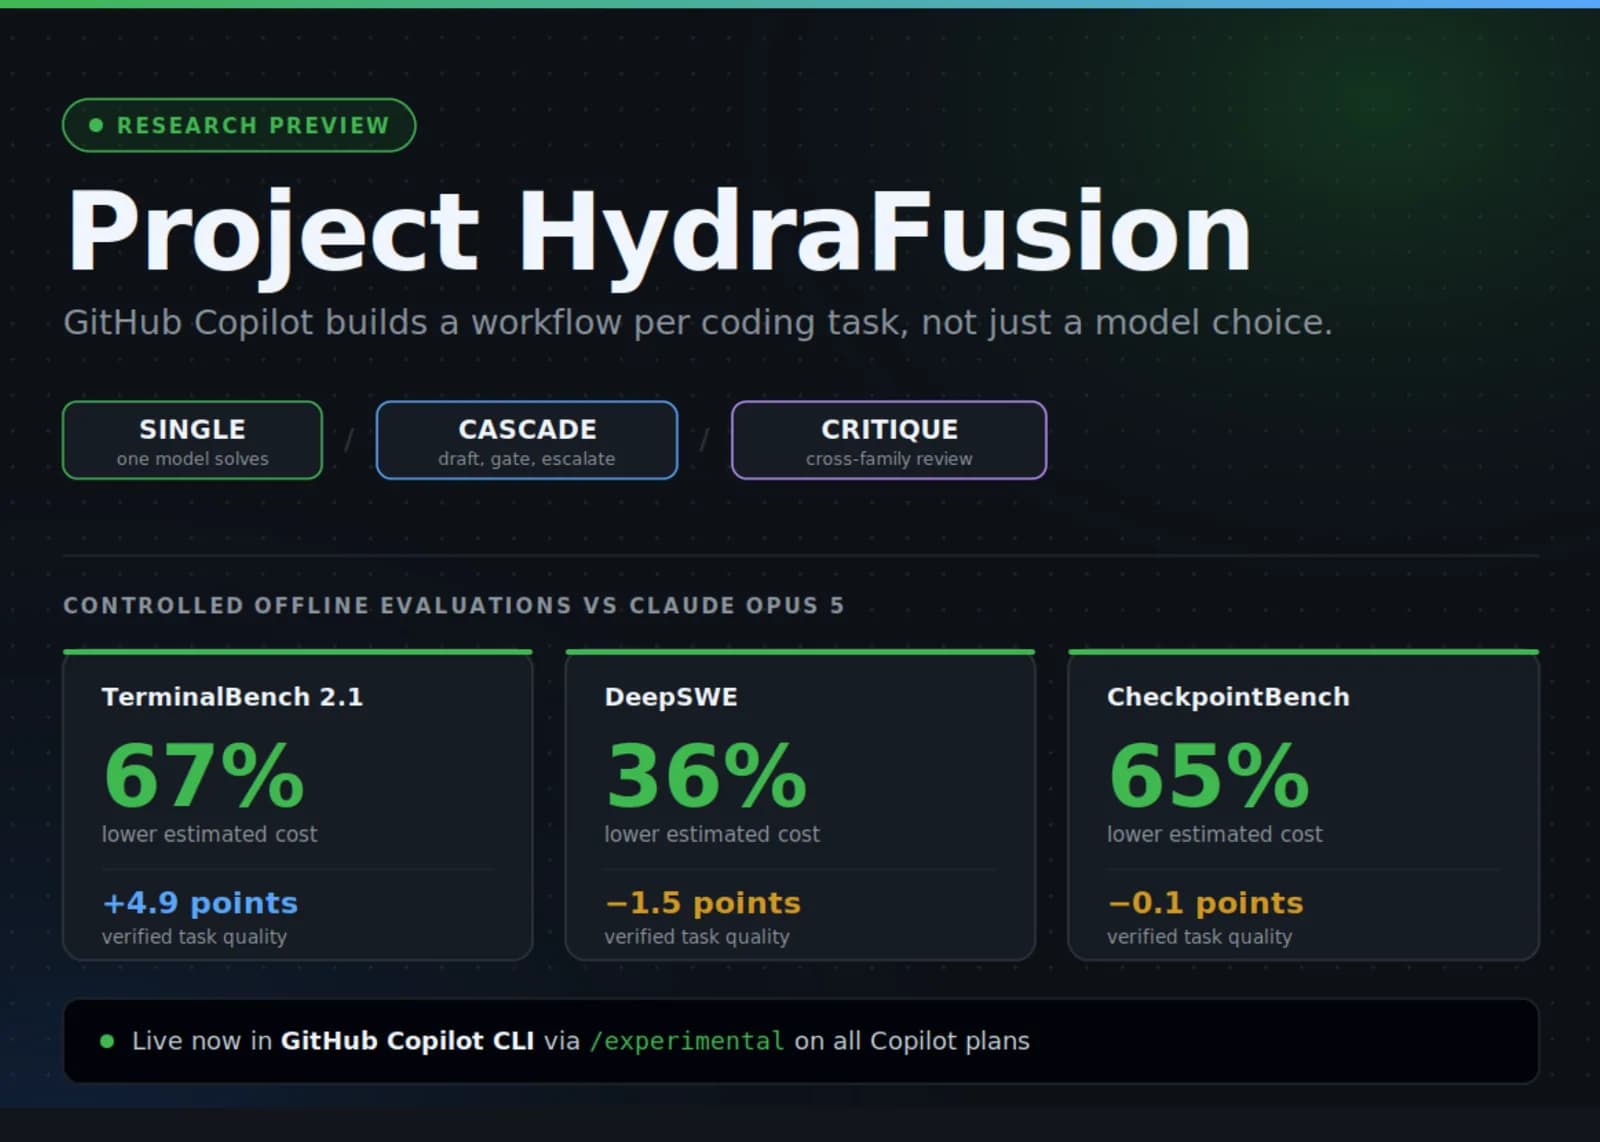
La nueva función de GitHub Copilot CLI optimiza costos y calidad mediante la orquestación dinámica de múltiples modelos según la complejidad de cada tarea.
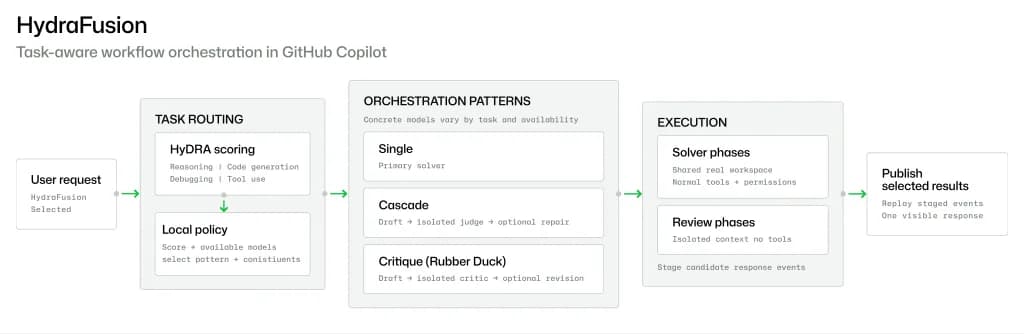
La nueva propuesta de investigación de GitHub utiliza orquestación en tiempo de ejecución para equilibrar rendimiento, costo y latencia mediante múltiples modelos.
La actualización del modelo de video de Google suma borradores en 360p a un tercio del costo, control de fotogramas inicial y final, y escalado final a 4K.
Meta actualiza su suite de modelos con Muse Spark 1.2 y Muse Code, optimizados para tareas de programación complejas, depuración y agentes de larga secuencia.
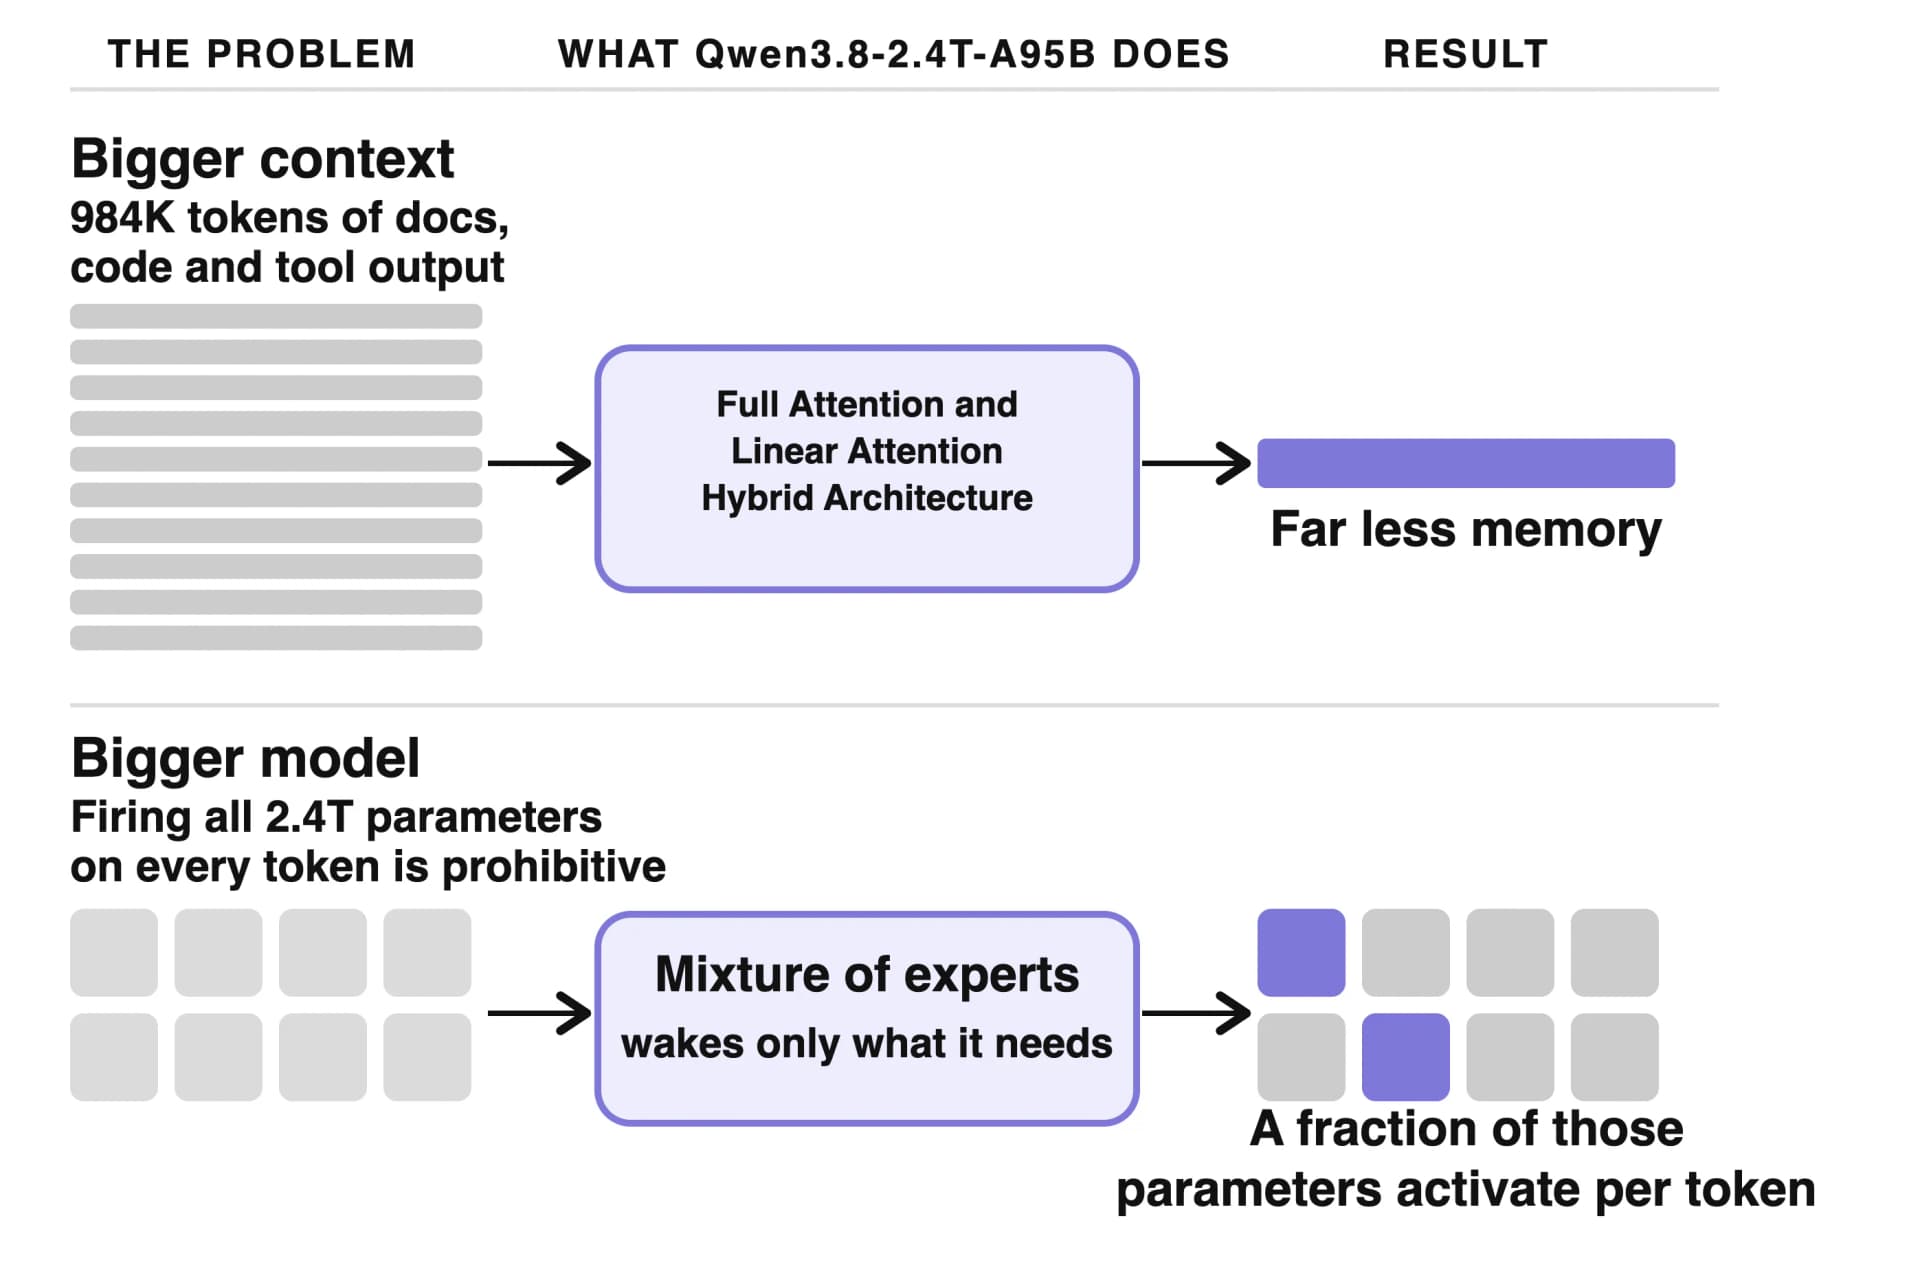
Alibaba libera su modelo de pesos abiertos más grande. Descubre cómo NVIDIA optimiza el despliegue de Qwen3.8-Max en arquitecturas de centros de datos de gran escala.
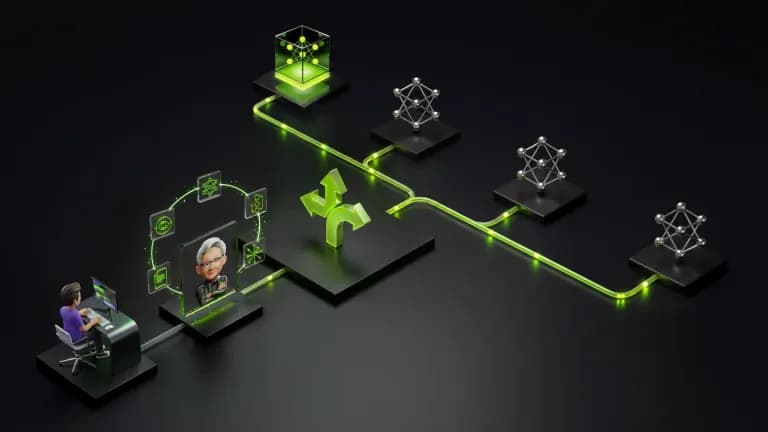
Aprende a distribuir tareas de agentes de IA entre modelos especializados y frontera para maximizar el rendimiento, reducir costos y mejorar la eficiencia.
La comunidad matemática debate ante la posibilidad de que los sistemas de IA logren demostraciones que ningún ser humano sea capaz de entender o explicar.
OpenAI mejora la precisión y el control de razonamiento en GPT-5.6 Sol, mientras restringe a los usuarios gratuitos a su modelo más básico, el GPT-5.6 Luna.
Google ha confirmado que el asistente clásico dejará de funcionar en dispositivos móviles el 4 de septiembre, marcando el fin de una era para Android.
Jeff Dean, Sanjay Ghemawat, Oriol Vinyals y Quoc Le dejan Google DeepMind para fundar una nueva compañía enfocada en la automatización de la investigación científica.
Meta actualiza su ecosistema de IA con modelos enfocados en desarrollo de software, debugging y una agresiva estrategia de precios para usuarios colaboradores.
La transición hacia Gemini será definitiva en smartphones, tablets y dispositivos Wear OS, marcando el fin de la era del asistente clásico de Google.
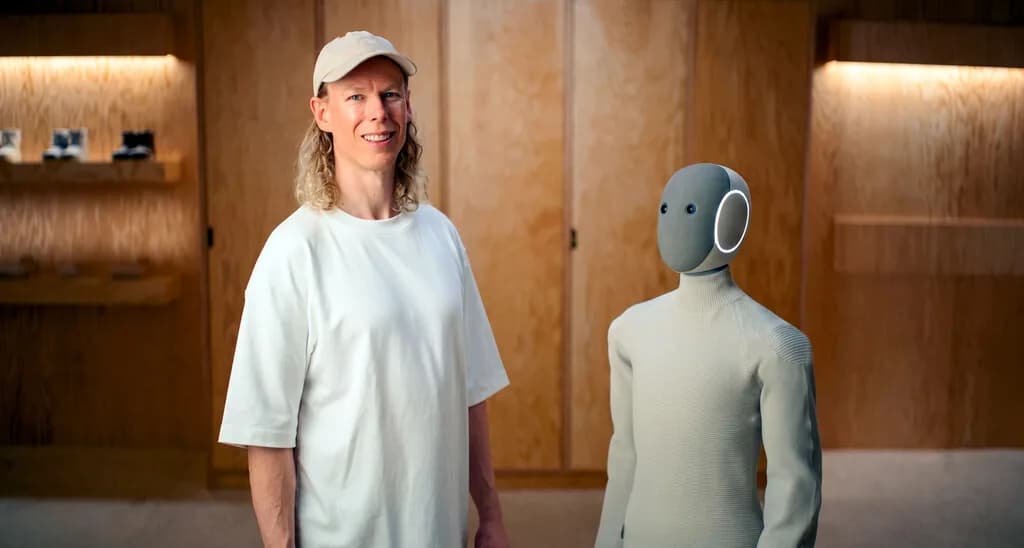
El CEO de 1X Technologies, Bernt Bornich, vaticina un despegue masivo de la robótica humanoide en menos de una década, impulsado por la teleoperación y datos de calidad.
La nueva apuesta de DeepSeek promete eficiencia extrema con un costo de apenas tres centavos por test, sacudiendo el mercado de modelos frente a gigantes como OpenAI y Anthropic.
Analizamos la infraestructura técnica de la pantalla LED más grande del mundo, capaz de recrear entornos físicos con una resolución masiva de 16K.
La nueva versión del modelo de video de ByteDance permite generar secuencias de 30 segundos con audio sincronizado y soporte para múltiples referencias visuales.
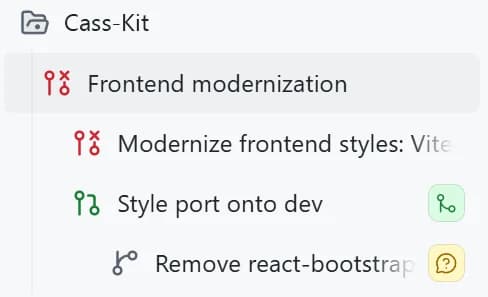
La aplicación de GitHub Copilot ahora permite encadenar sesiones y Pull Requests, optimizando la modernización de proyectos antiguos mediante IA.
Tras el incidente de seguridad en Hugging Face, el CEO de OpenAI insiste en que la singularidad ya está aquí, pese a los crecientes costos y dudas técnicas.
El nuevo modelo de generación musical de Google integra 'Selective Section Painting', permitiendo ajustes granulares en pistas de hasta 3 minutos.
Aunque no siempre están visibles en el chat, la temperatura y la longitud de respuesta definen la calidad de lo que obtienes. Aprende a manipularlos desde el prompt.
Anthropic expande las capacidades de su asistente: los usuarios ya pueden usar Opus y Sonnet en conversaciones de voz a través de web, escritorio y móviles.
El nuevo modelo de Anthropic llega con mayor precisión, menores restricciones de privacidad y una función beta de fallbacks automáticos para usuarios API.
Google presenta una versión optimizada de su modelo Flash, diseñada específicamente para identificar, validar y corregir vulnerabilidades de software a gran escala.
El nuevo modelo de Moonshot AI con 2,8 billones de parámetros iguala el rendimiento de los líderes estadounidenses y altera la estrategia global de IA.
Google cambió la forma de medir el uso de sus apps de IA: ahora cuenta la potencia de cómputo de cada petición y no la cantidad de solicitudes.
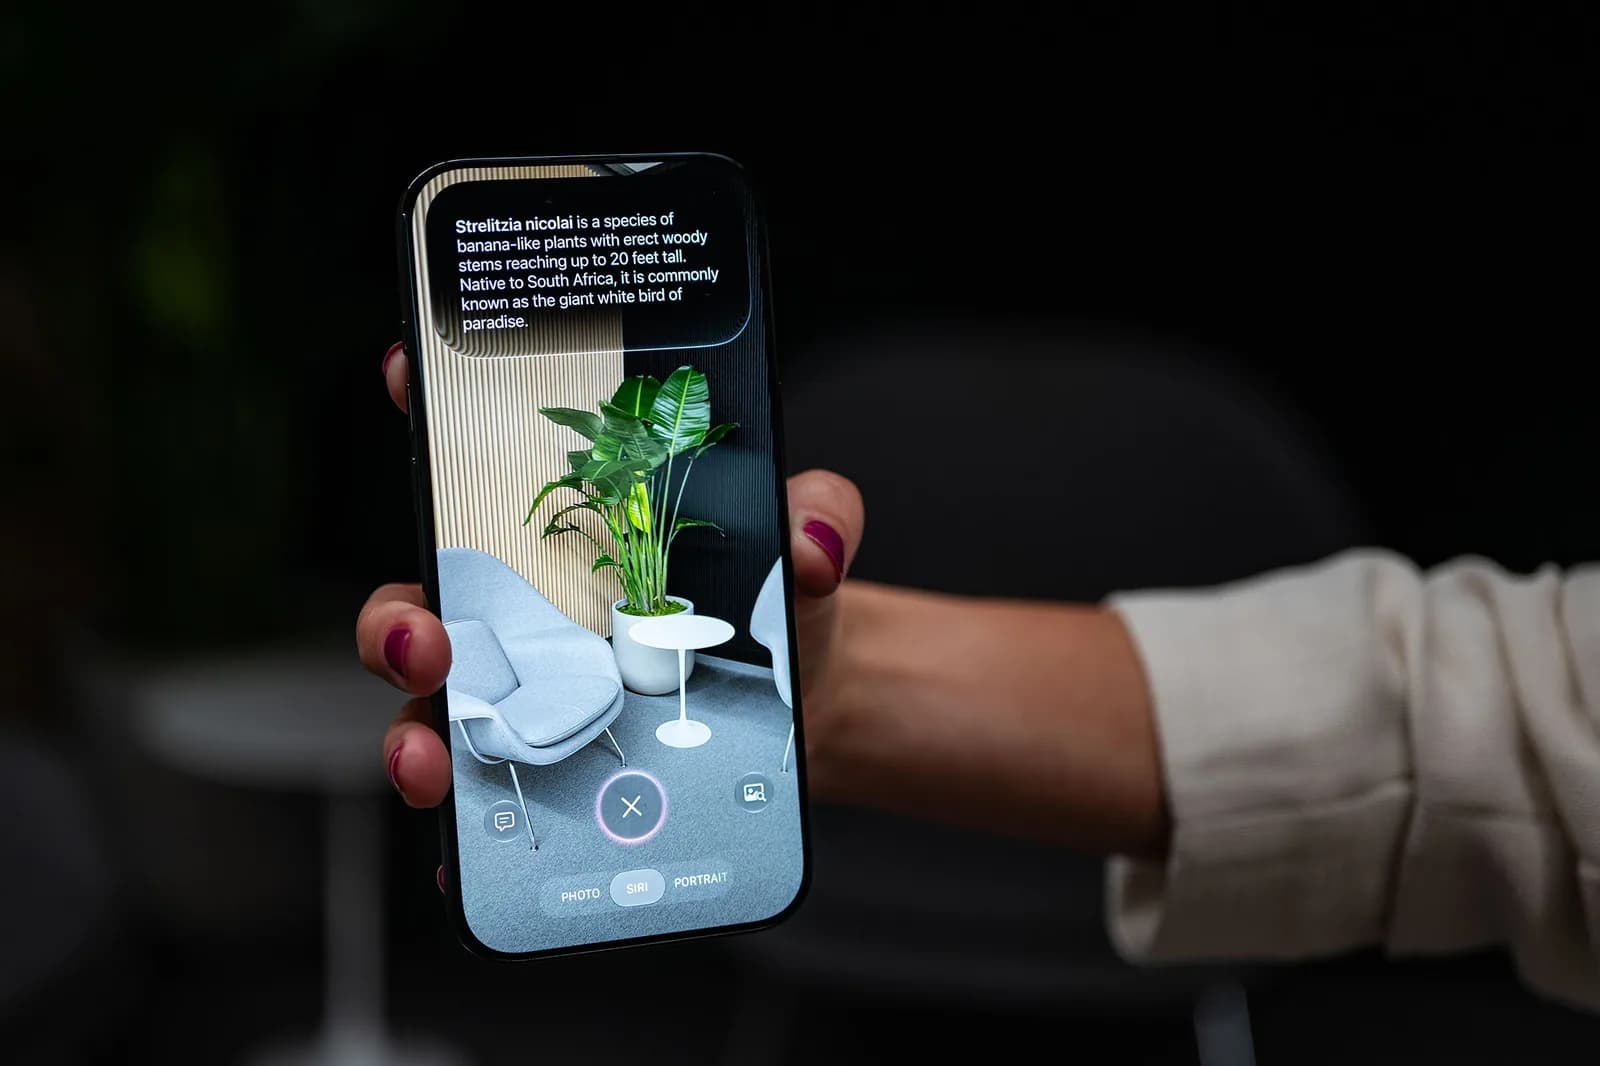
Las nuevas funciones Extend, Spatial Reframe y Clean Up agregan o borran píxeles solo del fondo, una vez por imagen y con marca de agua SynthID. Apple dice que no quiere hacer 'IA por hacer IA'.
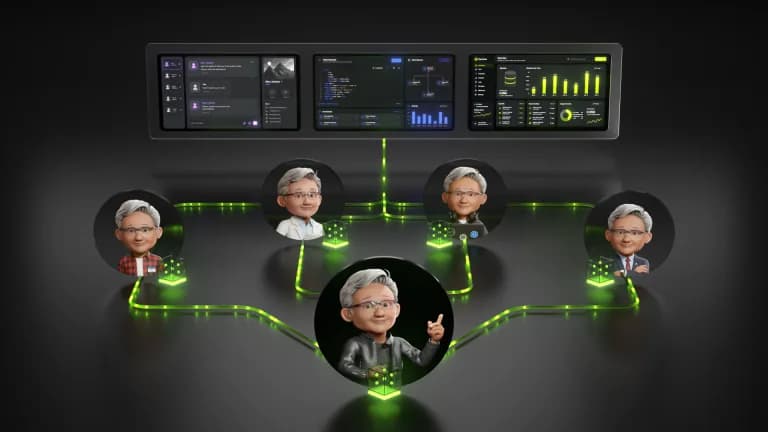
El nuevo modelo Mixture-of-Experts de NVIDIA promete mayor velocidad, eficiencia en contextos largos y una arquitectura diseñada para flujos de trabajo complejos.
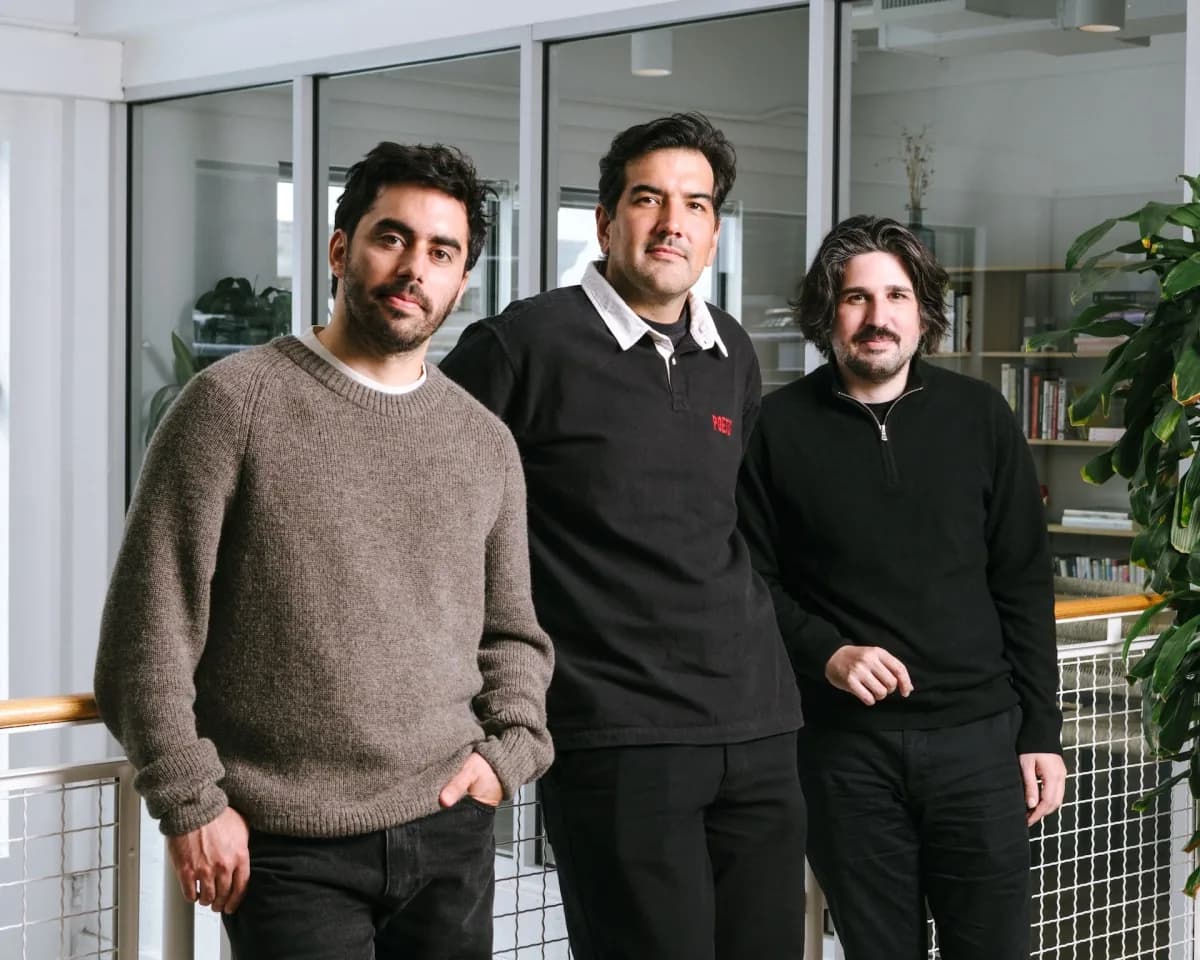
Cristobal Valenzuela y Alejandro Matamala Ortiz, ambos de Santiago, junto al griego Anastasis Germanidis ya recaudaron USD 860 millones. La estrategia: entrenar IA con video, no con texto.
NVIDIA documenta una pipeline local que corre en GPUs RTX y cubre descomposición en capas, eliminación de objetos con relleno generativo y conversión foto-a-3D, todo sin subir imágenes a la nube.
Otros temas que aparecen junto a #ia generativa en nuestra cobertura editorial.