IA
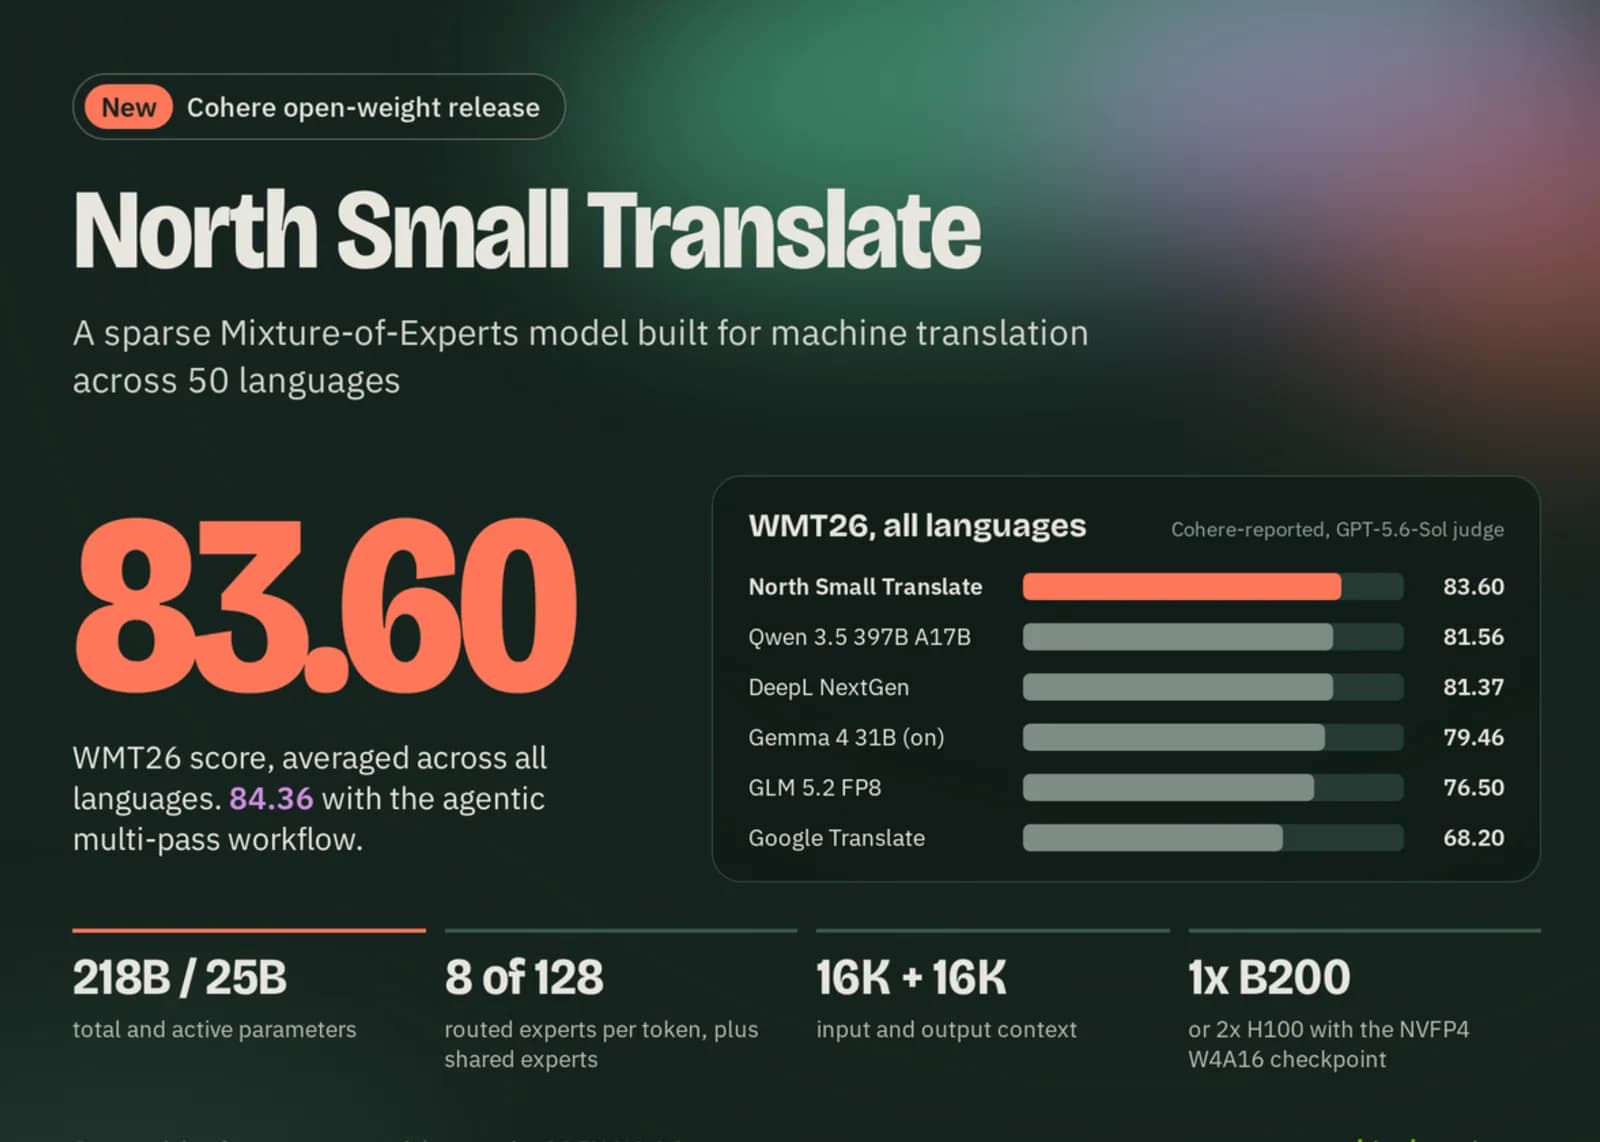
Un modelo MoE de 30B activa solo 3B parámetros por token
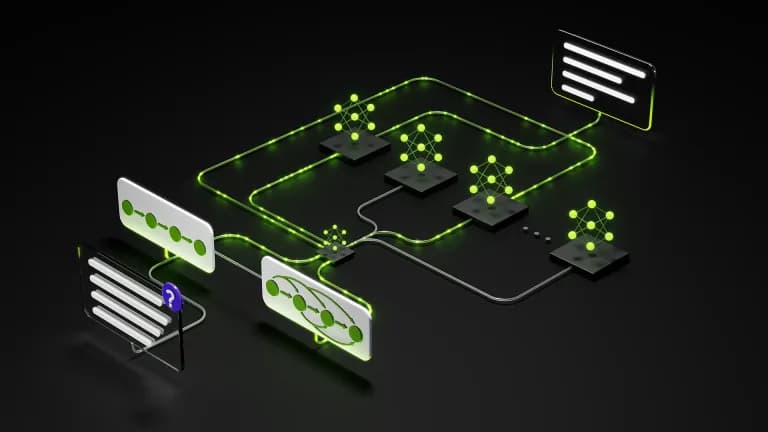
NVIDIA explica con Nemotron 3.5 Lightning en qué se diferencian los modelos densos y los de mezcla de expertos, y por qué la decisión depende del presupuesto de memoria y de la concurrencia.
NVIDIA Developer