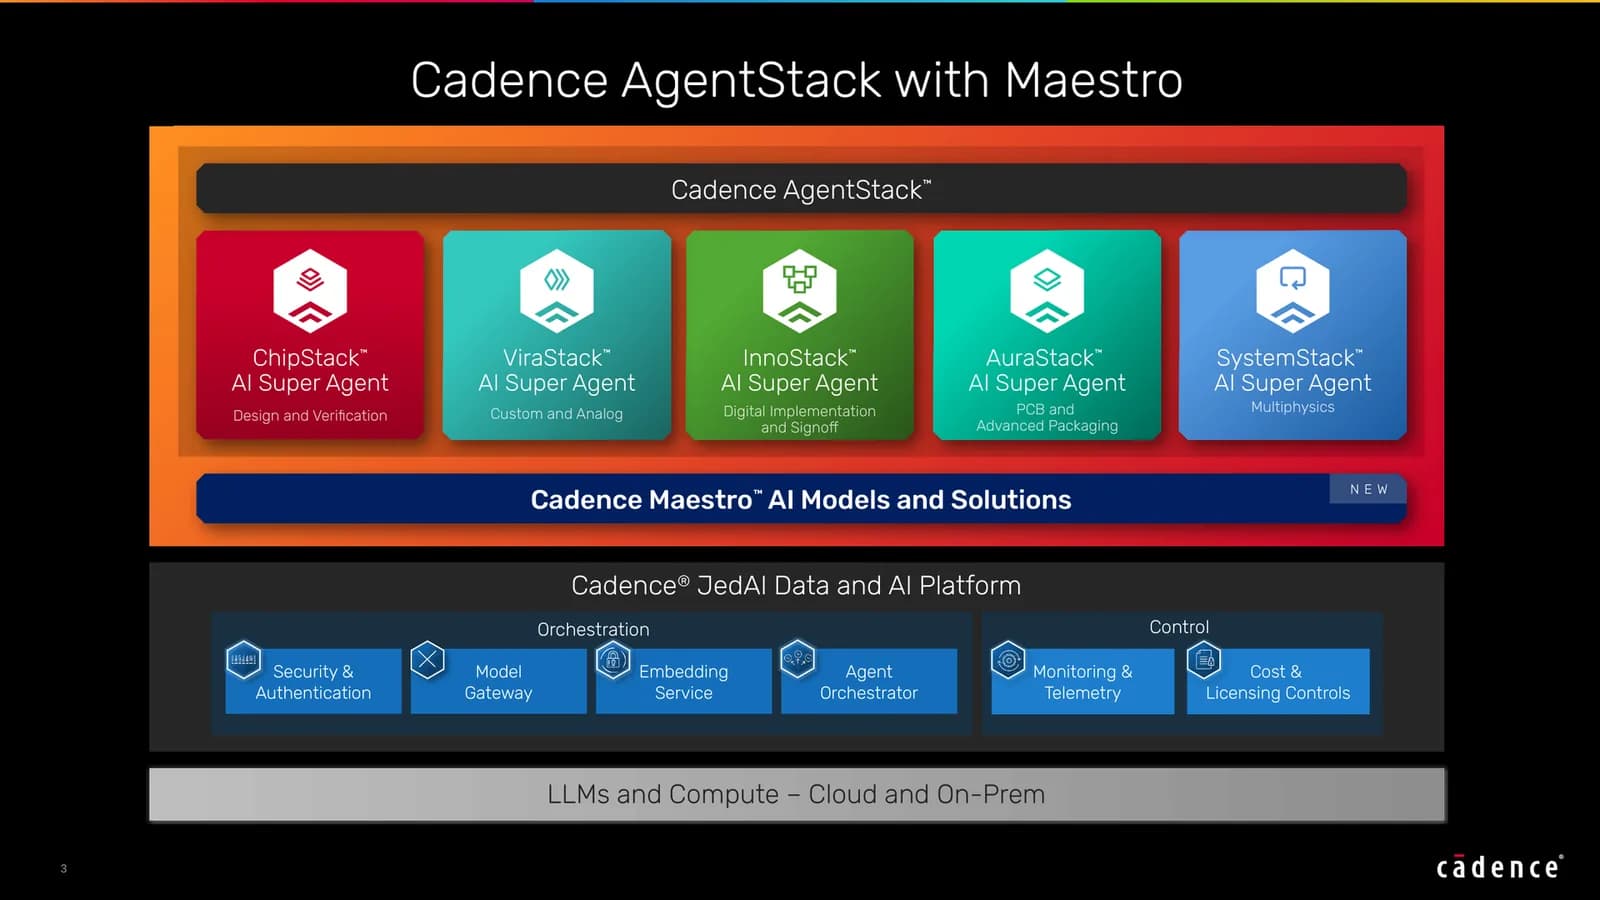
Cadence, una de las mayores empresas de automatización de diseño electrónico (EDA), presentó Maestro, una cartera de modelos de IA especializados para sus agentes de diseño de chips. Lo anunció en un comunicado de prensa enviado justo antes de su reporte de resultados.
En sus primeras mediciones contra modelos de propósito general, Cadence asegura una mejora de hasta 30% en la calidad de los resultados y una eficiencia de hasta 5 veces en tokens, o sea menos tokens para la misma tarea. Los primeros modelos "están disponibles para clientes seleccionados de acceso anticipado" en el cuarto trimestre de 2026. Se pueden correr en la nube de Cadence, en nubes públicas o en instalaciones propias del cliente, y post-entrenarse con sus "datos, diseños y flujos de trabajo propietarios".
Tom's Hardware conversó sobre Maestro con dos ejecutivos de Cadence, Rob Knoth, director sénior de estrategia y nuevos negocios, y Paul Cunningham, vicepresidente sénior y gerente general.
La diferencia con GPT-Synopsys
El enfoque se separa del modelo especializado de Synopsys, GPT-Synopsys, que correrá en infraestructura alojada por OpenAI y no usa datos de clientes para entrenarse. Los dos gigantes del EDA anunciaron sus modelos con menos de un mes de diferencia y ahora toman caminos distintos sobre dónde terminan los datos de diseño del cliente.
En lo que quizás coinciden es en el motivo. Cunningham le dijo a Tom's Hardware Premium que el costo de los agentes "de verdad empezó a explotar", y agregó: "Y creo que el mundo se dio cuenta". Por eso, según él, el paso natural es llevar más de las iteraciones de los agentes "a los pesos de los propios modelos".
¿Cómo funciona Maestro?
Maestro opera a través de los AI Super Agents de Cadence, que "interpretan la intención del diseño, descomponen tareas" y "orquestan la cartera Maestro con otros modelos de frontera y de pesos abiertos líderes", evaluando compromisos para guiar decisiones con conocimiento del dominio. También usa aprendizaje por refuerzo, en el que los "solucionadores deterministas de Cadence evalúan las salidas contra objetivos de ingeniería, restricciones y la verdad de referencia". Los resultados vuelven a los modelos para mejorarlos.
Entre los modelos está Nemotron de Nvidia. Los clientes pueden hacer ellos mismos el entrenamiento con sus datos usando el harness de ajuste fino de Cadence, potencialmente "en sus propias GPU, en su propia red", dijo Cunningham. Sobre Nemotron en particular, comentó que estaba "dando resultados muy sólidos y mejorando muy, muy rápido".
¿Qué miden el 30% y el 5x?
Con el EDA agéntico se repite la necesidad de precisar qué miden las cifras. En diseño de chips, la calidad de resultados suele referirse a la potencia, el rendimiento y el área del diseño, pero Cadence no especificó qué mide su 30%. Tanto esa cifra como la de 5 veces en eficiencia de tokens se miden contra "un modelo base de propósito general", que según Cadence es el modelo de código abierto del que partió Maestro antes de su entrenamiento. La empresa no quiso nombrarlo y solo dijo que es "uno de los modelos de código abierto líderes, muy competitivo con los modelos comerciales de frontera".
Cadence atribuye el ahorro de tokens a equilibrar las "llamadas a herramientas" de EDA y de automatización de diseño de sistemas (SDA) "con invocaciones al LLM". Cunningham lo explicó con una analogía. "No necesitas ir al supermercado en un motor a reacción", dijo, y lo que se busca es "el modelo correcto en el momento correcto para la tarea correcta".
El tiempo de ejecución también cuenta. Knoth le dijo a Tom's Hardware Premium en septiembre que una llamada a herramienta puede tardar desde horas hasta días en devolver un valor, mientras que los ciclos de entrenamiento de la industria de IA "están acostumbrados a minutos".
La eficiencia podría bajar costos, porque el uso de Maestro cuenta dentro del modelo de precios de agentes de Cadence, una suscripción con una cuota de consumo y cobro por el uso que la supere, según Cunningham. No dijo si el ahorro de tokens reduce la cuenta del cliente.
Flexibilidad y seguridad
En Synopsys, la flexibilidad para el cliente está en Autopilot, que según la empresa permite "elegir entre modelos de lenguaje comerciales, de código abierto y afinados" en "despliegues gestionados por Synopsys y por el cliente", con infraestructura en la nube o local.
Para la seguridad de los agentes, como el aislamiento en sandbox, Cadence dice que trabaja con Nvidia en una integración con la OpenShell Reference Architecture, que Nvidia lanzó la semana pasada nombrando a Cadence y a Synopsys. Estas opciones ayudan a proteger la propiedad intelectual del cliente.
| Cadence Maestro | GPT-Synopsys | |
|---|---|---|
| Anuncio | 26 de octubre de 2026 | 30 de septiembre de 2026 |
| Qué es | Cartera de modelos especializados para los AI Super Agents de Cadence | Modelo especializado que opera directamente las herramientas de Synopsys |
| Socio de modelos | Nvidia (Nemotron, OpenShell) | OpenAI |
| Modelos | LLM post-entrenados, modelos de decisión entrenados y habilidades de agente, combinados con modelos de frontera y de pesos abiertos, incluido Nemotron | Modelos de frontera de OpenAI |
| Dónde corre | Nube de Cadence, nubes públicas o instalaciones del cliente | Infraestructura alojada por OpenAI |
| Datos del cliente | Se puede post-entrenar con datos, diseños y flujos propios, con herramientas de Cadence | No se usan para entrenar el modelo |
| Resultados declarados | Hasta 30% más calidad y hasta 5x en eficiencia de tokens frente al modelo de código abierto sin nombre del que partió (resultados iniciales, medida no informada) | Ninguno informado |
| Disponibilidad | Primeros modelos para clientes seleccionados en el cuarto trimestre de 2026 | Sin fecha, con colaboraciones tecnológicas tempranas en curso |
| Clientes nombrados | Socionext, Silicon Labs (Nvidia como socio) | Ninguno |
| Precio | Suscripción con cuota de uso y cobro adicional por consumo | No informado, Synopsys y OpenAI comparten ingresos según su acuerdo |
Un año de agentes en Cadence
En la llamada de resultados de julio, el CEO Anirudh Devgan dijo que ChipStack, su agente de diseño y verificación, "tiene más de 20 colaboraciones con clientes", y ViraStack, su agente para diseño personalizado y analógico, "más de 25". Socionext anunció la semana pasada que está aplicando InnoStack. Silicon Labs también atribuyó a ChipStack una depuración más rápida, y las dos empresas dicen que ahora siguen de cerca a Maestro.
La consolidación agéntica de Cadence empezó con la compra de ChipStack en noviembre de 2025. En junio de 2026 la empresa aseguró que su agente había llegado a autonomía de nivel 5. En septiembre, dos días antes del anuncio de GPT-Synopsys, Knoth adelantó a Tom's Hardware Premium los ingredientes de Maestro: "ciclos de aprendizaje por refuerzo, post-entrenamiento específico del dominio de modelos de pesos abiertos, enrutamiento de modelos". Maestro ya está debajo de los cuatro super agentes, con una ventana de fin de año parecida a la de Autopilot de Synopsys.
| Cuándo | Producto | Lo que afirma Cadence | Estado |
|---|---|---|---|
| Noviembre de 2025 | Compra de ChipStack (startup de verificación agéntica) | Cerrada. El cofundador Kartik Hegde dirige ahora el grupo central de investigación en IA de Cadence | |
| Febrero de 2026 | ChipStack AI Super Agent | Hasta 10 veces más productividad en codificar diseños y bancos de prueba, planes de prueba, regresiones y depuración | En acceso anticipado desde el lanzamiento |
| Abril de 2026 | ViraStack (personalizado y analógico), InnoStack (implementación digital) y AgentStack (agente principal) | Socionext despliega InnoStack en producción, el resto sin informar | |
| Junio de 2026 | ChipStack en nivel 5, con Nemotron y OpenShell de Nvidia | Ciclos de validación RTL más de 40 veces más rápidos en el despliegue de Nvidia | Nivel 5 y AgentStack para clientes de acceso anticipado en el segundo semestre de 2026 |
| Julio de 2026 | AuraStack (PCB y encapsulado avanzado) | Hasta 2 veces menos tiempo de salida al mercado y 15 veces más productividad | Disponible en el supercomputador Millennium M2000 de Cadence. Nokia lo despliega desde el 21 de octubre |
| Septiembre de 2026 | ChipStack RTL Generation Agent | En promedio 24% menos área y 18% menos potencia que el código de un modelo base puro, en evaluaciones iniciales | Para clientes seleccionados en el cuarto trimestre de 2026, con colaboración temprana con Honda R&D |
| 26 de octubre de 2026 | Cartera de modelos Maestro | Hasta 30% más calidad y hasta 5 veces más eficiencia de tokens frente a un modelo base, en resultados iniciales | Primeros modelos para clientes seleccionados en el cuarto trimestre de 2026, con cerca de una docena de colaboraciones |
Acceso anticipado no es disponibilidad general
Con este ritmo hay que distinguir entre acceso anticipado y disponibilidad general. Cadence y Synopsys pueden mostrar colaboraciones con clientes. Synopsys apunta a la disponibilidad general de su cartera AgentEngineer y de Autopilot para fin de año, mientras que Cadence no dio fecha de disponibilidad general para Maestro. Para GPT-Synopsys, según sus socios, solo hay "colaboraciones tecnológicas tempranas en curso". Las plataformas y los agentes siguen en desarrollo.
Para Maestro, Cunningham espera "más casos de estudio, más beneficios cuantificables" durante el cuarto trimestre.
"Vamos a llevar los agentes y la IA agéntica de forma nativa a nuestra vertical, no a que nuestra vertical quede incrustada en agentes de propósito general", dijo.
Solo los resultados de clientes en flujos reales pondrán a prueba el 30% de Cadence.