Esta entrada se publicó originalmente en el sitio de Nota AI y se reproduce con su autorización.
Cuando una empresa adopta inteligencia artificial, el cuello de botella más común no es el desarrollo del modelo. Es la etapa de despliegue: conseguir que un modelo terminado corra de forma confiable en el dispositivo de destino real.
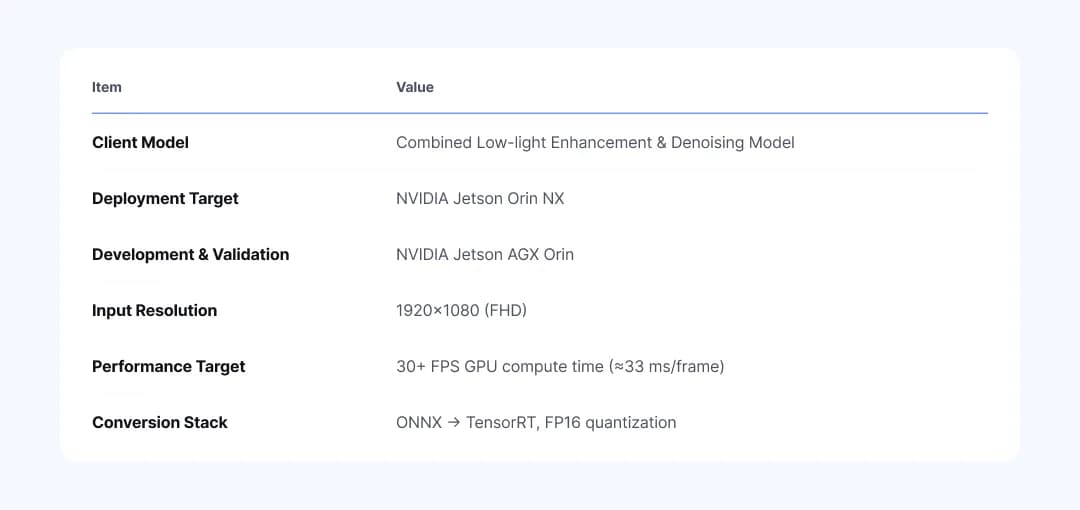
Este proyecto de restauración de video nocturno para circuito cerrado de televisión siguió el mismo patrón, con la optimización en la etapa de despliegue como desafío central. El modelo que el cliente ya tenía medía 400 milisegundos por cuadro en el entorno de borde de destino, una Jetson Orin NX, muy lejos del objetivo de tiempo real de 33 milisegundos, equivalente a 30 cuadros por segundo.
El resultado final fue reducir el tiempo de procesamiento a menos de 28 milisegundos, superando los 30 cuadros por segundo y cumpliendo a la vez los requisitos de calidad del cliente.
Esa mejora no salió de una optimización genérica aplicada al final. Cuando los métodos estándar, como la cuantización y la poda, llegaron a su límite, el equipo combinó las restricciones del hardware con las características propias del video para rediseñar el modelo desde cero.
¿Por qué 30 cuadros por segundo no es un número arbitrario?
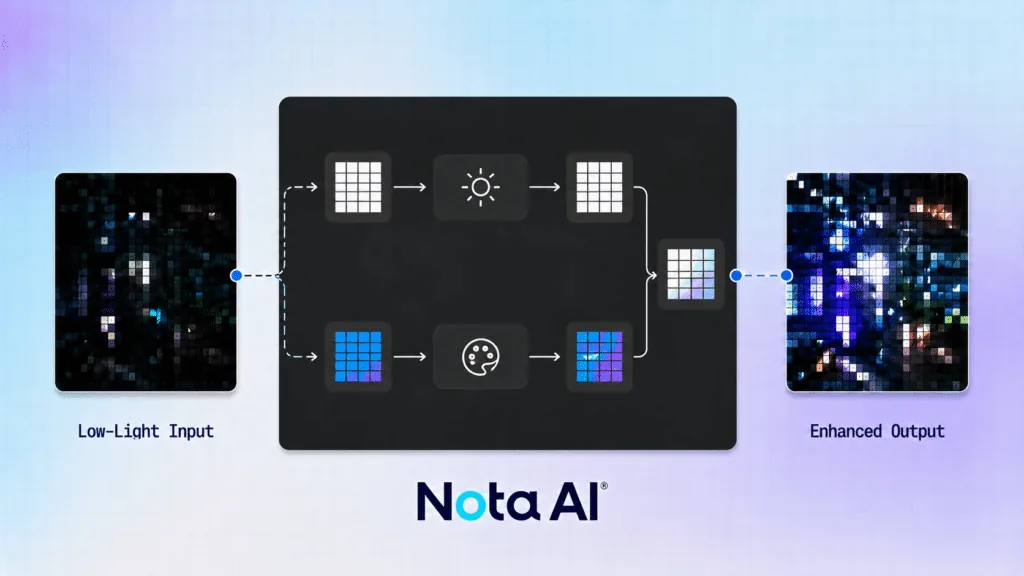
Es el piso para la detección y el seguimiento de objetos que vienen después en la cadena. Por debajo de esa tasa, los objetos que se mueven rápido caen entre cuadros y la detección se vuelve poco confiable.
Tratar el caso como un problema puro de velocidad sería perder el punto. Como el dominio de despliegue es la operación comercial de cámaras de vigilancia, la calidad de imagen y las condiciones operativas están entrelazadas. Además de los 30 cuadros por segundo y del despliegue en el borde, deben cumplirse en simultáneo estas condiciones:
- Entorno sin imagen de referencia: al no haber imágenes de referencia en terreno, el desempeño debe validarse con métricas de calidad sin referencia.
- Preservación del orden de brillo: evita distorsionar el equilibrio relativo entre luces y sombras, algo que degradaría la precisión de la detección posterior.
- Calidad de imagen natural: necesaria para que los algoritmos de reconocimiento extraigan características estables sin ruido artificial.
- Procesamiento concurrente de varios canales: varias cámaras deben correr al mismo tiempo sobre una sola GPU por eficiencia de infraestructura.
La primera barrera que enfrentan los modelos existentes es la diferencia en las métricas de evaluación. La validación convencional se apoya en PSNR (relación señal-ruido de pico) o SSIM (índice de similitud estructural), que comparan la imagen restaurada contra una referencia real, píxel a píxel.
En un despliegue real de videovigilancia, esa referencia no existe. La evaluación debe apoyarse en métricas sin referencia: NIQE para la naturalidad percibida y LOE para el orden relativo de brillo dentro de cada cuadro. Una vez que el criterio se corre hacia métricas operativas como estas, incluso los modelos que lideran las tablas de conjuntos públicos dejan de garantizar ventaja de calidad en producción.
El muro de los 33 milisegundos
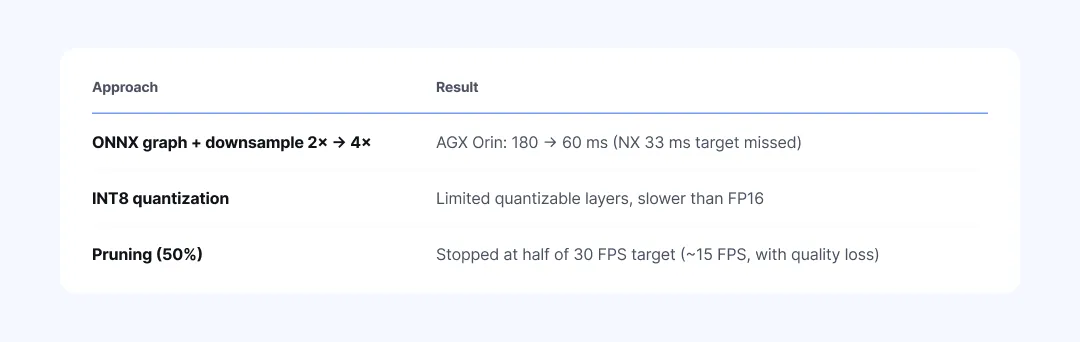
El modelo que el cliente había preparado era una arquitectura pesada: un módulo base de realce para poca luz seguido de otro módulo separado de reducción de ruido, para contener el ruido que se amplifica al levantar el brillo. Sobre la Jetson Orin NX, la inferencia original llegaba a unos 400 milisegundos, más de diez veces el objetivo. Para medir el techo de optimización, el equipo perfiló el modelo en una placa de desarrollo de mayor capacidad, la AGX Orin: incluso ahí la latencia rondaba los 180 milisegundos.
Se aplicaron todas las técnicas viables dentro del entorno de desarrollo. Primero, modificando el grafo ONNX del modelo original para reducir operaciones de transposición y redimensionado, y aumentando la tasa de submuestreo, la latencia bajó de 180 a cerca de 60 milisegundos. Pero al fijar TensorRT 10.3.x como entorno de ejecución, el propio motor empezó a hacer esa optimización de grafo de forma automática, sin dejar margen adicional por esa vía. La cuantización a INT8 terminó corriendo más lento que FP16, por la baja proporción de capas elegibles. Y una poda del 50% se estancó en la mitad de la tasa objetivo, cerca de 15 cuadros por segundo, con degradación visible de calidad.
.png)
La conclusión fue que la optimización posterior sobre esa arquitectura no podía llegar a 33 milisegundos. Como alternativa se probaron cuatro modelos muy citados en el área: RUAS, Zero-DCE++, LiteIE y Wave-mamba. Ninguno alcanzó el objetivo tampoco.
.png)
Tras esa secuencia de experimentos, la causa raíz quedó clara: tanto el modelo del cliente como las cuatro alternativas se apoyaban en un enfoque computacional pesado, el de generar o restaurar la imagen completa desde cero. Bajo ese patrón, ninguna optimización lograba cruzar la línea de los 33 milisegundos.
¿Cómo funciona el diseño con separación YUV?
Antes de diseñar la arquitectura propia, el equipo redefinió el problema. La esencia del realce de video nocturno es la restauración del canal de luminancia (Y), no la regeneración de los canales de crominancia (UV). En videovigilancia nocturna, la mayor parte de la información identificable es luminancia sepultada en la oscuridad. El color puede manejarse con una capa liviana de corrección en lugar de un decodificador profundo y pesado, con impacto insignificante en los algoritmos de reconocimiento posteriores.
De esa definición salieron tres decisiones estructurales:
- Separación del espacio de color YUV: se divide la imagen de entrada en canal Y (luminancia) y canales UV (crominancia), y solo el Y pasa por el cuerpo principal del modelo. Eso redujo a un tercio la información que el modelo debe procesar y eliminó la necesidad de un decodificador de reconstrucción de color.
- Submuestreo agresivo a una razón cercana a 2/5: sin los canales UV en el cuerpo principal, se pudo submuestrear con más fuerza. La luminancia es relativamente robusta a la pérdida de información espacial de alta frecuencia, mientras que los canales de color sufren un marcado sangrado cromático al reducirse. La entrada de 1920x1080 pasa por el cuerpo del modelo a cerca de 2/5 de su tamaño original.
- Reescalado bilineal y fusión UV corregida: el canal Y restaurado se vuelve a escalar a la resolución original por interpolación bilineal y se fusiona con los canales UV originales, que pasaron por una capa liviana de corrección de color para compensar los corrimientos inducidos por el cambio de luminancia.
.png)
El papel más crítico dentro de esa cadena lo cumple el bloque de restauración de luminancia. El modelo desplegado ahí es DeltaViT, un Vision Transformer liviano desarrollado internamente que opera con aproximadamente 98.000 parámetros. Frente a RetinexFormer, un modelo de tope de tabla en la misma tarea con cerca de 1,6 millones, DeltaViT usa unas 16 veces menos parámetros.
El propio equipo advierte un límite: el diseño está optimizado para entornos de videovigilancia con poca luz, donde la corrección de luminancia es la necesidad principal. Dominios con temperatura de color cambiante, como iluminación de escenario o luces industriales de espectro específico, requieren validación adicional.
Los números finales sobre hardware real
Tras exportar el modelo de Torch a ONNX y convertirlo a TensorRT, la latencia medida en el entorno de desarrollo (AGX Orin) quedó bajo los 10 milisegundos. Al pasar al destino real de despliegue, la Jetson Orin NX, el tiempo de cómputo en GPU quedó bajo 28 milisegundos: el objetivo de 33 se superó con más de 5 milisegundos de margen. En el mismo dispositivo donde el modelo anterior del cliente corría en unos 400 milisegundos, DeltaViT corre ahora en menos de 28.
| Modelo | Parámetros | Situación |
|---|---|---|
| Modelo original del cliente | arquitectura pesada en dos módulos | 400 ms en Jetson Orin NX |
| RetinexFormer | 1,6 millones | tope de tabla, no alcanza tiempo real |
| LYT-Net | 45.000 | falla por memoria insuficiente en 1080p |
| Zero-DCE++ | 10.600 | no alcanza el objetivo |
| RUAS | 3.400 | no alcanza el objetivo |
| DeltaViT | 98.000 | menos de 28 ms en Jetson Orin NX |
Las pruebas comparativas se corrieron sobre una RTX 3090 de 24 GB en cinco conjuntos de datos estándar de poca luz, midiendo LOE, NIQE y tiempo de inferencia en 1080p. LYT-Net, pese a ser el más liviano en parámetros, quedó fuera de competencia: falla la inferencia en 1080p por falta de memoria, lo que lo hace inviable en el mundo real.
Para quien arma vigilancia con hardware accesible en la región, el dato práctico es que la Jetson Orin NX es la placa de gama media del catálogo de NVIDIA para el borde, no el equipo tope. Que el procesamiento en tiempo real se resuelva ahí, y no en una AGX Orin varias veces más cara, es lo que define si un proyecto de varias cámaras cierra o no en presupuesto.