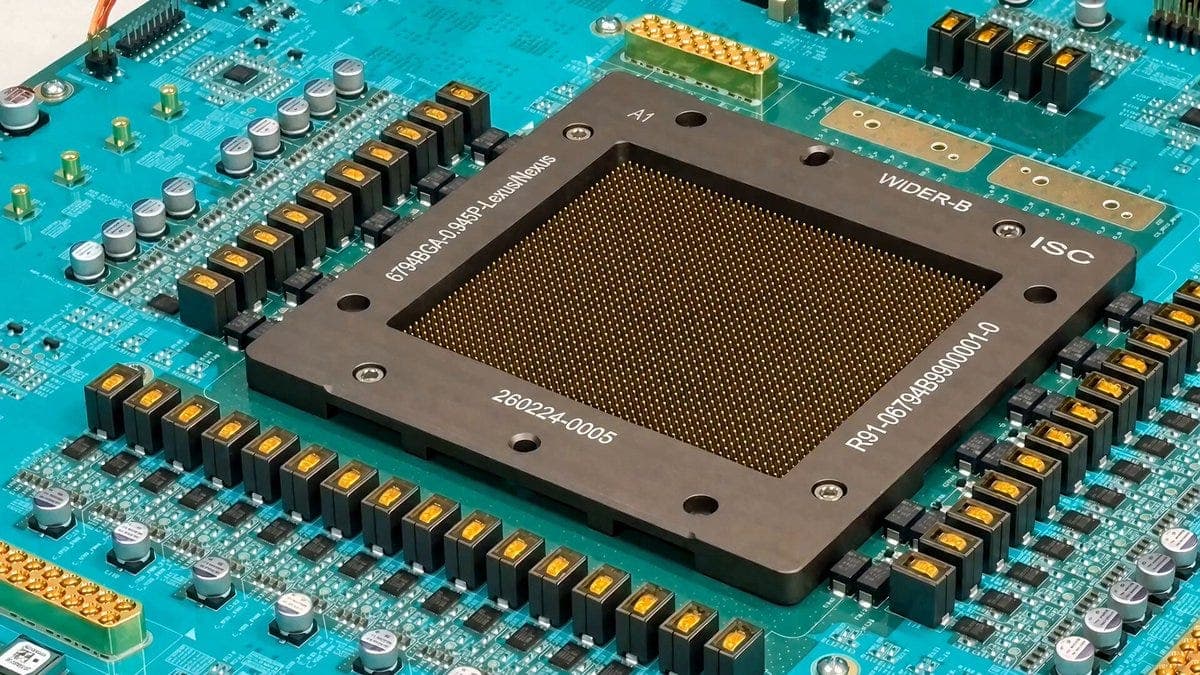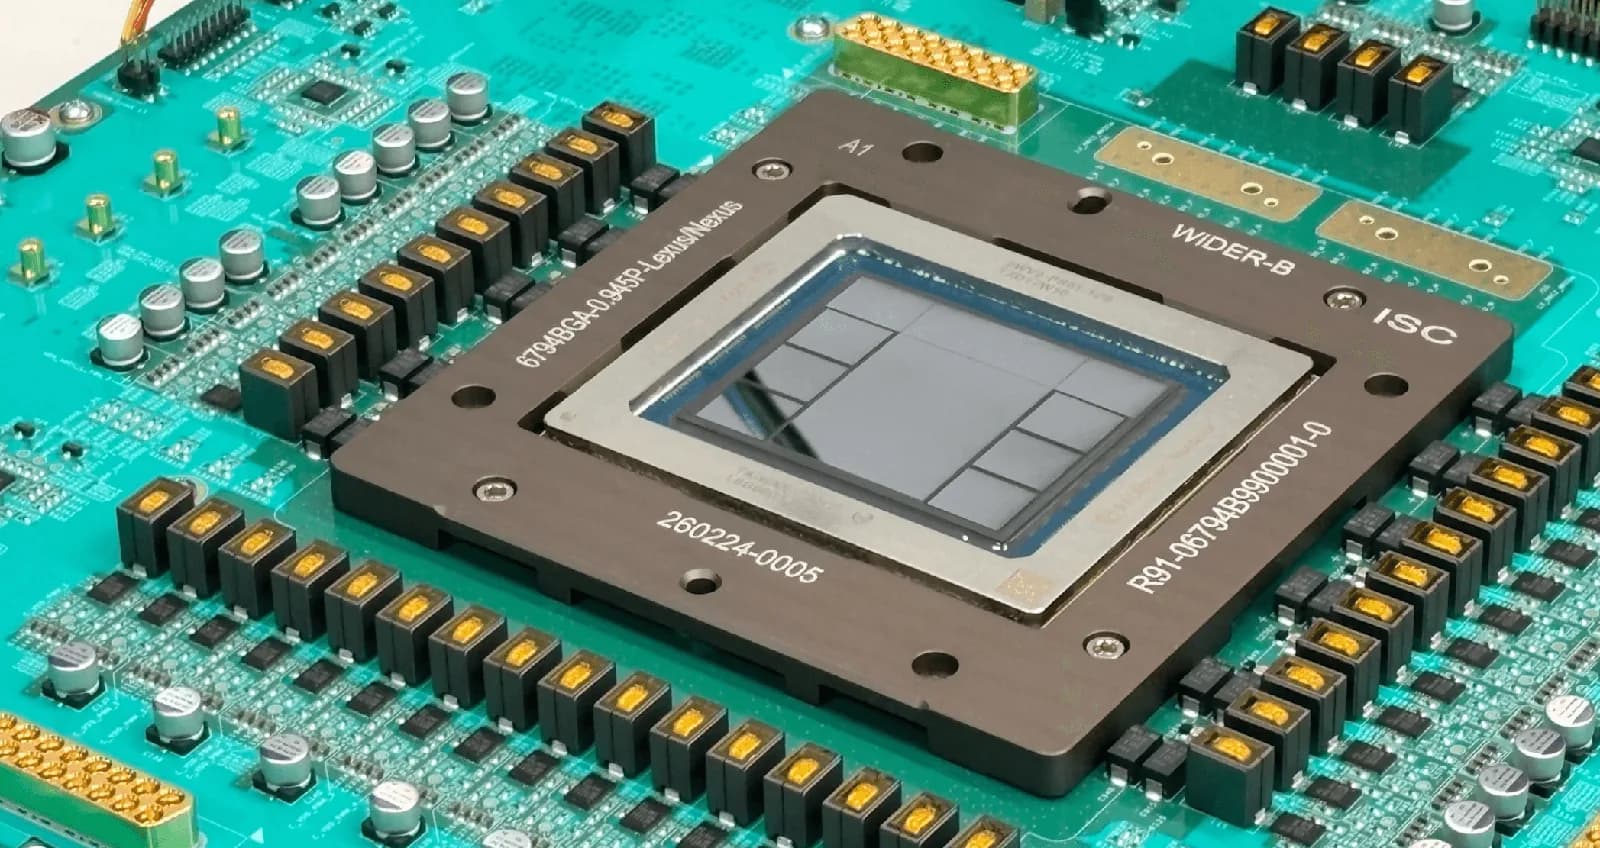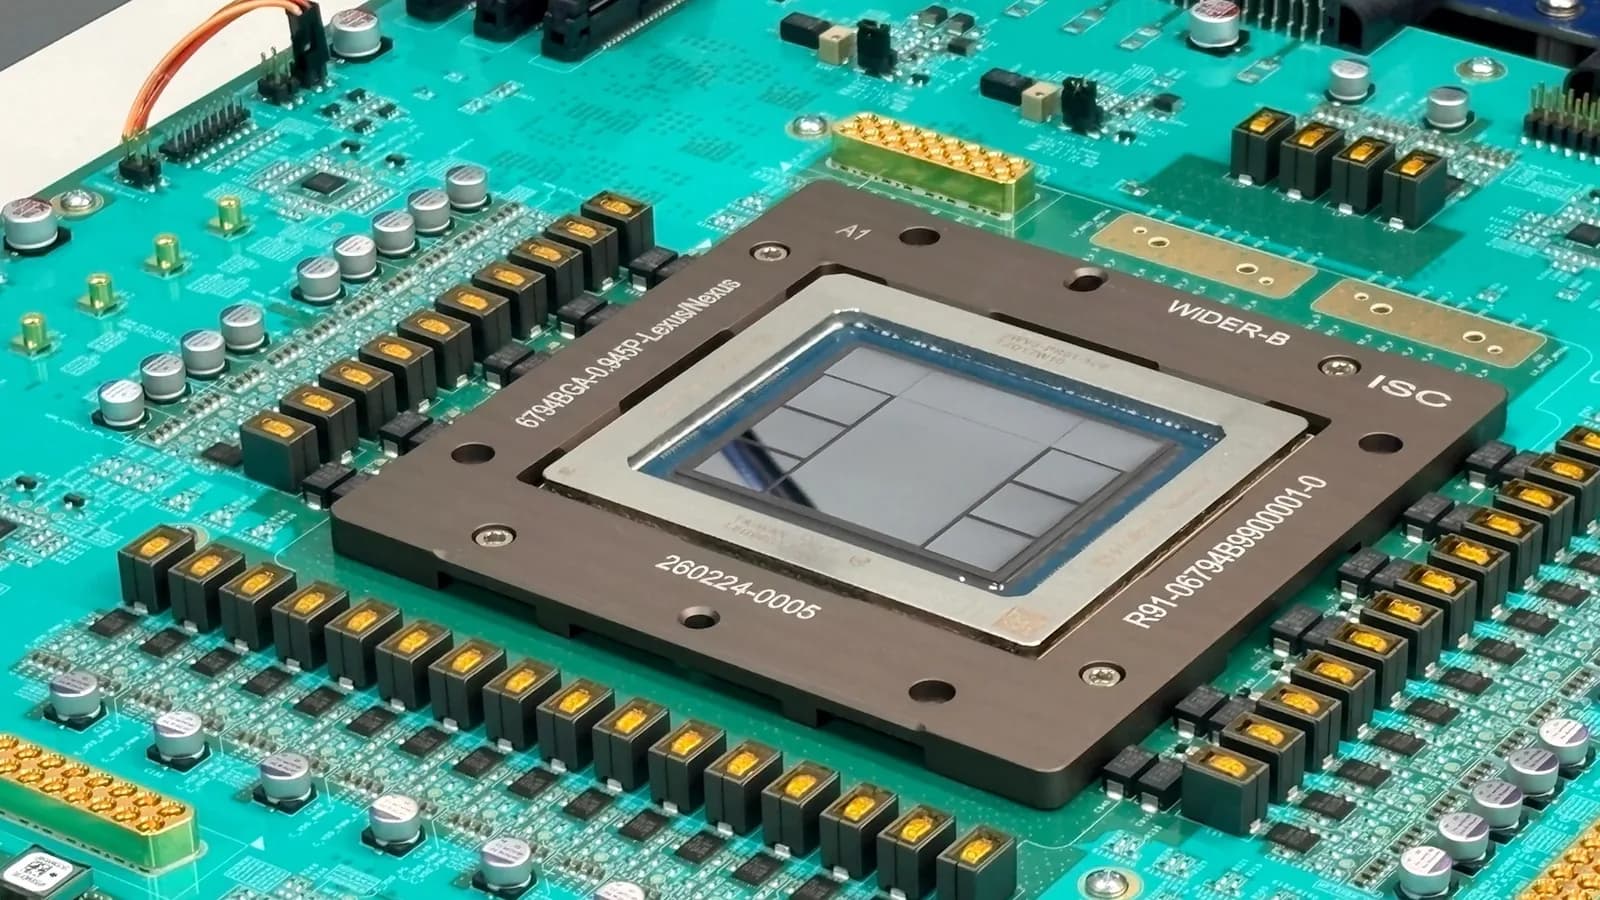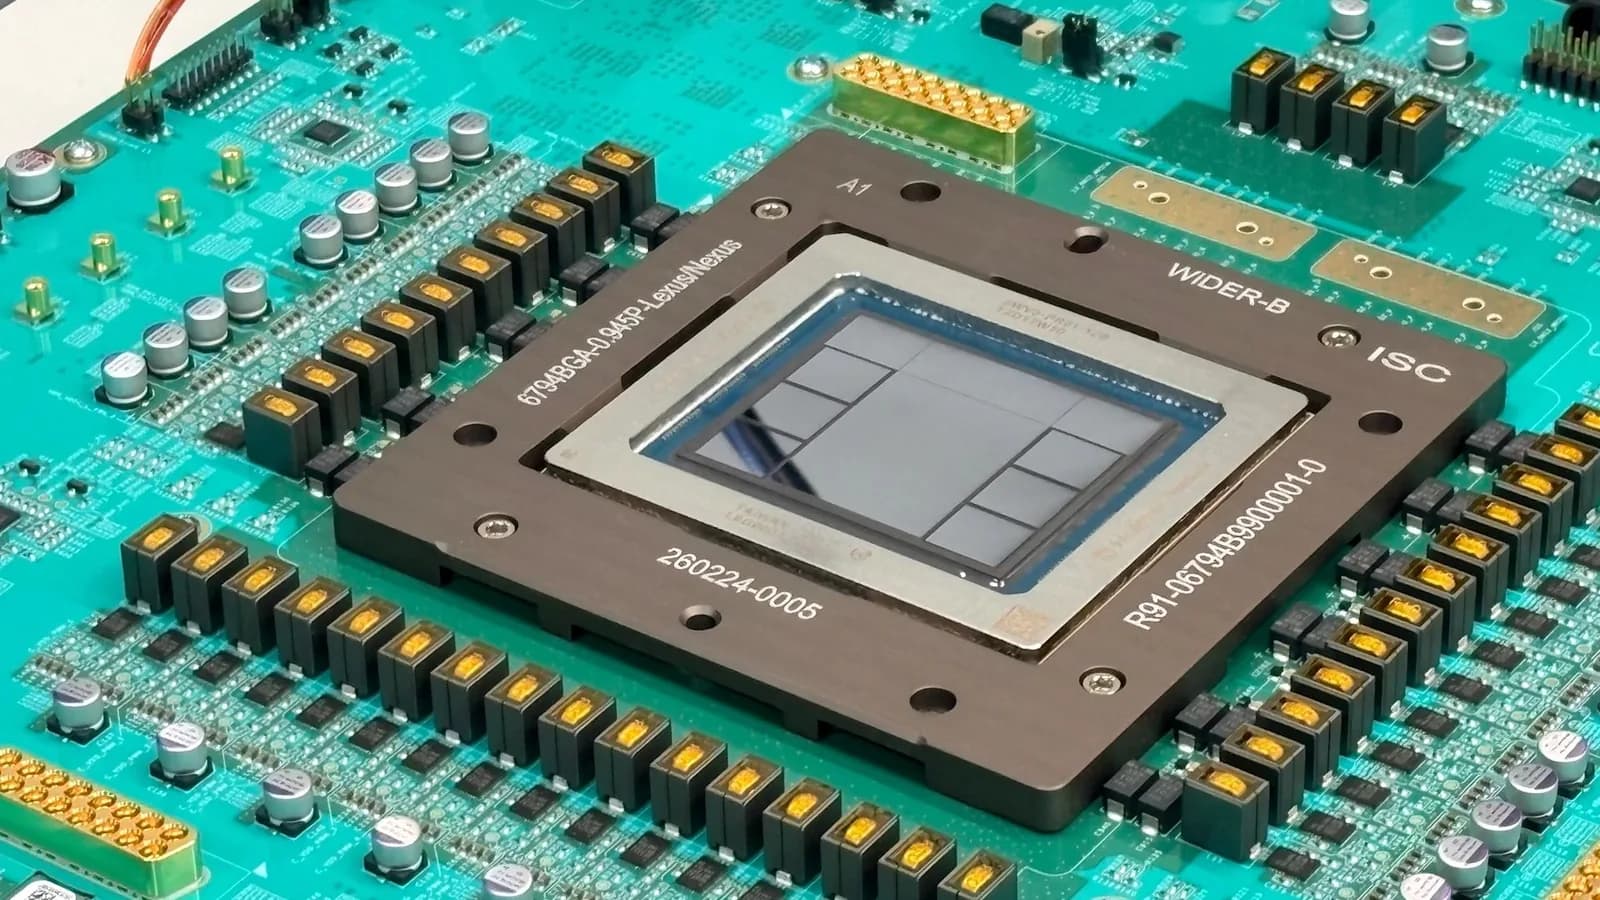
Jalapeño, el acelerador de inferencia a medida de OpenAI, está pensado para las necesidades de cómputo de la propia empresa. Así lo dijo Richard Ho, jefe de hardware de OpenAI, en una entrevista con Tom's Hardware Premium publicada el 28 de septiembre. Ho igual dejó abierta la puerta a una distribución más amplia. "Se podría usar para cualquiera, honestamente", afirmó.
Desde que se presentó el ASIC Jalapeño quedaba una pregunta en el aire. ¿Para quién es? El acelerador tiene un propósito, pero OpenAI no había dejado claras sus ambiciones en hardware. Cuando OpenAI y Broadcom revelaron su alianza el año pasado, la empresa sugirió que fabricaba ASIC para uso propio. Después mostró benchmarks que comparaban Jalapeño con los aceleradores Blackwell de Nvidia y reafirmó una hoja de ruta de varias generaciones en Hot Chips 2026.
"Tenemos una demanda de cómputo tan fuerte dentro de la empresa que nos va a tomar bastante tiempo siquiera cubrir nuestra propia demanda, que crece todo el tiempo", dijo Ho. "Creo que vamos a tener las manos ocupadas solo dando cómputo a OpenAI durante un buen tiempo. Eso no quiere decir que no se pueda usar en otra parte. Creo que se podría, pero nuestra prioridad es asegurarnos de que las necesidades de cómputo de OpenAI se cubran primero que nada."
¿Contra qué se midió Jalapeño?
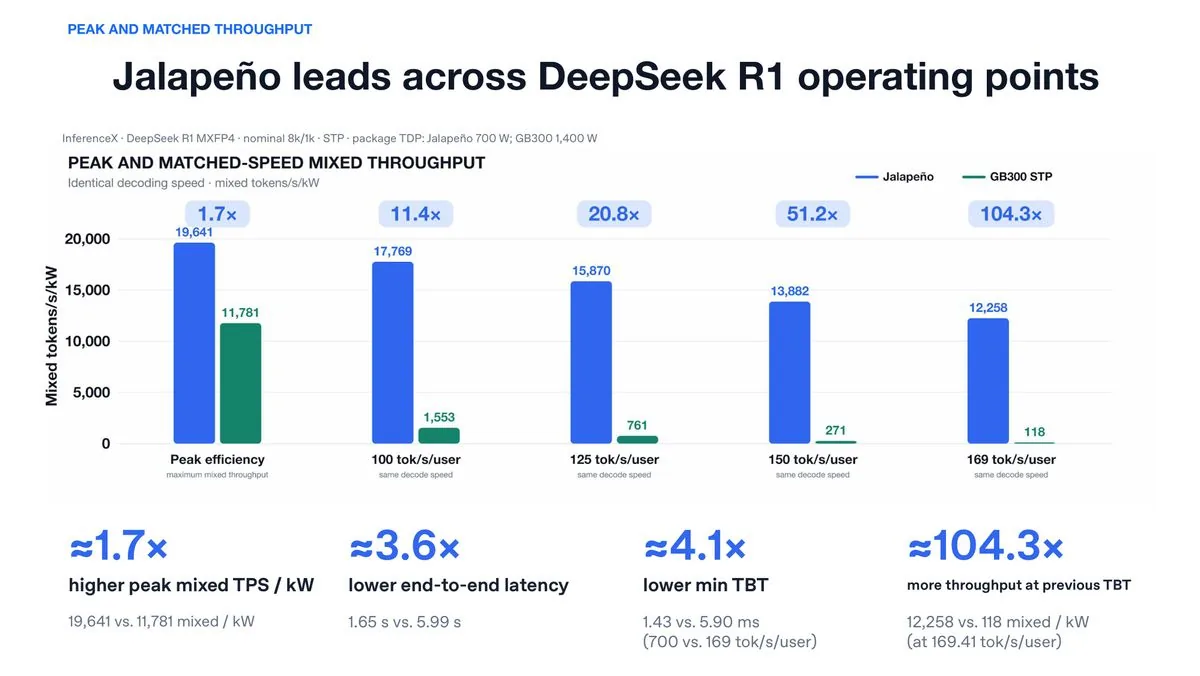
La posición competitiva de Jalapeño se apoya sobre todo en los benchmarks que OpenAI mostró en Hot Chips. Se corrieron en InferenceX, el benchmark de SemiAnalysis, y comparaban a Jalapeño con los GB200 y GB300 de Nvidia. Los ASIC son comunes, pero que tengan un rendimiento competitivo no lo es, y hay una buena razón. Se construyen para acelerar cargas de trabajo específicas. Con Jalapeño, en cambio, OpenAI mostró el chip acelerando su propio modelo de pesos abiertos GPT-OSS, además de DeepSeek R1 y Kimi K2.5.
En un principio OpenAI no planeaba mostrar benchmarks en Hot Chips, y ni siquiera estaba segura de presentarse en el evento, contó Ho. El ejecutivo repitió la historia que OpenAI contó en el escenario de Hot Chips. Un equipo de ingenieros hizo correr Kimi y DeepSeek en Jalapeño en los dos meses que pasaron entre la primera muestra A0 y la presentación.
Aunque Ho fue claro en que Jalapeño se despliega internamente y seguirá así por ahora, dejó abierta la puerta a una entrada más amplia en el mercado de hardware. Sobre los benchmarks de Hot Chips, Ho dijo lo siguiente.
"Lo que de verdad queríamos demostrar, para dejar atrás, era la percepción equivocada en la industria de que nuestro chip de inferencia a medida era solo para modelos de OpenAI... Es programable, es de propósito general y no está programado de forma fija para modelos de OpenAI."
El suministro, un freno posible
Una explicación posible para la reticencia a entrar al mercado externo de hardware es el suministro. Ho dijo que "hay una nueva base de suministro", en referencia a los dos últimos años en que él y Sam Altman, CEO de OpenAI, recorrieron fábricas pidiendo más capacidad. Ho asegura que OpenAI está "en buena forma" en suministro interno, pero abastecer a clientes externos probablemente sería otra historia.
Jalapeño funciona con otros modelos, pero el rendimiento competitivo bruto no fue el objetivo principal del diseño. Consultado por el motor detrás del diseño de Jalapeño, Ho fue directo. "Fue la eficiencia." El ejecutivo describió la eficiencia como pariente del cómputo. Los centros de datos de IA modernos están limitados por la energía, y un motor de inferencia más eficiente equivale a más cómputo efectivo.
Ho también atribuyó a esa misma toma de decisiones pragmática el diseño conjunto con los modelos internos de OpenAI. "[El codiseño] es algo que no se puede hacer muy bien con un vendedor externo de silicio, porque hay mucha propiedad intelectual de investigación en los modelos, y no se puede compartir ampliamente porque se va a filtrar. Va a salir, no importa cuántos acuerdos de confidencialidad firmes."
¿Y frente a Vera Rubin?
Si Jalapeño llegara a una distribución amplia, no competiría con la plataforma Grace Blackwell de Nvidia sino con la más nueva, Vera Rubin. Ho explicó que la comparación contra Blackwell se hizo "porque esos eran los mejores resultados publicados que pudimos encontrar". La empresa ha corrido más benchmarks internos, tanto contra Vera Rubin como con ventanas de contexto más grandes.
Los benchmarks de InferenceX solo midieron el escenario 8k1k, con 8.000 tokens de entrada y 1.000 de salida fijos. Ho dijo que los benchmarks internos de OpenAI muestran que el ASIC "parece rendir incluso mejor que los benchmarks existentes de algunos de los otros dispositivos disponibles". Más interesante es la comparación con Vera Rubin, que según OpenAI sale bien.
"Obviamente, para cuando lo despleguemos, va a ser [Vera Rubin], quizás incluso VR Ultra en algunas partes del calendario de despliegue. Hicimos los nuestros internamente, pero obviamente no los publicamos. Esos tienen que venir de Nvidia y de otros que puedan hacerlo... sí, nos está yendo muy bien en esos", dijo Ho.