
Electrónica
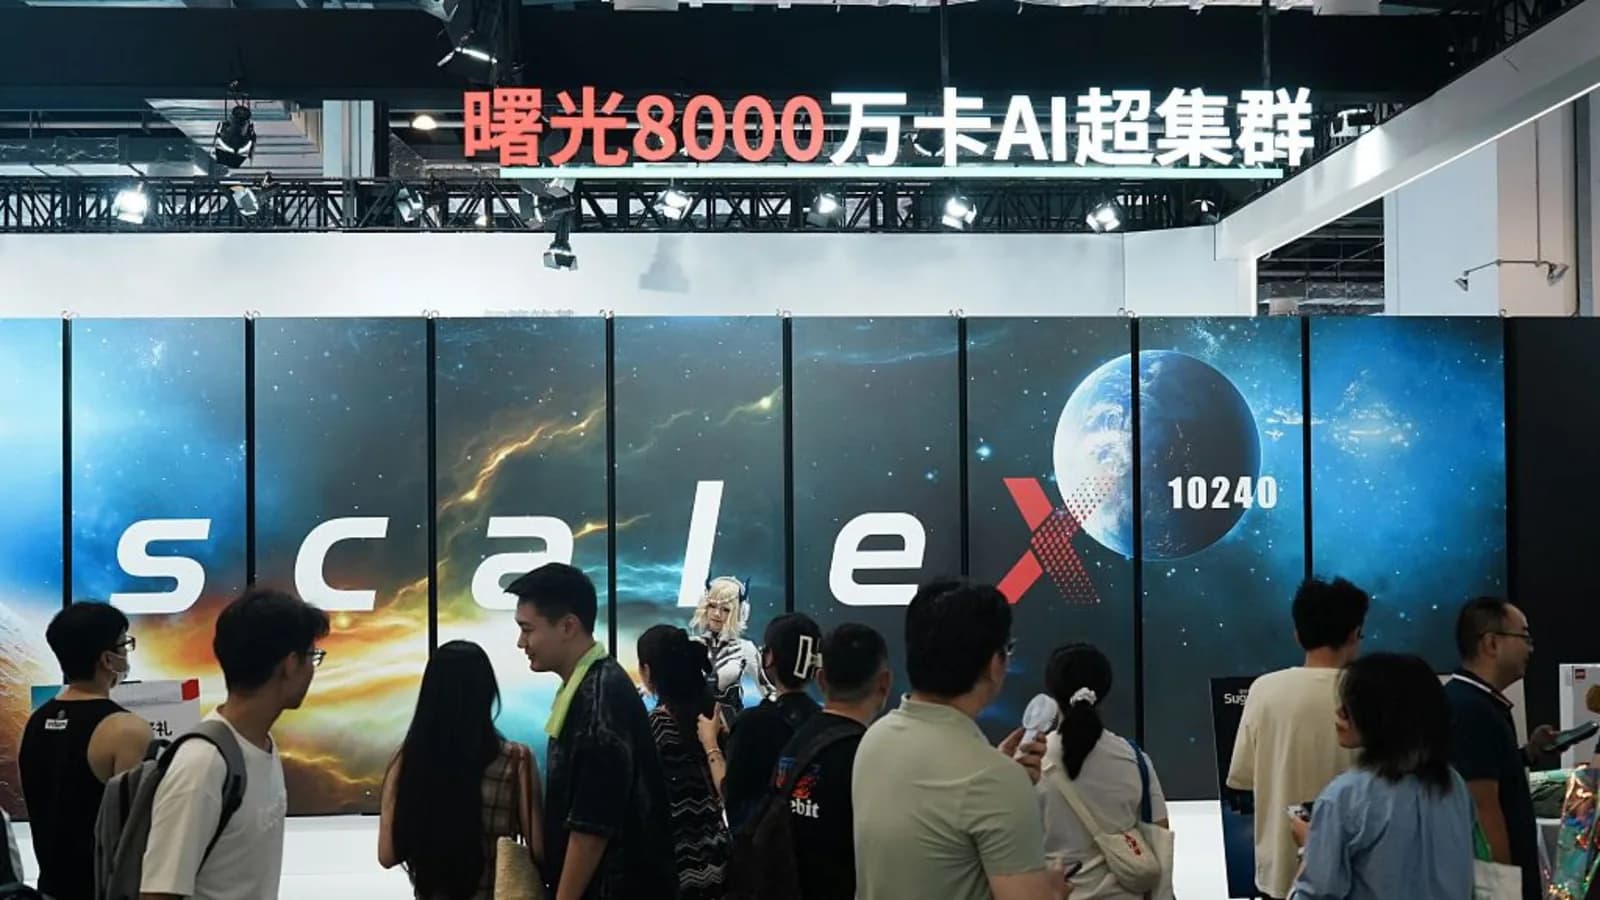
Sugon 8000, el supercluster chino de IA con 100.000 tarjetas locales
Sugon presentó el sistema en la conferencia anual china de computación de alto rendimiento, ya usado en más de 10 proyectos de investigación.
Interesting Engineering
15 notas publicadas
La herramienta de AWS promete llevar una app de PyTorch a Trainium cambiando una sola línea de configuración, sin reescribir código.
El chip propio de Azure llega en 2027 en racks de hasta 96 aceleradores, con ocho pilas de HBM4 y 18 TB/s de ancho de banda por chip.
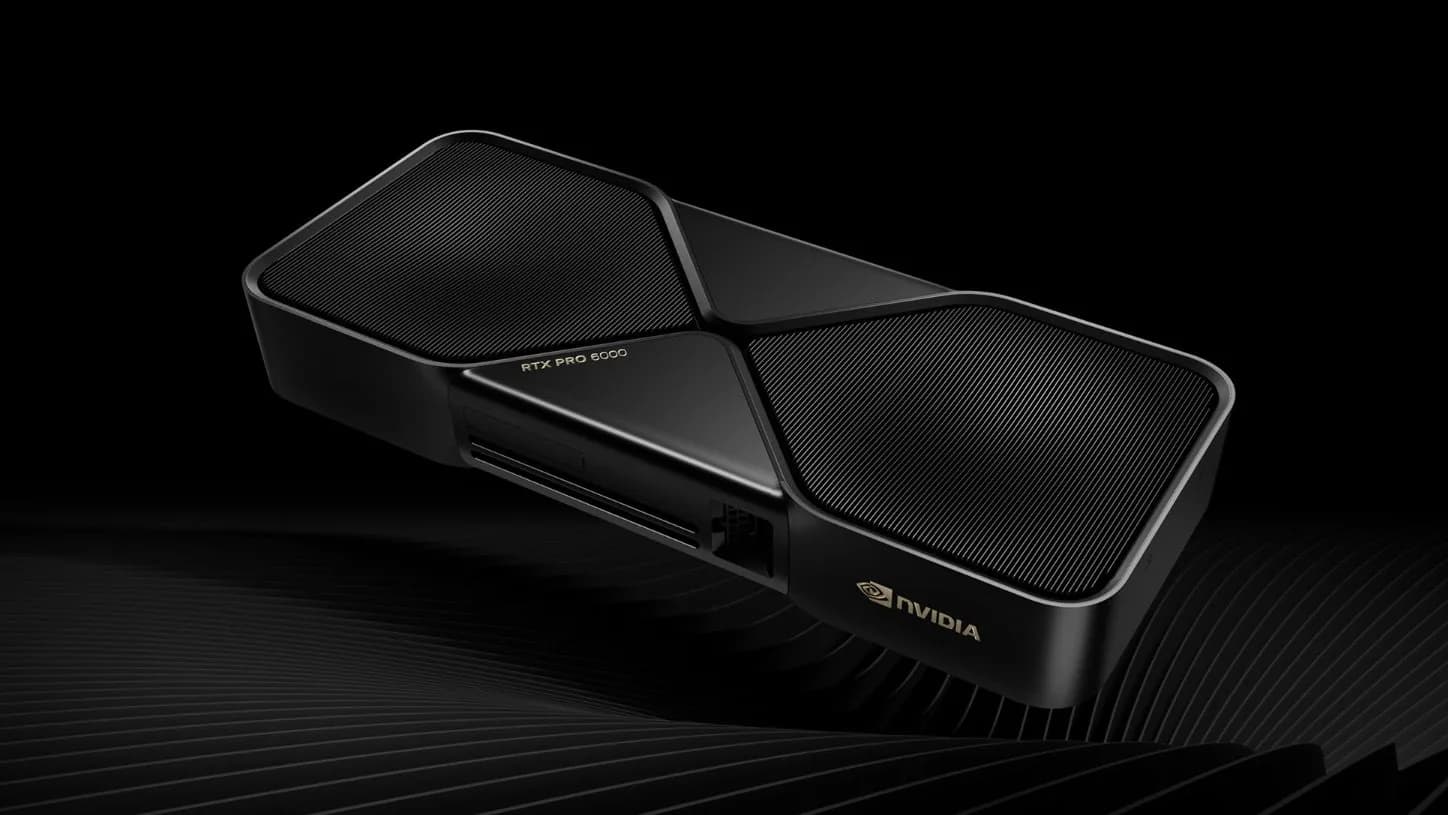
Según el Financial Times, usan RTX 5090 y RTX Pro permitidas por los controles de exportación para cubrir un déficit de 1,5 millones de chips.
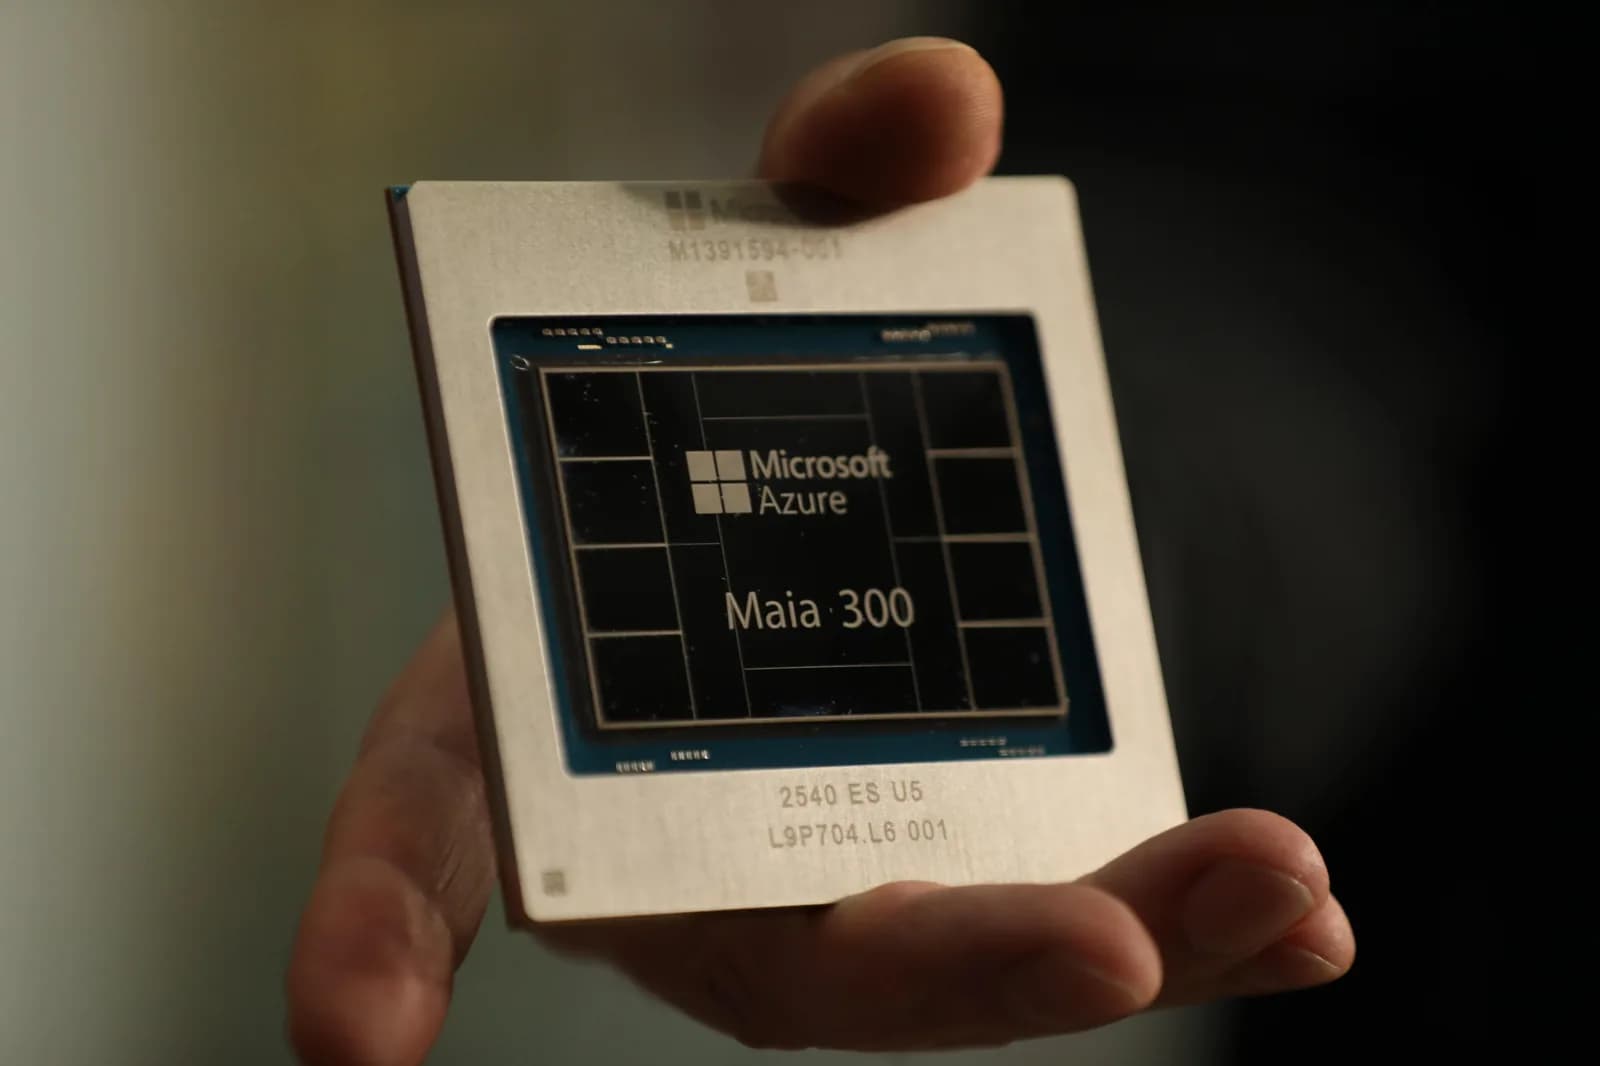
La tercera generación del acelerador propio de Microsoft se fabrica en el nodo N2P de TSMC y entrará a producción en 2027.
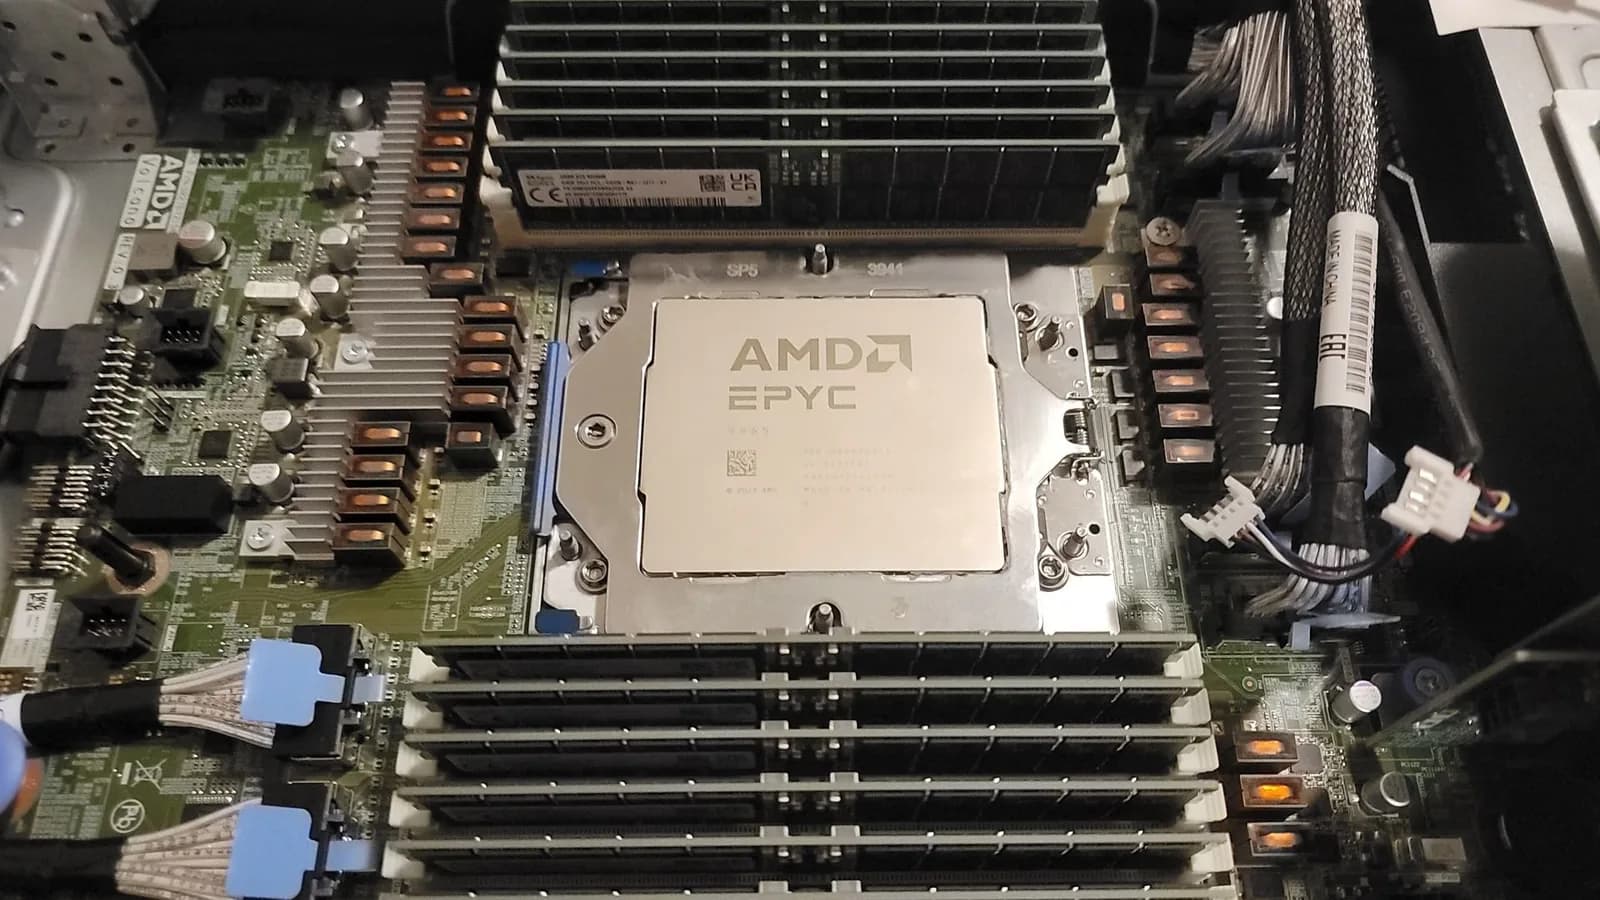
Richard Ho, jefe de hardware de OpenAI, dijo a Tom's Hardware que eligió Turin por madurez y que Vera, como CPU independiente, todavía está un poco atrás.
El lenguaje, creado en la Universidad de Pekín, promete un modelo de programación más simple que CUDA y ya es la herramienta principal de DeepSeek.
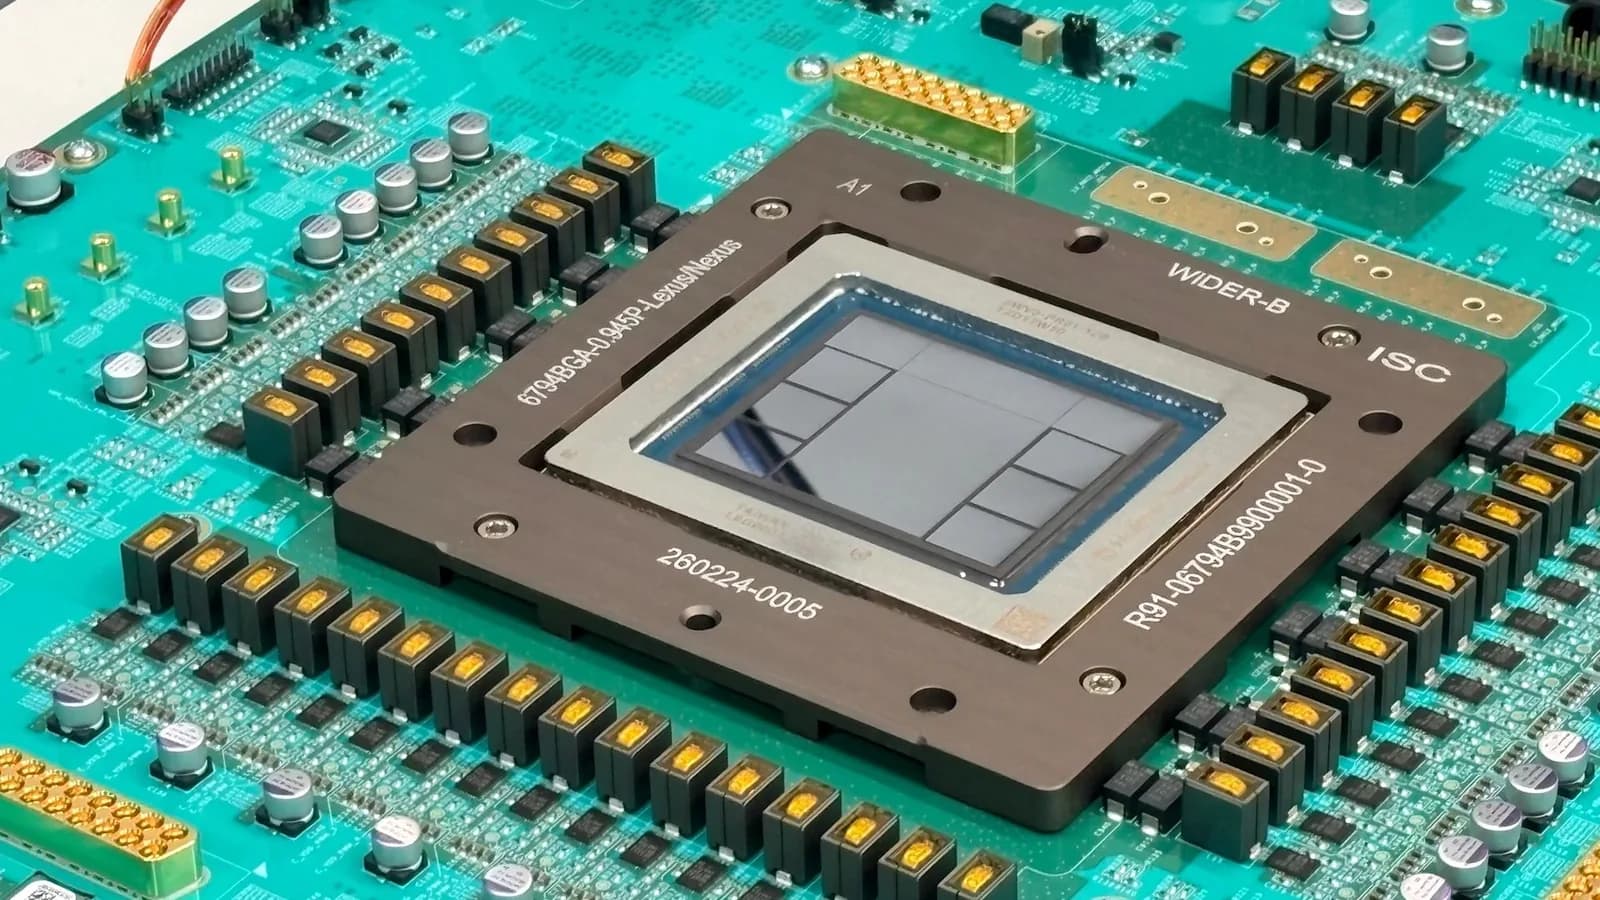
Richard Ho, jefe de hardware de OpenAI, dijo a Tom's Hardware que el chip es de propósito general y que la demanda interna de cómputo lo ocupará por mucho tiempo.
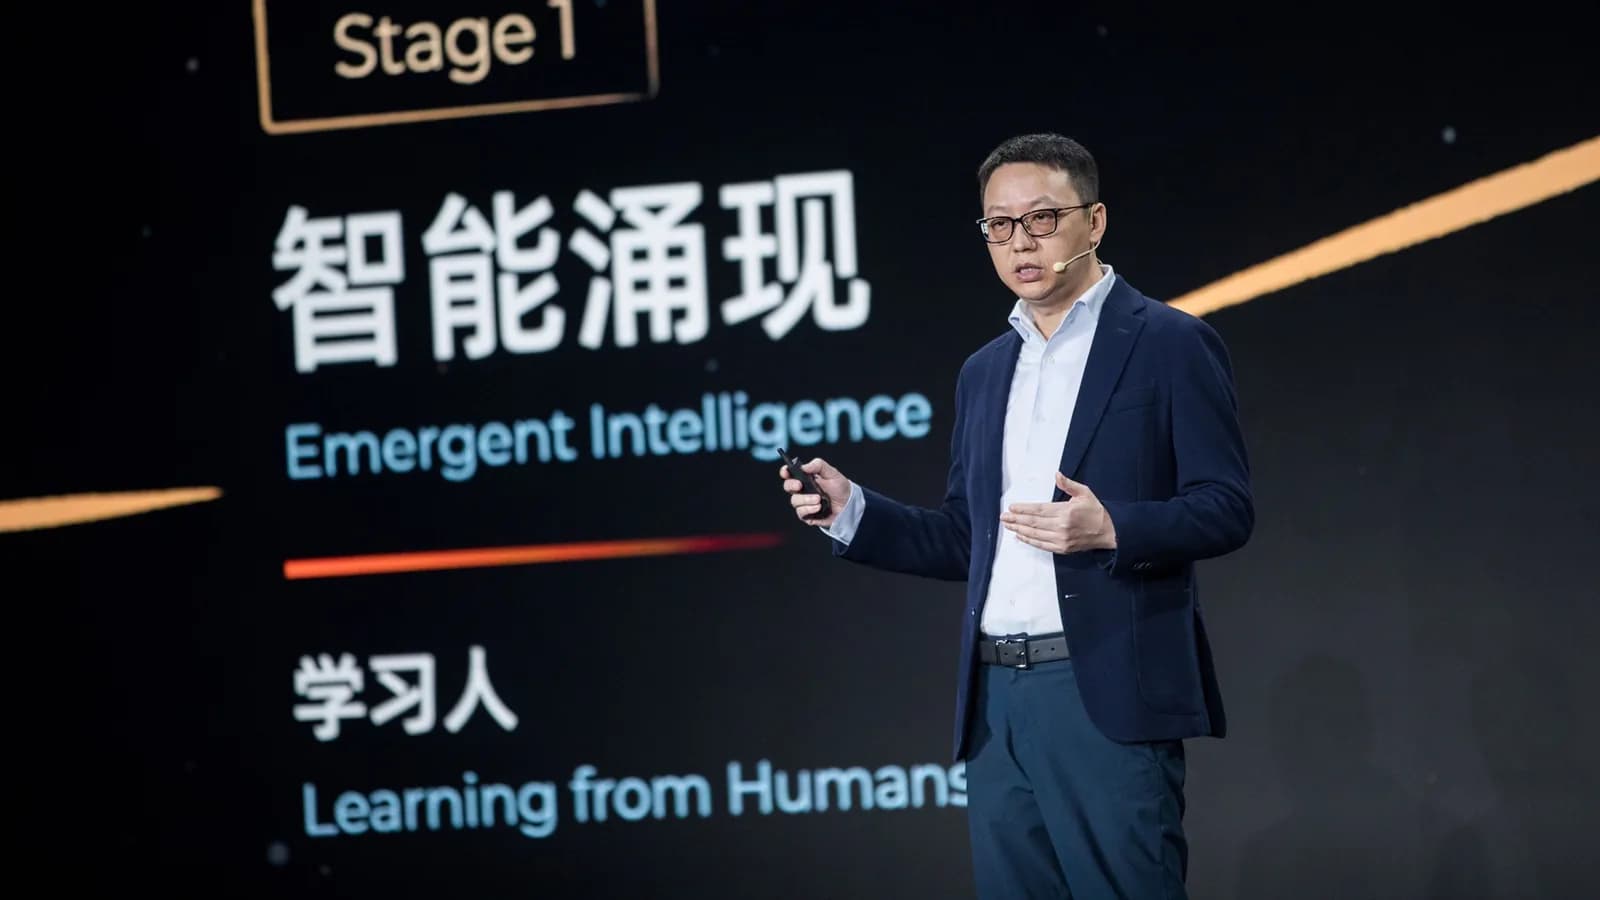
La compañía lo presentó en Hangzhou como el chip de IA más potente de China y anunció que Qwen 5 llegará con hasta 10 billones de parámetros.
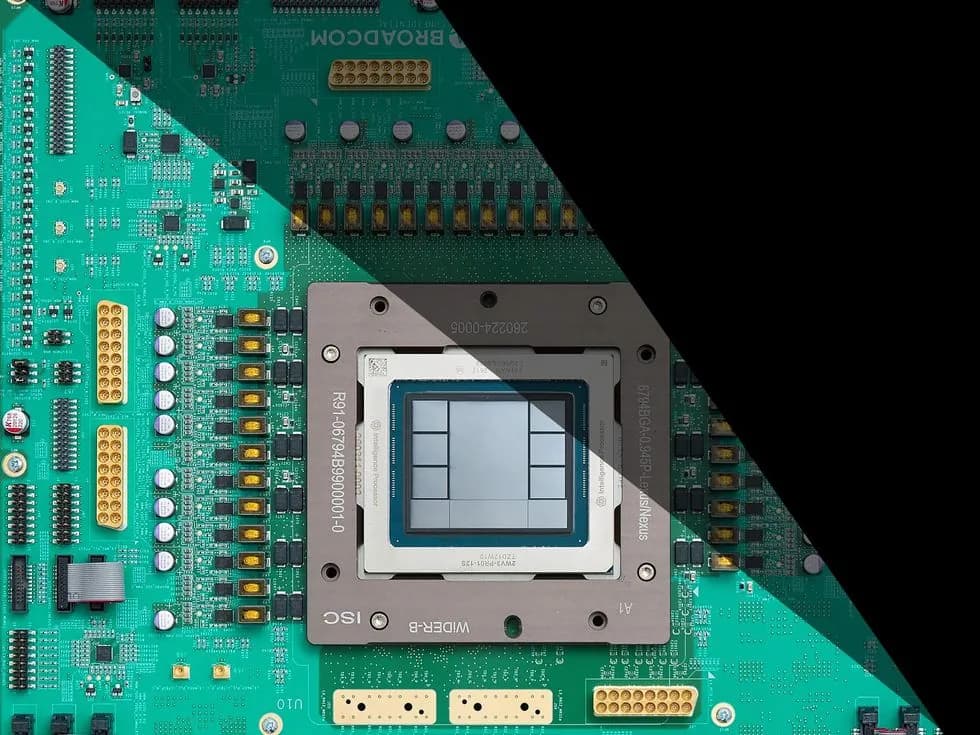
La empresa usó sus propios modelos de lenguaje para acelerar el diseño, con un equipo que promedió menos de 100 personas y con Broadcom a cargo del diseño físico desde las compuertas en adelante.
Huawei, Cambricon, Moore Threads y Biren empujan procesadores propios, pero el obstáculo que ninguno ha resuelto es el entorno de software que rodea a las GPU de Nvidia.
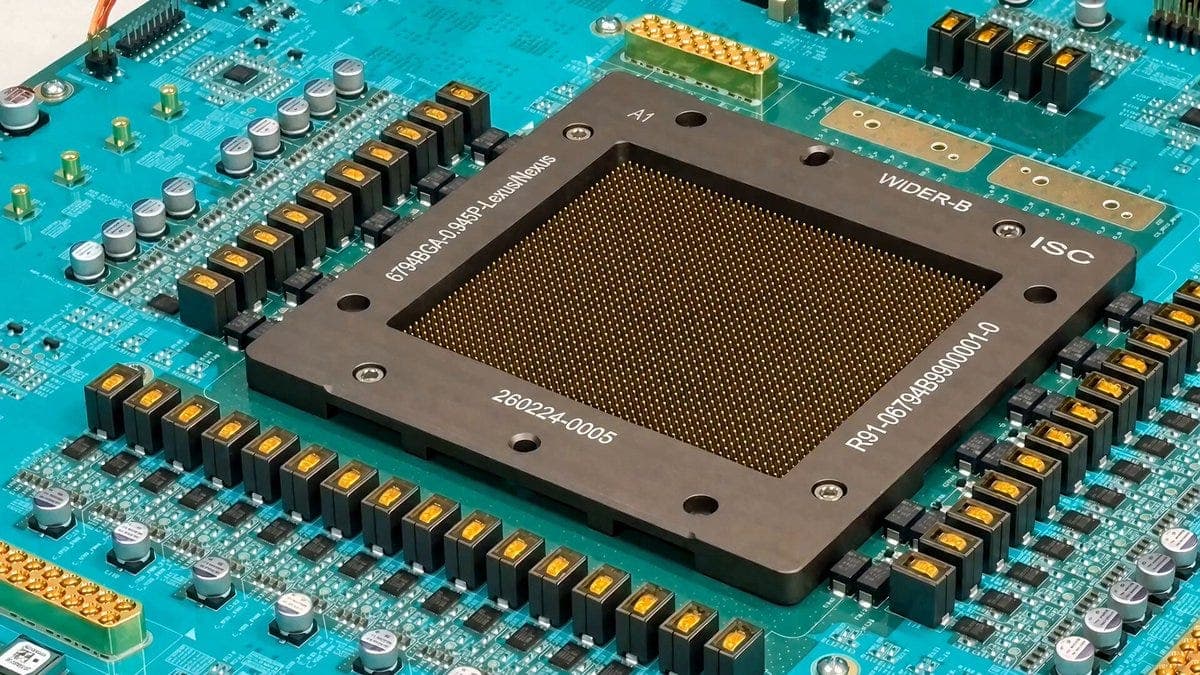
OpenAI publicó en Hot Chips 37 los primeros números de su chip de inferencia propio: entre 1,5 y 1,9 veces más trabajo por watt que los sistemas GB200 y GB300 de NVIDIA.
Microsoft ampliará el uso de chips de IA de AMD en Azure con la plataforma Helios, y un perfil público sugiere que Anthropic también está probando hardware de la firma.
El chip, atribuido a Jeff Dean, grabaría el plano de Gemini en el hardware para ser 6 a 10 veces más eficiente que los TPU actuales. Google lo desplegaría desde 2028 para abaratar la inferencia.
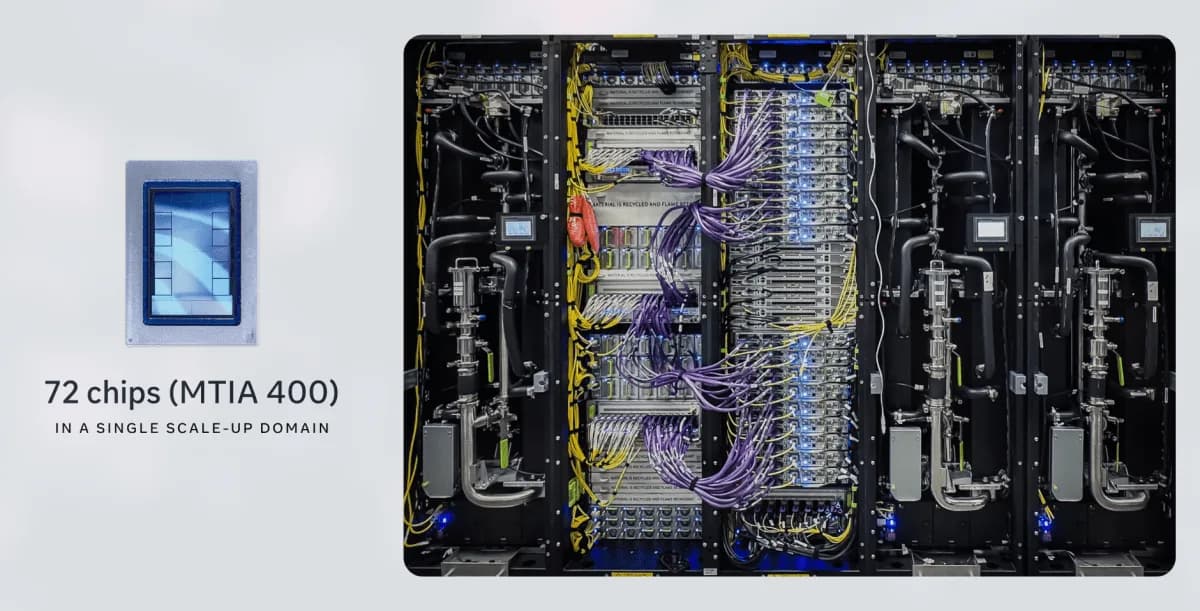
La compañía fabricará su acelerador propio con Broadcom y TSMC para reducir su dependencia de las GPU de Nvidia y AMD, en plena escasez de componentes.
Otros temas que aparecen junto a #chips ia en nuestra cobertura editorial.