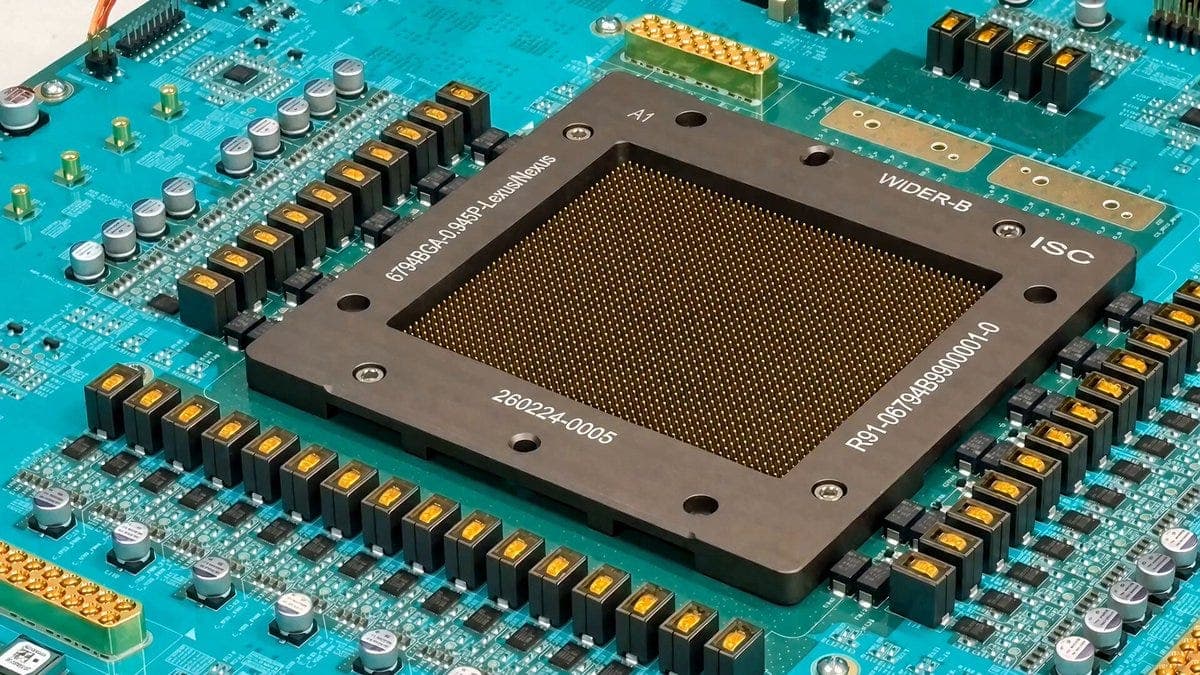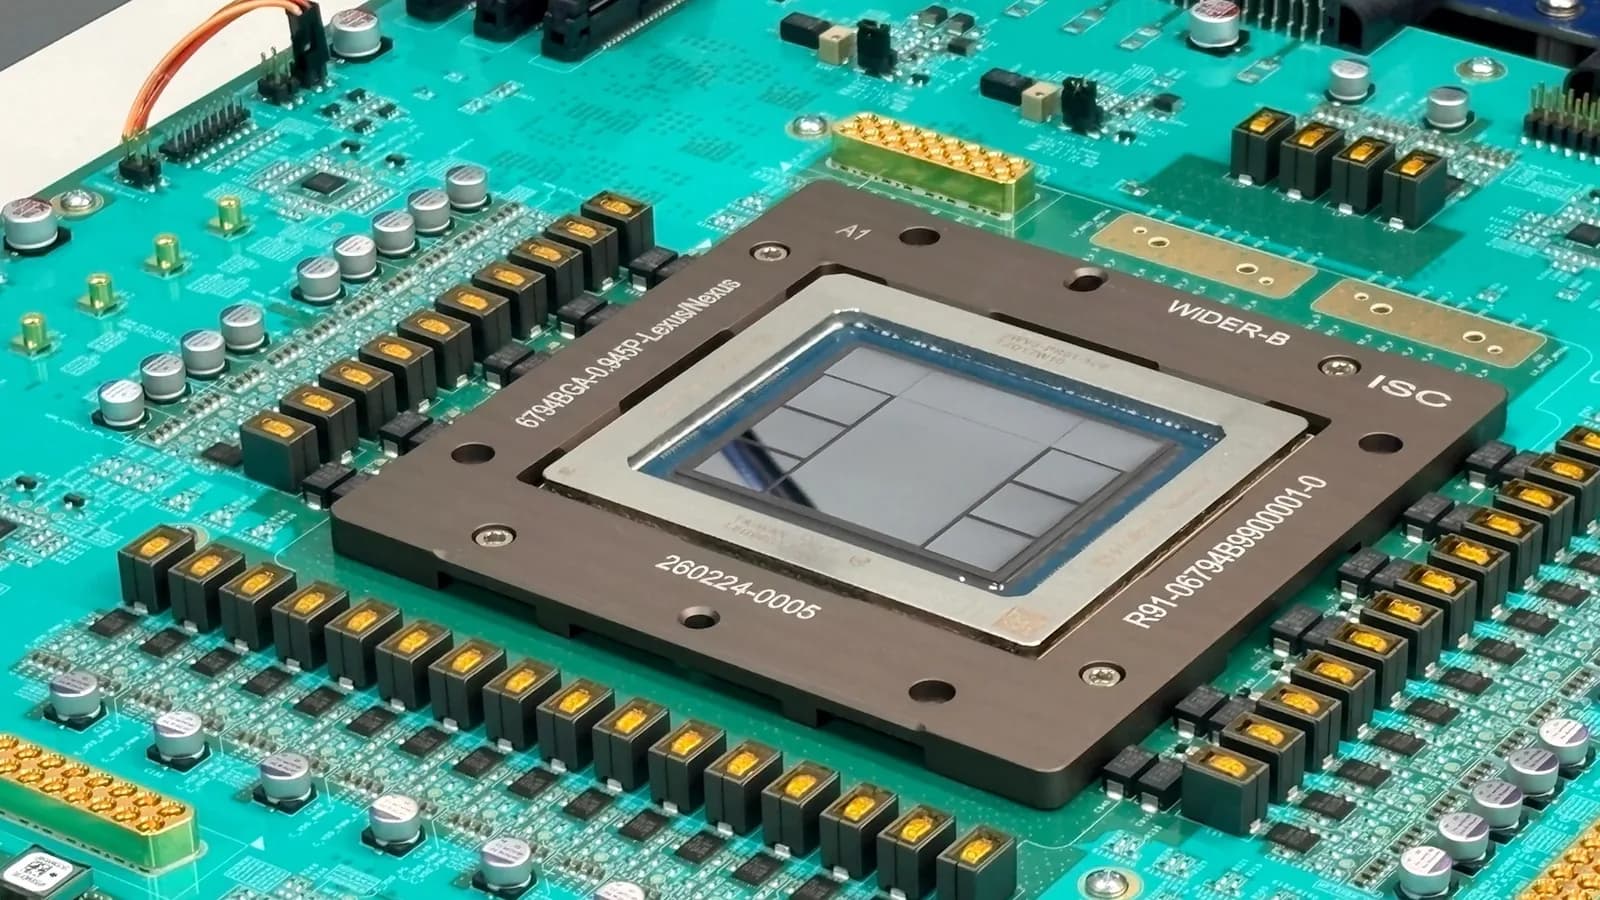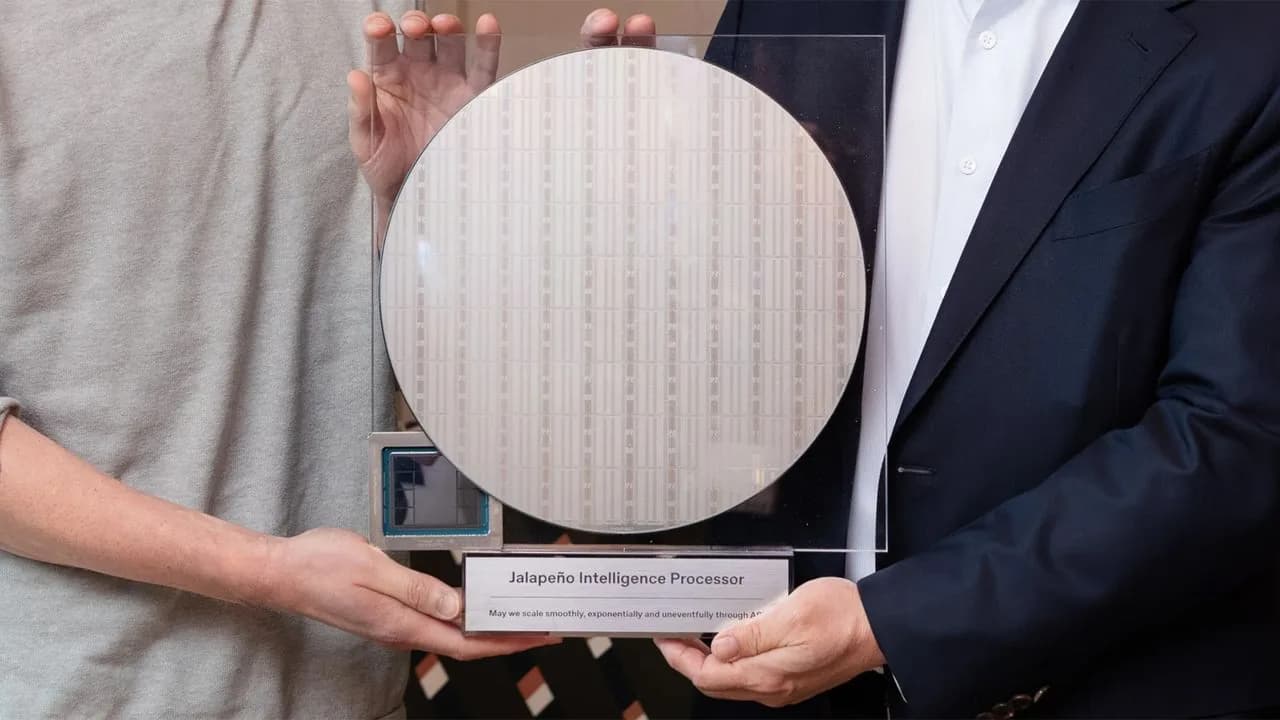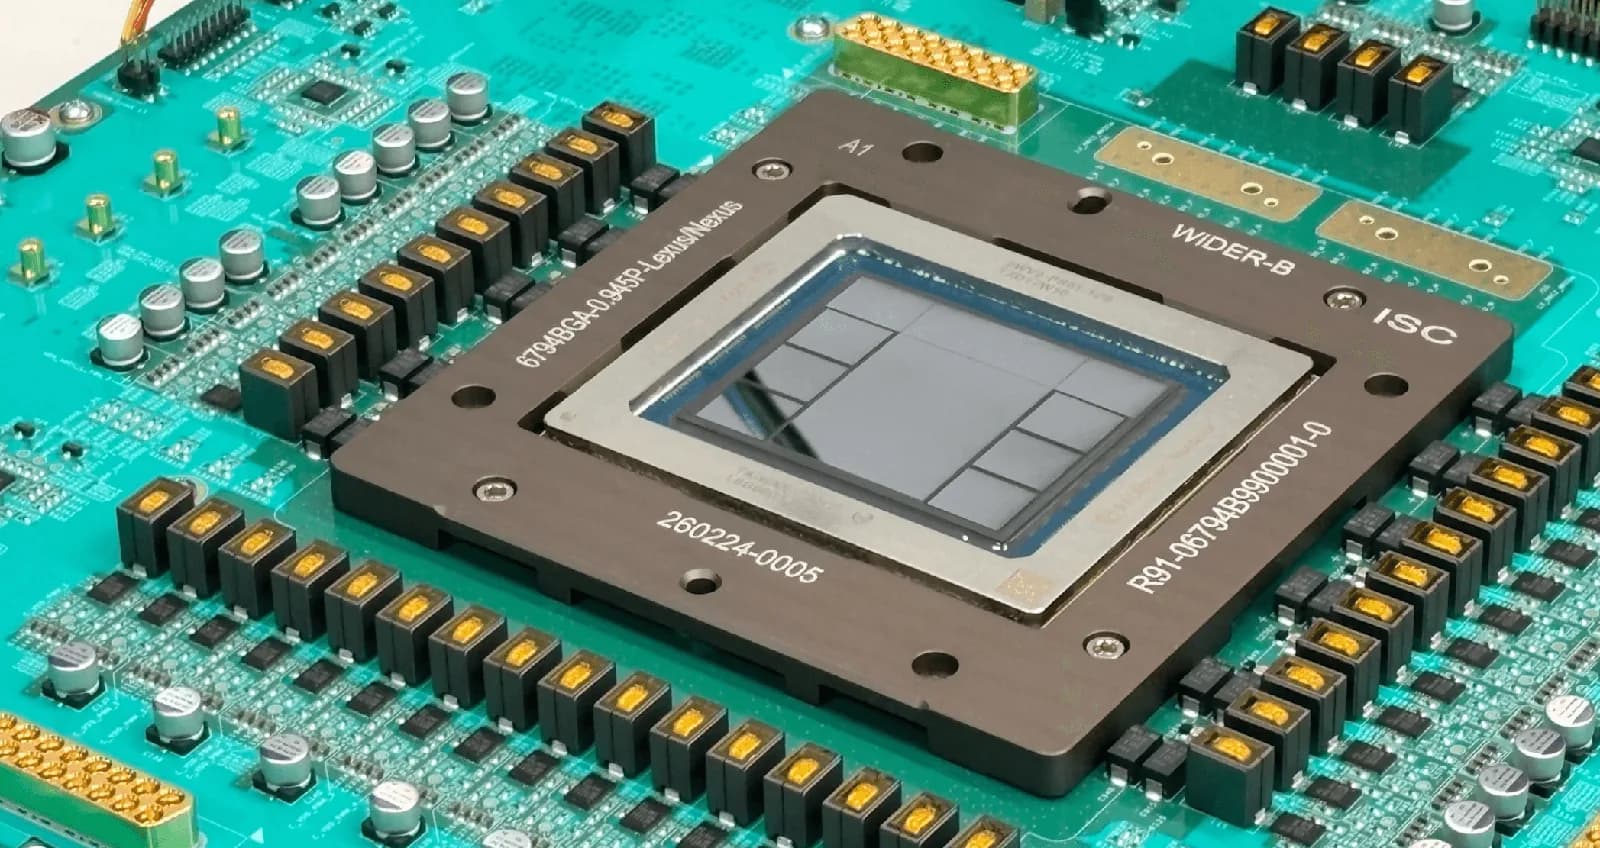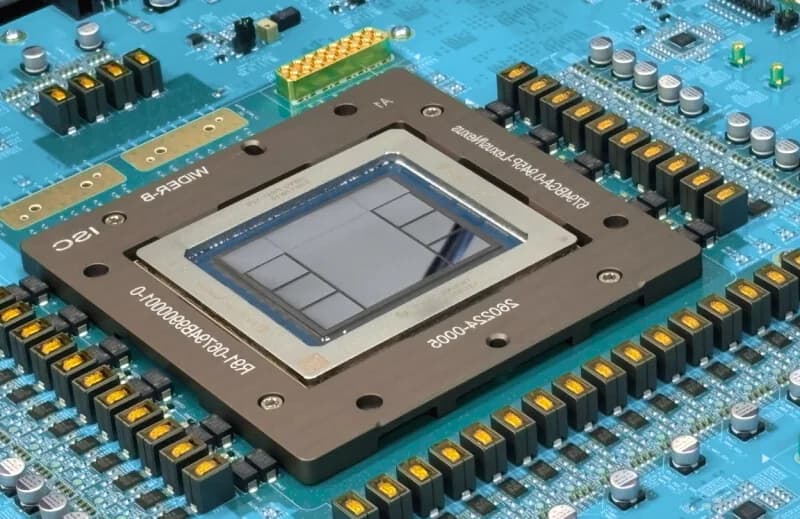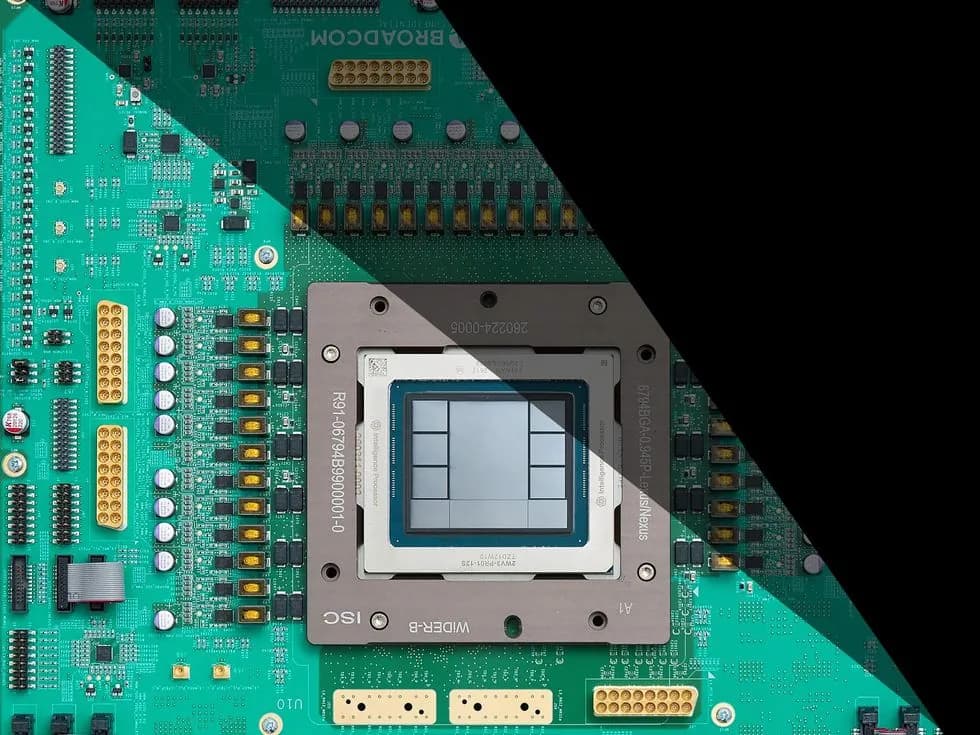
OpenAI diseñó su chip Jalapeño en menos de 20 meses
La empresa usó sus propios modelos de lenguaje para acelerar el diseño, con un equipo que promedió menos de 100 personas y con Broadcom a cargo del diseño físico desde las compuertas en adelante.
6 notas publicadas

OpenAI publicó en Hot Chips 37 los primeros números de su chip de inferencia propio: entre 1,5 y 1,9 veces más trabajo por watt que los sistemas GB200 y GB300 de NVIDIA.

La compañía midió su acelerador de inferencia contra sistemas comerciales en tres modelos de pesos abiertos y reporta hasta 4,1 veces más rendimiento en las cargas más interactivas.

OpenAI detalló en Hot Chips la arquitectura NUMA de su acelerador de inferencia: 216 GB de HBM4, dos redes internas separadas y más de la mitad del núcleo escrita con ayuda de sus propios modelos.

El primer acelerador propio de OpenAI, hecho con Broadcom, se llevó los mejores números de rendimiento por watt en el banco de pruebas InferenceX, aunque no pasa de muestras de ingeniería.

OpenAI mostró en Hot Chips su acelerador desarrollado con Broadcom, pensado solo para inferencia, con producción en volumen prevista para 2027.
Otros temas que aparecen junto a #jalapeno en nuestra cobertura editorial.