Revolut recortó cerca de 90% el costo de inferencia de sus herramientas de programación con IA en menos de un año. La fintech británica lo consiguió al dejar los modelos autohospedados como opción por defecto, en lugar de depender sobre todo de servicios comerciales como Claude.
David Abitbol, líder de operaciones e infraestructura de Revolut, lo contó el mes pasado en la conferencia AI Engineer de Nueva York. Según su relato, tras desplegar herramientas de programación con IA a unos 2.000 ingenieros, el tiempo de programación mejoró 60% y el tiempo de entrega (lead time) mejoró 70%. Revolut adoptó primero GLM-5.1, después pasó a GLM-5.3, y hoy lo sirve con 56 GPU Nvidia B200.
Antes de cambiarse a GLM, la empresa ya experimentaba con IA. Desplegó Gemini a comienzos de 2025 y Claude Code a comienzos de 2026.
"Éramos muy escépticos sobre el costo de la IA. Veíamos ingenieros que gastaban 1.000 dólares al mes, 10.000 dólares al mes, sin mucho retorno, así que cuando lo lanzamos lo lanzamos con límites de presupuesto estrictos", dijo Abitbol.
Tokens baratos, uso sin cuota
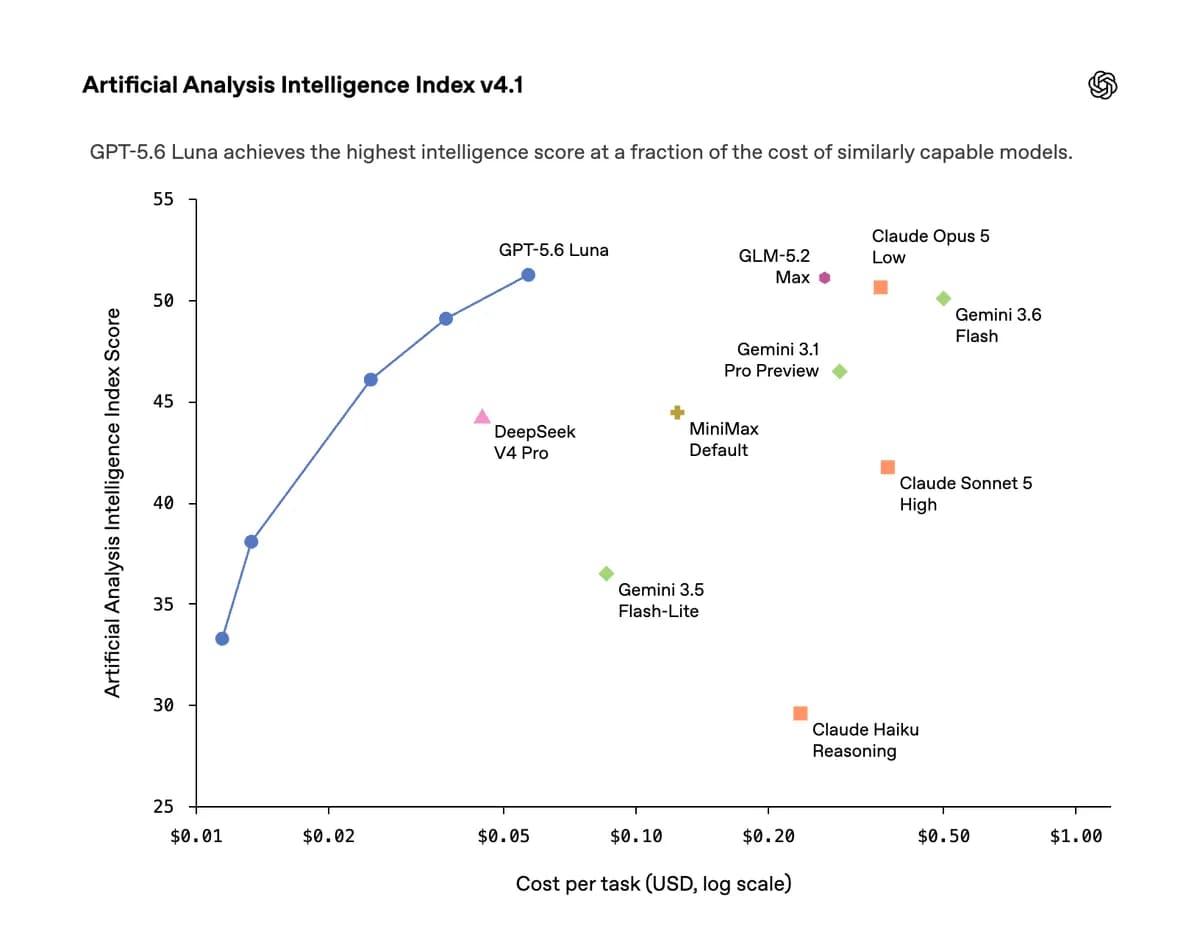
Por esos límites, los ingenieros solo tenían acceso a una cantidad acotada de tokens, y la empresa empezó a estudiar cómo hospedar sus propios modelos. A 0,30 dólares por millón de tokens de entrada y salida, autohospedar GLM 5.1 costaba cerca de una décima parte de lo que costaba usar Codex de OpenAI o Claude Code de Anthropic. Y resultó que con tokens baratos uno deja de preocuparse por cuántos usa la gente o para qué.
La velocidad de programación mejoró, pero Abitbol dijo que el mayor cuello de botella no era el código. Las ganancias más grandes vinieron de dejar que los modelos se encargaran de la depuración y de los tickets de Jira y Confluence.
"Cuando tienes tokens ilimitados, eres libre de hacer eso", dijo. "Ya no tienes que guardar tus tokens para el fin del trimestre o para la tarea más difícil".
¿Qué hardware necesita GLM?
GLM 5.1, desarrollado por el laboratorio chino de pesos abiertos Z.ai, no es un modelo pequeño. Tiene cerca de 754.000 millones de parámetros en total, con 40.000 millones activos por cada token generado. Solo para cargar los pesos pide unos 380 GB de memoria de GPU, y entre 6 y 26 GB más por usuario para mantener el contexto, según la precisión.
Para servir GLM-5.3 a escala, Revolut desplegó 56 GPU Nvidia B200, el equivalente en número de GPU a siete sistemas DGX B200 de ocho GPU. Abitbol aclaró que las mayores mejoras de rendimiento no vinieron de sumar GPU. Vinieron de ajustar los hiperparámetros del modelo, pasar a cuantización NVFP4, separar las etapas de prefill y decode y afinar el largo del contexto.
| Dato | Valor |
|---|---|
| Parámetros totales de GLM 5.1 | ~754.000 millones |
| Parámetros activos por token | 40.000 millones |
| Memoria para los pesos | ~380 GB |
| Memoria de contexto por usuario | 6 a 26 GB |
| GPU de Revolut para GLM-5.3 | 56 Nvidia B200 |
| Costo por millón de tokens | 0,30 dólares |
Una de las conclusiones fue que admitir una ventana de contexto de un millón de tokens no la vuelve útil ni eficiente.
"El contexto largo es una estafa. Hay que tenerlo muy presente", dijo Abitbol. "Aunque puedas servir un millón de tokens, 256 mil es lo que de verdad necesitas".
¿Qué latencia aceptan los ingenieros?
Con esas optimizaciones, la empresa logró un tiempo hasta el primer token de menos de 3 segundos con ventanas de contexto de unos 256.000 tokens, y una generación de cerca de 200 tokens por segundo. Según Abitbol, ese es el punto justo para sus ingenieros de software.
"A lo que hay que apuntar es a menos de 3 segundos hasta el primer token. Es evidencia empírica. En cuanto pasas de 5 segundos, mi bandeja de Slack empieza a explotar", dijo Abitbol. "En cuanto a rendimiento, no importa tanto. Servimos, en términos de interactividad, 200 tokens por segundo. La gente está bien con eso. No necesitas ir más alto. La forma de trabajar cambió. Ya no miramos el flujo de tokens de razonamiento. La gente corre tareas en paralelo y vuelve a revisar cuando la tarea terminó".
Si el rendimiento preocupa, agregó, los ingenieros que se conectan después de las 17:00 reciben cerca de 800 tokens por segundo.
Un enrutador para lo que GLM no hace
GLM no reemplazó del todo a GPT ni a Claude. El modelo chino trabaja solo con texto, así que no sirve bien para tareas como el diseño de interfaces. Revolut usa un enrutador de modelos que manda las consultas con imágenes a modelos como Gemini o GPT Luna y deja la generación de código en GLM.
"El código abierto es ahora una prioridad en Revolut, y nuestra economía es favorable. La facturación es plana, no tenemos sorpresas en la cuenta a fin de mes, y la frontera es la excepción", dijo Abitbol.
Abitbol reconoce que los modelos chinos de pesos abiertos pueden generar dudas de privacidad y seguridad. Subraya que la preocupación principal es acceder a ellos mediante API que corren desde China. Ejecutados en servidores propios o en nubes regionales, según él, no hay de qué preocuparse.