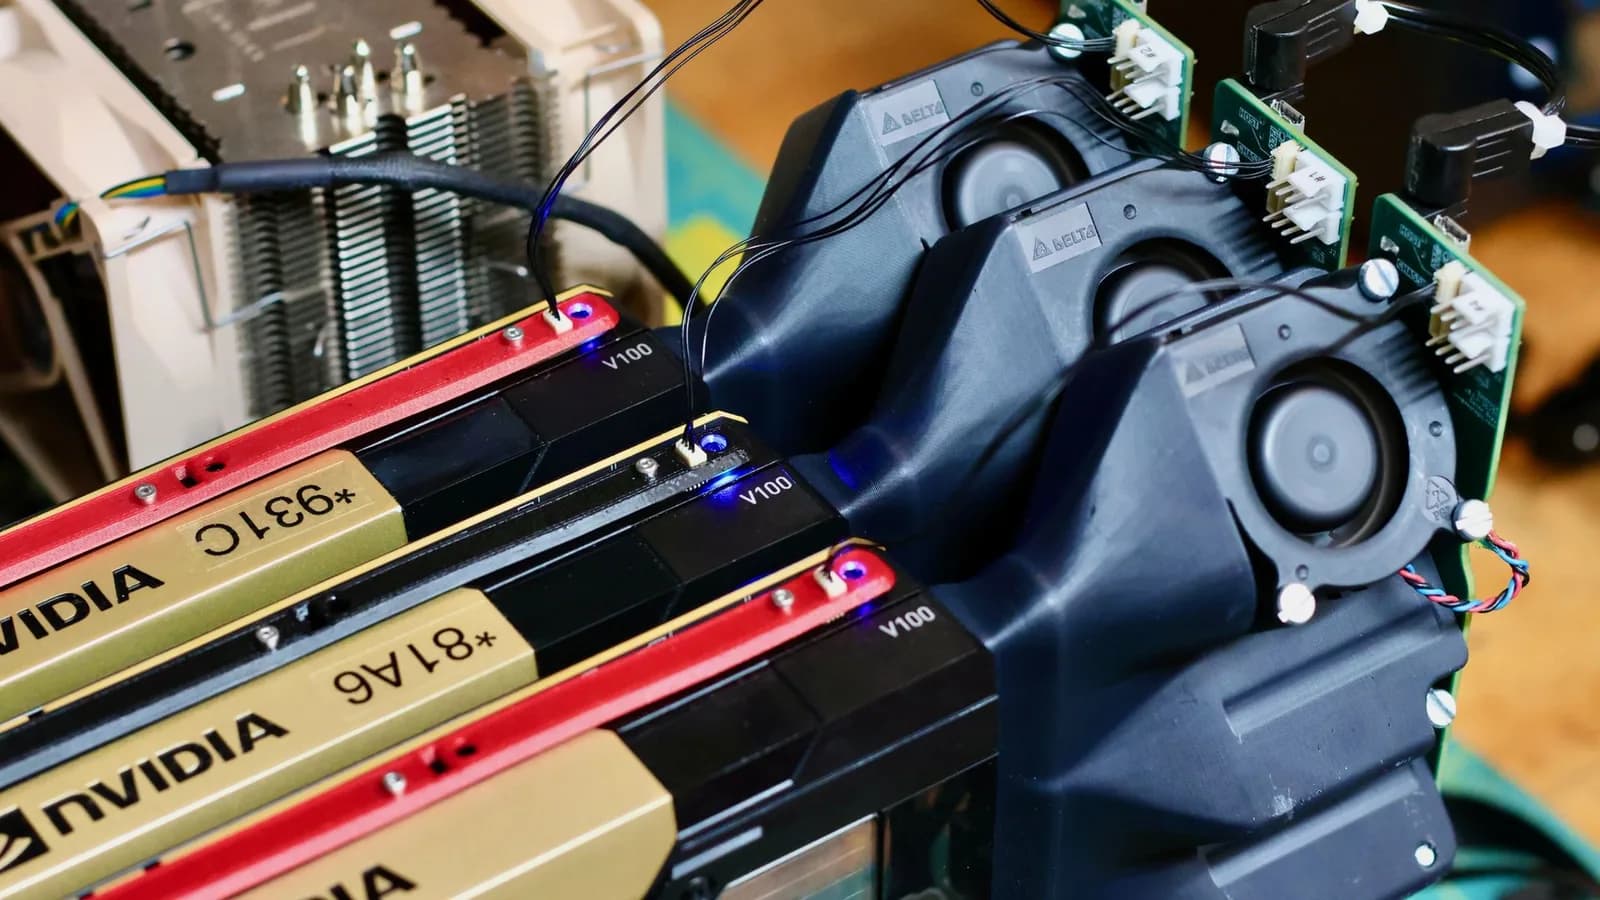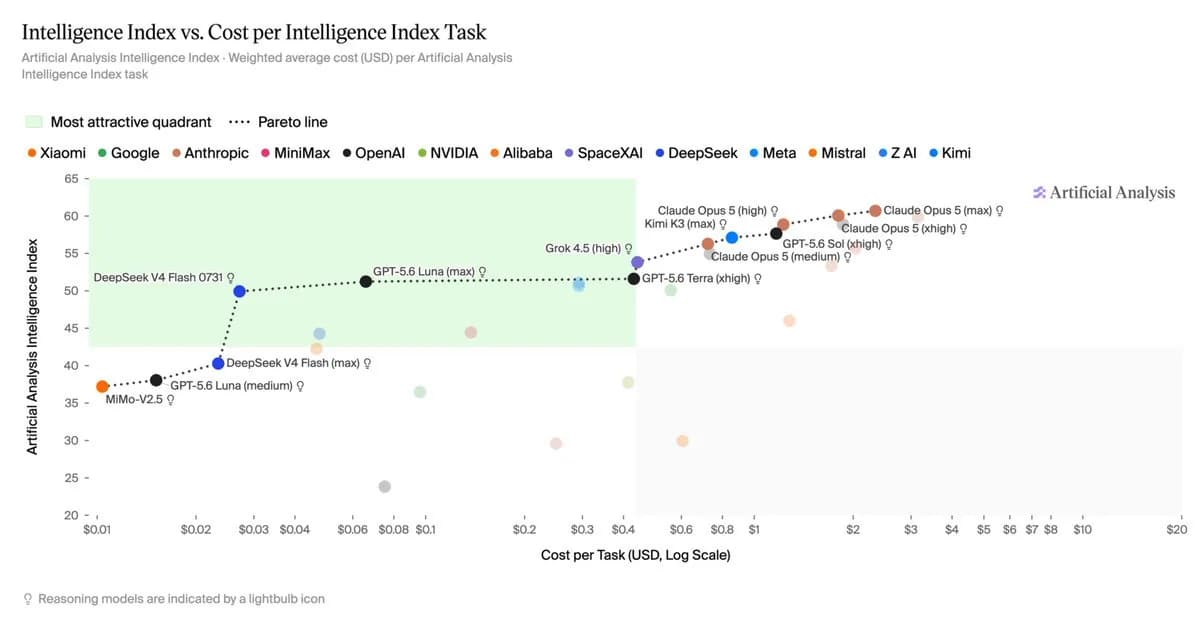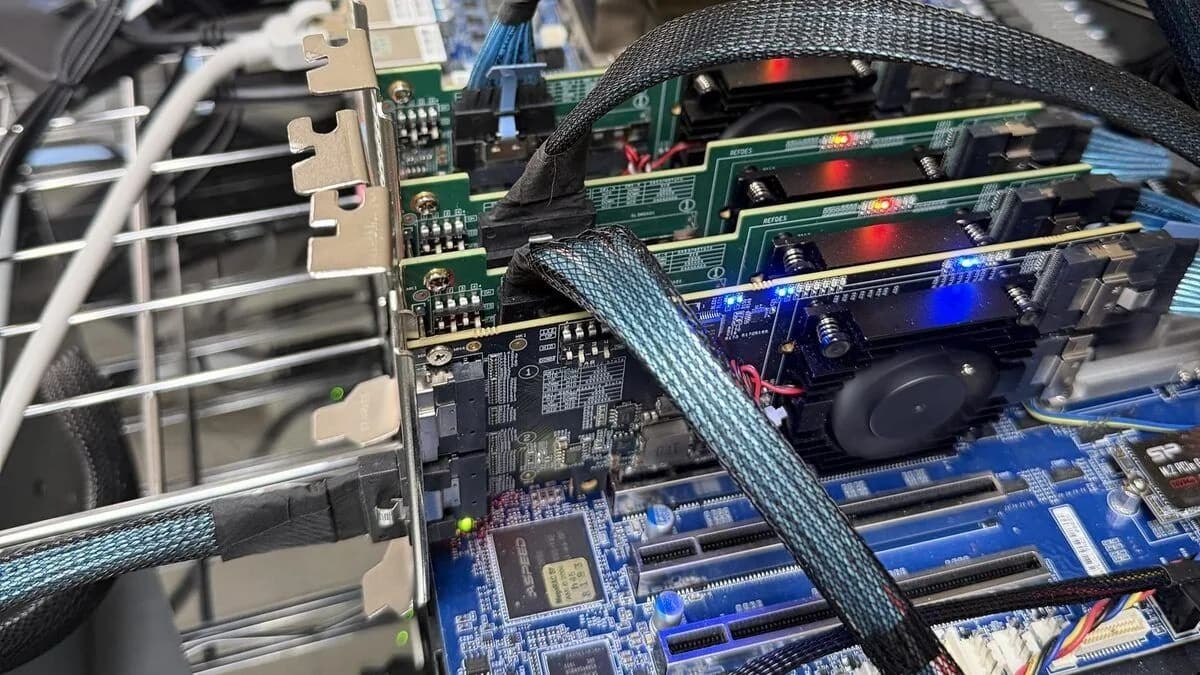
Nick Mermiges, abogado, amplió su servidor de IA privado de ocho a 12 tarjetas Nvidia V100 usadas. Con eso puede correr todos los expertos de DeepSeek V4.1 Flash en el formato de 4 bits NVFP4, informó Tom's Hardware el 20 de noviembre.
El rendimiento llega a 184 tokens por segundo en código, y con documentos largos el modelo empieza a responder en cerca de la mitad del tiempo que antes. Mermiges asegura que decodifica una sola consulta más rápido que los montajes de DGX Spark publicados, por la mitad de lo que cuestan tres unidades, considerando los 9.450 dólares que pagó.
Lo resumió así en r/LocalLLM.
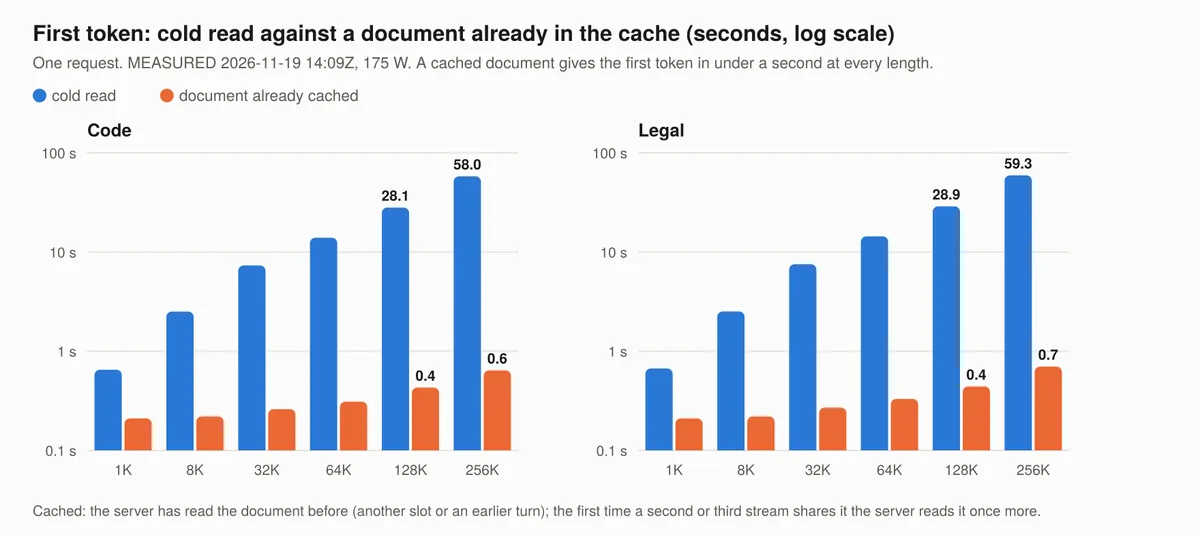
"Abogado con demasiadas GPU: DeepSeek-V4.1-Flash en 12 V100, los 15.360 expertos en NVFP4 en las tarjetas. 157-184 tok/s en un flujo de código, más rápido que cualquier montaje publicado de 4 DGX Spark y el doble que 3 Spark, por la mitad del precio de 3 Spark. Lectura de un archivo de 128K en 28 s."
Tercera versión del mismo servidor
Es la tercera vuelta del proyecto. Mermiges partió con su montaje original, al que ya le había sumado memoria y otros arreglos, y ahora lo amplió para trabajar con más precisión. La mejora consiste en una tercera placa de V100, con lo que llega a 12 tarjetas, cuatro por placa.
Las ocho tarjetas originales de 32 GB sumaban 254 GiB, pero los expertos del modelo elegido, en la versión NVFP4 publicada por Nvidia, necesitan 278,9 GiB. Su solución anterior era dejar todos los expertos en las tarjetas con precisión de 2 bits y pasar a NVFP4 los más usados (5.949, cerca del 38,7%) hasta llenar la memoria.
Ahora los 15.360 expertos caben completos en las tarjetas, "sin ninguno comprimido de más", según su repositorio de GitHub. En un texto más largo en su sitio, dice que los valores de los expertos "son iguales a los de la versión publicada por DeepSeek", aunque otras partes del modelo usan formas compactas.
¿Cómo corre un formato de Blackwell en una GPU de 2018?
La V100 tiene una limitación que él mismo explica. No tiene núcleos tensoriales para FP4 ni FP8, así que cada número NVFP4 se desempaqueta primero por software a media precisión. Los expertos compactos igual convienen "porque las tarjetas leen menos bytes, no porque calculen más rápido".
Eso explica por qué una tarjeta de 2018 puede correr un formato de la era Blackwell.
Las capas del modelo se reparten otra vez entre las placas, ahora en tres tramos: 0 a 13, 14 a 27 y 28 a 39. Cada tramo se divide entre las cuatro tarjetas de su placa. Las tarjetas de una misma placa comparten el enlace rápido de Nvidia, NVLink, y los traspasos entre placas cruzan el PCIe del equipo a través de dos switches PCIe distintos.
Las dos primeras placas comparten un switch PEX88096, así que su traspaso queda dentro de él. La tercera está detrás de un PLX 8749 separado, por lo que el segundo traspaso tiene que cruzar además los puentes PCIe del equipo, y eso suma latencia.
Las mediciones, antes y después
El esfuerzo valió la pena. Con otros ajustes (el límite de potencia de cada tarjeta subió de 150 W a 175 W y su tope de reloj bajó de 1.522 MHz a 1.452 MHz) hay mejoras visibles en rendimiento y en precisión.
| Medición | Antes | Ahora |
|---|---|---|
| Primer token de código con 256K de contexto | 108,4 s (tras la mejora anterior) | 58 s |
| Lectura del prompt sobre 32K | cerca de 2.200 tokens/s (primer montaje) | cerca de 4.500 tokens/s |
| Decodificación de código a 1K | referencia | 23% más rápida |
La mayor potencia probablemente explica parte de la mejora en la lectura del prompt. En decodificación de código no hay ganancias reales desde 32K hacia arriba, así que lo que de verdad mejora es la espera por el primer token.
Mermiges quiso sacarle más al sistema subiendo cada tarjeta a 200 W durante un día, pero "el equipo se cayó una vez con cuatro conversaciones largas al mismo tiempo", lo que sugiere que el consumo era demasiado. También intentó optimizar el montaje al máximo, pero tuvo que desactivar cuatro mejoras porque no cumplieron sus metas: un almacén de conversaciones que guarda en disco, un traspaso más liviano entre tramos, un empaquetado más ajustado de los expertos y una aritmética exacta de suma entre cuatro tarjetas.
Varias consultas a la vez
Otra técnica común es correr varias consultas en paralelo, lo que suele mejorar la velocidad total. En este caso, tres consultas con 128K de contexto lograron cerca de 360 tokens por segundo en total en código y 213 en textos legales. Él mismo advierte que "este no es un motor de decodificación por lotes; más consultas que tramos ganan poco".
Eso podría ser lo siguiente. Mermiges planea estudiar la decodificación por lotes, "lo único que tienen los Spark y que yo quiero", escribió en Reddit. También quiere activar el almacén de conversaciones para que los documentos de un caso sobrevivan a un reinicio.
Reconoce que sus números no demuestran "la calidad de las respuestas en el uso real". Aun así, el montaje es su máquina por defecto para DeepSeek desde el lunes, y dice que es el primer modelo que "funciona como Opus 4.6" para él.