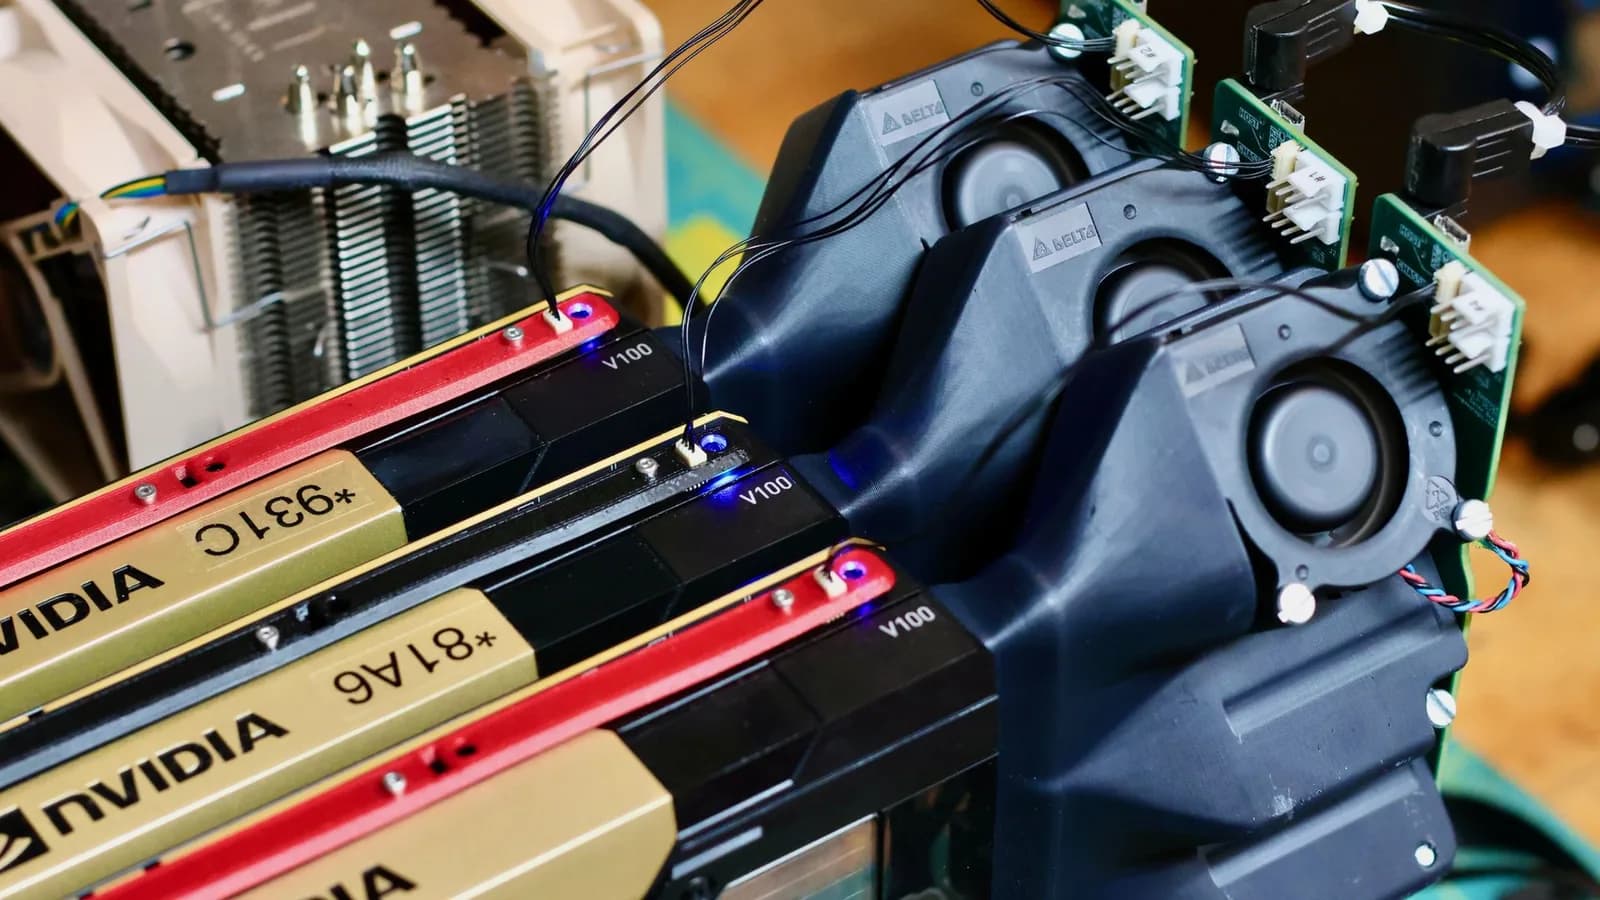
Tres tarjetas Nvidia V100 usadas, de esas que muchos ya dan por basura electrónica, generan unos 100 tokens por segundo con Qwen 3.6 35B en un equipo casero que costó 1.042 dólares. Las pruebas son del constructor de homelabs Devon Bray, que firma como esologic, y Tom's Hardware recogió sus resultados el 19 de noviembre. En la misma plataforma, el modelo denso Qwen 3.6 27B, más chico, rinde cerca de 24 tokens por segundo. Para un mismo trabajo, las V100 gastan más o menos la mitad de la energía que la misma cantidad de tarjetas P100.
El autor resumió el experimento en el foro r/homelab de Reddit, donde publicó también las mediciones de consumo.
"Una caja de GPU de unos mil dólares, llena de tarjetas de descarte (V100, P100), compite con hardware y API de inferencia modernos", escribió.
Nueve armados sobre la misma placa
La entrada de su blog, titulada "Scaling 'E-Waste': LLMs on Multiple Decommissioned GPUs", compara nueve configuraciones distintas, de una a tres tarjetas K80, P100 o V100 de 16 GB, todas montadas sobre una sola placa Supermicro de doble Xeon. Las pruebas usan llama.cpp y suman más de 130 mediciones de modelos de lenguaje, entre ellos Qwen 2.5, Gemma 4 y, como era de esperar, Qwen 3.6, con precisiones Q4, Q8 y F16 y contextos que van de 4K a 128K. También se registra la energía que gasta la GPU en cada corrida.
El autor cuenta que usa Qwen 3.6 35B a diario en las V100. Advierte, eso sí, que escalar con GPU dadas de baja tiene un límite.
¿Qué es una GPU de "basura electrónica"?
En este caso, la expresión se refiere a GPU empresariales retiradas de servicio. Son una opción popular entre aficionados, aunque rinden bastante menos que las alternativas modernas, que cuestan muchísimo más.
Las Nvidia Tesla V100 se probaron como continuación de una ronda de julio, en la que el mismo autor evaluó 15 GPU de este tipo. Esta vez la placa y los procesadores se mantuvieron iguales en todos los armados. Es una Supermicro X10DRG-Q con dos Intel Xeon E5-2687W de 12 núcleos, alimentada por una fuente Corsair HX1500i.
El rendimiento se juzga contra lo que el autor considera "interacción en tiempo real", que fija en 70 tokens por segundo. ¿Y por qué tres GPU? Porque Qwen 3.6 35B, el modelo principal de la prueba, no corre con una ni con dos tarjetas en Q8, es decir, con cuantización de 8 bits.
¿Cuánto costó cada armado?
Los precios son los que entregó el autor, con la advertencia de que no son "100% representativos de lo que se puede encontrar hoy en eBay". Además, los totales cuentan solo una de las dos CPU y dejan fuera la RAM, el almacenamiento, el gabinete y la refrigeración.
| Pieza (dólares) | 3 K80 | 3 P100 | 3 V100 de 16 GB |
|---|---|---|---|
| Tres GPU | 270 (90 cada una) | 403,50 (134,50 cada una) | 655,16 (436,77 por par) |
| Placa | 211 | 211 | 211 |
| Fuente | 147,70 | 147,70 | 147,70 |
| Una CPU | 28,20 | 28,20 | 28,20 |
| Total del autor | 657 | 790 | 1.042 |
| Con la segunda CPU | 685 | 819 | 1.070 |
Las tarjetas más antiguas salen relativamente baratas porque "se calientan mucho y llegan sin refrigeración". Eso obligó al autor a imprimir en 3D un ducto de soplador para cada tarjeta, y de ahí nació un enfriador independiente que ahora está desarrollando.
Cómo se midió la velocidad
Cada prueba consiste en 10 corridas de 512 tokens generados, con el contexto precargado a 4K, 32K, 64K o 128K. Qwen 3.6 35B es un modelo de mezcla de expertos (MoE), que activa unos 3.000 millones de sus 35.000 millones de parámetros por cada token. Las cifras que siguen son en Q8.
Con una ventana de contexto chica, de 4K, la meta se cumplió con holgura. Los 100,8 tokens por segundo de ese caso bajaron a 72,7 con 128K, todavía por encima del umbral de 70. El modelo de 27B, que no es MoE, rindió mucho peor, con 24,3 tokens por segundo en 4K, 21,6 en 32K, 18,7 en 64K y apenas 14,2 en 128K. Según el largo del contexto, el MoE termina siendo entre cuatro y cinco veces más rápido.
| Configuración (tokens por segundo con Qwen 3.6 35B) | 4K | 32K | 64K | 128K |
|---|---|---|---|---|
| 3 V100, Q8 | 100,8 | 89,4 | 83,5 | 72,7 |
| 2 V100, Q4 | 105,4 | 96,2 | 89,5 | 77,1 |
| 3 P100, Q8 | 55,2 | 50,9 | 47,5 | 40,2 |
| Mac M5 Max, 8 bits | 105,5 | 91,1 | 78,5 | 61,3 |
También se probaron otros modelos densos de unos 30.000 millones de parámetros. Con 4K, Gemma 4 31B llegó a 20,9 tokens por segundo y Qwen 2.5 32B a 21,0. El MoE Gemma 4 26B, en cambio, superó la barra de 70 tokens por segundo con solo dos V100 en Q8.
Si se baja a Q4, o cuantización de 4 bits, dos V100 corren Qwen 3.6 35B a entre 77,1 y 105,4 tokens por segundo, de 128K a 4K de contexto. Ahí el autor sostiene que sumar tarjetas entrega más memoria, lo que permite correr modelos más grandes, pero no más velocidad.
¿Cómo le va contra un Mac M5 Max o una DGX Spark?
Las P100, en comparación, solo llegaron a entre 40,2 y 55,2 tokens por segundo en el mismo rango de contexto con Qwen 3.6 35B en Q8, y alcanzaron los 70 únicamente con Qwen 2.5 3B.
La comparación con hardware más moderno se hizo con datos de otras fuentes. Los rivales son la Nvidia DGX Spark, con precio sugerido de 4.700 dólares, y el Mac Studio M5 Max, que parte en 2.499 dólares pero sube a 5.399 con la GPU de 40 núcleos, los 128 GB de memoria y el SSD de 1 TB de la configuración comparada. Frente a ambos, el armado de tres V100 se defiende.
La cifra del Mac sale de la página de benchmarks de oMLX para el M5 Max con 40 núcleos de GPU y 128 GB de memoria unificada, que marca 43,9 tokens por segundo con un prompt de unos 195K tokens en Qwen 3.6 35B. El Mac va levemente adelante en 4K y 32K, mientras que las V100 toman la delantera en 64K y 128K, por 19% en el contexto más largo. Estas cifras hay que tomarlas con cautela, porque las máquinas usan runtimes distintos.
La medición de la Spark viene del dgx-spark-bench de Kleybrink, que usa Ollama en modo de razonamiento con prompts cortos. Sus 45,8 tokens por segundo son menos de la mitad de lo que logran las V100 con 4K.
Las GPU actuales "destrozan a nuestros equivalentes dados de baja", en palabras del autor. Con 128K de contexto se obtienen cerca de 315 tokens por segundo con dos H100 y unos 455 con una sola B200. La B200 rinde unas seis veces lo de la caja de V100, aunque las tarjetas alojadas corrieron el modelo completo en 16 bits y las V100 la versión de 8 bits. Parasail, un proveedor de inferencia, patrocinó esa comparación con despliegues dedicados de H100 y B200.
Consumo de energía por corrida
En energía, el armado de V100 gastó cerca de 0,02 kWh en una corrida del modelo 35B con 128K de contexto. Las P100 consumieron el doble, y dos o tres K80 llegaron a entre 0,35 y 0,45 kWh. Según el autor, la V100 de 16 GB saca mejores puntajes que la P100 y consume menos energía. Las cifras corresponden solo a las GPU y no al consumo medido en el enchufe.
Lo que sigue en el proyecto
El autor quiere un benchmark que refleje el rendimiento de una "fábrica de software", un término para modelos que reciben prompts sin parar, las 24 horas, donde la velocidad inmediata pesa menos. El enfriador, por su parte, está "casi listo para su lanzamiento", y los primeros probadores saldrán de su lista de correo, aunque no hay fecha. En el hilo de Reddit, el autor cuenta además que planea comparar backends de inferencia y usar decodificación especulativa para subir el rendimiento.