Las cargas de agentes, los documentos largos y las bases de código grandes están empujando el largo de contexto de decenas de miles de tokens a cientos de miles. Con esos largos, la atención pasa a ser la parte más cara de una capa transformer. La atención densa compara cada consulta (query) contra cada clave (key), así que su costo por consulta crece con el largo de contexto N. Con 128K tokens puede llevarse la mayor parte del tiempo de prefill de una capa.
La solución a nivel de modelo es la atención dispersa, una técnica en la que cada consulta atiende solo a un subconjunto pequeño del contexto, elegido para esa consulta, y no al contexto completo. Eso reduce tanto el cómputo como el tráfico de memoria de la atención con contextos largos.
NVIDIA publicó el 17 de noviembre en su blog para desarrolladores una guía práctica para quienes diseñan atención dispersa que corra bien en sus GPU. Se centra en la atención dispersa a nivel de modelo, en la que la dispersión se aprende durante el entrenamiento, y no en métodos que se aplican después del entrenamiento como BLASST, MInference o Quest. Con un kernel FP8 de producción, el equipo recorre los parámetros de diseño del indexador (cabezas de consulta, cabezas de clave, dimensión de cabeza, razón de compresión y profundidad de la decodificación especulativa), mide cómo escala el costo de Top-k y compara la atención central por token contra la atención por bloques.
Cada sección explica qué premia el hardware y por qué, y termina con una regla aplicable al diseño propio. La guía sigue el mismo enfoque de codiseño de las entregas anteriores sobre atención densa y diseño de LLM pensado para el hardware.
¿Qué es la atención dispersa y por qué importa?
La atención dispersa es una técnica de optimización que limita a qué tokens anteriores atiende cada consulta. En vez de mirar el contexto completo, cada consulta atiende solo a las k claves más relevantes, que suelen ser unos pocos miles. Así la atención central deja de crecer con el contexto.
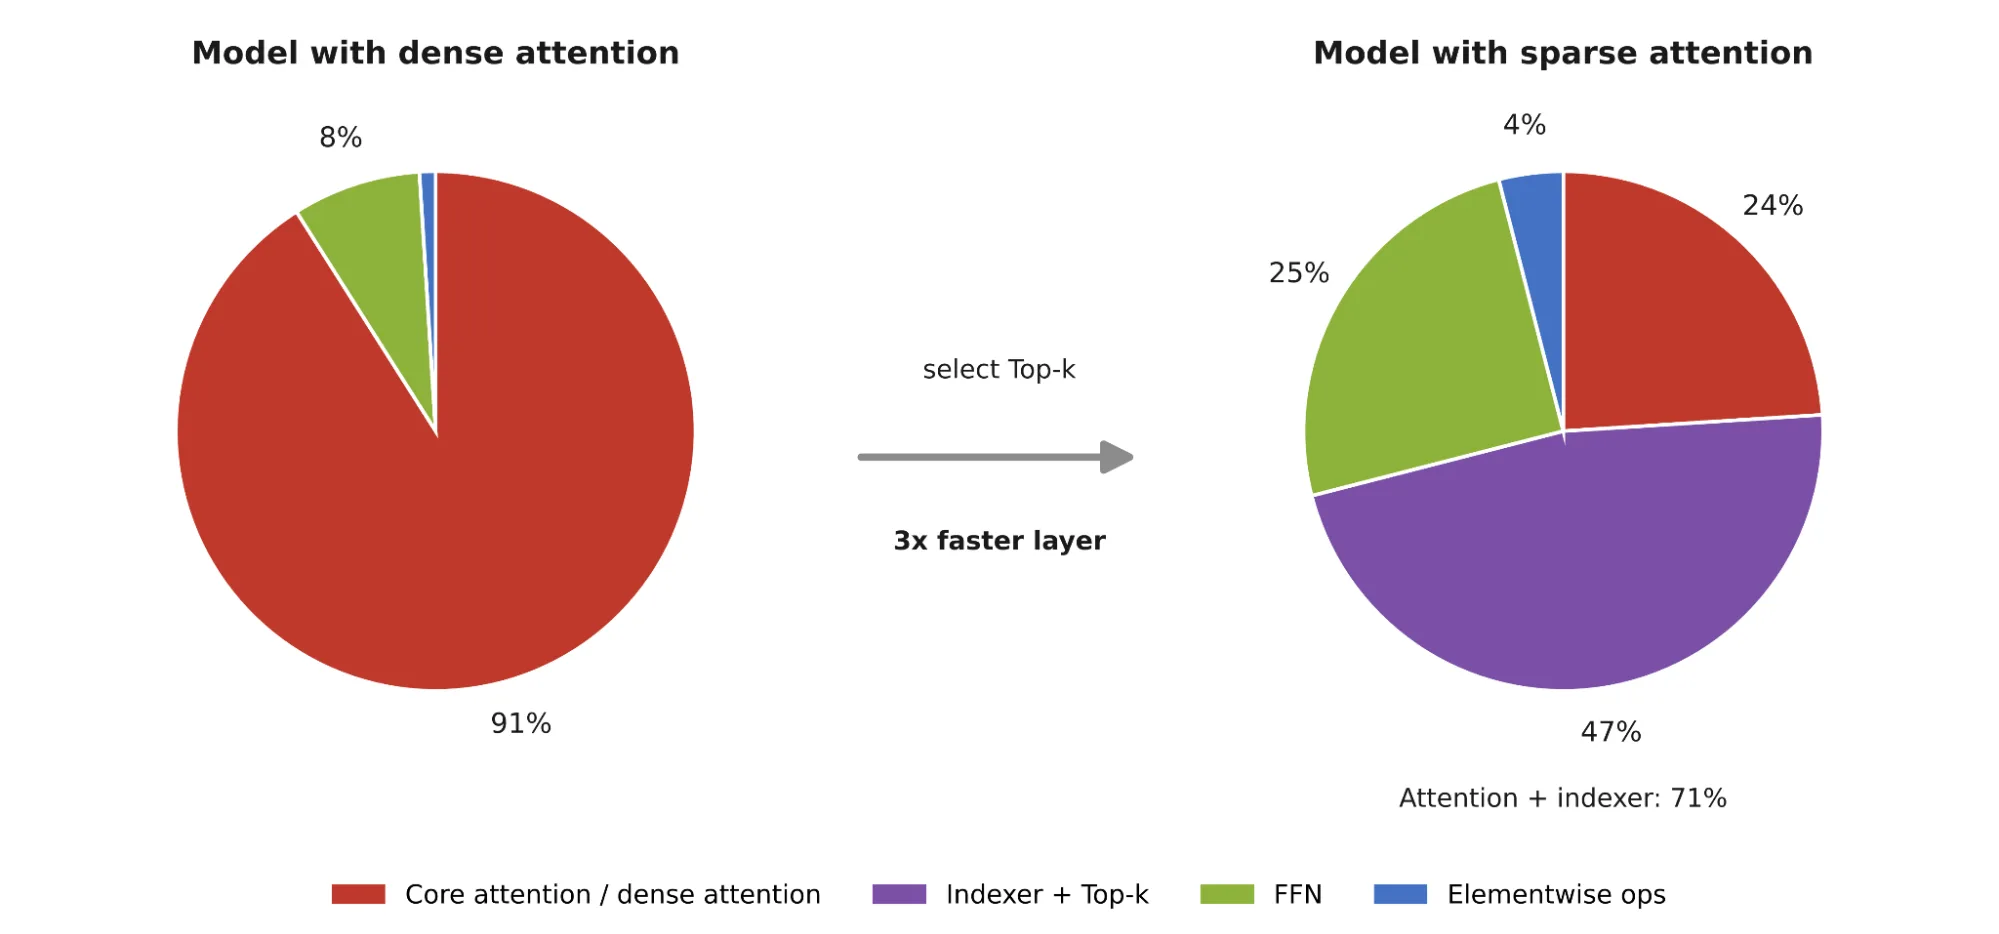
Pero esas k claves hay que encontrarlas, y el componente que lo hace, el indexador, sigue puntuando las N claves. El costo no desaparece, se traslada al indexador. En la capa de prefill de DeepSeek V3.2, el indexador y Top-k se llevan el 47% del tiempo.
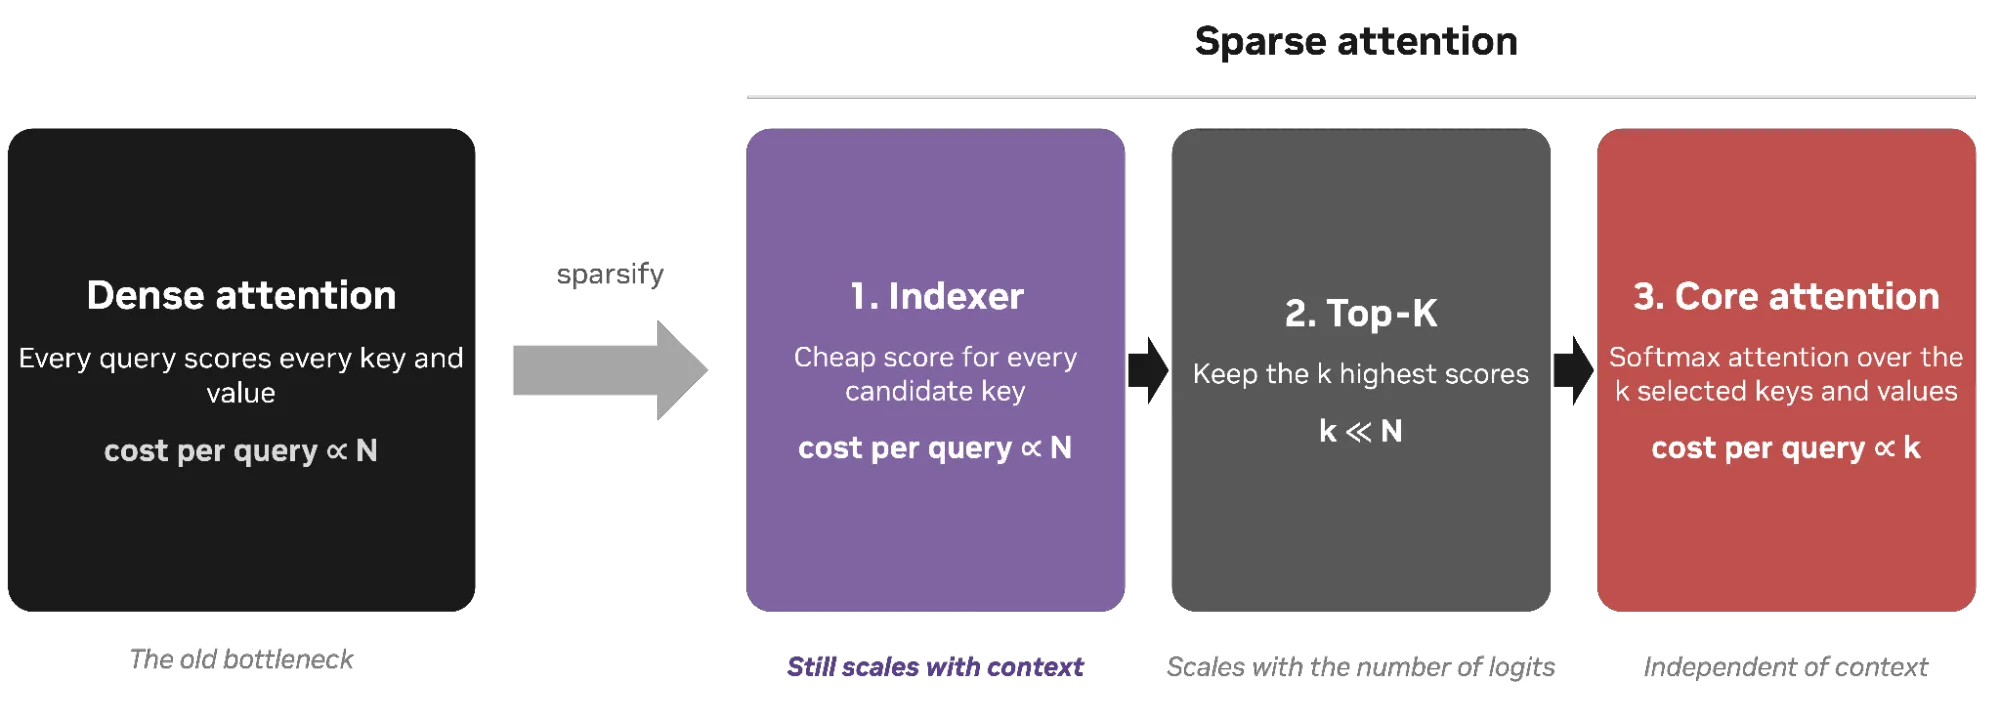
La atención dispersa tiene tres etapas. El indexador puntúa cada clave, Top-k se queda con los k puntajes más altos y la atención central aplica atención softmax sobre esas k claves y sus valores. Las dos últimas etapas escalan con k, y el indexador con N.
El espacio de diseño del indexador
Un indexador es un bloque pequeño parecido a la atención. Las cabezas de consulta comparan la consulta actual contra una caché de claves del indexador, y unas operaciones de posprocesamiento (por ejemplo una ReLU y una suma ponderada) convierten esos puntajes en un solo logit por clave.
La mayoría de los diseños recientes usa una sola cabeza de clave (KH = 1), entre 32 y 64 cabezas de consulta reducidas a un solo puntaje con una ReLU y una suma ponderada, una dimensión de cabeza (Hsz) de 128 y selección por token o por bloques pequeños. Las mediciones de las cinco secciones siguientes, una por parámetro, muestran cuáles de esas decisiones son eficientes en las GPU de NVIDIA y cuáles conviene cambiar.
¿Cómo calcula el indexador?
El indexador es una sola multiplicación de matrices en lote con un epílogo fusionado. En el prefill puntúa de una vez todos los tokens de la entrada (ISL), así que la multiplicación es grande y queda limitada por el cómputo. En la decodificación puntúa solo D + 1 tokens de consulta por cabeza de clave en cada paso, y para unas pocas filas de logits tiene que leer la caché de claves completa desde la memoria HBM.
Contar las FLOP, las lecturas de Q y K y las escrituras de logits da la intensidad aritmética de cada fase. En el prefill los términos de Q y K se achican como 1 / ISL, así que con contexto largo solo sobrevive la escritura de logits.
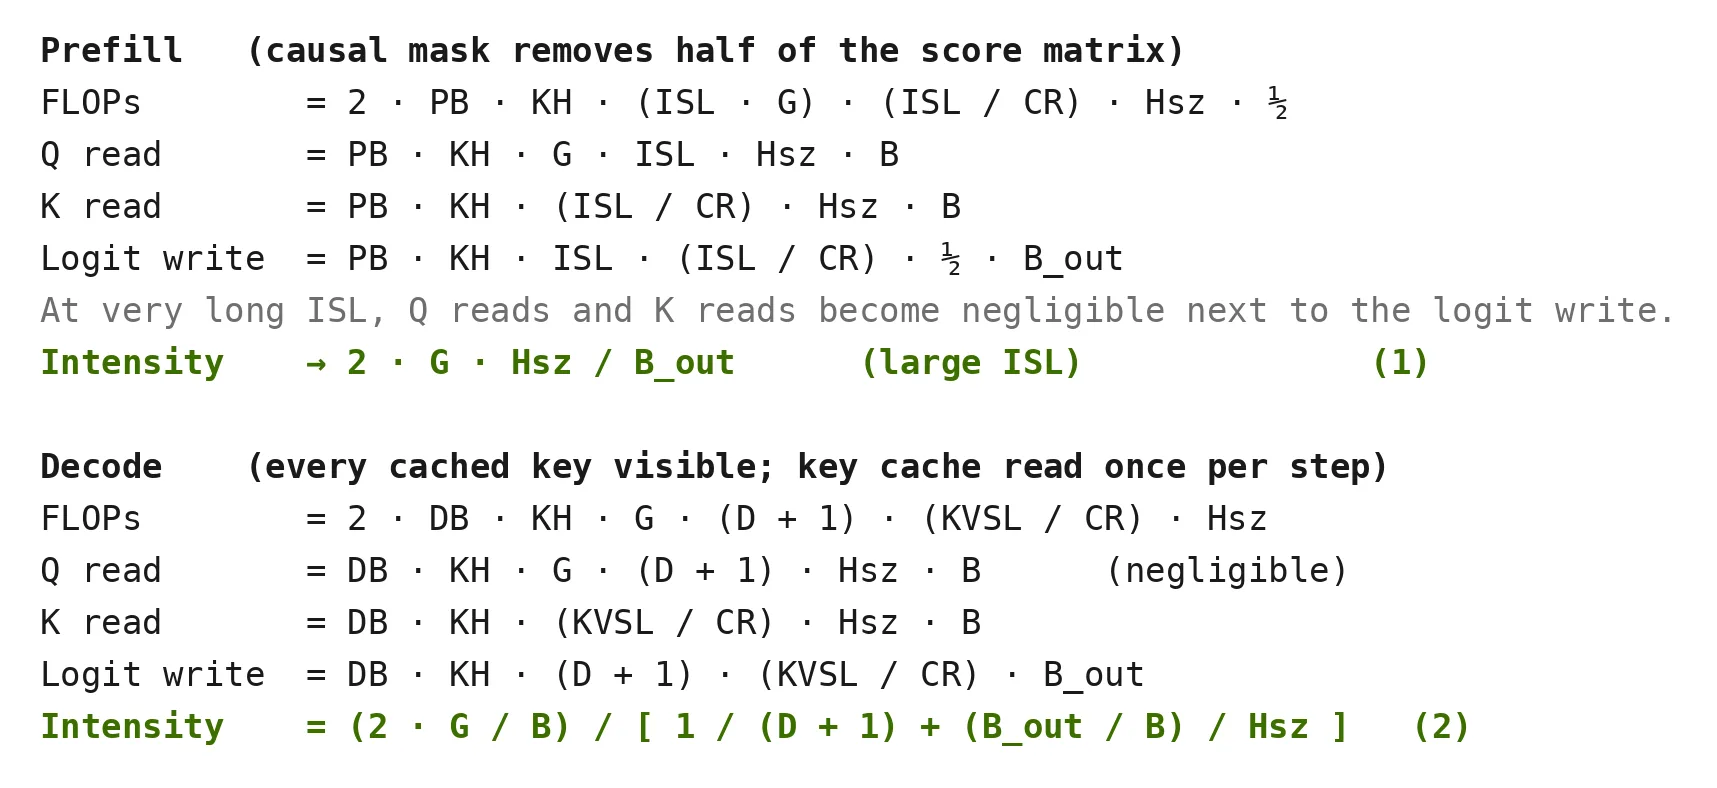
De las ecuaciones 1 y 2 salen tres observaciones.
- El largo de secuencia (ISL, KVSL) y la razón de compresión (CR) no aparecen en ninguna de las dos. Escalan el trabajo total, pero no la proporción entre FLOP y bytes.
- Las dos intensidades son proporcionales a G = QH / KH. Reducir las G cabezas de un grupo a un solo logit da G veces más FLOP por logit escrito. Los diseños que no hacen esa reducción, como MSA y MoBA, pierden ese factor.
- La intensidad en decodificación crece casi en línea con D + 1 y casi no depende de Hsz, siempre que los D + 1 tokens de consulta quepan en una sola pasada sobre la caché de claves.
Salvo que se indique otra cosa, las mediciones usan un kernel de indexador FP8 con 64K claves de indexador (CR = 4), Hsz = 128, KH = 1, PB = 1 y DB = 128.
Cabezas de consulta, tamaño de grupo y largo del borrador especulativo
La intensidad es proporcional al tamaño de grupo, pero prefill y decodificación responden distinto. El prefill está limitado por el cómputo, así que más cabezas de consulta significan proporcionalmente más tiempo. La decodificación está limitada por la memoria, y leer la caché de claves es el cuello de botella principal. Más cabezas de consulta suman FLOP pero no bytes nuevos, así que el tiempo de ejecución no cambia.
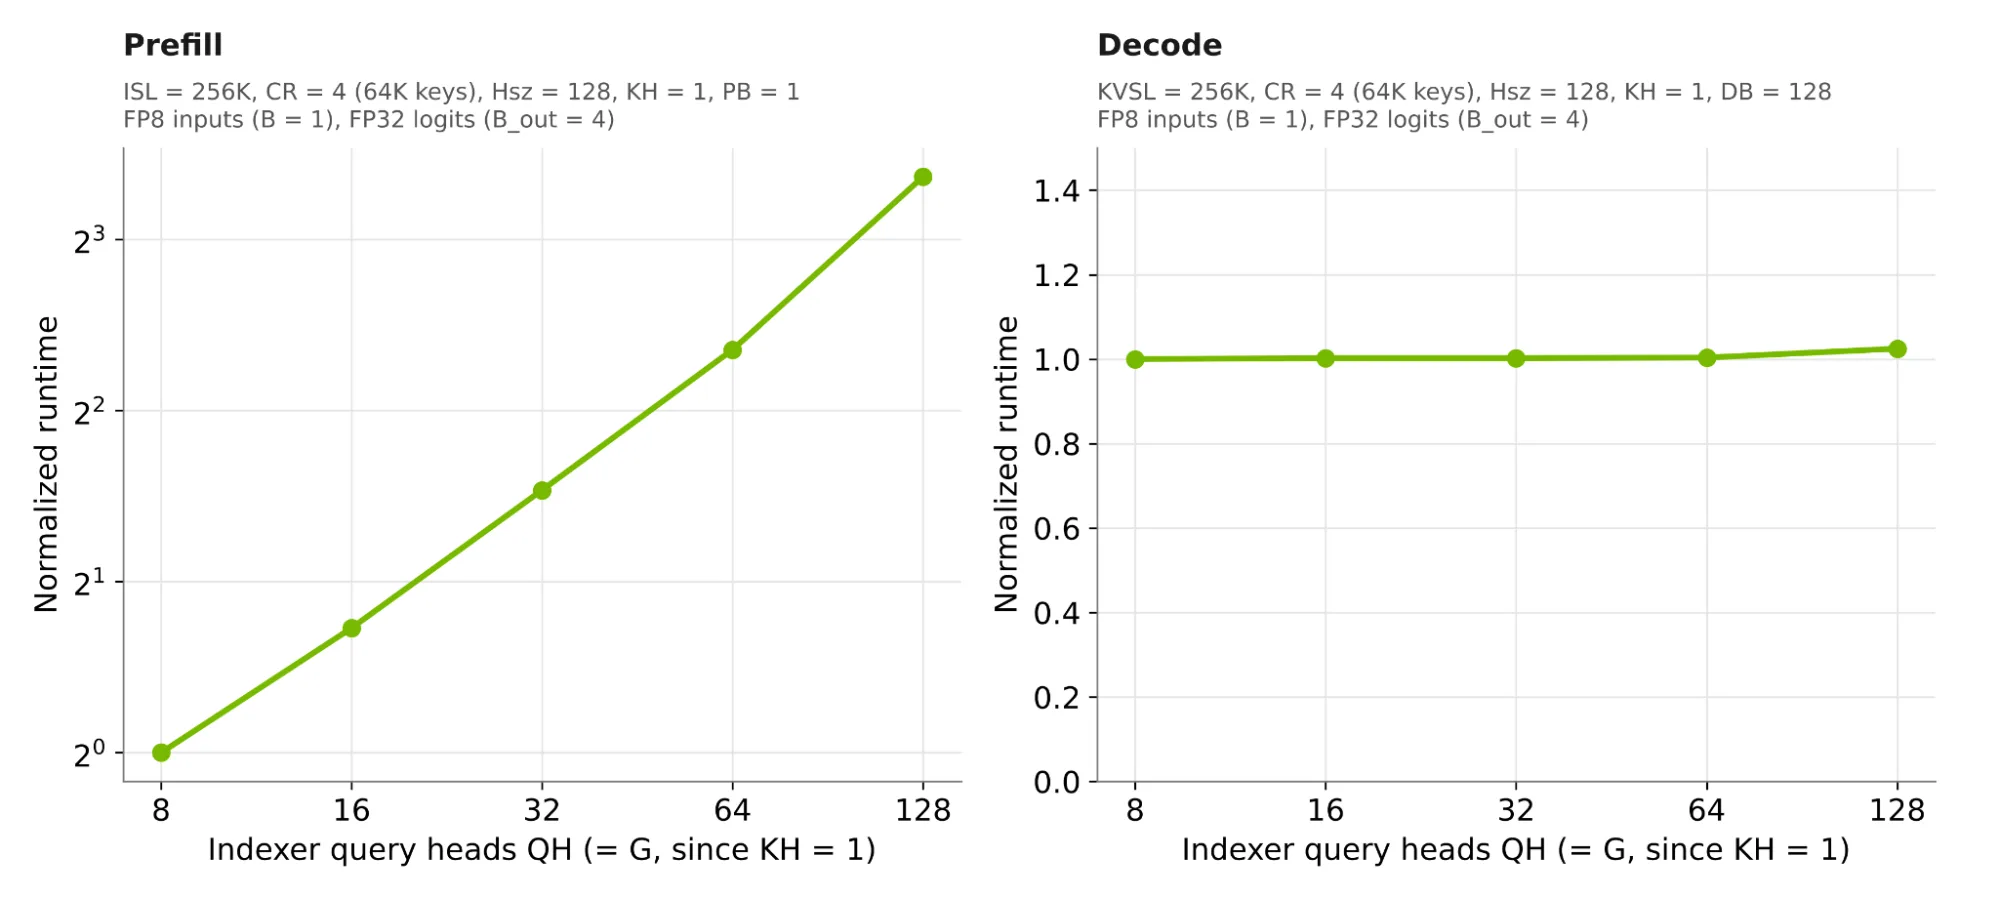
En decodificación el tiempo se mueve solo 2% mientras G crece 16 veces, porque la única lectura de la caché de claves fija el tiempo. En prefill el tiempo crece más lento que G cuando G es chico. Duplicar G de 8 a 16 cuesta 1,66 veces, no 2. La razón es que la escritura del logit en FP32 ocurre una vez por logit sin importar G, y con G chico esa escritura domina. Sobre G = 16, aproximadamente, domina la multiplicación de matrices y el tiempo crece con G.
La ecuación 2 tiene una segunda palanca sobre la intensidad en decodificación, D + 1, el número de tokens de consulta que se puntúan por paso. Sin decodificación especulativa vale 1. Con ella, el modelo genera un borrador de D tokens y los verifica junto al token nuevo en un solo paso, así que el indexador puntúa D + 1 tokens de consulta contra la misma caché de claves. Igual que las cabezas de consulta extra, esos tokens suman FLOP pero no bytes nuevos, y los tokens del borrador salen casi gratis mientras quepan en una pasada.
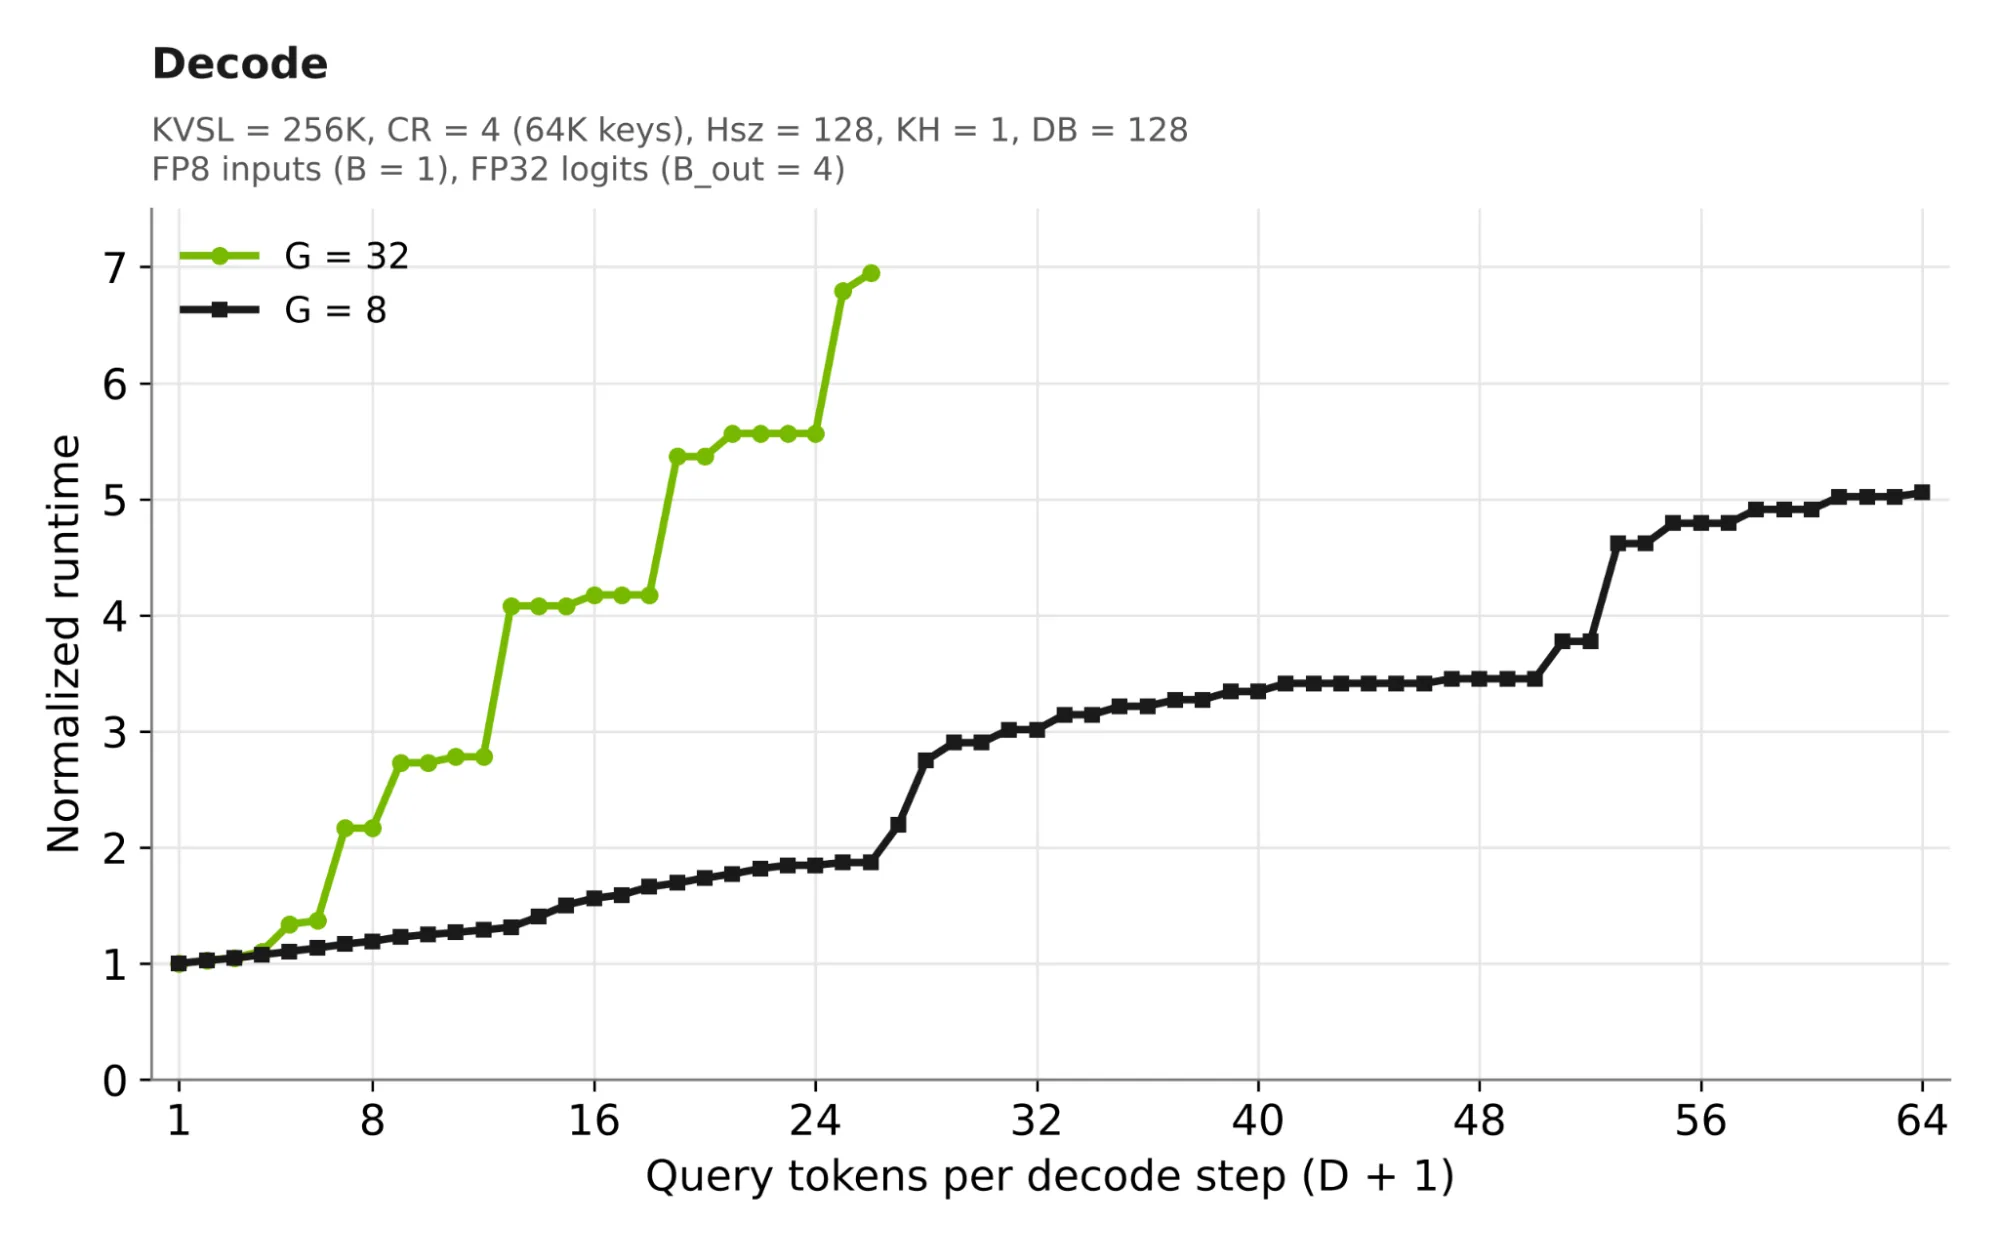
Una baldosa (tile) de Tensor Core admite hasta 256 filas de consulta. Con un epílogo en FP32, la presión sobre los registros deja la baldosa práctica en unas 200 filas, así que una pasada por la caché de claves puede puntuar G × (D + 1) hasta cerca de 200. Eso son seis tokens de consulta con G = 32 y 26 con G = 8. Hasta ese punto el tiempo sube solo 1,37 y 1,87 veces mientras el trabajo crece 6 y 26 veces. Pasado ese punto las filas ya no caben en una baldosa, el kernel lanza más CTA y el tiempo da un salto.
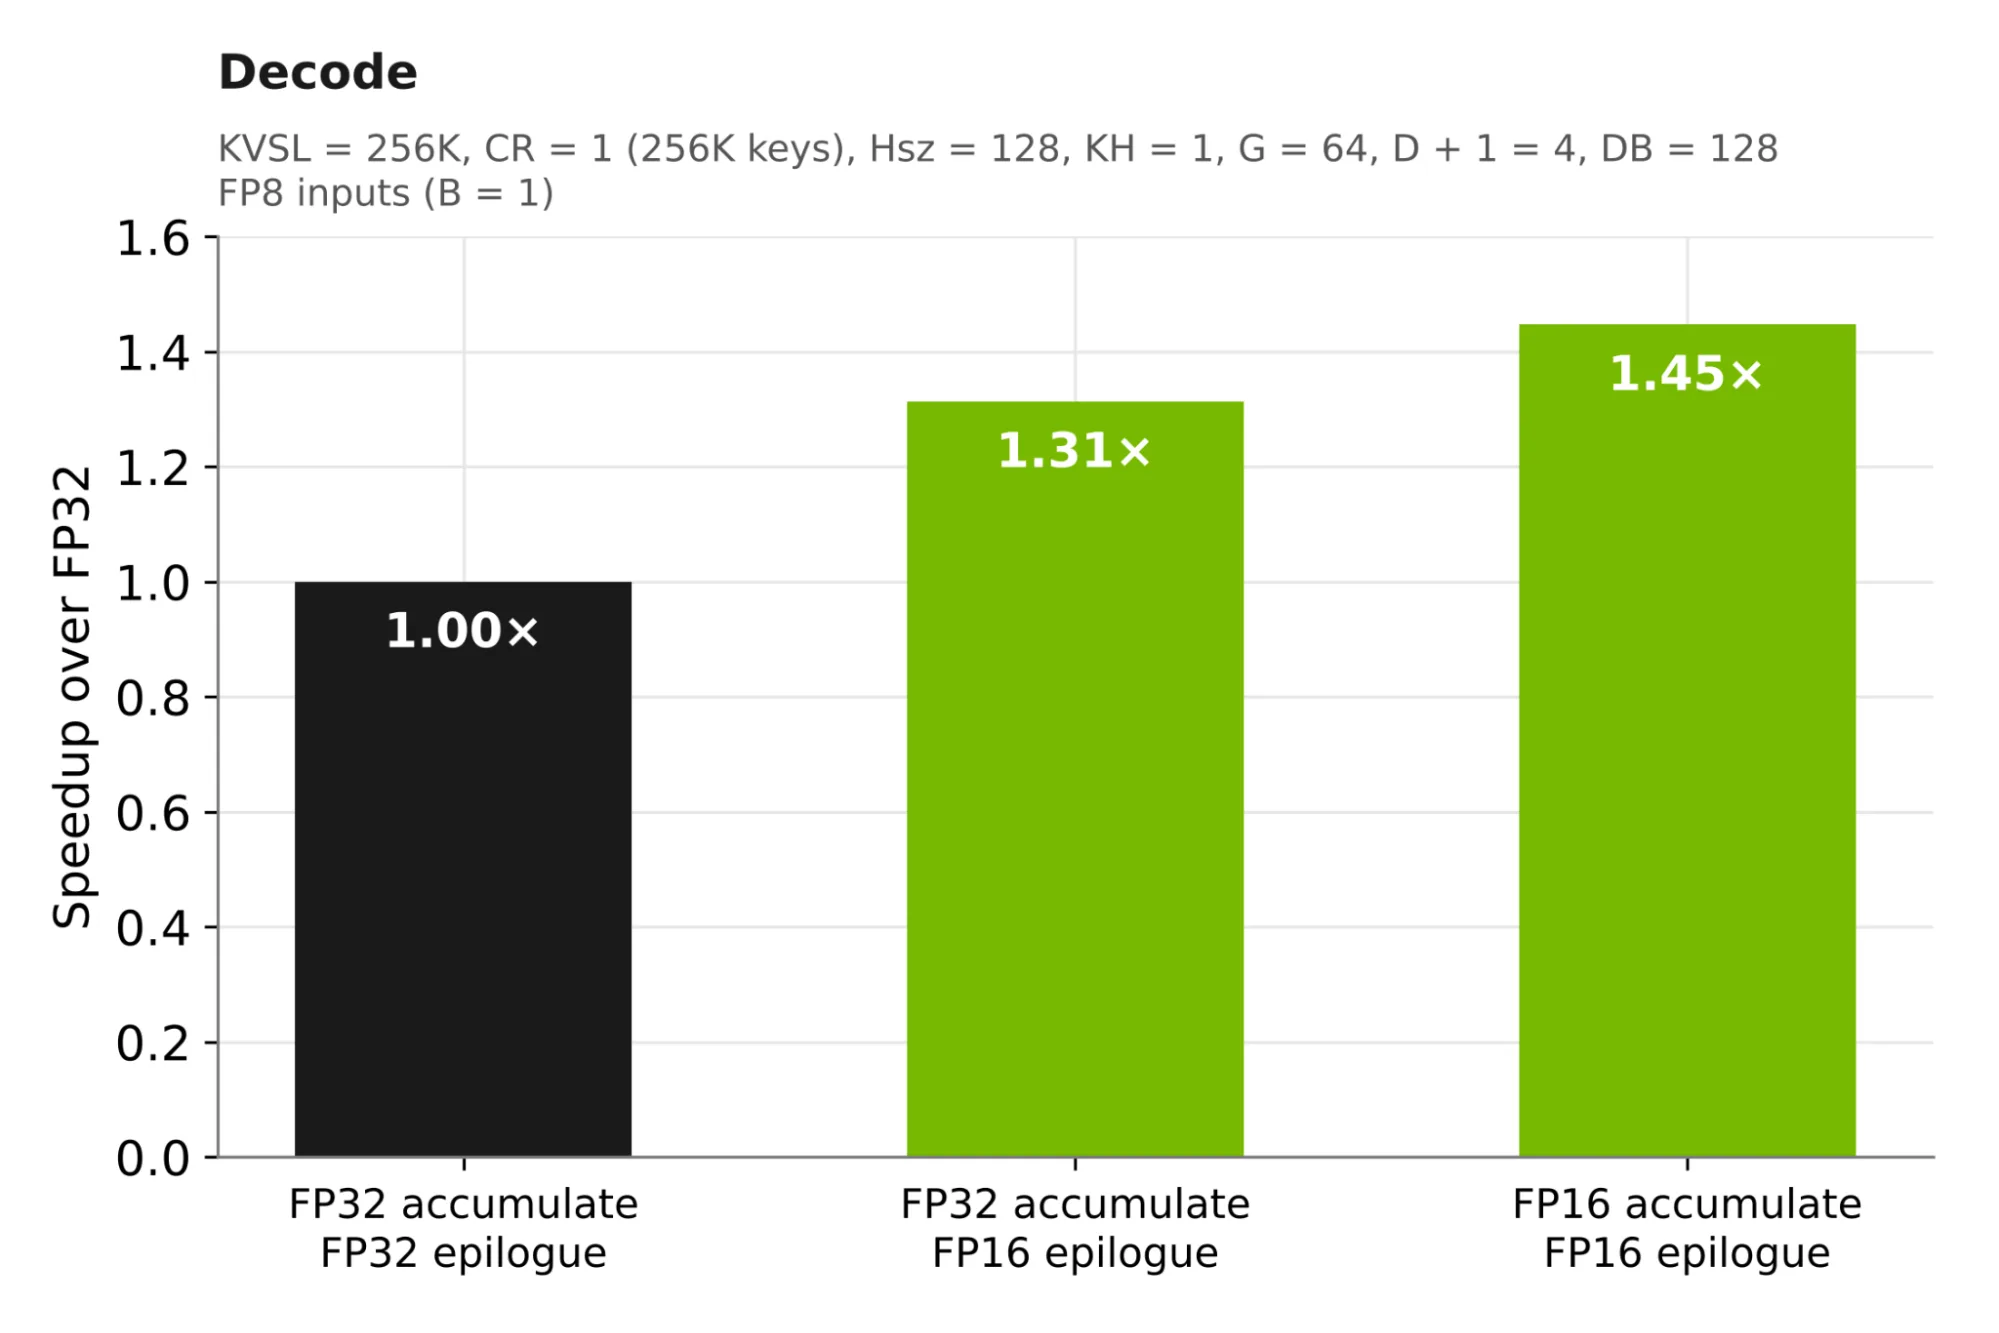
El tamaño de grupo y la profundidad especulativa compiten por la misma baldosa. Un epílogo en FP16 amplía la baldosa a 256 filas y da una aceleración de 1,31 veces con G = 64 y D + 1 = 4. Acumular también la multiplicación de matrices en FP16 llega a 1,45 veces, pero solo si el escalado QK del indexador mantiene las salidas dentro del rango de FP16.
Regla 1. Mantener G × (D + 1) dentro de una baldosa de Tensor Core, unas 200 filas (256 con epílogo en FP16).
Regla 2. Correr el epílogo del indexador en FP16. Usar FP16 también para la acumulación, siempre que el escalado QK del indexador mantenga las salidas de la multiplicación dentro del rango de FP16.
Cabezas de clave (KH)
Subir KH con un QH fijo achica G y baja la intensidad tanto en prefill como en decodificación, pero cada fase lo paga distinto.
En decodificación, cada KH adicional significa otra lectura completa de la caché de claves y otro conjunto de logits que escribir. La lectura de claves es la mayor parte del tráfico de esa fase, así que el tiempo crece en línea con KH, 7,6 veces de KH = 1 a KH = 8. Las FLOP no cambian, pero se mueven KH veces los bytes.
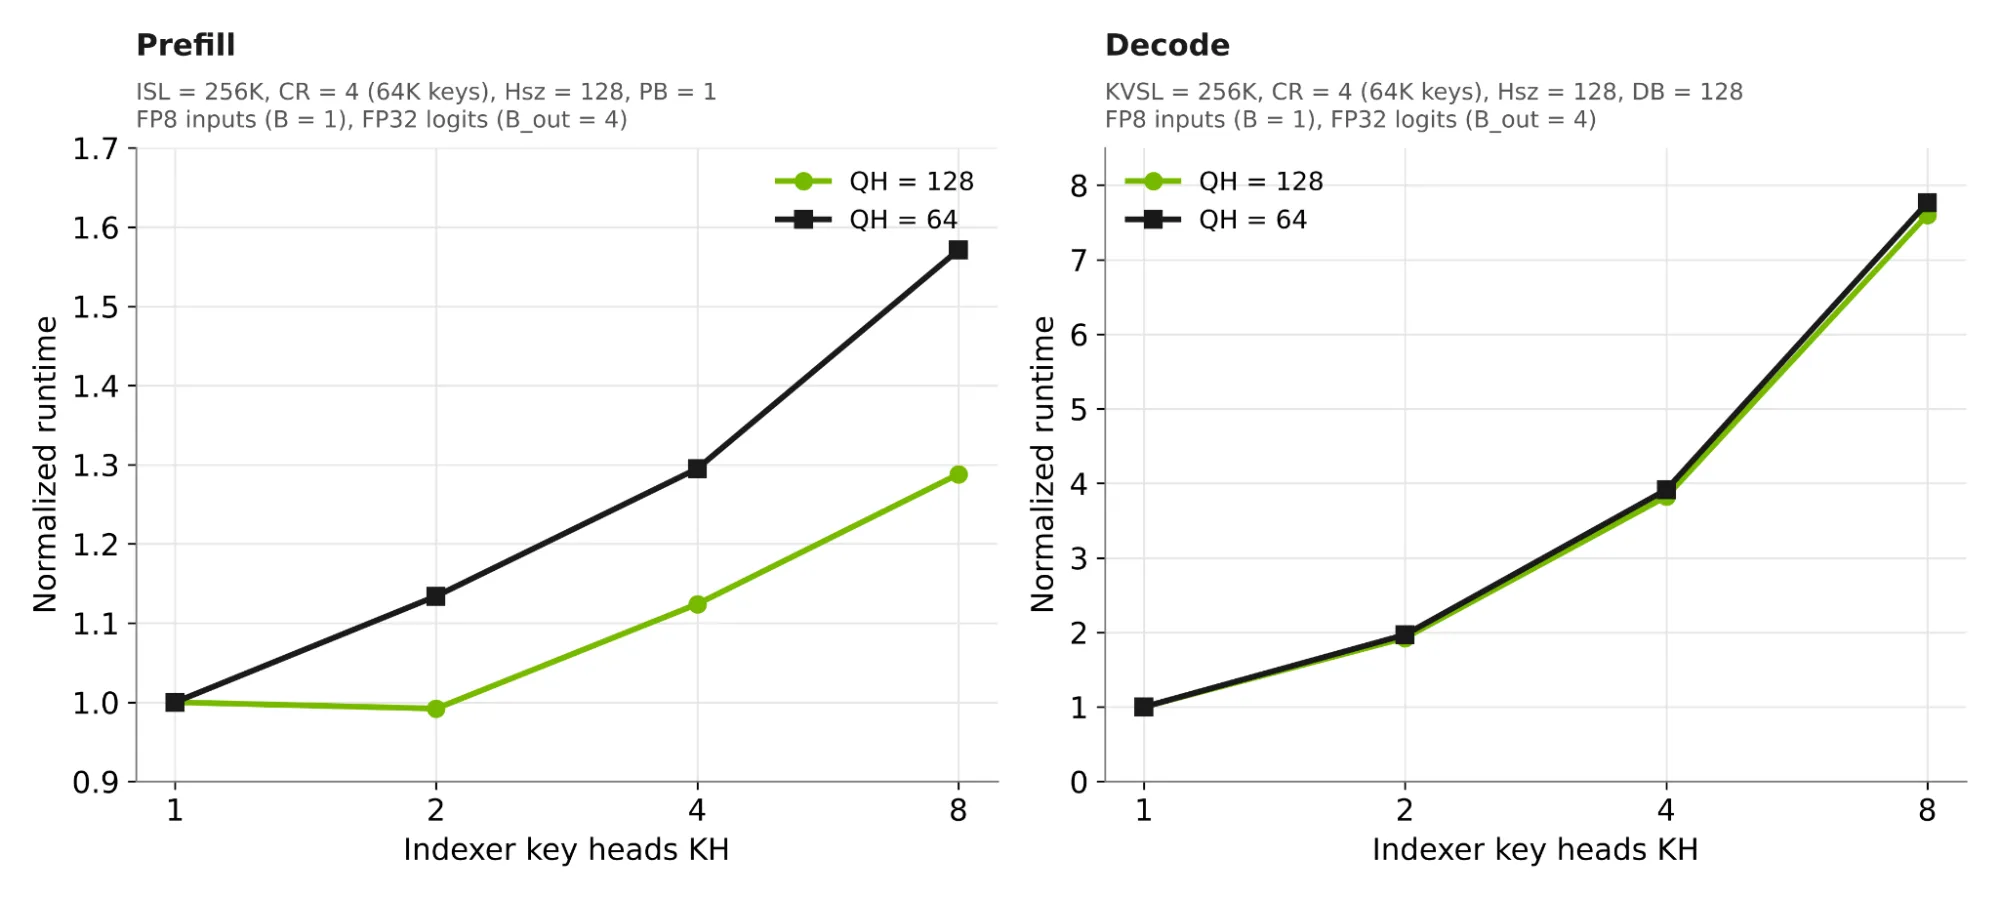
El prefill es menos sensible y sube entre 1,3 y 1,6 veces de KH = 1 a KH = 8. Las FLOP no cambian, y las lecturas de claves extra son pocas al lado de la escritura de logits que domina el tráfico del prefill. Lo que crece es el trabajo por logit, porque cada cabeza de clave escribe su propio logit para cada clave. Un epílogo de menor precisión (regla 2) y la fusión con Top-k reducen ese trabajo.
Regla 3. Usar KH = 1 con una reducción entre las G (= QH) cabezas de consulta, de modo que se escriba un solo logit por clave.
Dimensión de cabeza (Hsz) y el epílogo
Hsz entra directo en la ecuación 1, así que una cabeza más ancha sube la intensidad del prefill. En la ecuación 2 su peso es mínimo, y la decodificación solo paga los bytes extra de las claves.
El prefill tiene un segundo efecto que la ecuación 1 no recoge. El epílogo (la ReLU y la suma ponderada) trabaja sobre los puntajes, cuya cantidad no depende de Hsz. Solo las FLOP de la multiplicación crecen con Hsz. Con Hsz chico, el prefill queda limitado por el epílogo en los núcleos CUDA y los Tensor Cores esperan. Ensanchar la cabeza agrega FLOP de multiplicación que caben en ese tiempo de espera, así que el tiempo crece mucho más lento que Hsz hasta que ambos se equilibran cerca de Hsz = 128.
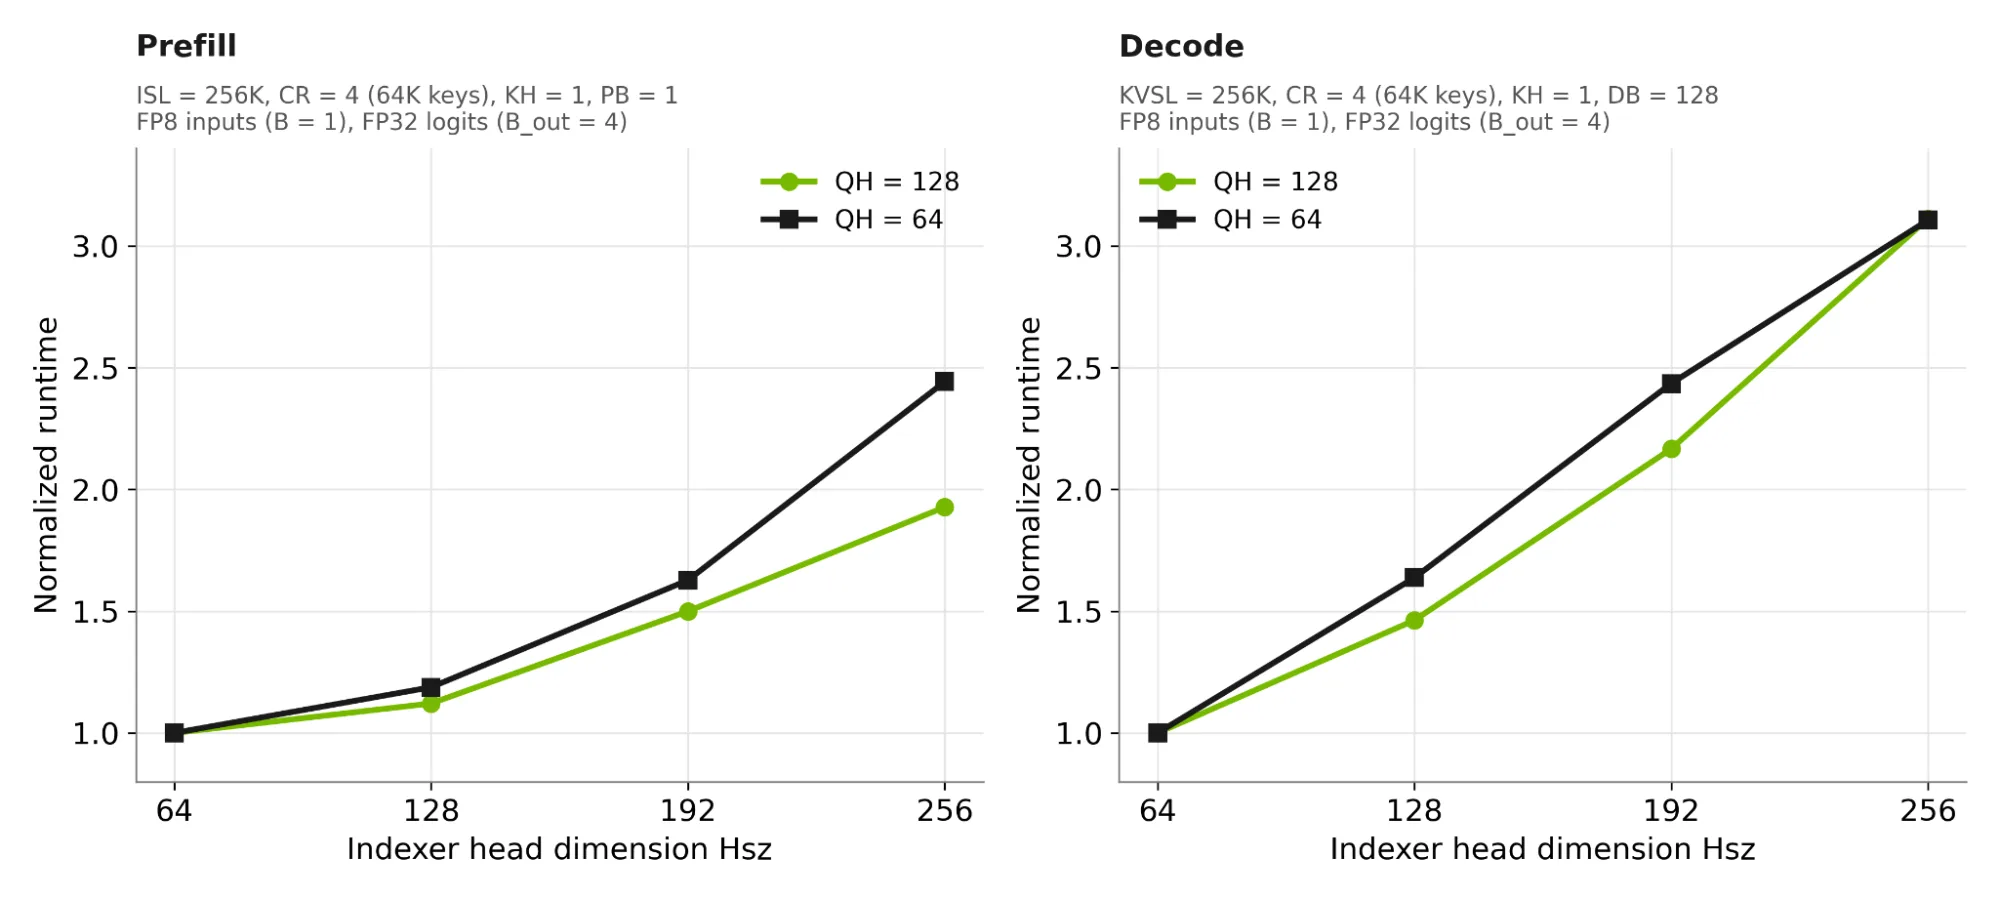
En prefill, pasar de Hsz = 64 a 128 cuesta solo entre 1,1 y 1,2 veces, no 2, y sobre 128 el tiempo crece con las FLOP. En decodificación el tiempo crece con Hsz en todo el rango, porque cada byte extra de clave se lee desde HBM.
Regla 4. Usar Hsz = 128 o 256. Con Hsz = 64 los Tensor Cores quedan esperando al epílogo. Las cabezas más angostas reducen los bytes en decodificación, y por eso la mayoría de los diseños se queda en 128.
Razón de compresión (CR)
Con CR = 4, una clave del indexador representa cuatro tokens. Aquí CR es la razón de compresión del indexador. La atención central puede comprimir su propia caché KV por separado, lo que ahorra sobre todo capacidad de memoria, mientras que la CR del indexador fija el tiempo de ejecución. CR no aparece en las ecuaciones 1 ni 2, así que no cambia qué limita al kernel. Cambia el trabajo total, en línea con 1/CR, tanto en prefill como en decodificación.
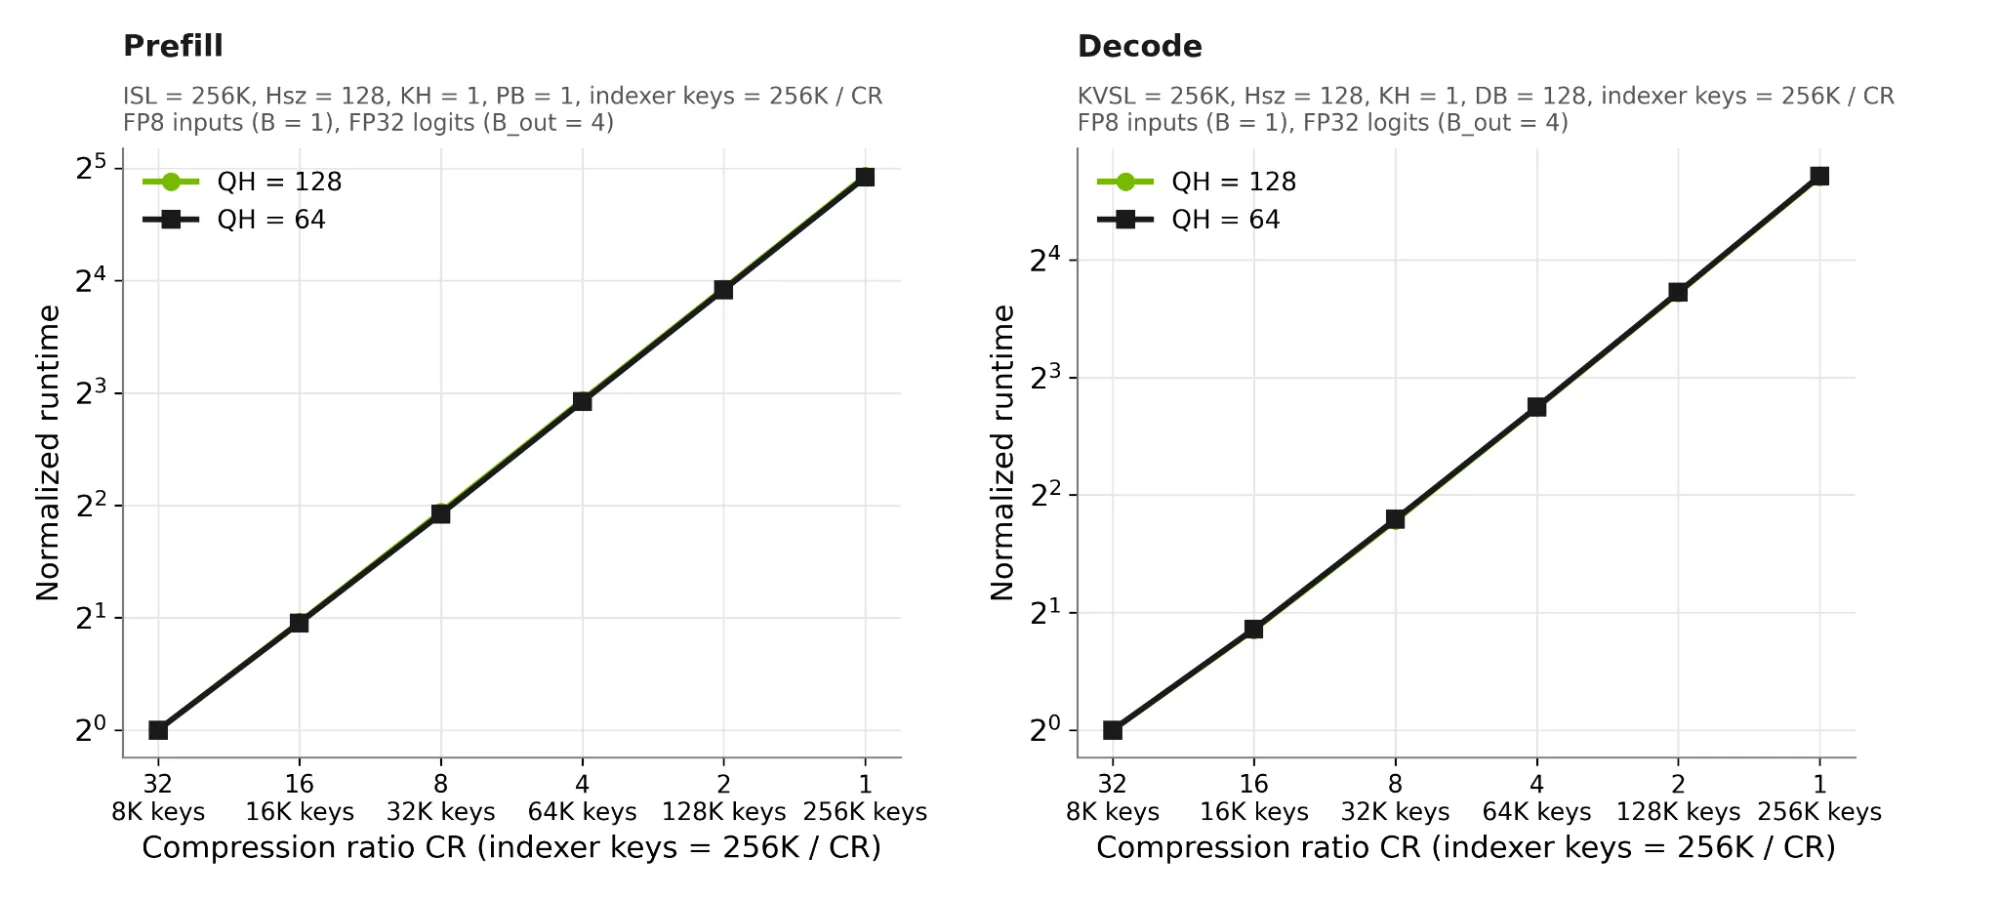
En prefill el tiempo se duplica cada vez que CR se reduce a la mitad, porque cada clave que se quita se lleva su parte de multiplicación, epílogo y escritura de logits. En decodificación también se duplica, salvo con la caché más chica (8K claves, 1,8 veces), donde la lectura de claves es demasiado corta para alcanzar el ancho de banda completo de HBM.
Puntuar menos claves es la única forma de reducir el trabajo del indexador. NVIDIA identifica tres caminos en los modelos recientes. Claves de indexador comprimidas (CSA, GLM 5.3 Flash, QSA, NSA, MoBA), indexación jerárquica (LSA-Flash) e índices compartidos entre capas (GLM 5.2, LSA-Flash).
Regla 5. Reducir las claves que puntúa el indexador, con compresión, indexación jerárquica e índices compartidos. Ninguna de estas técnicas cambia la intensidad aritmética, así que se usan junto con las reglas 1 a 4 y no en su reemplazo.