El Allen Institute for AI (Ai2) liberó el 1 de octubre Olmo-core 3, una actualización de su marco para desarrollar modelos de lenguaje. La pieza central es un sistema rediseñado y abierto para entrenar modelos de mezcla de expertos (MoE, por mixture of experts). Junto al código, Ai2 publicó un informe técnico y una demostración interactiva.
Según Ai2, Olmo-core 3 está pensado para llevar el entrenamiento de MoE al rango del billón de parámetros sin perder eficiencia de cómputo. Es uno de los sistemas sobre los que se construye la próxima generación de Olmo, y la institución lo presenta como parte de su compromiso de abrir las herramientas y la infraestructura de entrenamiento detrás de cada modelo nuevo.
¿Qué problema intenta resolver?
Entrenar modelos grandes exige mucho cómputo, lo que sube los costos y el consumo de energía y deja el desarrollo de modelos avanzados fuera del alcance de muchos investigadores académicos y laboratorios chicos. Los MoE son una vía más eficiente. Pueden tener muchos más componentes aprendidos, o parámetros, sin que cada entrada tenga que usarlos todos.
El modelo completo, eso sí, igual tiene que guardarse en la memoria de las GPU y actualizarse durante el entrenamiento. Además, dirigir cada entrada hacia los expertos correctos (los componentes especializados dentro de un MoE) a lo largo de un clúster genera sus propios costos de comunicación y coordinación. A medida que el MoE crece, esos costos pueden comerse buena parte de la ventaja de usar solo una parte del modelo para cada entrada.
Olmo-core 3 apunta a cerrar esa brecha. En una de las pruebas, Ai2 subió el conjunto de expertos de 8 a 128 y siguió eligiendo solo cuatro expertos por token (las pequeñas unidades de texto que procesa un modelo de lenguaje). Así mantuvo los parámetros activos por token cerca de 3.200 millones. La capacidad total subió de 4.600 millones a 47.000 millones de parámetros, y el rendimiento de entrenamiento cayó menos de 5%.
La misma infraestructura se midió con más de un billón de parámetros totales.
Un sistema armado según cómo funcionan los MoE
Olmo-core cambió con cada generación de Olmo. El trabajo de Ai2 en modelos dispersos parte con OlmoE, que usaba una arquitectura MoE con 64 expertos enrutados. Olmo 3, en cambio, fue un modelo denso, o sea con casi todo el modelo activo para cada token, y su sistema de entrenamiento se construyó en torno a ese diseño. Olmo-core 3 agrega un sistema pensado para MoE mucho más grandes.
La implementación MoE anterior de Olmo-core usaba paralelismo de datos totalmente fragmentado (FSDP), configurado para reunir y volver a repartir los pesos del modelo en cada lote pequeño de datos. Olmo-core 3 pasa a un sistema basado en paralelismo de datos distribuido (DDP). Deja a los expertos residentes en las GPU y les envía los datos que corresponden, lo que evita reunir los pesos una y otra vez.
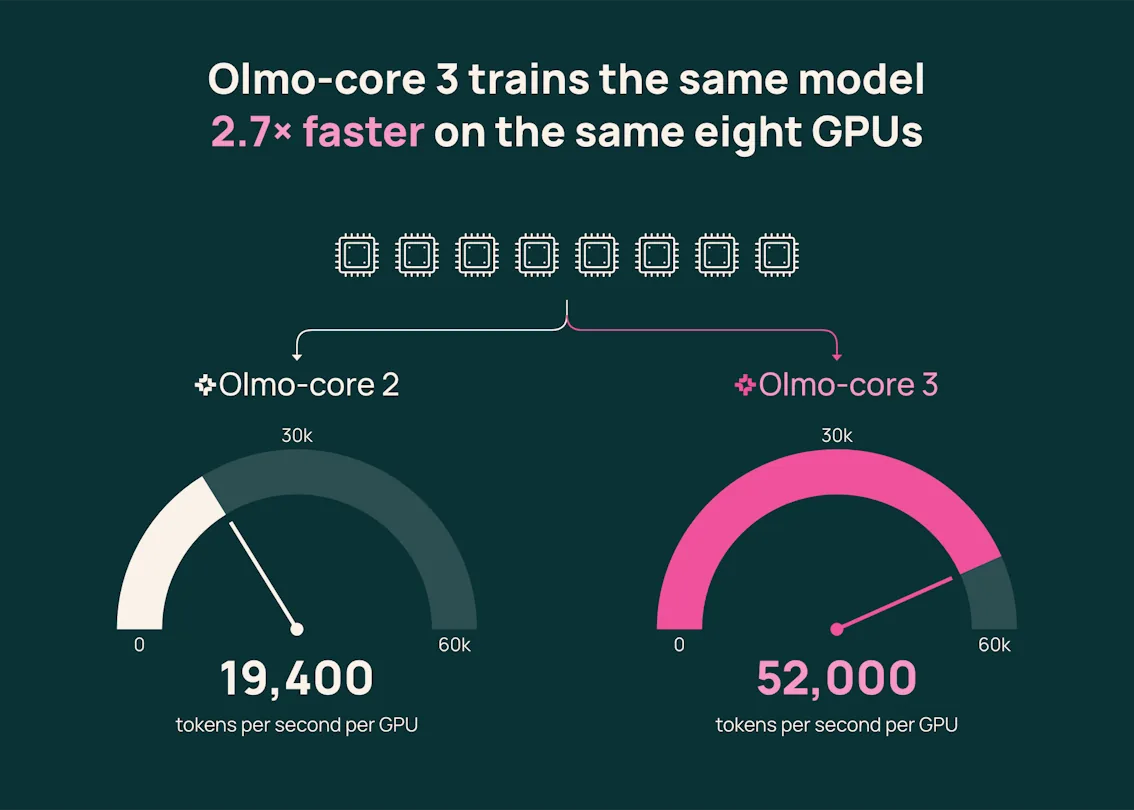
Ai2 reconoce que Megatron-Core, de NVIDIA, es una opción establecida para entrenar MoE grandes. Lo que trae Olmo-core 3 es un sistema MoE integrado al marco detrás de Olmo. En una prueba preliminar con ocho GPU NVIDIA B300, un MoE de 47.000 millones de parámetros procesó 52.000 tokens por segundo por GPU con el sistema nuevo, contra 19.400 con la implementación anterior. Son unas 2,7 veces más.
Cómo reparte el modelo entre GPU
Olmo-core 3 combina varias técnicas para distribuir MoE grandes en clústeres de GPU con optimizaciones que hacen más eficientes el enrutamiento y el cálculo. Tres técnicas deciden cómo se reparten el modelo y su estado de entrenamiento:
- Paralelismo de expertos. Distribuye los expertos entre las GPU, de modo que cada una guarda solo una parte del conjunto.
- Paralelismo de pipeline. Divide las capas del modelo (las etapas sucesivas que transforman una entrada) entre grupos de GPU, lo que reduce cuánto del modelo tiene que tener cada GPU en memoria.
- Optimizador distribuido. Reparte el estado del optimizador (los datos adicionales que se usan para calcular y aplicar las actualizaciones) entre las GPU, en vez de guardar una copia completa en cada una.
Juntas, estas técnicas permiten escalar un MoE sin que cada GPU cargue el modelo entero y su estado de entrenamiento.
Olmo-core 3 también baja el costo de enviar los datos a los expertos correctos y de ejecutar sus cálculos. El paralelismo de expertos por filas coloca los datos enrutados directamente en los búferes de entrada de cada experto, con lo que hay menos trabajo extra para reordenarlos. El enrutamiento residente en GPU mantiene los metadatos de enrutamiento en las GPU, así la CPU puede encolar trabajo sin esperar a que esa información se copie de vuelta. Y el GEMM agrupado junta muchos cálculos pequeños de expertos para que la GPU los ejecute de forma más eficiente.
¿Cuánto aporta MXFP8?
El marco soporta MXFP8, un formato numérico de menor precisión que representa algunos valores con menos bits. Eso puede reducir el cálculo y la cantidad de datos que se mueven entre GPU, siempre que el ahorro supere el costo de convertir entre formatos.
Ai2 midió el efecto de MXFP8 en el rendimiento de entrenamiento de punta a punta en una prueba controlada con cuatro GPU NVIDIA B300, con el trabajo repartido de forma uniforme entre expertos. Con MXFP8 activado en las partes del sistema donde más ayudaba, el rendimiento fue cerca de 21% mayor que con BF16, el formato de mayor precisión que usaron como base. La memoria activa máxima bajó de 103 GiB a 95 GiB. La mayor parte de la ganancia vino del cálculo de las capas feed-forward y del movimiento de datos entre expertos, no de la atención.
Ai2 advierte que estas técnicas tienen que funcionar en conjunto. Acelerar una parte del entrenamiento puede generar costos en otra. Un cálculo más rápido puede exigir más movimiento de datos, y mover menos bits puede no servir si convertir los datos toma demasiado tiempo. El sistema se diseñó en torno a esos compromisos y deja que los investigadores que usan el código abierto controlen cómo encajan las piezas.
La institución publicó un recorrido interactivo que muestra cómo el paralelismo de datos, de expertos y de pipeline trabajan juntos para escalar el entrenamiento, desde una sola GPU hasta muchas.
Pruebas en el rango del billón de parámetros
Ai2 midió Olmo-core 3 en varias configuraciones sobre GPU NVIDIA B300. Entre ellas, un modelo de 1,2 billones de parámetros con 58.360 millones activos por token, repartido en 512 GPU. Su mayor rendimiento observado fue de 858 TFLOP/s por GPU, una medida del cálculo útil del modelo por segundo en cada GPU. Estas pruebas usaron enrutamiento aleatorio para medir el desempeño del sistema, no la calidad de un modelo entrenado.
También probaron DeepEP v2, una forma alternativa de manejar la comunicación entre expertos repartidos en distintas GPU, y llegaron a una configuración de 2,38 billones de parámetros totales. Fue una prueba corta de capacidad y no un entrenamiento completo, así que muestra la escala que alcanza el sistema más que su rendimiento sostenido.
El informe técnico documenta además experimentos que guiaron cómo Ai2 entrena y mide sus MoE:
- Un puntaje pensado para incentivar un enrutamiento equilibrado podía mejorar mientras la carga real se desequilibraba. Ai2 bautizó esa falla como token gerrymandering.
- Bajar la tasa de aprendizaje de los expertos (el tamaño de sus actualizaciones) porque procesan menos tokens no mejoró los resultados en la familia de modelos que probaron.
- Los cálculos en GPU tomaron tiempos distintos cuando cambiaban los valores procesados, incluso con las mismas dimensiones de matriz. Por eso las comparaciones de rendimiento necesitan valores de entrada iguales, además de formas iguales.
- Superponer comunicación y cálculo en flujos separados de la GPU no siempre aceleró el entrenamiento. En algunas pruebas, lo hizo más lento.
El informe explica esos hallazgos junto con los enfoques que se probaron y se descartaron.
La base del próximo Olmo
La próxima generación de Olmo usará una arquitectura MoE. Ai2 dice que apunta a que sea su Olmo más capaz hasta ahora, entrenado con su conjunto de datos más grande y con su ventana de contexto más larga.
El código es abierto. Investigadores y desarrolladores pueden usar Olmo-core 3 para entrenar sus propios MoE, adaptarlo a otro hardware y experimentar con el enrutamiento, el paralelismo y otras partes del sistema. Los detalles de diseño, los experimentos y las ablaciones están en el informe técnico y en el repositorio de Olmo-core en GitHub.