¿Cómo puede un modelo de 30.000 millones de parámetros activar solo 3.000 millones por token y aun así aprovechar la capacidad del modelo completo? Nemotron 3.5 Lightning ilustra la respuesta. Usa una arquitectura de mezcla de expertos, o MoE, que selecciona apenas un subconjunto de sus parámetros para cada token.
Hoy dominan dos arquitecturas de modelo, la densa y la MoE. Cómo un modelo organiza sus parámetros importa tanto como cuántos tiene. La elección afecta el rendimiento de salida, el costo de memoria y la complejidad del servicio más de lo que lo hace el conteo bruto de parámetros. Por eso la decisión entre una y otra termina definida por las restricciones del despliegue.
La diferencia se parece a la de dos motores con la misma cilindrada total. Uno enciende todos sus cilindros en cada ciclo. El otro activa únicamente los que necesita.
¿En qué se diferencian un modelo denso y uno MoE?
En términos simples, densos y MoE se diferencian en cómo usan sus parámetros. Un modelo denso activa todos sus parámetros para cada token. Un modelo MoE almacena varias redes expertas y enruta cada token a través de un subconjunto elegido.
Los modelos densos suelen favorecer un despliegue más simple y predecible. Los MoE pueden entregar más capacidad y más rendimiento de salida cuando la memoria y la complejidad del servicio son manejables.
En qué cambian los parámetros
En un modelo denso, cada parámetro participa en cada pasada hacia adelante. Los 27.000 millones de parámetros de un modelo de 27B se disparan para cada token, a través de un único bloque compartido de red feed-forward (FFN) por cada capa del decodificador.
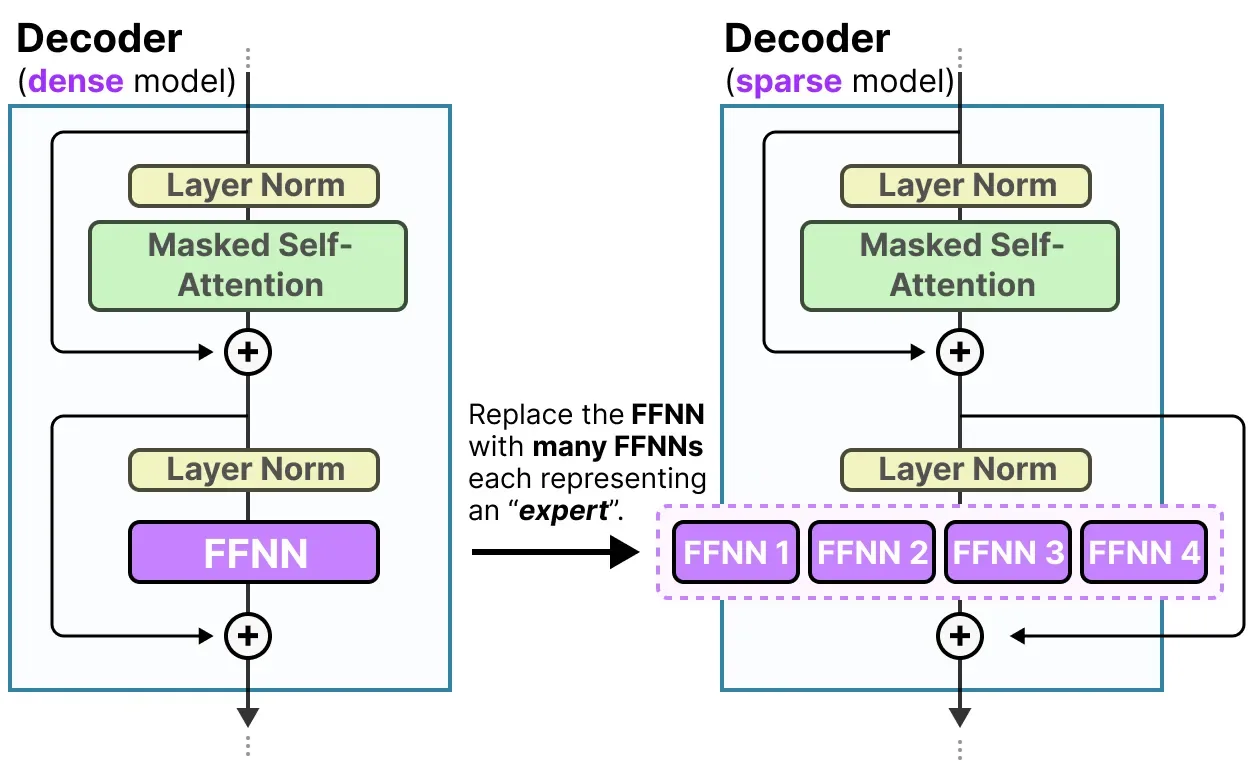
Un modelo MoE reemplaza esa FFN compartida por varios bloques FFN, que son los expertos. Mediante un proceso interno de enrutamiento, los tokens entrantes se procesan en un pequeño subconjunto de expertos en lugar de pasar por cada parámetro. Estructuralmente, dentro de cada capa del decodificador donde un modelo denso tendría una FFN, una capa MoE tiene varias, por ejemplo 8, 64 o 128. Una red de compuerta aprendida, habitualmente llamada router, se ubica delante de todas ellas y asigna cada token entrante a los k expertos con mejor puntaje. Los bloques FFN seleccionados son los que corren para ese token, mientras el resto se salta en esa capa en particular. La mayoría de los MoE modernos, como Mistral Small 4, además corren un experto "compartido" al que se enruta todo token sin importar la decisión del router.
Cómo funciona el enrutamiento
En los modelos MoE la decisión de ruteo se toma por separado en cada capa. Un token no se enruta a un experto y se queda ahí por el resto de los cálculos. En cada capa del decodificador se vuelve a enrutar según lo que ese token representa en ese punto de la red.
Estos expertos de cada capa no son expertos en el sentido tradicional de especializarse en una materia. Sus especializaciones viven sobre todo en patrones de sintaxis y de tipo de token, como la puntuación o los números, aunque eso varía según la arquitectura y los métodos de entrenamiento.
Mientras el mecanismo del router decide qué bloques FFN se saltan en cada capa de decodificación, los tokens siguen pasando por el mecanismo de atención completo, como siempre. Cuando la ficha de un modelo dice "3B de parámetros activos", esa cifra incluye tanto los pesos de atención y de embeddings para cada token como los pesos FFN seleccionados.
La variante híbrida con Mamba-2
También hay variantes dentro de MoE. Una de ellas es la que especifica la ficha de modelo de NVIDIA para Nemotron 3.5 Lightning, un híbrido de Mamba-2, MoE y atención. Las capas Mamba-2 reemplazan a la atención en la mayoría de las capas y cargan un estado recurrente de tamaño constante, en vez de una caché KV que crece. Eso cambia el perfil de memoria en contextos largos de una forma que la dispersión por sí sola no explica.
En lugar de tomar las decisiones de ruteo usando todo el ancho del modelo, Lightning las comprime primero en un espacio más pequeño, para que esa decisión le salga más barata. La figura 1 describe el caso general del transformer con MoE. Conviene tener presente que un modelo MoE es un tipo de modelo disperso.
¿Cuál es más rápido, el denso o el MoE?
Los modelos MoE suelen ser más rápidos en rendimiento de tokens, porque activan solo un subconjunto de los parámetros feed-forward para cada token. Los densos activan la red completa, a cambio de un servicio más simple y de una latencia más predecible.
Con alta concurrencia, el ruteo y el movimiento de memoria pueden estrechar la ventaja del MoE. Los resultados además dependen del hardware, la precisión, el framework de inferencia y el diseño del modelo. Nemotron 3.5 Lightning, por ejemplo, tiene capas Mamba-2 y decodificación especulativa.
Las diferencias de rendimiento que importan
La diferencia de rendimiento entre ambas arquitecturas se reduce a dos cosas. La primera, con el mismo conteo total de parámetros, los bloques FFN que se saltan hacen más rápido al MoE. La segunda, más determinante, es que el MoE desacopla la memoria, atada a los parámetros totales y a la VRAM que hay que alojar, del cómputo, atado a los parámetros activos y a los FLOPs por token.
En un modelo denso, los costos de alojamiento y de inferencia escalan juntos. El MoE rompe ese vínculo. Con MoE la VRAM se paga por adelantado. Cuando todos los expertos están cargados en memoria, el cómputo se paga por token y escala solo con los expertos que se encienden. Los expertos inactivos no cuestan nada de ejecución, aunque se siga pagando la memoria necesaria para almacenarlos. Ese traslado desde un cómputo variable por token hacia una memoria fija es el tradeoff principal.
Con tamaño de lote 1, la decodificación queda limitada por la memoria disponible antes que por el cómputo, y ahí el MoE rinde bien, porque lee menos bytes de pesos por token. A medida que el lote crece, los tokens en conjunto terminan usando la mayoría de los expertos de la red y esa ventaja se estrecha, aunque la reducción de trabajo por token se mantiene. El MoE conserva una ventaja de rendimiento a través de los distintos tamaños de lote, pero su margen de latencia frente a un modelo denso bien optimizado se comprime cuando sube la concurrencia.
Los frameworks de inferencia modernos manejan el ruteo sin descartar tokens, aunque todos los expertos deben vivir en la memoria de la GPU al mismo tiempo. Eso deja menos espacio para la caché KV del que tendría un modelo denso de tamaño comparable.
Dos modelos de 30B que no se parecen en nada
La tabla 1 del artículo original muestra una comparación directa. Con el mismo tamaño total de parámetros, la dispersión aparece con todas sus letras en el rendimiento de servicio. Gemma 4 31B y Nemotron 3.5 Lightning rondan ambos los 30B totales y, sin embargo, entre los distintos proveedores de GPU NVIDIA sus rangos de velocidad de salida ni siquiera se traslapan. Activar 3.000 millones de parámetros por token es una de las razones de fondo, aunque no la única. Las capas Mamba-2 de Lightning y su decodificación especulativa aportan por su cuenta, al margen de la arquitectura MoE híbrida.
Los tradeoffs de cada uno se pueden observar. Lightning entrega entre cuatro y cinco veces la velocidad de salida de Qwen3.8-27B a un catorceavo del precio, y puntúa menos de la mitad en capacidad general. Eso es lo correcto para una capa de ejecución agéntica que corre pasos bien especificados a volumen. Y es lo incorrecto donde una sola pasada dura de razonamiento decide el resultado.
¿Cuándo conviene un modelo denso y cuándo uno MoE?
A la hora de decidir cuál usar, todo depende de cuál sirve mejor al contexto del despliegue. Hay varios factores que considerar.
- Presupuesto de memoria. La huella de memoria sigue a los parámetros totales y no a los activos, así que un MoE de 30B y un denso de 30B necesitan ambos unos 60 GB. La pregunta real es qué se obtiene por esos gigabytes. El denso los convierte en capacidad y el MoE en rendimiento de salida.
- Concurrencia. El MoE gana con claridad para una sola petición. Su ventaja de rendimiento se sostiene a medida que escala la concurrencia, aunque la brecha de latencia se acorta. Si el despliegue es sensible a la latencia con alta concurrencia, conviene medir los dos antes de decidir.
- Planes de ajuste fino. El ajuste fino de un modelo denso es más simple, porque todos los parámetros se activan y los gradientes fluyen de manera uniforme. Un ajuste fino completo sobre un MoE puede desbalancear el router, que vuelve populares a unos expertos y elimina del todo a otros. Los enfoques LoRA y PEFT ayudan a evitarlo, igual que congelar el router sin más. La receta de ajuste fino supervisado de NeMo para Lightning lo maneja de forma correcta para ese modelo en particular.
- Cuantización. La razón de compresión no es donde vive la diferencia arquitectónica. En la práctica pesan más otras dos cosas. Primero, hay que revisar en qué precisión viene ya el checkpoint. Mistral Small 4 es FP8 de forma nativa, así que pasar a 4 bits compra otro 1,7x aproximado, de 121 GB a 71 GB, y no 4x. Segundo, las dos arquitecturas tienen módulos que se cuantizan mal, y no son los mismos. En un MoE el problema es el router, donde perturbaciones pequeñas dan vuelta decisiones de ruteo discretas. Las recetas mantienen el router, los embeddings y la cabeza de salida en precisión más alta. En los modelos de atención híbrida el problema son las proyecciones recurrentes, que también dan vuelta las decisiones de ruteo. Las versiones cuantizadas de Qwen3.8-27B dejan el bloque de atención lineal en BF16 exactamente por esa razón.
El tradeoff de fondo
Denso y MoE son dos respuestas a un mismo tradeoff, capacidad por parámetro contra cómputo por token. El denso mantiene todo simple y todo activo, lo que facilita el ajuste fino y el servicio. El MoE compra rendimiento con memoria, y lo paga en complejidad de servicio.
Nemotron 3.5 Lightning es completamente abierto, con pesos, datos y recetas, así que se puede adaptar a flujos propios y desplegar en cualquier parte. Está disponible para probar en build.nvidia.com y en OpenRouter, y los pesos se descargan desde Hugging Face y ModelScope.
Para cargas de IA física, NVIDIA menciona como opciones populares del ecosistema a AgiBot GO-1 y a Tencent Hy-Embodied-VLM-1.0.