Ingenieros de Meta reescribieron el kernel de Jagged Flash Attention (JFA), el mecanismo de atención detrás de su modelo generativo de anuncios GEM, para la GPU NVIDIA Blackwell B200. Lo hicieron con TLX (Triton Low-level Extensions), unas extensiones que agregan control explícito y consciente del hardware sobre el modelo de programación por bloques de alto nivel de Triton, según el detalle técnico que el equipo publicó en el blog de PyTorch.
La atención es el kernel más lento de GEM. Llegar al rendimiento máximo de Blackwell ha exigido tradicionalmente escribir a mano en CuteDSL o CUDA, algo lento de desarrollar y difícil de extender a variantes nuevas. Según Meta, TLX cierra esa brecha por los dos lados.
- Esfuerzo de desarrollo. El kernel de atención en TLX ocupa cerca de 3.200 líneas de código conciso a nivel de Triton, unas tres veces menos que las cerca de 10.000 líneas en CuteDSL de FlashAttention-4 (FA4), el estado del arte.
- Rendimiento. Supera a FA4 (versión de mayo de 2026) en las formas irregulares que le importan a GEM, por cerca de 13% en la pasada hacia adelante y cerca de 50% en la retropropagación.
Al quedarse en el modelo de alto nivel de Triton, el kernel es lo bastante accesible como para que lo lean, extiendan y fusionen ingenieros de modelado, no solo especialistas en kernels. Todas las mediciones se hicieron en bfloat16 sobre la B200 contra FA4. El código está publicado en GitHub.
¿Qué es la atención irregular y por qué importa en GEM?
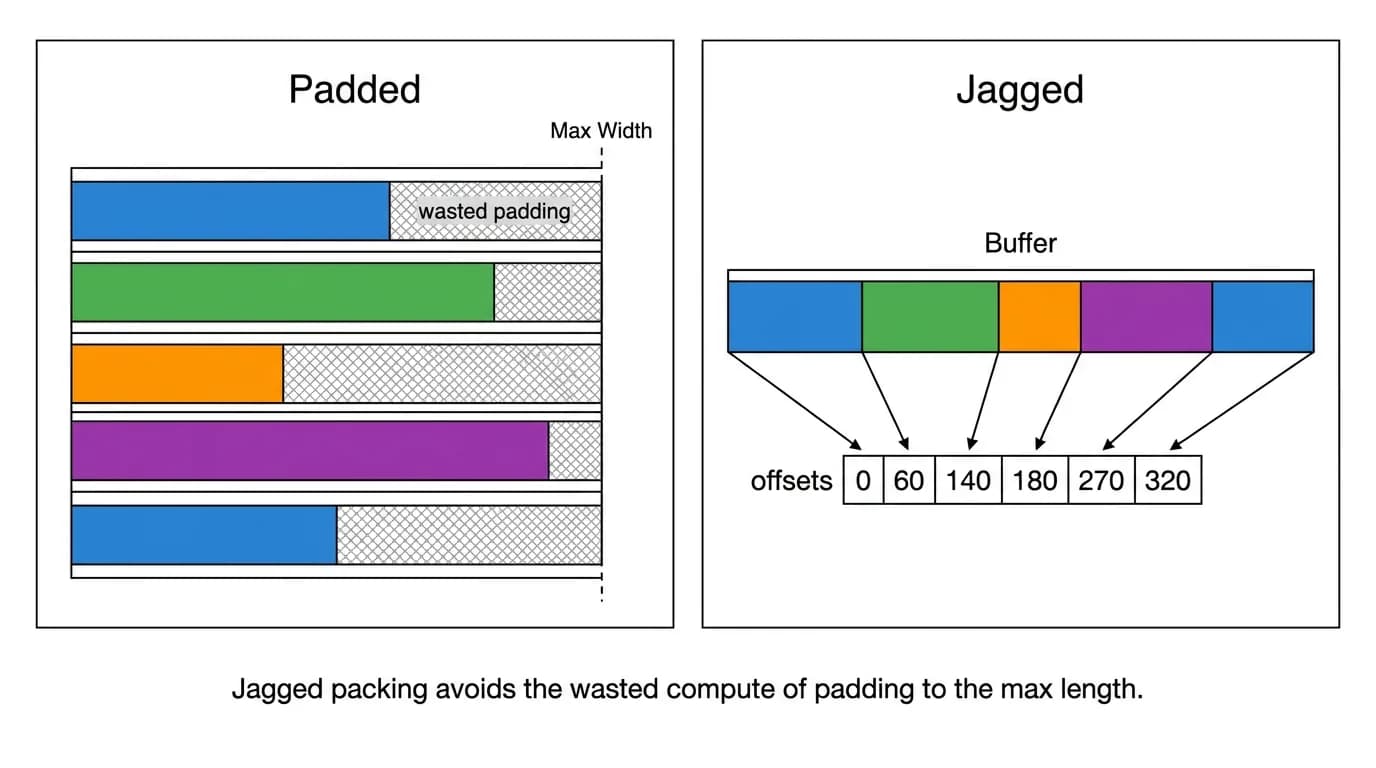
Los modelos de anuncios de Meta, entre ellos GEM y la arquitectura Kunlun, aplican atención sobre secuencias de usuario irregulares (jagged), es decir, de largo variable. Como explicó la empresa en su análisis del entrenamiento de GEM, rellenar esas secuencias hasta un largo fijo puede desperdiciar hasta el 50% del cómputo. GEM en cambio empaqueta las secuencias de forma contigua y anota los límites de cada una en un tensor de desplazamientos.
Jagged Flash Attention es el mecanismo a nivel de kernel que vuelve eficiente esa representación sin relleno. Aplica el algoritmo de FlashAttention directamente sobre los tensores Q, K y V empaquetados y sus desplazamientos, sin materializar nunca tokens de relleno.
Alcanzar el rendimiento máximo en Blackwell significa mantener los tensor cores alimentados todo el tiempo. Triton puro deja la mayoría de esas decisiones al compilador. TLX las expone como primitivas de primera clase, con asignación explícita de SMEM y TMEM, especialización de warps con async_task, barreras, TMA y MMA asíncronos, y CLC.
El desafío, rendimiento y facilidad de cambio a la vez
Optimizar la atención en Blackwell exige resolver dos problemas juntos. El primero es el rendimiento. La atención solo llega al máximo cuando las cargas desde memoria global, el softmax y las multiplicaciones de matrices se superponen de forma ajustada. El segundo es la velocidad de iteración. La atención es donde aterrizan las ideas nuevas de modelado (ventana deslizante, bloques dispersos y otras variantes), así que el kernel se edita seguido, y la vía del estado del arte es un kernel escrito a mano en CuteDSL o CUDA, difícil de leer, extender o fusionar.
El punto de partida fue un kernel JFA maduro basado en Triton. Era correcto en lo algorítmico, pero dejaba al compilador todo el movimiento de datos dentro del chip y la planificación. No había control sobre la asignación de memoria compartida ni la profundidad del pipeline, no había barreras explícitas ni especialización de warps, y un solo grupo homogéneo de warps hacía cargas, softmax y multiplicaciones a la vez, de modo que los tensor cores se detenían cada vez que ese grupo no estaba emitiendo una MMA.
El caso de producción, llamado broadcast-Q, condiciona además el diseño. Una sola Q densa se difunde a todas las secuencias del lote, así que su gradiente dQ debe sumarse a lo largo de todo el lote. Eso convierte el epílogo de dQ en una reducción entre programas con mucha contención, y varias de las optimizaciones existen para acelerarla.
Cambios estructurales
La especialización de warps, la gestión explícita de memoria compartida y de tensores y el pipeline con barreras son ingredientes estándar de cualquier kernel de atención de alto rendimiento para Blackwell. Lo que importa, según Meta, es que TLX permite expresarlos en código Triton de alto nivel y no en CuteDSL o CUDA escritos a mano.
En concreto, el equipo dividió cada CTA en tareas asíncronas con roles especializados. Hay warps dedicados a las cargas TMA, a las multiplicaciones en tensor cores, a las cuentas de softmax y corrección, y al guardado del epílogo, más un warp dedicado a la reducción de dQ en la retropropagación. Así los tensor cores reciben MMA una tras otra mientras el softmax corre en paralelo.
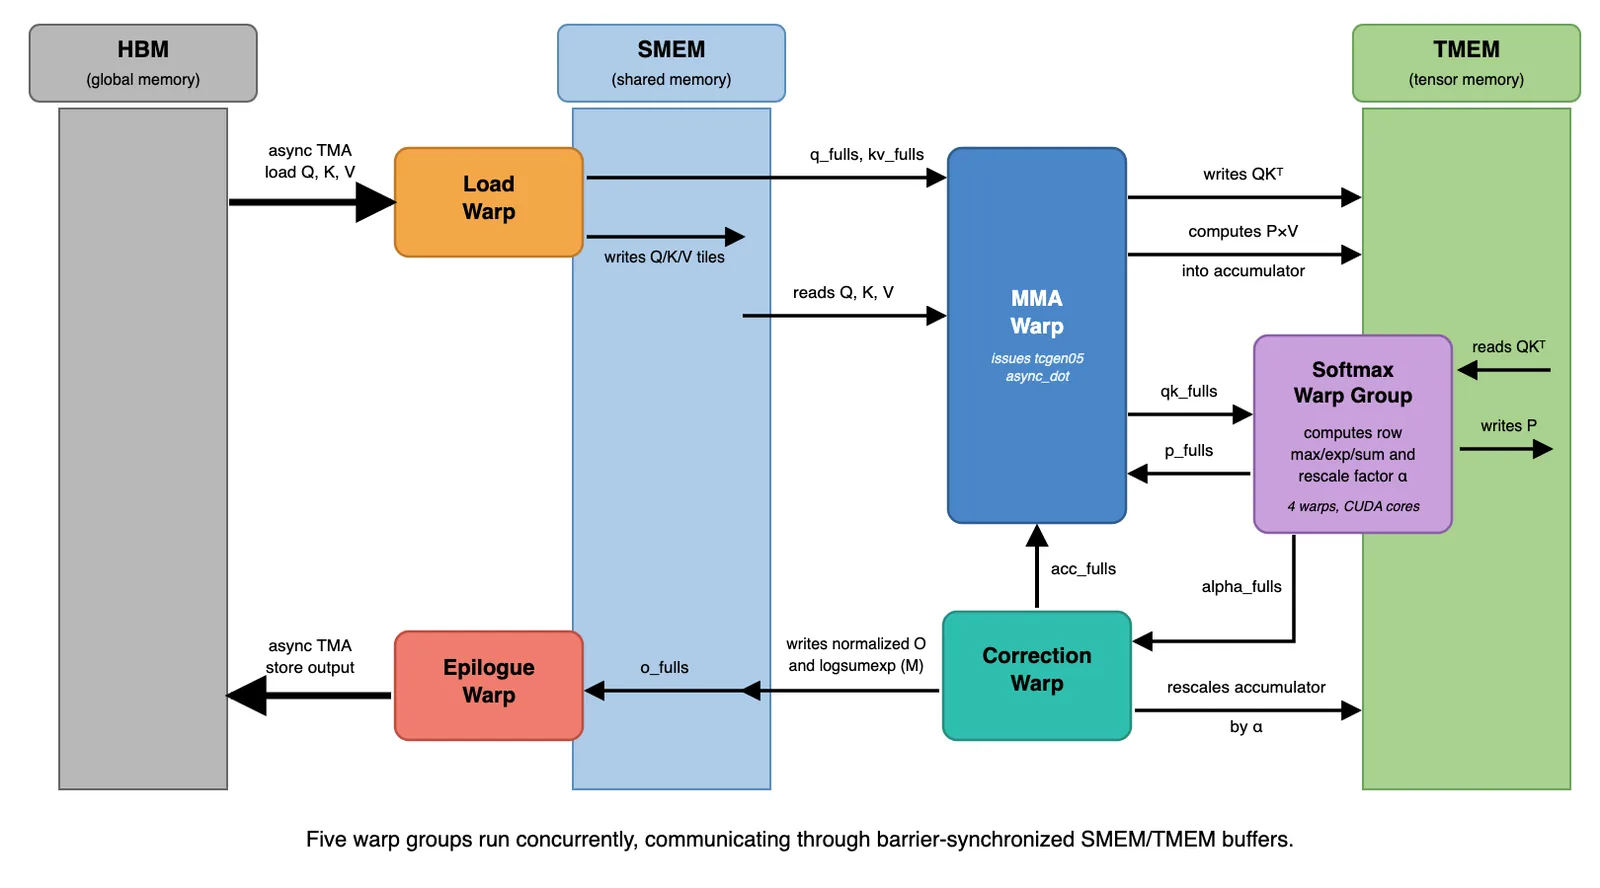
El mismo control explícito se extiende a la memoria y la planificación.
- Cada búfer dentro del chip se asigna a mano con su profundidad de pipeline, por ejemplo K y V con triple búfer para que el warp de carga vaya adelantado.
- Los búferes de TMEM con vidas que no se superponen comparten espacio. Los puntajes QK, P y las estadísticas del softmax usan una misma asignación, mientras el acumulador PV conserva la suya.
- Los datos pasan entre warps con barreras explícitas de productor y consumidor, para un pipeline determinista.
- Las dos pasadas son persistentes, con una CTA por SM que recorre los bloques en bucle.
Nada de esto se puede expresar en Triton puro, y la estructura persistente es la que deja espacio para tomar decisiones de planificación propias.
Las cinco optimizaciones
Con la estructura especializada y persistente en su lugar, lo que queda es eliminar las esperas y el trabajo desperdiciado que impiden que los tensor cores estén siempre ocupados. El equipo las encontró con un método constante. Usó NVIDIA Nsight Compute para leer contadores de hardware como la utilización de los tensor cores y del pipeline de TMEM, la ocupación de los SM y los desbordes de registros, los registros de ptxas para confirmar esos desbordes, y TritonBench en modo de medición con perfilador para comparar latencias antes y después. Algunas técnicas se tomaron de FA4 y otras salieron del análisis del propio kernel.
- Planificación de bloques irregulares entre SM. Balanceo de carga por software más Cluster Launch Control, para que todos los SM sigan ocupados pese a que los largos de las secuencias difieren en órdenes de magnitud.
- Preparación de dQ en varias etapas. Un pipeline de doble búfer en SMEM que oculta la suma con reducción de dQ, el principal cuello de botella de la retropropagación.
- Liberación anticipada de la memoria de tensores. Soltar el búfer de dQ en TMEM antes de sus últimos guardados permite que el warp de MMA empiece antes la multiplicación de dQ del bloque siguiente.
- Separación del bucle. Partir el bucle de KV en una pasada principal sin ramas y una cola pequeña con máscara elimina el costo de la máscara en cada iteración y los desbordes de registros que provoca.
- MMA colaborativa entre 2 CTA. Dos CTA cooperan en una sola multiplicación para subir la utilización de los tensor cores en la retropropagación, que es intensiva en multiplicaciones (técnica tomada de FA4).
¿Cómo se reparte el trabajo irregular entre los SM?
Las entradas irregulares generan un desbalance de carga fuerte. Con largos que varían en órdenes de magnitud, una asignación ingenua de bloques a SM deja algunos SM ociosos mientras otros procesan las secuencias largas. Un mapa de calor de ocupación de los SM lo muestra a simple vista, con unas pocas filas que siguen activas mucho después de que el resto quedó libre. Un rebalanceo completamente voraz es casi óptimo, pero no se puede vectorizar y dispara el costo de lanzamiento del lado del host.
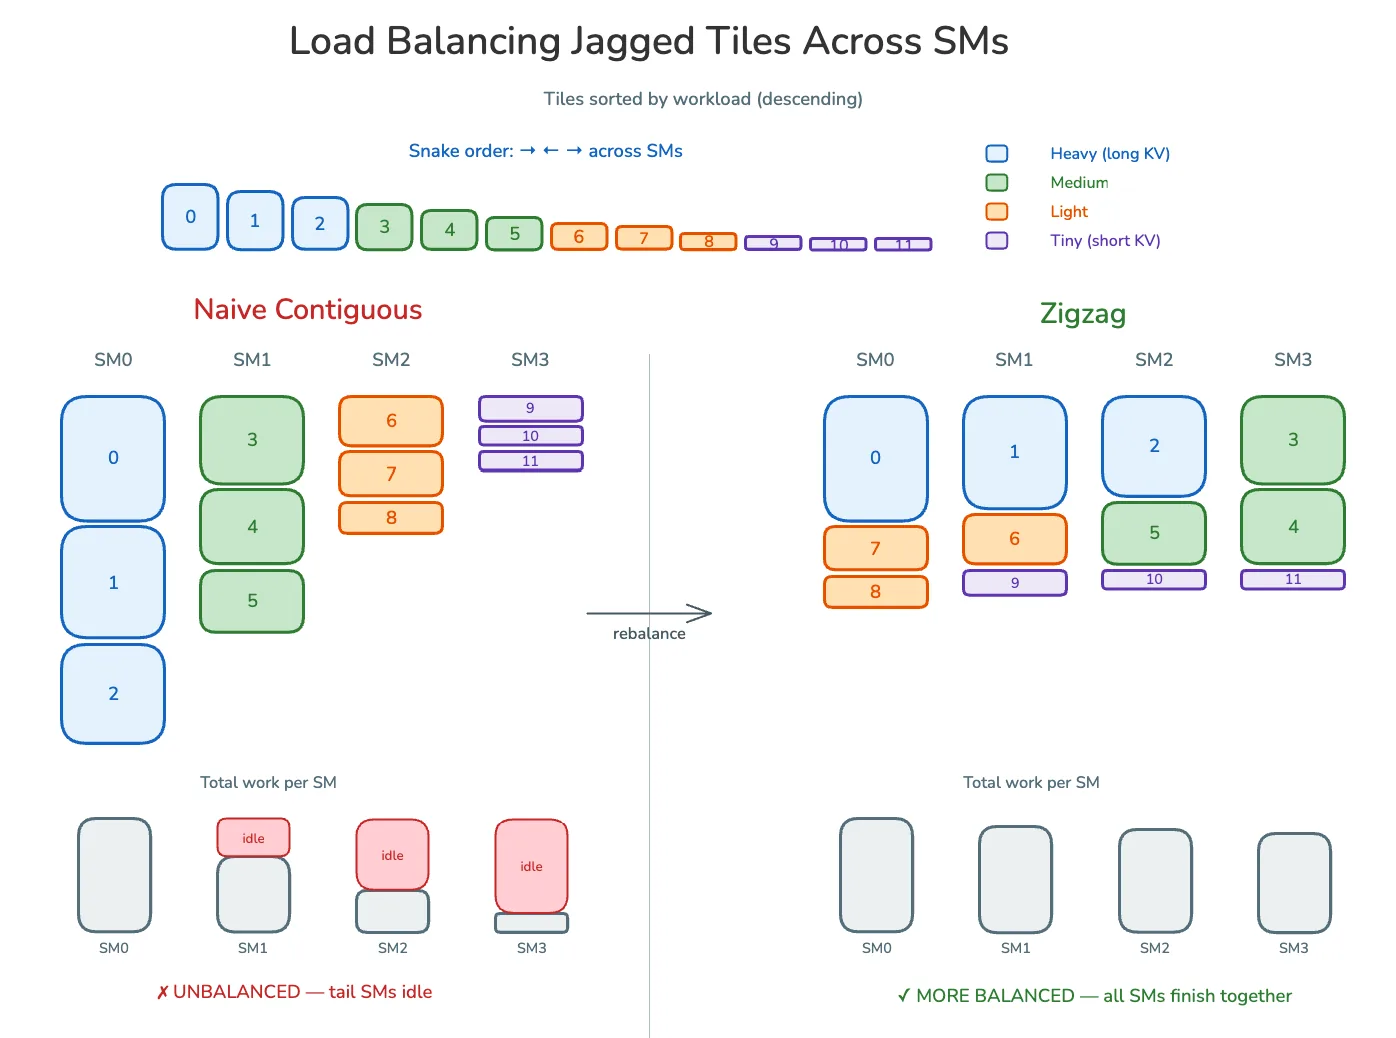
En la pasada hacia adelante, el bucle externo recorre la Q densa y el interno la K y V irregulares, así que el costo de cada bloque es proporcional al largo de las claves de su lote. La solución, propia del equipo para el caso irregular, es ordenar en el host todos los bloques por carga de KV, de mayor a menor, y repartirlos entre los SM en zigzag. Las pasadas pares llenan los SM de izquierda a derecha y las impares de derecha a izquierda, de modo que cada SM termina con una mezcla pareja de bloques largos y cortos a un costo de CPU despreciable. Esto recuperó cerca de un 20% en el kernel hacia adelante.
La retropropagación necesita otra estrategia. Su pasada de dK y dV recorre los bloques de K y V por fuera y la Q densa por dentro, así que ahora los bloques de K y V son las unidades de trabajo. Cada uno cuesta más o menos lo mismo, pero la cantidad por lote varía con el largo irregular de las claves. Ordenar por carga ya no ayuda. En cambio, el host precalcula la lista de bloques válidos (lote, cabeza, bloque de K y V) y los reparte en turno rotativo entre los SM, con un orden que deja el bloque como índice más interno para que bloques consecutivos reutilicen la misma K y V en la caché L2. La cantidad de bloques de cada cabeza se rellena hasta un múltiplo del tamaño del clúster para la ruta de 2 CTA.
El balanceo estático cubre el desbalance que se puede predecir. La variación que solo aparece en ejecución la maneja en forma dinámica Cluster Launch Control (CLC), una función de Blackwell que entrega el índice del siguiente bloque a pedido. El SM que termine primero toma el siguiente trabajo y ninguna secuencia larga frena toda la grilla.
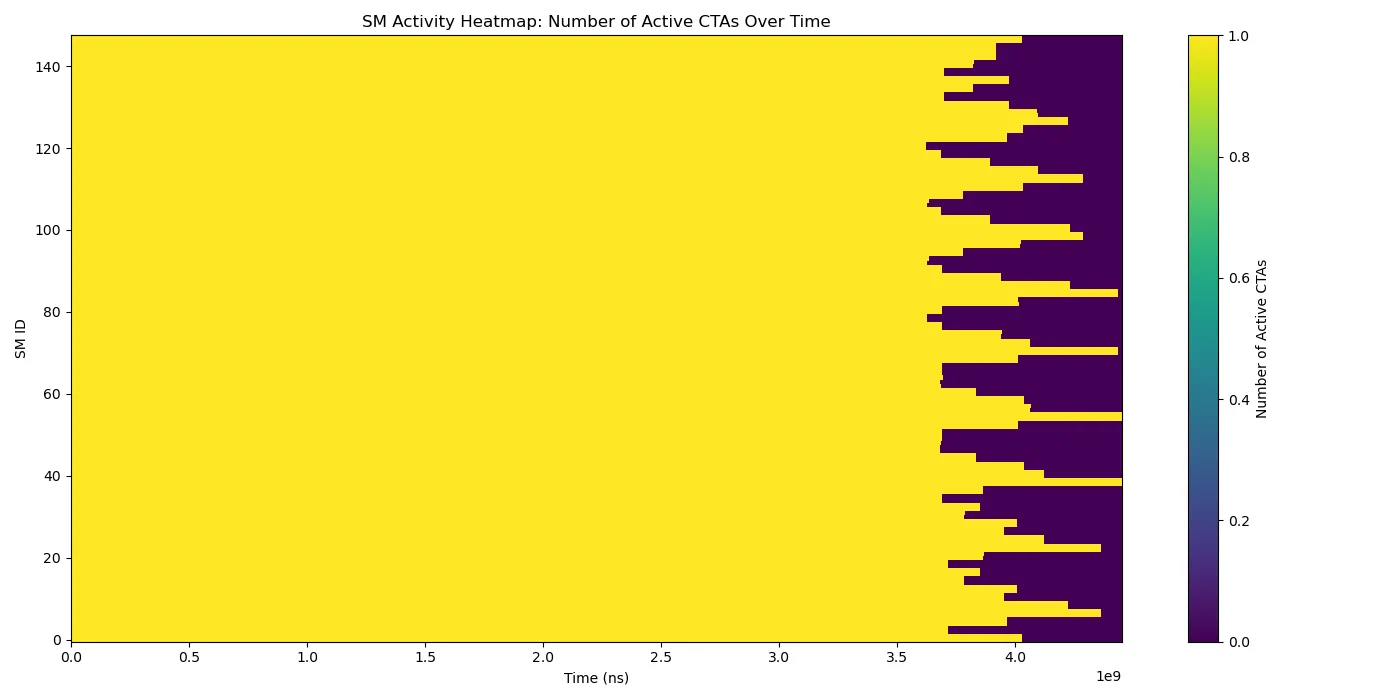
Carga de trabajo de las CTA sin CLC.
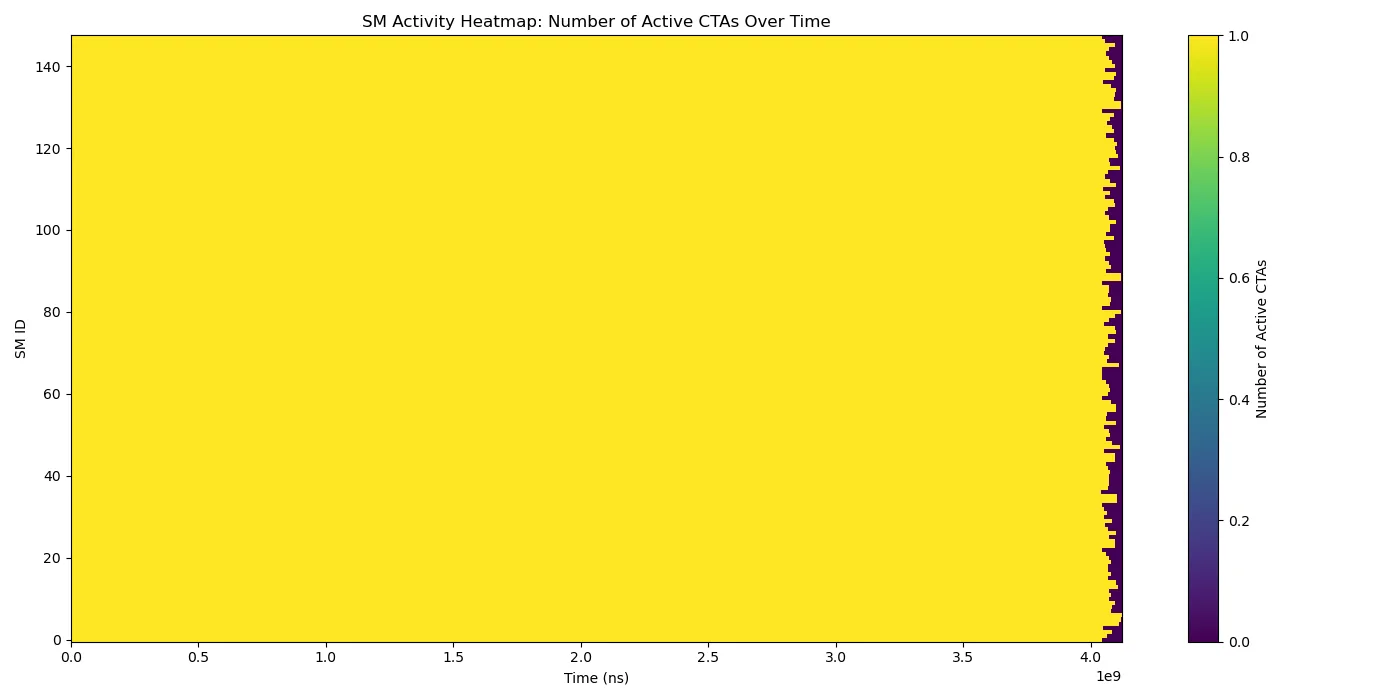
Carga de trabajo de las CTA con CLC.
CLC se aplica tanto al kernel hacia adelante como al de retropropagación. En TLX es un protocolo liviano de productor y consumidor sobre un contexto de planificación compartido.
El balanceo por software y CLC pueden parecer redundantes, porque ambos reparten trabajo entre los SM, pero se complementan. CLC planifica en forma dinámica y no sabe qué bloques están vacíos, así que con entradas irregulares, y sobre todo dispersas, sigue gastando ciclos en repartir los bloques vacíos que introduce el relleno. El precálculo de bloques válidos en el host los descarta de antemano. Por eso el balanceo por software sigue sirviendo incluso en un kernel con CLC.
El cuello de botella de dQ
El análisis de barreras de la retropropagación señaló al epílogo de dQ como el principal cuello de botella. Su suma con reducción hacia la HBM explicaba entre 9% y 11% de la utilización perdida de los tensor cores, la brecha accionable más grande.
Dos factores lo hacen lento. Primero, como dQ se suma a lo largo de todo el lote, cada SM emite sumas con reducción sobre las mismas posiciones de dQ, con mucha contención. Segundo, la API de alto nivel para esa operación las serializa. La suma de cada franja de columnas debe terminar antes de que empiece la siguiente, sin pipeline.
La solución del equipo fue hacer explícita la etapa de preparación y darle doble búfer, de modo que la suma con reducción de una franja hacia la HBM se superponga con la copia de la franja siguiente desde la TMEM y siempre haya un guardado en curso.