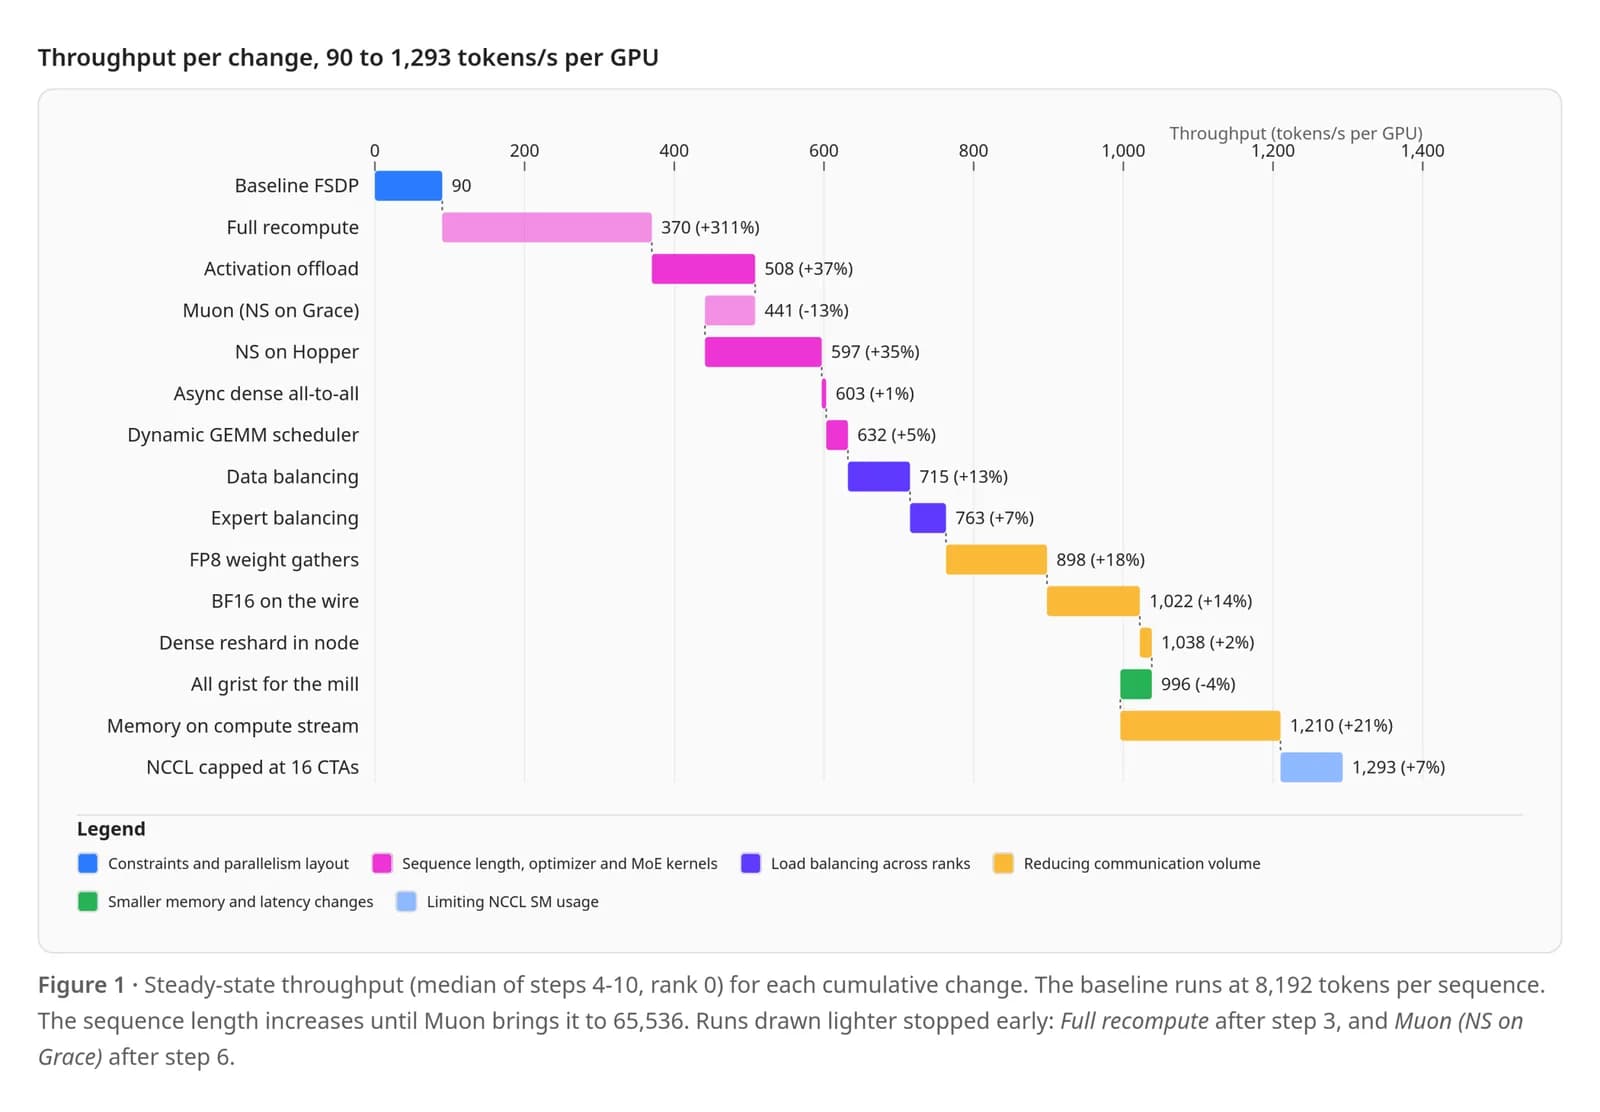
Escalar el preentrenamiento de un modelo Mixture-of-Experts (MoE) de cerca de un billón de parámetros sobre infraestructura pública y compartida se consideraba inviable, por cuellos de botella propios de la arquitectura y de la interconexión. El consorcio EUROPA lo logró en JUPITER usando la flexibilidad de PyTorch y TorchTitan. Subió el rendimiento de 90 a cerca de 1.300 tokens por segundo por GPU, sobre 384 GPU NVIDIA GH200 por réplica de paralelismo de datos (96 nodos), dentro del EuroHPC Frontier AI Grand Challenge. El equipo lo contó en el blog de PyTorch.
El EuroHPC Frontier AI Grand Challenge se diseñó para demostrar que una IA soberana y de código abierto puede competir en la frontera con recursos públicos compartidos. En ese proceso, el consorcio EUROPA, formado por Domyn y los institutos Fraunhofer IAIS e IIS, fue seleccionado para desarrollar un modelo MoE europeo abierto de al menos 400.000 millones de parámetros, compatible con las 24 lenguas oficiales de la Unión Europea y en cumplimiento estricto de la Ley de IA de la UE.
El texto describe cómo escalaron el preentrenamiento a un MoE de un billón de parámetros en JUPITER, el supercomputador de exaescala de EuroHPC alojado en el Forschungszentrum Jülich.
Los modelos de este tamaño suelen entrenarse en clústeres que sus desarrolladores operan o arriendan para uso exclusivo. JUPITER, en cambio, es infraestructura de investigación financiada con fondos públicos y compartida por cientos de proyectos. Además se diseñó para la investigación científica en general, lo que llevó a decisiones de arquitectura poco habituales en el mundo de la IA. Llegar al billón de parámetros con un rendimiento viable exigió optimizaciones que van más allá de las técnicas distribuidas estándar.
Para tener la flexibilidad necesaria y ajustar fino el preentrenamiento, el equipo eligió PyTorch y TorchTitan. En esas condiciones subieron el rendimiento de 90 a unos 1.300 tokens por segundo por GPU en 384 GH200 (96 nodos). Los hitos principales se apoyan en el diseño de TorchTitan y terminaron como aportes a TorchTitan y a PyTorch:
- Ubicación con FlexShard para el optimizador Muon, que elimina la mayor parte de su comunicación.
- Descarga de los checkpoints de activaciones a la CPU Grace.
- Ejecutar la preparación del all-gather de FSDP en el stream de cómputo (
unshard_async_op), lo que libera unos 14 GiB de HBM por GPU.
El informe completo detalla el resto de los cambios, con figuras interactivas y trazas del perfilador.
La máquina y sus límites
Cada nodo Booster de JUPITER tiene cuatro superchips NVIDIA GH200 Grace Hopper. Cada superchip une una GPU Hopper (96 GB de HBM3) con una CPU Grace de 72 núcleos (120 GB de LPDDR5X), conectadas por un enlace NVLink-C2C de 900 GB/s. Las GPU de un nodo se comunican por NVLink 4 a 150 GB/s por dirección, y cada nodo tiene cuatro adaptadores InfiniBand NDR200, cerca de 25 GB/s por GPU.
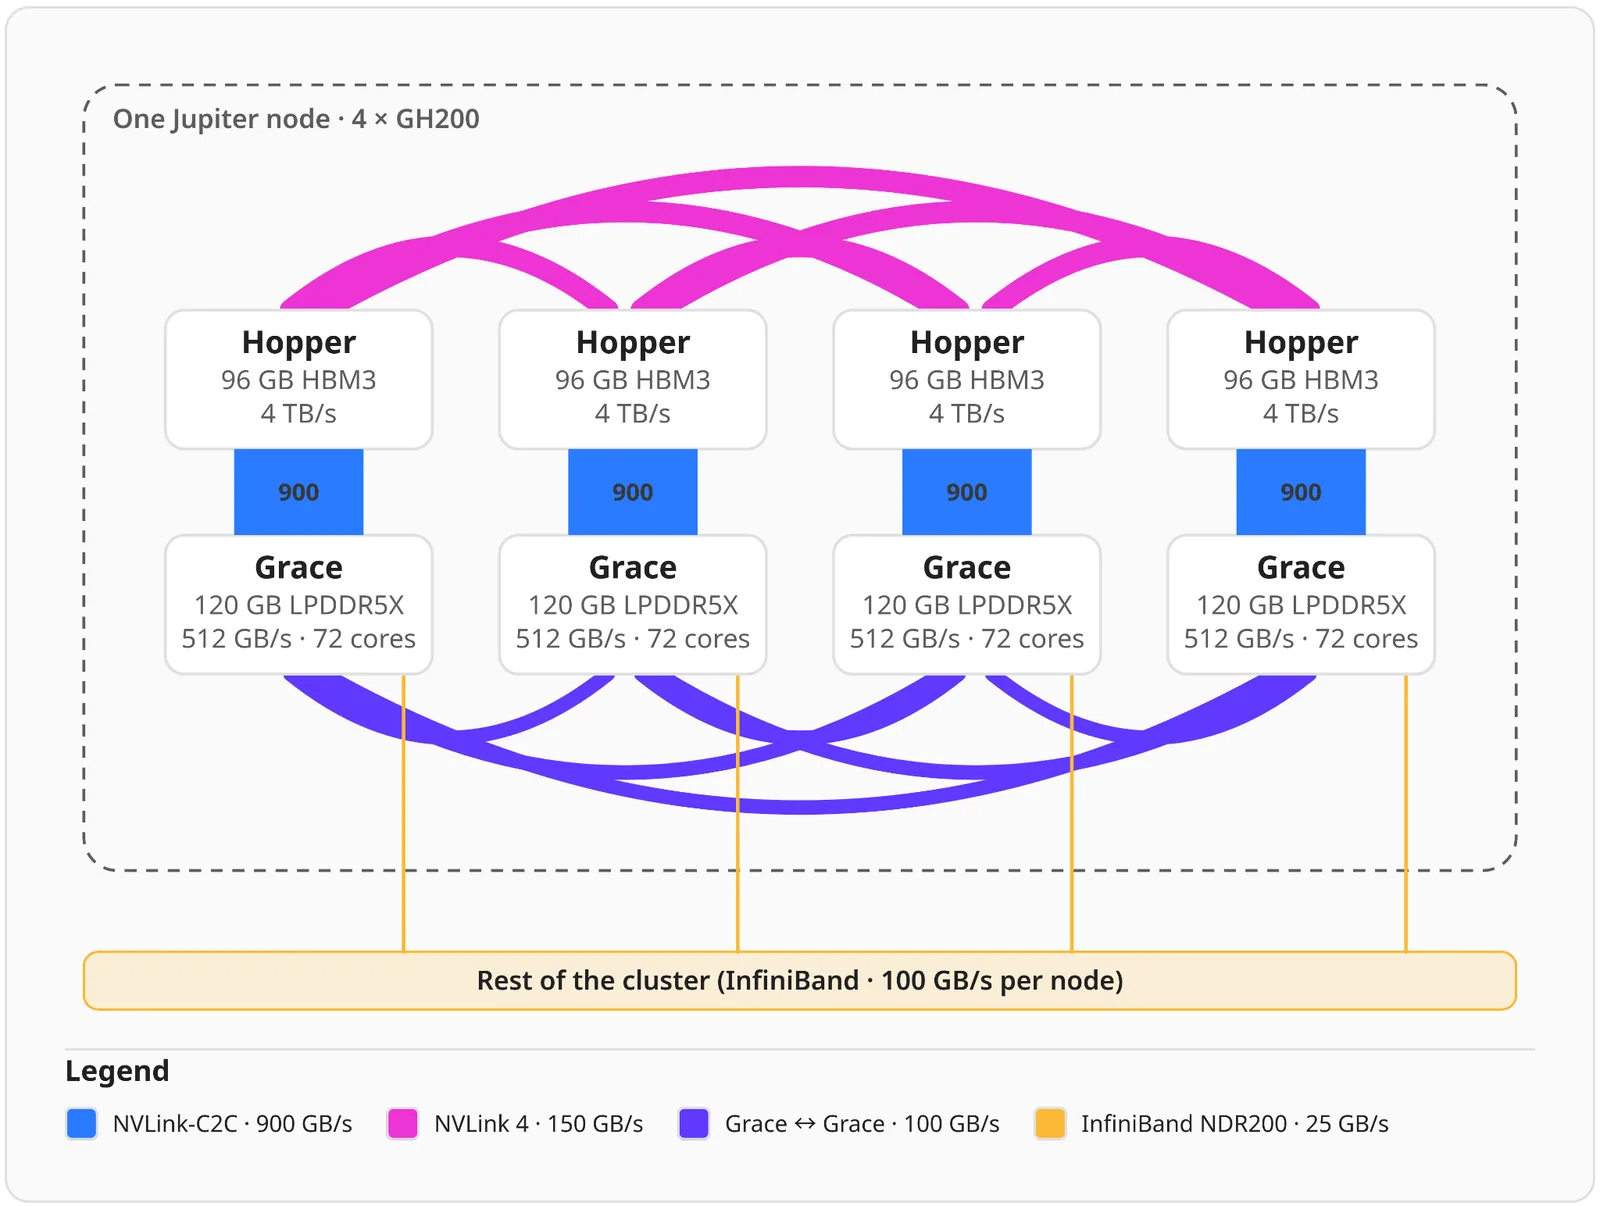
Figura 2. Anchos de banda dentro de un nodo de JUPITER, dibujados a escala. Todo el tráfico entre nodos sale por los delgados enlaces InfiniBand.
Además de los aceleradores, dos partes del sistema pesan en el diseño:
- Ancho de banda entre nodos. InfiniBand es 36 veces más lento que el enlace entre una GPU y su propia CPU, y repartir un modelo de un billón de parámetros entre cientos de aceleradores obliga a cruzar ese límite todo el tiempo durante el entrenamiento. El tráfico por InfiniBand tiene que solaparse de forma agresiva con el cómputo.
- Capacidad de memoria del host. El GH200 existe con hasta 480 GB de LPDDR5X por Grace, pero los nodos de cómputo de JUPITER usan la configuración de 120 GB (los nodos de acceso traen 480 GB), que privilegia el ancho de banda sobre la capacidad. Descontando lo que usa el kernel quedan unos 108 GiB utilizables por GPU, y en la práctica el equipo vio nodos que arrancaban trabajos con mucho menos. Eso limita cuánto estado se puede sacar de la HBM.
Esos límites definen el esquema de paralelismo. Se usó FSDP de 384 vías con paralelismo de expertos de 4 vías dentro de cada nodo y sin paralelismo de pipeline. El all-to-all de tokens del MoE es difícil de solapar, así que se dejó sobre NVLink. Sin paralelismo de pipeline los pasos tienden a ser más cortos, lo que da retroalimentación rápida a escala, y los costos fijos se amortizan con un lote grande de 384 secuencias de 65.536 tokens (unos 25 millones de tokens por paso).
FSDP ya solapa la recolección de la capa n+1 con el cómputo de la capa n, así que la mayor parte del trabajo restante fue hacer que ese solapamiento fuera efectivo. Lo lograron en tres frentes. Pasaron a secuencias más largas para computar más tiempo, redujeron los bytes enviados por InfiniBand y usaron la memoria de Grace para tener capacidad total suficiente para el modelo, los gradientes y el estado del optimizador.
FlexShard, Muon sin comunicación
El equipo usa Muon para todas las matrices de pesos salvo el enrutador y los embeddings (cerca del 99,5% de los parámetros) y AdamW para el resto. Muon necesita un estado fp32 por parámetro, mientras que Adam necesita dos. Eliminar ese segundo estado fue determinante para que una secuencia de 65.536 tokens cupiera en memoria.
Muon ortogonaliza cada actualización con unas pocas iteraciones de Newton-Schulz, que operan sobre la matriz completa. Como FSDP divide cada matriz en 384 fragmentos, una implementación simple junta cada matriz en un solo rango, corre Newton-Schulz ahí y reparte el resultado de vuelta. Sobre esta interconexión, esa comunicación sale demasiado cara.
FlexShard, que ya es parte de TorchTitan, permite decidir qué rango es dueño de qué parámetros. Los expertos se fragmentaron por experto completo, así que cada rango es dueño de matrices de expertos enteras y corre sus iteraciones de Newton-Schulz sin ninguna comunicación. Las matrices densas, como las proyecciones de atención, se siguen juntando en un rango dueño, y cada rango procesa sus propios expertos mientras las matrices densas viajan, de modo que esa comunicación queda solapada.
Con la descarga a CPU de FSDP, el optimizador corre en Grace, donde están guardados los parámetros, y Newton-Schulz sobre 72 núcleos Arm toma unos 35 segundos por paso. El equipo aportó a TorchTitan soporte para correr Newton-Schulz en la GPU mientras los parámetros siguen descargados. El paso del optimizador bajó de 41,7 a 2,2 segundos, y el rendimiento subió de 441 a 597 tokens por segundo por GPU (+35%).
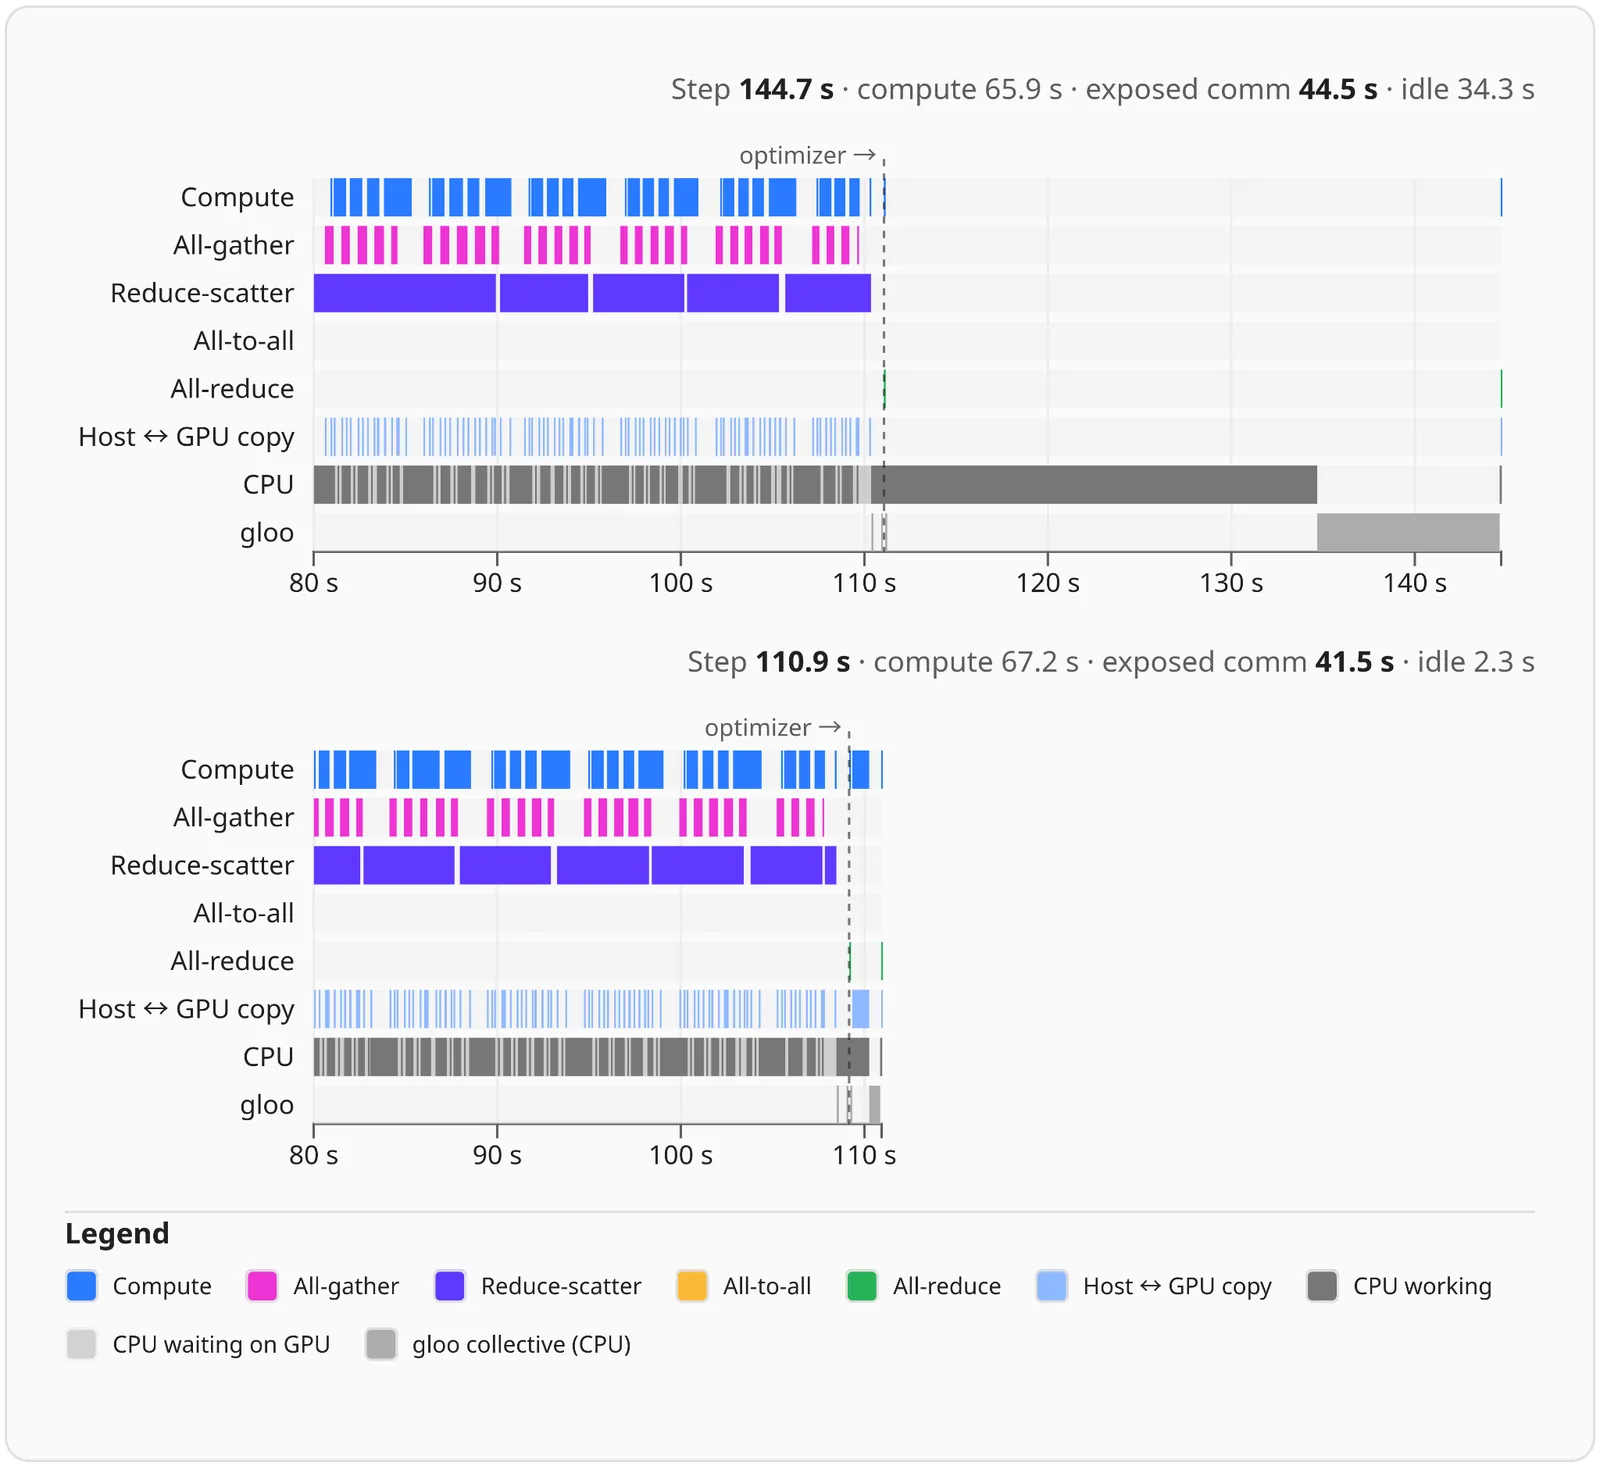
Figura 3. Paso perfilado del rango 0 desde el segundo 80. Arriba, Newton-Schulz en Grace, con la GPU ociosa unos 34 segundos después del paso hacia atrás mientras computa la CPU. Abajo, Newton-Schulz en Hopper, donde el optimizador ocupa una fracción pequeña del paso.
Descarga de activaciones a Grace
En este esquema, el volumen de pesos recolectados por capa no depende de la cantidad de tokens, así que una secuencia más larga aumenta el tiempo de cómputo sin afectar la comunicación. Primero se guardaron las activaciones solo en los bordes de cada capa y se recomputó todo lo interno durante el paso hacia atrás. En TorchTitan eso se llama FullAC. Como la GPU pasaba ociosa la mayor parte del paso de base, el cómputo extra no lo alargó, y el rendimiento pasó de 90 a 370 tokens por segundo por GPU con 32.768 tokens.
Con 65.536 tokens, las activaciones de borde ocupan por sí solas 74 capas × 65.536 tokens × 6.144 × 2 bytes, cerca de 55 GiB por GPU, que no caben en la HBM junto a los pesos. El GH200 tiene un enlace de 900 GB/s a 120 GB de memoria de CPU, así que se decidió descargarlas. Cada activación de borde se copia a Grace después de que el paso hacia adelante la produce, y vuelve a Hopper una capa antes de que el paso hacia atrás la recompute. Un parámetro de descarga fija qué proporción de capas se descarga, lo que cambia HBM por memoria de Grace.
El envoltorio de activation checkpointing de TorchTitan hizo cómodo este cambio. El equipo aportó a TorchTitan los hooks para descargar los checkpoints de activaciones y construyó su estrategia de descarga sobre ellos. Con la descarga, el rendimiento subió de 370 a 508 tokens por segundo por GPU (+37%), y el largo de secuencia creció a 49.152 tokens y luego, con Muon, a 65.536.
Figura 4. Calendario de descarga, dibujado con 16 capas en lugar de 74. En el paso hacia adelante cada activación de borde se mueve a Grace. En el paso hacia atrás vuelve a la HBM una capa antes de recomputarse.
Desfragmentar los streams de FSDP
Después de actualizar el software, el asignador con caché de CUDA empezó a reintentar asignaciones en todos los rangos con cerca de 70% de uso de memoria. En el momento de los reintentos había entre 25 y 30 GiB de HBM libres, pero el asignador no podía usarlos.
La causa estaba en cómo FSDP solapa la comunicación con el cómputo. FSDP usa un stream de cómputo y cuatro streams laterales, y el asignador mantiene un grupo de memoria separado por cada stream. La memoria que libera un stream solo la puede reutilizar ese mismo stream. FSDP asigna cada búfer en el stream que lo escribe, y otras optimizaciones de comunicación del equipo asignaban búferes temporales dentro de las llamadas de FSDP, así que también terminaban en streams laterales.
Al reproducir el registro de eventos del asignador en el pico de memoria, los streams laterales retenían 27,3 GiB, de los que solo 6,4 GiB estaban en uso. Los 20,9 GiB restantes quedaban fuera del alcance del stream de cómputo, que entonces no encontraba un bloque de 4 GiB para un búfer del MoE.
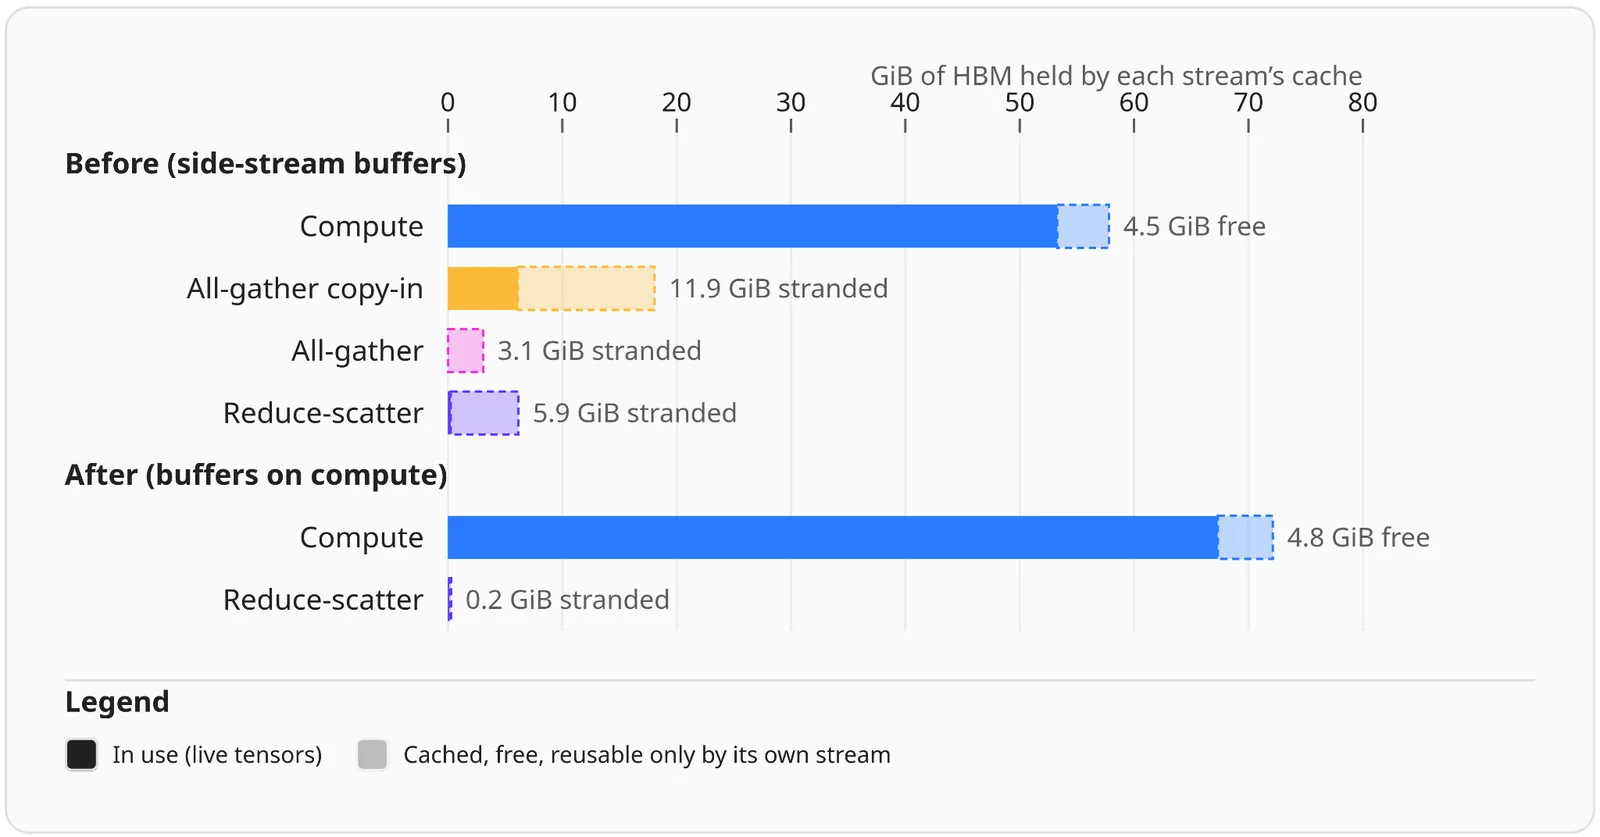
Figura 5. HBM retenida por la caché de cada stream del asignador en el pico de memoria viva, reconstruida desde la traza de eventos del rango 0. Las barras sólidas son tensores vivos y las punteadas, memoria en caché que solo puede reutilizar el stream dueño.
FSDP2 tiene un indicador privado, unshard_async_op, que corre la preparación del all-gather en el stream de cómputo y deja que NCCL trabaje en su stream interno. Así los búferes de recolección se asignan desde el grupo del stream de cómputo y vuelven a él. El equipo adaptó su recolección propia para que corriera de forma asíncrona, de modo que el stream de cómputo espera a la red solo cuando necesita los pesos.
Con eso, los rangos con reintentos del asignador bajaron de 384 a cero. La memoria reservada en el pico pasó de 88,1 a 74,6 GiB, y el rendimiento subió de 996 a 1.210 tokens por segundo por GPU.
El equipo propuso una opción en TorchTitan para activar ese indicador. Tras la revisión, unshard_async_op está pasando a una API pública de FSDP (PyTorch #202343), para que otros usuarios de FSDP puedan apoyarse en ella.
Aportes de vuelta a PyTorch
Según el consorcio, esta configuración permite escalar preentrenamientos a un billón de parámetros con un rendimiento útil sobre infraestructura pública europea. Para que otros puedan reproducir los resultados (hay más detalles en un artículo complementario), el equipo subió todos los arreglos a PyTorch y TorchTitan.