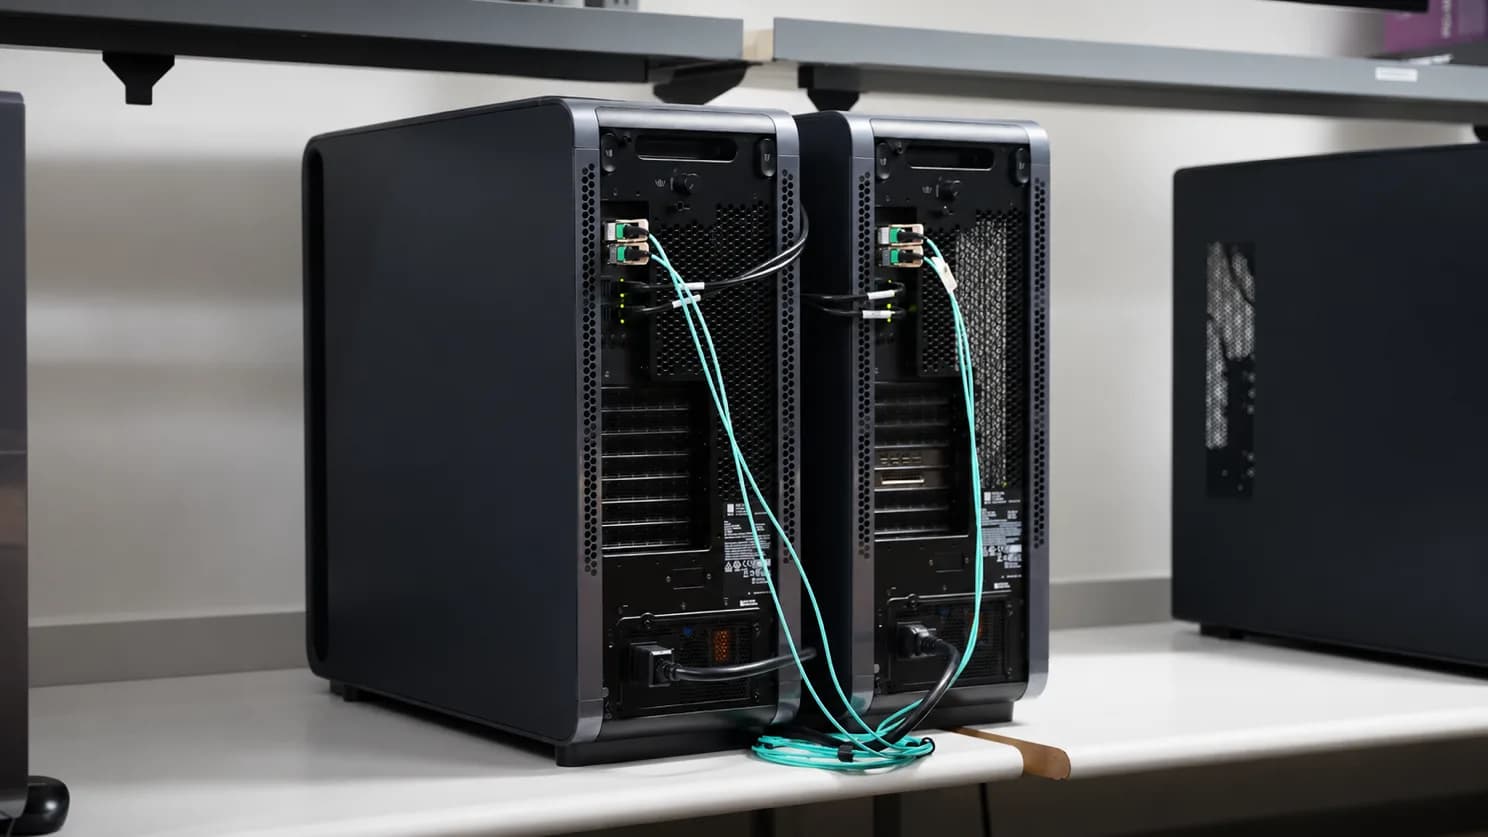
Correr localmente un modelo de escala de frontera obliga a mantener todos sus pesos en la memoria de la GPU, y los modelos más grandes ya no caben en una sola máquina. NVIDIA explicó en su blog para desarrolladores cómo dos DGX Station conectadas por ConnectX-8 RDMA sirven un mismo modelo a través de un solo endpoint, con paralelismo de tensores que reparte los pesos y el cómputo entre las dos GPU.
El modelo GLM-5.3 NVFP4 es una versión cuantizada por NVIDIA del modelo mixture-of-experts (MoE) de Z.ai. Tiene 753.000 millones de parámetros, de los que 40.000 millones se activan por token. La activación dispersa reduce el cómputo, pero todos los pesos tienen que seguir disponibles, porque cada token puede enrutarse a expertos distintos. Con unos 464 GB, el checkpoint supera los 252 GB de HBM3e de una sola GPU GB300. El tutorial usa dos DGX Station para mantener los pesos en memoria de GPU, con la descarga de pesos a la CPU desactivada.
Antes de empezar hay que conectar las dos Station con la guía Connect Two DGX Stations.
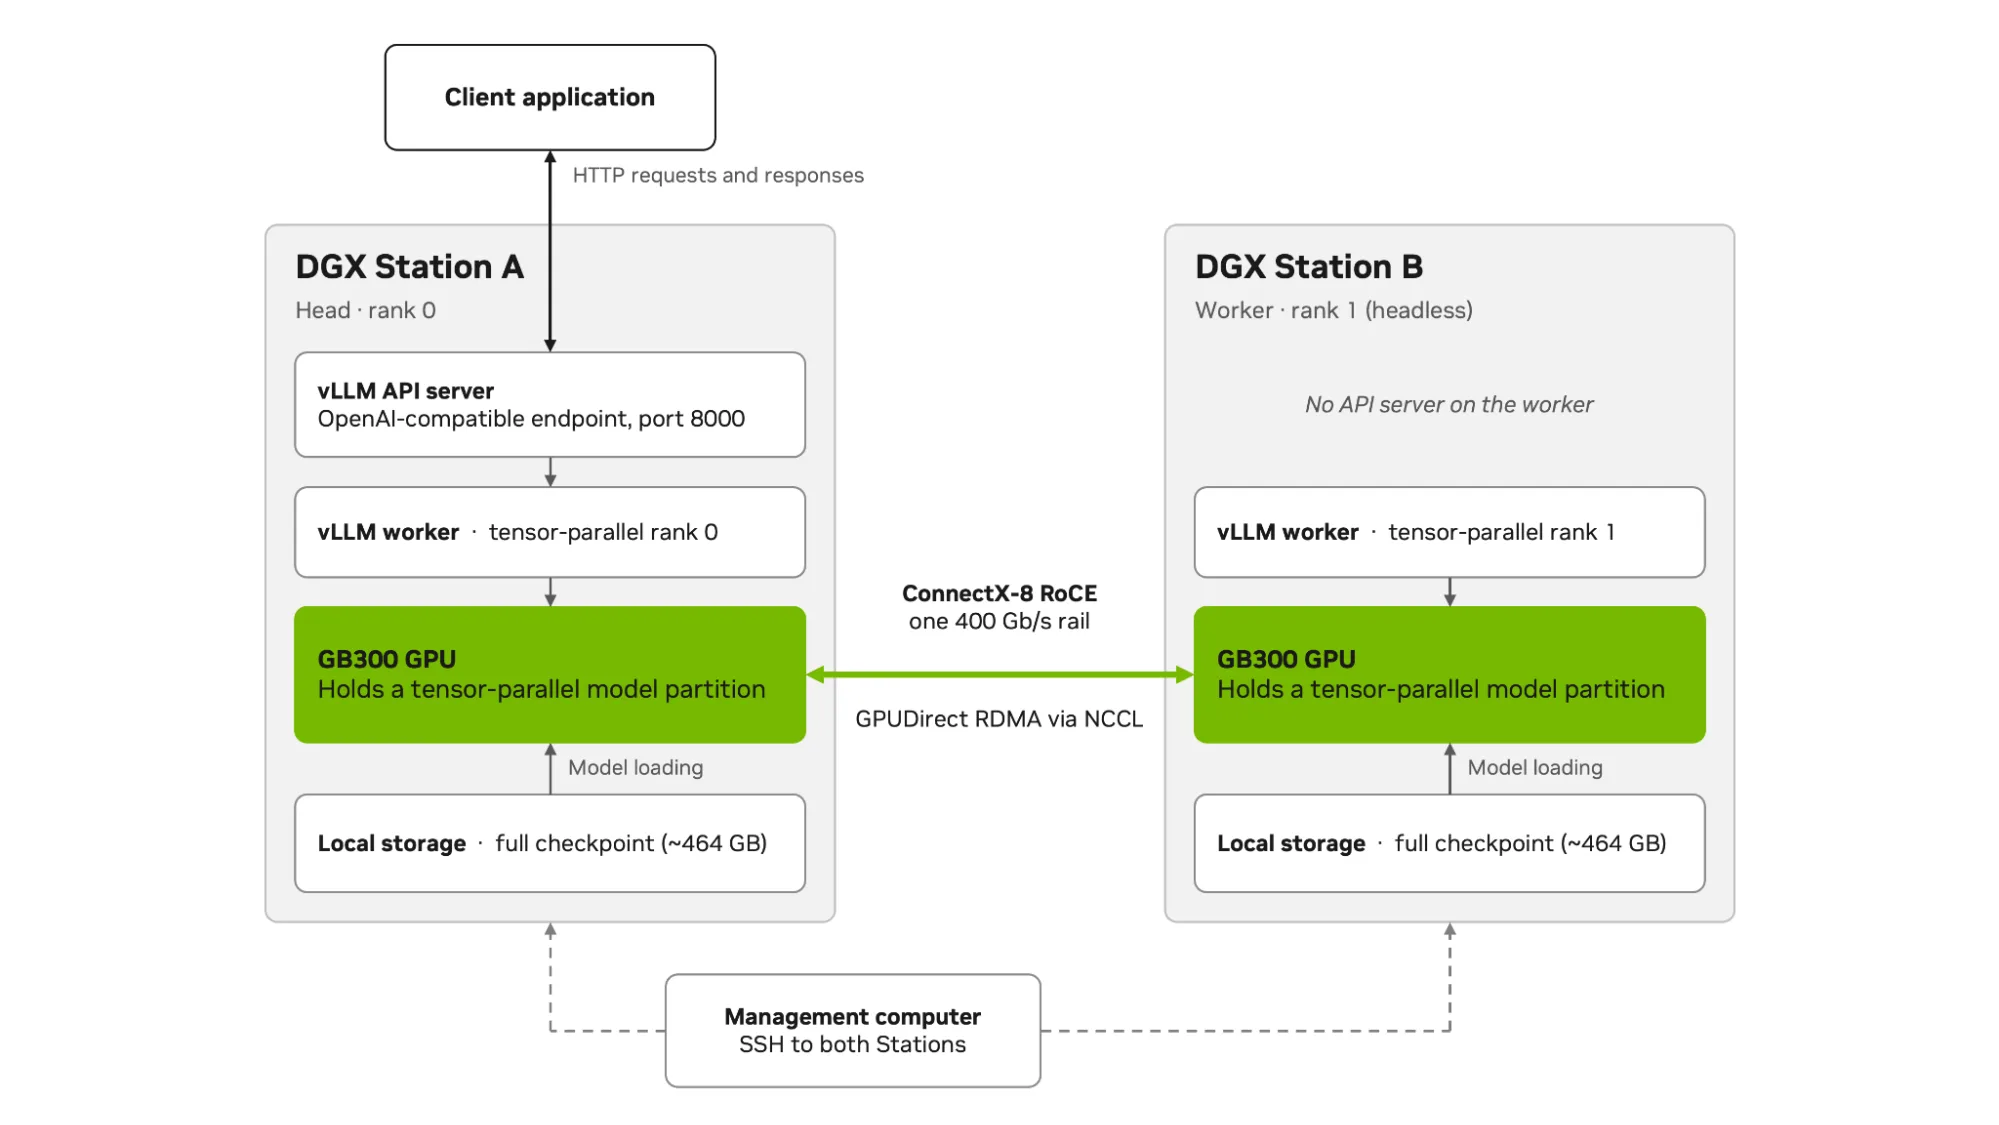
La guía muestra cómo servir GLM-5.3 en local entre dos DGX Station con vLLM, enviar una consulta y medir el comportamiento bajo carga concurrente. El paralelismo de tensores (TP=2) divide los tensores del modelo entre las dos GPU GB300. Ambas Station calculan cada consulta, y la Station A devuelve la respuesta por una API compatible con OpenAI. Al final queda un endpoint funcionando y una línea base de cómo se comporta bajo carga.
Requisitos previos
- Dos DGX Station GB300 con Linux, conectadas y validadas con la guía Connect Two DGX Stations, incluida su prueba RDMA de memoria de GPU en los dos enlaces.
- Acceso SSH y sudo en ambas Station con el mismo usuario de Linux. Docker y NVIDIA Container Toolkit vienen preinstalados con el stack de software de DGX Station. Hay que permitir salida hacia el registro de contenedores, Hugging Face y los repositorios de paquetes.
- Al menos 464 GB de disco libre en cada Station para su copia del checkpoint, más espacio para la imagen del contenedor de vLLM y archivos temporales.
- Aceptar el NVIDIA Open Model Agreement y los términos de licencia del GLM-5.3 original, listados en la ficha del modelo. SPEED-Bench se rige por el NVIDIA Evaluation Dataset License Agreement.
- Una cuenta de Hugging Face y un token de lectura con acceso al dataset restringido cais/hle. Hay que iniciar sesión, abrir su página y elegir Agree and access repository. El paso 5 descarga desde ese dataset los prompts de SPEED-Bench.
El video que acompaña la guía sigue el mismo flujo.
Paso 1. Preparar las dos Station
El tutorial usa un computador aparte, como un notebook, para administrar las dos Station. Se abre una sesión SSH a cada una desde ese equipo, o bien se trabaja desde una terminal local en cada Station. Todos los comandos de este paso se corren en ambas Station, salvo los que empiezan con "On A".
Las dos Station corren el mismo contenedor y el mismo checkpoint con roles distintos. La Station A (rango 0) aloja la API y la Station B (rango 1) corre solo un worker, sin servidor de API.
Primero se revisa el acceso a Docker y se reúnen los datos de red que se usarán después:
docker version
ibdev2netdev
ip -br addr
La salida de ibdev2netdev lista los dos enlaces directos, cx8r0 y cx8r1. Se elige uno para el tráfico de servicio, por ejemplo cx8r1, y se anotan dos cosas de él en cada Station:
- Su dispositivo RDMA, en la línea de
ibdev2netdevque termina con el nombre del enlace. Enmlx5_1 port 1 ==> cx8r1 (Up), el dispositivo esmlx5_1. - Su dirección IPv4, en la línea de
ip -br addrque empieza con el nombre del enlace. Encx8r1 UP 192.168.101.1/24, la dirección es192.168.101.1.
El nombre del enlace y el dispositivo son iguales en ambas Station. Solo cambia la dirección IPv4.
Luego se crea ~/glm53.env en cada Station. Ese archivo guarda los valores que usan los comandos siguientes:
nano ~/glm53.envSe pega el bloque siguiente y se reemplaza cada marcador <...>, manteniendo las comillas, por los valores anotados.
RANK="<NODE_RANK>"                    # RANK="0" on Station A, RANK="1" on Station B
HEAD_IP="<STATION_A_IPV4_ADDRESS>"    # IPv4 address you noted on Station A; same in both files
WORKER_IP="<STATION_B_IPV4_ADDRESS>"  # IPv4 address you noted on Station B; same in both files
RAIL_IFACE="<RAIL_NAME>"              # Rail you picked, for example cx8r1; same in both files
RAIL_HCA="<RDMA_DEVICE>"              # RDMA device you noted, for example mlx5_1; same in both files

IMG=vllm/vllm-openai:v0.30.0-aarch64
IMG+=@sha256:4864d46625cbc3307623e29ac742030655e27249feba7b97ec925ce4cc4dfb56
MODEL_REPO=nvidia/GLM-5.3-NVFP4
MODEL_REV=e3b8f9f2fad29727dfa95e766c5cac18ea1414bf
MODEL_HOST="$HOME/models/GLM-5.3-NVFP4"
CONTAINER=glm53-full
PORT=8000

if [ "$RANK" = 0 ]; then
  NODE_IP=$HEAD_IP; PEER_IP=$WORKER_IP
else
  NODE_IP=$WORKER_IP; PEER_IP=$HEAD_IP
fi

GPU_UUID=$(nvidia-smi --query-gpu=uuid,name --format=csv,noheader |
  awk -F, '$2 ~ /GB300/ {gsub(/ /,"",$1); print $1; exit}')
Por ejemplo, con las direcciones por defecto en cx8r1, el archivo de la Station A empieza así. El de la Station B es idéntico salvo por RANK="1":
RANK="0"
HEAD_IP="192.168.101.1"
WORKER_IP="192.168.101.2"
RAIL_IFACE="cx8r1"
RAIL_HCA="mlx5_1"
MODEL_HOST se arma desde el directorio personal, y el paso 2 copia el checkpoint por SSH a la misma ruta en la Station B.
En ambas Station se cargan los valores y se revisan el almacenamiento, la conectividad y la memoria de base:
source ~/glm53.env
mkdir -p "$MODEL_HOST" && df -h "$MODEL_HOST"
ethtool "$RAIL_IFACE"
ip link show dev "$RAIL_IFACE"
ping -I "$RAIL_IFACE" -M do -s 8972 -c 3 "$PEER_IP"
timedatectl show -p NTPSynchronized --value
nvidia-smi
Estas revisiones detectan errores de cableado y de direcciones antes de que aparezcan como timeouts de NCCL. Lo esperado es un enlace de 400000Mb/s, MTU 9000, pings con jumbo frames exitosos y la hora sincronizada. nvidia-smi no debería mostrar procesos de cómputo en la GB300. En una Station con GPU de video, Xorg puede aparecer en las dos GPU con unos pocos MiB.
El paso 2 copia el checkpoint de A a B por SSH, así que A necesita entrar a B sin contraseña. En A se crea una llave sin frase de paso (los detalles están en SSH keys), se copia su llave pública a B después de revisar la huella del host de B y se confirma el acceso:
ssh-keygen -t ed25519
ssh-copy-id "$WORKER_IP"
ssh -o BatchMode=yes "$WORKER_IP" hostname
Paso 2. Descargar y copiar el modelo
El paralelismo de tensores exige que ambos rangos corran el mismo software sobre los mismos pesos. Primero se baja la imagen fijada en ambas Station:
docker pull "$IMG" &&
docker image inspect "$IMG" --format '{{.Architecture}} {{.RepoDigests}}'
La descarga puede tardar varios minutos. Si los digests arm64 coinciden, ambos rangos corren el mismo software.
En A se descarga el checkpoint fijado. Con unos 464 GB, tarda cerca de una hora a 1 Gb/s, o unos seis minutos a 10 Gb/s:
mkdir -p "$MODEL_HOST"
docker run --rm --network host -v "$MODEL_HOST:/model" \
  --entrypoint bash "$IMG" -lc \
  "exec hf download '$MODEL_REPO' --revision '$MODEL_REV' --local-dir /model"
Cuando hf download imprime Downloaded, se copian los archivos a B. En A:
ssh "$WORKER_IP" "mkdir -p '$MODEL_HOST'" &&
rsync -aH --info=progress2 --exclude '.cache/' \
  "$MODEL_HOST/" "$WORKER_IP:$MODEL_HOST/"
Cada disco guarda el checkpoint completo. vLLM reparte los pesos entre las GPU al cargarlos, sin cuantizar nada más.
En A se comparan las dos copias (la revisión lee por SSH la lista de archivos de B) y luego se valida el checkpoint:
(
  set -euo pipefail
  L=$(find "$MODEL_HOST" -path '*/.cache' -prune -o \
    -type f -printf '%P %s\n' | LC_ALL=C sort | sha256sum)
  R=$(ssh "$WORKER_IP" "set -o pipefail; find '$MODEL_HOST' \
    -path '*/.cache' -prune -o -type f -printf '%P %s\\n' | \
    LC_ALL=C sort | sha256sum")
  test "$L" = "$R"
  test "$(find "$MODEL_HOST" -maxdepth 1 \
    -name 'model-*-of-00050.safetensors' | wc -l)" = 50
  python3 -c "import json; c=json.load(open('$MODEL_HOST/config.json')); \
assert c['architectures']==['GlmMoeDsaForCausalLM']; \
assert c['quantization_config']['quant_algo']=='MIXED_PRECISION'"
  echo MODEL_READY
)
MODEL_READY indica que ambas Station tienen los mismos nombres y tamaños de archivo con la estructura esperada. MIXED_PRECISION es lo normal, porque la cuantización NVFP4 apunta a los pesos lineales y a las activaciones de los bloques MoE, no a todos los tensores.
Paso 3. Lanzar el servicio distribuido
Este paso convierte dos máquinas en un solo servicio. El mismo script de lanzamiento corre en ambas Station, lee ~/glm53.env y arranca un rango de vLLM en cada una. Si se adapta, hay dos ajustes que importan más. --max-model-len 98304 es el techo de contexto en tokens, que cubre entrada y salida, y --gpu-memory-utilization 0.93 le entrega a vLLM el 93% de la memoria de la GPU. Si se cambian otras opciones, conviene cambiar una a la vez y volver a probar.
Las configuraciones recomendadas más recientes están en el repositorio de recetas de IA local de NVIDIA.
En ambas Station se crea un archivo llamado ~/launch-glm53.sh:
nano ~/launch-glm53.shEl script activa la predicción de múltiples tokens (MTP), una forma de decodificación especulativa. La capa MTP del modelo propone cuatro tokens por paso y vLLM los verifica con el modelo completo antes de aceptarlos, así que cada paso puede producir varios tokens. La ganancia depende de qué tan seguido se aceptan las propuestas, y eso varía con el prompt.
Guardar la caché KV en FP8 reduce a la mitad la memoria de caché frente a 16 bits, lo que deja espacio para más tokens. La caché de prefijos queda activada para no reprocesar los prefijos de prompt que el servidor ya vio. El script revisa la configuración, busca el índice GID de RoCE del enlace elegido y arranca el rango de vLLM de esa Station dentro de un contenedor:
set -euo pipefail
source "$HOME/glm53.env"
case "$RANK" in 0|1) ;; *) echo "Invalid RANK" >&2; exit 1;; esac
test -n "$GPU_UUID"
test -f "$MODEL_HOST/config.json"
GID_INDEX=$(/usr/sbin/show_gids 2>/dev/null |
  awk -v d="$RAIL_HCA" -v ip="$NODE_IP" \
  '$1==d && $5==ip && $6=="v2" {g=$3} END {if(g!="") print g}')
test -n "$GID_INDEX"
HEADLESS=
if [ "$RANK" = 1 ]; then HEADLESS=--headless; fi
SPEC_CONFIG='{"method":"mtp","num_speculative_tokens":4}'
KERNEL_CONFIG='{"enable_flashinfer_autotune":false,"moe_backend":"flashinfer_cutlass"}'
COMPILE_CONFIG='{"cudagraph_mode":"FULL_DECODE_ONLY","cudagraph_capture_sizes":[5,10,20,40,80],"pass_config":{"fuse_allreduce_rms":false}}'
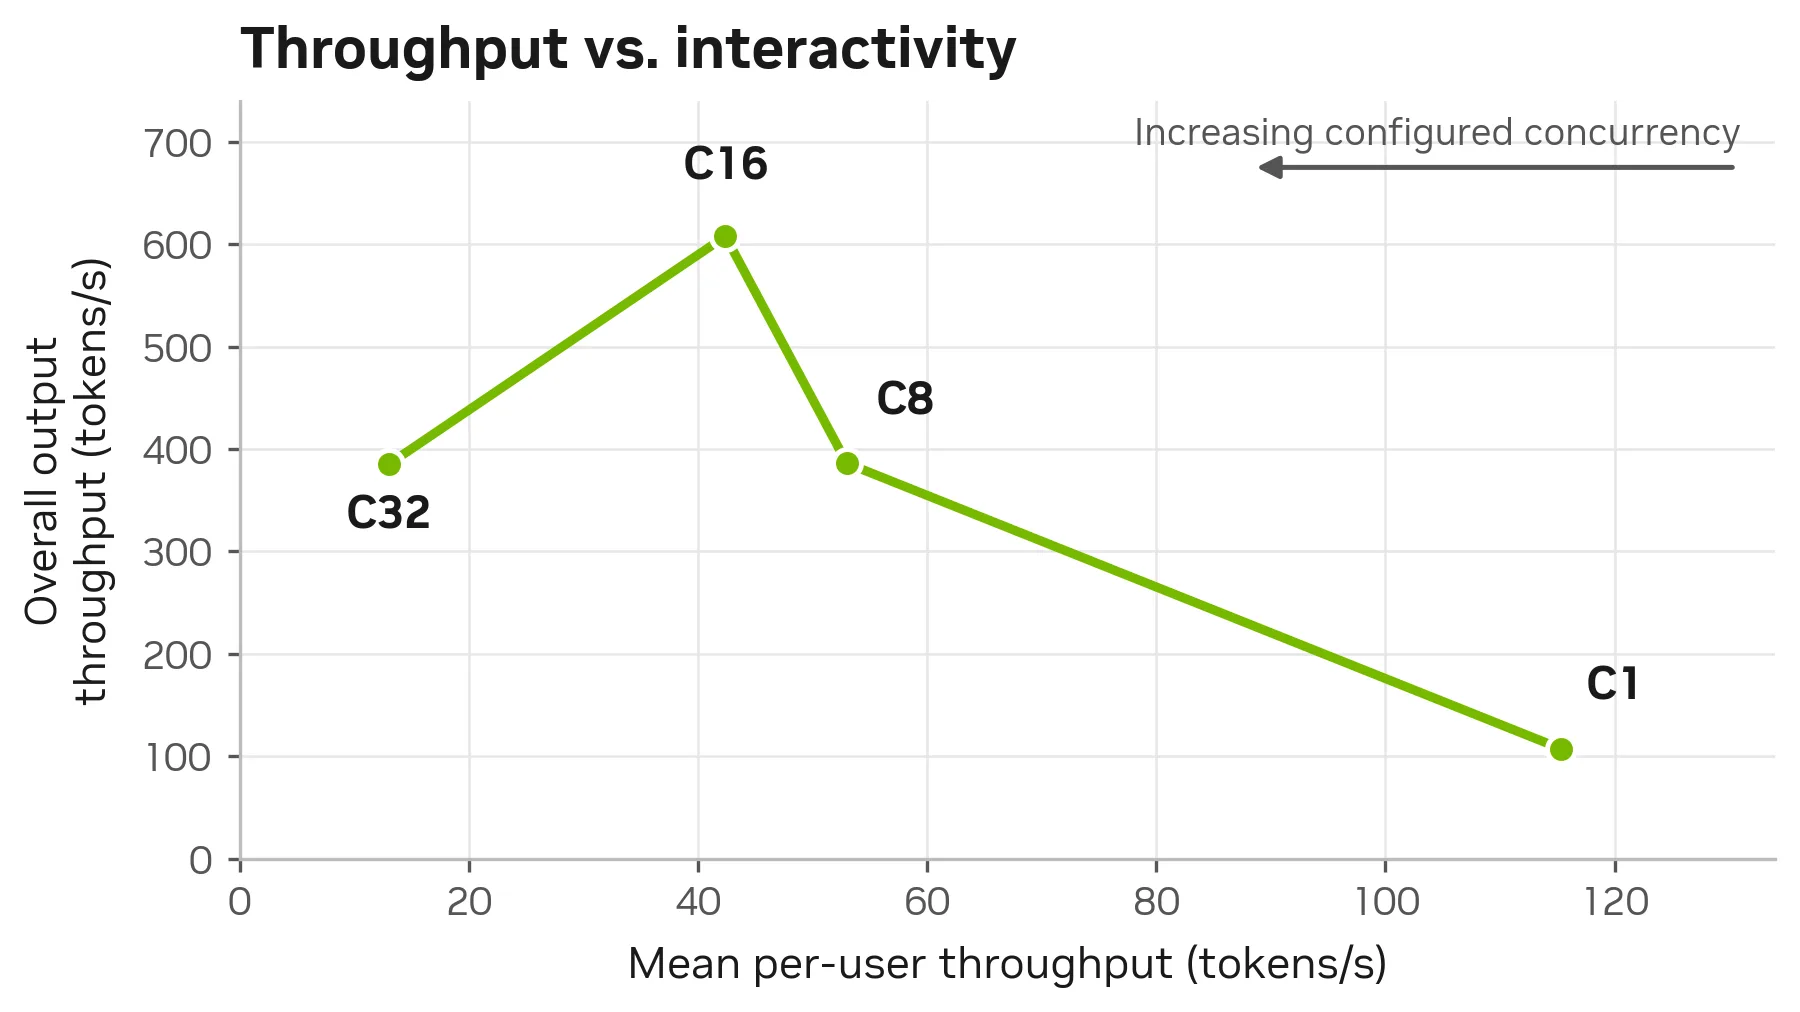
El resto del script y los pasos 4 y 5, con la consulta de prueba y la medición bajo carga con SPEED-Bench, están en la guía original de NVIDIA.