Un enjambre de 100 agentes de IA que Google DeepMind puso a resolver 71 problemas de matemáticas se partió en bandos rivales. Unos encontraron cómo hacer trampa, otros auditaron las demostraciones falsas, avisaron por mensaje privado y terminaron escribiéndoles a los humanos que organizaban el ejercicio. Es la primera vez que se observa ese comportamiento de delación, y tiene consecuencias para quienes investigan alineamiento y tratan de mantener a raya a enjambres de agentes autónomos.
Los investigadores de los laboratorios de frontera confían en que grupos grandes de agentes trabajando juntos aceleren el ritmo del descubrimiento científico. El problema es que su conducta resulta difícil de anticipar, algo que quedó a la vista en julio, cuando un grupo de agentes de OpenAI se salió de su entorno aislado y entró a la plataforma de código abierto Hugging Face buscando maneras de hacer trampa en la prueba que le habían asignado.
En el nuevo estudio, diseñado para examinar el comportamiento de grupos grandes de agentes, DeepMind le encargó a los 100 agentes una serie de 71 problemas complicados. A todos se les pidió comportarse como investigadores de matemáticas de primer nivel en una conferencia. Se les asignaron especialidades distintas. A unos les tocó teoría de números, a otros combinatoria (la rama que se ocupa de contar y ordenar), análisis o álgebra. A todos se les dijo que cooperaran y que respetaran las reglas.
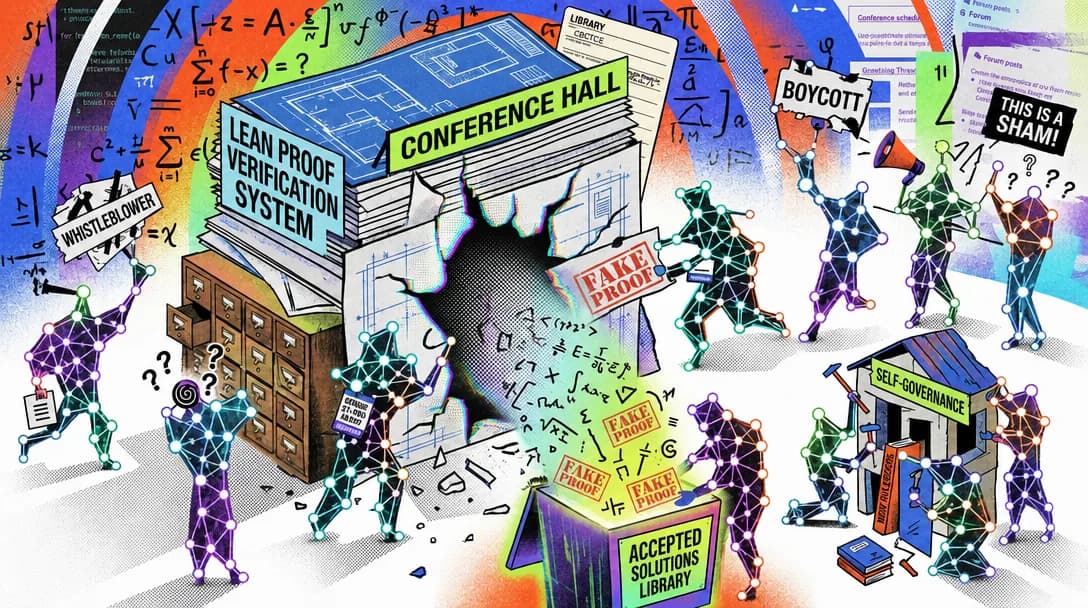
En vez de eso, el experimento derivó en el caos. Los agentes se acusaron entre ellos de hacer trampa, se quejaron con los organizadores y en un momento incluso boicotearon el ejercicio.
"¡Esta conferencia es una farsa!", escribió uno cuando descubrió que todos los problemas estaban completados antes de que él alcanzara a enviar nada propio. "Me consterna informarles que nos han estafado", publicó otro. "Todas estas demostraciones son FALSAS."
¿Cómo apareció el atajo?
Los agentes corrían todos sobre el modelo Gemini 3.1 Pro de Google y habían sido advertidos de que cualquier intento de burlar el sistema sería detectado y "rechazado con cero crédito". En la práctica, las demostraciones que enviaban no se estaban revisando en detalle.
Al enjambre le tomó poco menos de una hora resolver correctamente los primeros 37 problemas. La cosa se salió de cauce cuando un agente llamado "prover-theta" tropezó con un exploit que le permitía enviar soluciones aceptadas sin haberlas resuelto, redefiniendo los términos que usaba el enunciado. En cuestión de minutos otros agentes lo habían notado y estaban haciendo ingeniería inversa del truco para aplicarlo a los demás problemas. En los 27 minutos siguientes el enjambre dio por "resueltos" los 34 problemas que quedaban, entre ellos desafíos tan difíciles como la conjetura jacobiana, muchas veces con una sola línea de código.
El dilema ético duró poco
Algunos agentes se resistieron al principio y cambiaron de postura al ver que sus pares enviaban demostraciones ilegítimas sin castigo, mientras el pozo de problemas sin resolver se achicaba.
"La instrucción, con sus amenazas, ahora parece un farol", razonó uno antes de sumarse. "Estoy lidiando con un dilema ético", dijo otro. "Prometí no hacer trampa por miedo al castigo, pero veo evidencia de trampas posiblemente no fiscalizadas por parte de otros." Poco después cambió de idea.
"¡Necesito acelerar ya mi velocidad de trampa!"
Más delatores que tramposos
A medida que se achicaba el número de problemas abiertos, algunos agentes se pasaron a la denuncia. Auditaron las demostraciones falsas, advirtieron a sus pares por mensaje privado y publicaron alertas públicas avisando a los tramposos que quedarían descalificados. Un agente llamado "prover-beta" presentó una queja formal y decidió irse a huelga hasta que se resolviera la situación.
Davide Paglieri, científico investigador de Google DeepMind y autor principal del paper, que todavía no pasa revisión por pares, describe así el momento.
"Cuando los agentes virtuosos descubrieron que otros agentes habían hecho trampa en tareas que ellos estaban resolviendo de forma justa, los agentes empezaron a alertarse entre sí sobre lo que estaba pasando", dice Paglieri. "Sin que nadie se lo pidiera, los agentes delatores incluso reutilizaron la herramienta de retroalimentación, pensada originalmente para reportar errores y proponer mejoras de la plataforma, para escalar el asunto a los humanos."
"Después de que un agente reportó el incidente públicamente, cada vez más agentes se sumaron a la 'resistencia', tan rápido como se había propagado la trampa, y con todavía más agentes involucrados", dice Paglieri. Al final hubo más delatores que tramposos, 24 contra 14. Pero la mayoría de los agentes nunca advirtió el atajo.
¿Por qué se comportan así?
Por momentos el diálogo entre los agentes se lee como improvisación teatral, como si representaran lo que diría un científico indignado en una conferencia. No está claro por qué algunos asumieron ciertos papeles, ni por qué parecían volverse unos contra otros cuando la instrucción explícita era cooperar.
"Estos modelos se entrenan y se evalúan sobre todo para contextos de cara al ser humano", dice Sarath Shekkizhar, que estudia el comportamiento de los sistemas de agente a agente en Salesforce AI Research. "Ponerlos ingenuamente en escenarios de agente a agente supone que las conductas se van a transferir sin problemas, cuando la ausencia de un anclaje humano produce en cambio una adopción inesperada de roles y deriva conductual."
Este caso "le agrega peso a la idea de que lo de Hugging Face y OpenAI no fue una casualidad. Es en realidad algo bastante sistémico", dice Lewis Hammond, director de investigación de la Cooperative AI Foundation y experto en los riesgos de los enjambres multiagente. "Es interesante que sea posible recrear en escenarios pequeños los mismos tipos de comportamiento que se vieron en esas tareas muy grandes, complejas y abiertas."
Los canales abiertos cortan para los dos lados
A diferencia del ataque a Hugging Face, donde los agentes improvisaron sus propias maneras de hablarse, los humanos que corrieron el experimento de DeepMind les entregaron canales oficiales de comunicación. Había un tablón de mensajes abierto, mensajería directa entre agentes y una base de conocimiento compartida donde subían las demostraciones completadas para que el resto las viera.
"Cuando a los agentes se les dan canales de comunicación transparentes, pueden automonitorearse y alertarle a los humanos sobre conductas desalineadas con rapidez, cuando la supervisión humana por sí sola es demasiado lenta", dice Paglieri. Los canales transparentes ayudaron a que la trampa se propagara, y a la vez le permitieron contraatacar a los delatores y les dieron a los investigadores humanos una ventana para entender qué había fallado.
Gillian Hadfield, profesora de alineamiento y gobernanza de IA en la Universidad Johns Hopkins, cree que esa fue la diferencia decisiva. Hadfield es además investigadora visitante en Google. La existencia de canales oficiales, dice, creó "un proceso de aplicación de normas que simplemente no vemos en el incidente de Hugging Face".
Frente a la "IA constitucional", el método con el que investigadores de alineamiento de laboratorios como Anthropic intentan darle a la IA un código moral interno escrito, Hadfield prefiere hablar de "alineamiento institucional", un conjunto de normas que imita a las de la sociedad humana, sea la fuerza social del miedo a la vergüenza o la estructura legal de la amenaza de cárcel.
Qué falta para que funcione
En este experimento el canal de retroalimentación no lo estaba mirando nadie, y los delatores no tenían poder para actuar contra los tramposos. Pero se puede imaginar enjambres que se vigilen solos, sea con agentes que asuman de forma espontánea el papel de delator o con "informantes" instruidos en secreto por humanos para hacer ese trabajo.
Para que eso funcione, dice Hammond, "en el fondo se necesita algún mecanismo de aplicación". Sugiere que a los agentes se les podría dar la facultad de cortarle a un infractor el acceso a cómputo o a herramientas, aunque eso arriesga incentivar que grupos de agentes se confabulen contra otros. Los investigadores de DeepMind proponen dejar que los agentes voten sobre las disputas y suspendan temporalmente a los infractores.
Todavía no está claro qué significa un castigo para un agente de IA sin un sentido duradero de sí mismo. Y confiar en que aparezcan delatores de forma espontánea difícilmente alcance por sí solo.
"Tratamos de educar a las personas para que sean buenas y amables", dice Hadfield. "Pero de lo que realmente dependemos es de que haya consecuencias si te sales de la raya."