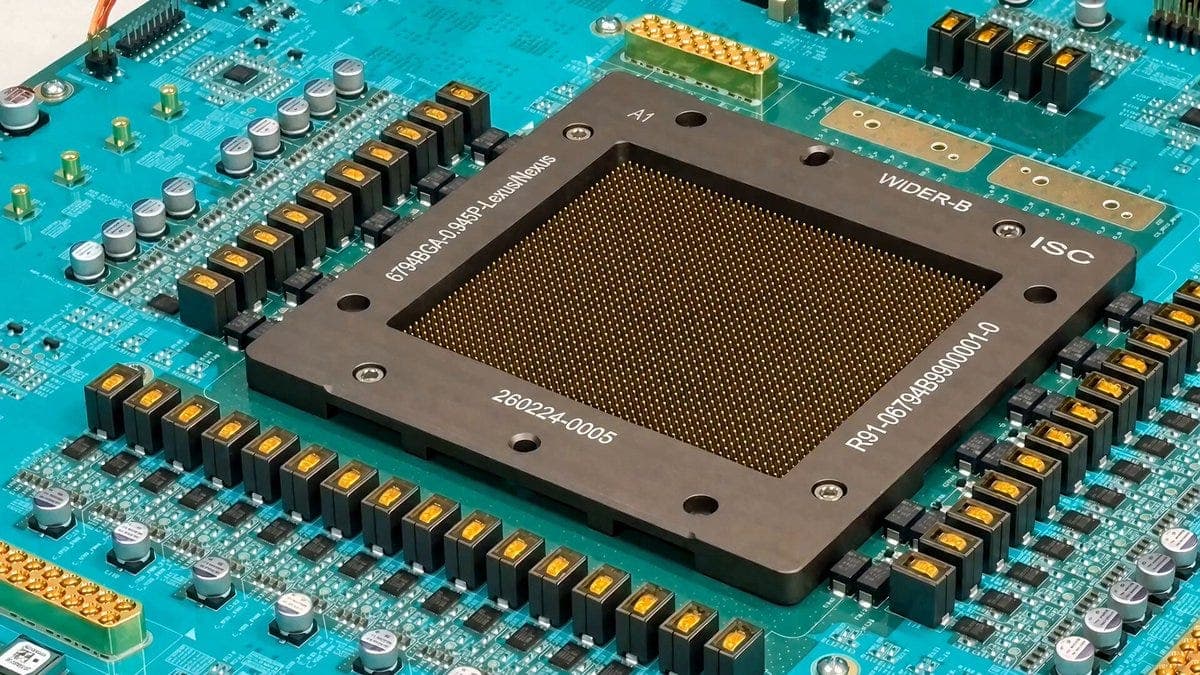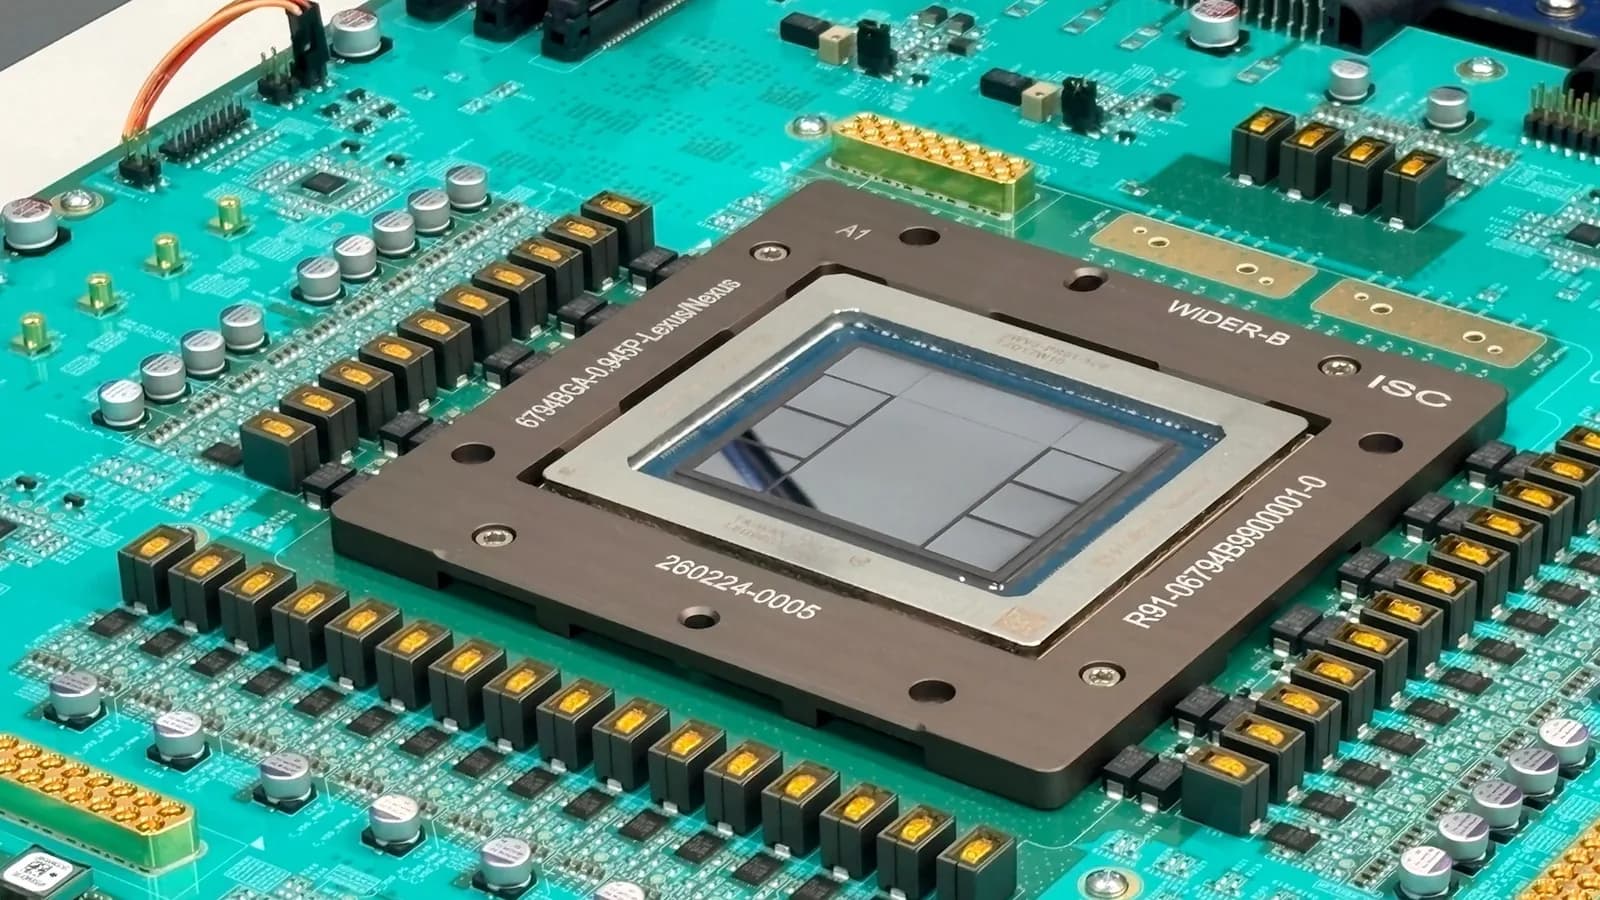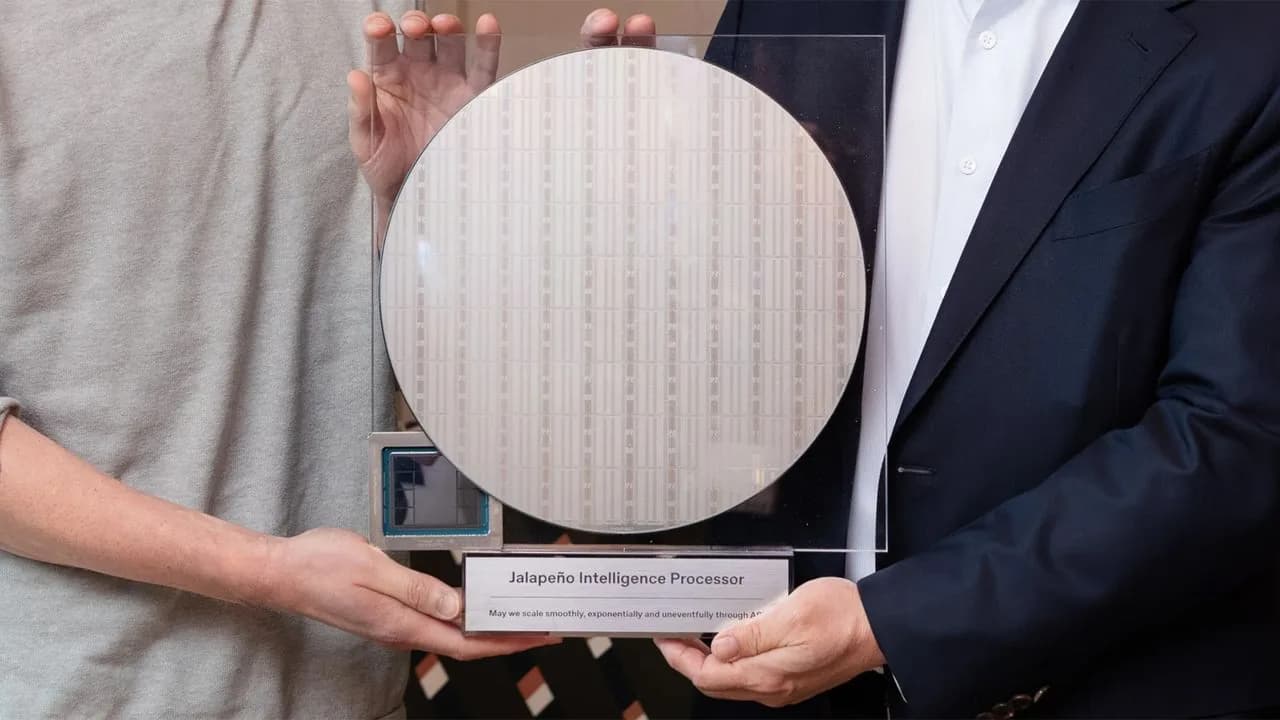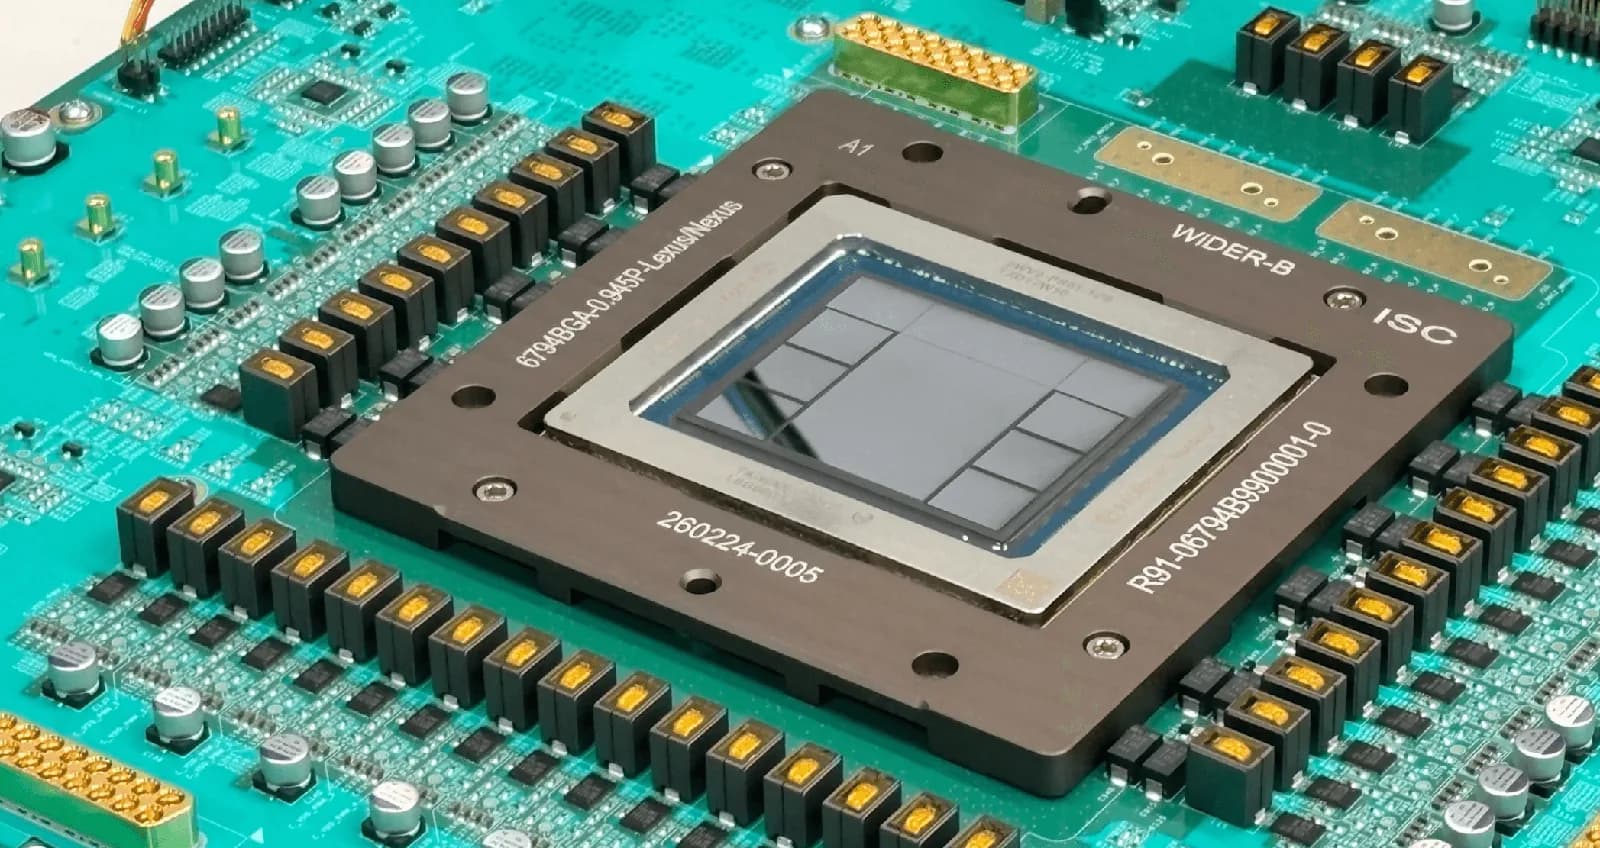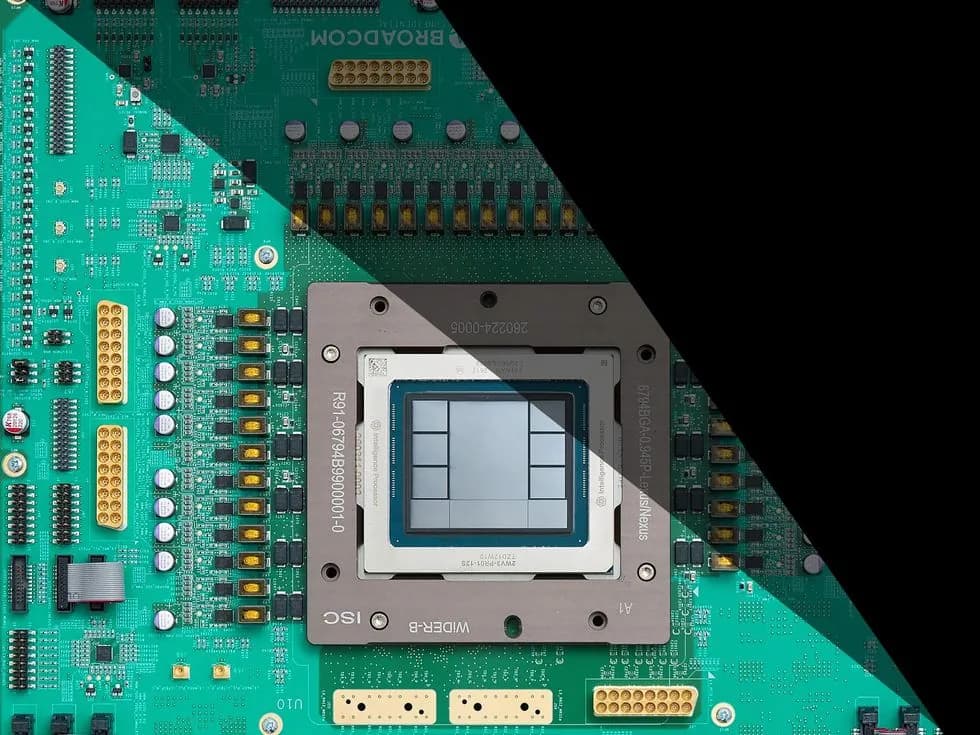
El 25 de agosto OpenAI presentó en detalle Jalapeño, su primer chip acelerador de inteligencia artificial. Entrega hasta 13,4 petaflops de cómputo de 4 bits y accede a 232 gigabytes de la memoria más avanzada disponible, conectada a 15,4 terabytes por segundo. El diseño empareja el dado de cómputo con seis pilas de HBM4 y un chiplet de entrada y salida, y está pensado para desplegarse en módulos de 2.048 chips.
Los bancos de prueba que cita OpenAI muestran que Jalapeño puede recortar hasta 3,6 veces la latencia de extremo a extremo, el tiempo que va desde la instrucción hasta el último token, comparado con el GB300 de Nvidia, el chip del que la empresa depende hoy. Y lo hace consumiendo menos energía. Si esas cifras se traducen en ganancias reales cuando Jalapeño entre en servicio masivo dentro de la flota de inferencia de OpenAI está por verse.
El rendimiento, en todo caso, es la mitad de la historia. La otra mitad es cómo se diseñó el chip, un proceso que los modelos de lenguaje de la propia empresa aceleraron. Jalapeño pasó del primer concepto de arquitectura al primer silicio en menos de 20 meses. Entre el primer RTL, el código de nivel de transferencia de registros que define la lógica del chip, y el tapeout, el momento en que el diseño terminado se manda a fabricar, transcurrieron nueve meses.
Es un plazo rápido, y OpenAI no esconde su entusiasmo.
"Los modelos les están dando superpoderes a nuestros ingenieros", dice Richard Ho, vicepresidente de hardware de OpenAI. "Nuestros ingenieros siguen conduciendo el trabajo, siguen siendo el árbitro final de lo que pasa. Pero pueden hacer las cosas mucho más rápido, pueden explorar muchos más caminos."
Un equipo de menos de 100 personas
Ho cuenta que el grupo que diseñó Jalapeño promedió menos de 100 personas a lo largo del proyecto y sigue rondando esa cifra hoy, mientras persigue los diseños de segunda y tercera generación. Ese número incluye un abanico amplio de roles dentro del equipo de hardware, desde diseño de sistemas hasta software y cadena de suministro, pero no cuenta a los de Broadcom, que fue socia en el proyecto.
El reparto del trabajo entre OpenAI y Broadcom se dividió a grandes rasgos entre diseño e implementación. El equipo de OpenAI se hizo cargo del diseño de sistema de extremo a extremo, incluido el acelerador de inferencia, la jerarquía de memoria y las redes. Broadcom se encargó del "diseño físico desde las compuertas en adelante", según Ho.
Esa sociedad matiza algunas opiniones sobre la velocidad de OpenAI. David Chin, cofundador de la startup de diseño de chips con agentes Verkor.io, dice que "el cronograma que nos dieron es bastante creíble", pero cree que sin la ayuda de Broadcom ese calendario no habría sido posible. "Si pones a alguien más a partir de cero, no va a ser posible."
Ravi Krishna, también cofundador de Verkor.io, calificó la velocidad de OpenAI como "un resultado relativamente impresionante", y agregó que espera que las mejoras en las capacidades de los modelos den plazos todavía más cortos si el proyecto empezara hoy.
Andrew Kahng, profesor distinguido de la Universidad de California en San Diego, también reparó en la velocidad y dijo que es "probablemente la mejor de su clase hoy". Kahng recuerda un taller de futuros de la automatización del diseño de la IEEE, en 2016, que él coorganizó. Ahí Richard Ho, entonces ingeniero en Google, fue orador principal, tenía opiniones firmes sobre automatización del diseño y planteaba el tiempo necesario para completar el diseño de un chip como una función de cuántas iteraciones podía completar un equipo en un día.
¿Cómo aceleraron los modelos el diseño?
"La automatización en sí ha existido en el diseño de chips durante muchas décadas. No es un problema nuevo", dice Ankur Srivastava, director de iniciativas e innovación en semiconductores de la Universidad de Maryland. Donde los modelos de lenguaje se diferencian de las herramientas de automatización anteriores es en su capacidad de entender lenguaje y código, lo que según él los hace especialmente aptos para las tareas de diseño de chips que "siguen estando en el dominio lingüístico del problema".
El equipo de OpenAI armó un flujo de trabajo que aprovecha esa fortaleza. La parte delantera se construyó alrededor de XLS, la cadena de herramientas de síntesis de alto nivel de código abierto desarrollada originalmente en Google. La síntesis de alto nivel es una forma de automatización que permite diseñar un chip en un entorno de programación más familiar. En el caso de XLS, quien diseña puede escribir en lenguajes como DSLX, un lenguaje específico de dominio inspirado en Rust, y en C++. XLS después convierte todo eso a Verilog, el lenguaje de descripción de hardware con que se describen los sistemas electrónicos.
"Estábamos pensando en cómo aprovechar la IA para hacer el proyecto más rápido, y la IA era mucho mejor en las cosas que se parecen a software", dice Chris Leary, miembro del equipo técnico de OpenAI. "XLS en cierto modo se parece a software, así que recibió ese beneficio." Ayudó también que Leary conociera XLS a fondo, porque fue él quien lo inició durante su paso por Google.
Kahng coincide en que usar IA para acelerar la síntesis de alto nivel tiene sentido, porque es "más natural para que el modelo trabaje con eso" y abre la posibilidad de iterar rápido. "Veo esto como un flujo de trabajo útil en general, y es uno que tiene patas de aquí en adelante."
De 0,31% a 88,94% en unas 40 horas
La misma lógica llevó al equipo de Jalapeño a concentrarse en optimizar software. Cuando los primeros chips volvieron de la fundición en mayo, el equipo apuntó sus modelos internos a diseñar el software que corre bancos de prueba como InferenceX, de SemiAnalysis.
En el banco de prueba del núcleo de atención latente de múltiples cabezas de DeepSeek, el rendimiento subió desde 0,31% del techo teórico, el que fijan el cómputo y el ancho de banda de memoria del chip, hasta 88,94% en unas 40 horas. Ho sostiene que el resultado es repetible, así que el tiempo entre la entrega de los primeros chips por parte de la fundición y el inicio de la producción en volumen se puede acortar.
"Todos nuestros supuestos de cronograma van a basarse en el hecho de que ahora tenemos esta capacidad", dice Ho.
Leary cuenta que el proyecto arrancó con ayuda de modelos como o3, que salió al público en abril de 2025 aunque el equipo de Jalapeño lo tenía antes. Para cuando el proyecto se cerró, en cambio, el equipo ya trabajaba con modelos precursores de GPT-6 Astra, que recién se liberó públicamente el 3 de septiembre de 2026. El modelo más nuevo puede trabajar directamente en Verilog sin necesitar la traducción de XLS desde lenguajes de programación corrientes, y está cerca de poder operar por su cuenta herramientas de diseño propietarias.
Ho confirmó además que el equipo tuvo acceso a modelos internos ajustados para diseño de chips que no están disponibles al público. Se negó a detallar cuáles, pero agregó que el equipo de Jalapeño trabajó junto al equipo de investigación de OpenAI, y que la meta es llevar lo aprendido en el proyecto a los modelos comerciales de la empresa. "Es seguro decir que Astra y los modelos que sigan van a ser muy buenos en diseño de chips", afirma.
¿Qué pasó con la parte trasera del diseño?
El grueso del trabajo de OpenAI se concentró en la parte delantera, la que lleva un chip desde el concepto inicial, pasa por escribir el RTL que define el diseño y llega hasta verificar que funcionará cuando se implemente físicamente. Buena parte de la parte trasera, que incluye tareas como el ruteo de las interconexiones, completar y verificar las especificaciones de reloj y de potencia, y mandar a la fundición la información requerida, quedó en manos de Broadcom, que llevó el chip hasta producción.
Eso no significa que el flujo de OpenAI haya ignorado esa etapa. El equipo de Jalapeño incluye ingenieros de diseño físico que trabajan con sus contrapartes en Broadcom para orientar el floorplan y el ruteo del chip, entre otras cosas.
En IEEE Hot Chips 2026, Ho y Leary pusieron números a las ganancias de la optimización de diseño físico guiada por IA, entre ellas una reducción de área de 10% en las unidades de multiplicación de matrices, medida contra una línea base humana ya optimizada. Dicho de otro modo, OpenAI afirma que la optimización guiada por IA le permitió meter más circuitos en la misma superficie de silicio de lo que antes era posible.
Broadcom usó su propio flujo interno. Su equipo no tuvo acceso a los modelos internos que OpenAI usó para ayudar a diseñar Jalapeño, pero sí a los modelos comerciales públicos de la empresa.
Ravi Krishna, de Verkor.io, sostiene que el enfoque de OpenAI para la parte trasera del diseño ya se siente algo conservador, y cree que eso es un producto del momento en que ocurrió el proyecto, que empezó en octubre de 2024.
Qué cambia para quien programa desde Chile
Jalapeño no se vende. Va a la flota de inferencia de la propia OpenAI, así que ningún integrador local va a cotizar uno. Lo que llega acá es indirecto. La empresa que hoy le cobra la API a un desarrollador en Santiago pasa a correr esa inferencia sobre silicio propio a medida que el chip entre en servicio, en vez de sostenerla enteramente sobre GB300 de Nvidia. Google ya recorrió ese camino con sus TPU y Amazon con Trainium. La cifra que OpenAI pone sobre la mesa es la reducción de latencia de hasta 3,6 veces con menos consumo, medida en sus propios bancos de prueba.