El Mac Studio actualizado de Apple con el chip M5 Ultra ya demostró su capacidad en las pruebas del medio, con una CPU de 36 núcleos y una GPU de 80 núcleos con aceleradores neuronales para las operaciones de matrices que mueven el cómputo de IA. Además se puede configurar con hasta 512 GB de memoria unificada, y por eso muchos entusiastas de la IA local están dispuestos a esperar las 13 a 15 semanas que hoy demora Apple en despacharlo, según Tom's Hardware.
La pregunta del medio fue si la configuración que probó, de 12.300 dólares o más, vale la pena para ese público. En su reseña inicial ya había probado el M5 Ultra al máximo con el popular Qwen 3.8 27B, pero ese modelo denso y compacto no se acerca a ocupar 256 GB de memoria. Esta vez quiso llenar esa memoria con modelos grandes de punta, como DeepSeek V4.1 Flash 1017 y GLM 5.3 Flash.
También usó pruebas nuevas para medir al Mac Studio en tareas agénticas sobre la GPU, después de su reseña del Microsoft Surface Laptop Ultra con el chip RTX Spark de Nvidia.
Rendimiento agéntico y eficiencia energética
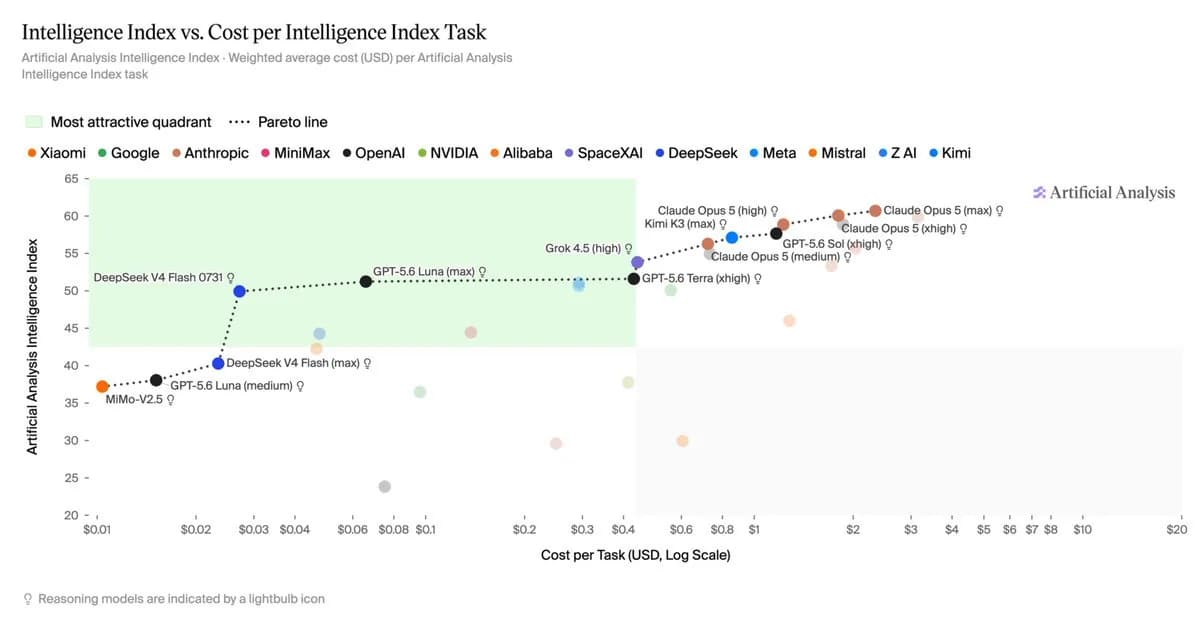
Tom's Hardware empezó con AgentPerf-Local, la prueba de Artificial Analysis. Reproduce trazas de inferencia grabadas con ciertos modelos en distintas cargas de IA agéntica para medir el rendimiento. La mayor parte del trabajo ocurre en el procesamiento del prompt y no en la generación de tokens, así que debería favorecer a los sistemas con mucho cómputo bruto, algo que tienen tanto el GB10 como el M5 Ultra.
En el papel, la GPU de 80 núcleos del M5 Ultra supera con holgura a los 48 SM Blackwell del GB10. Incluso sin datos detallados de relojes, al GB10 le costaría muchísimo ganarle en esta prueba. El Mac tiene además 1,2 TB/s de ancho de banda de memoria, poco más de cuatro veces los 273 GB/s del GB10 para la etapa de decodificación. Pero las pruebas anteriores del medio muestran que en IA las especificaciones pesan menos que el rendimiento entregado, y este puede variar mucho respecto del papel.
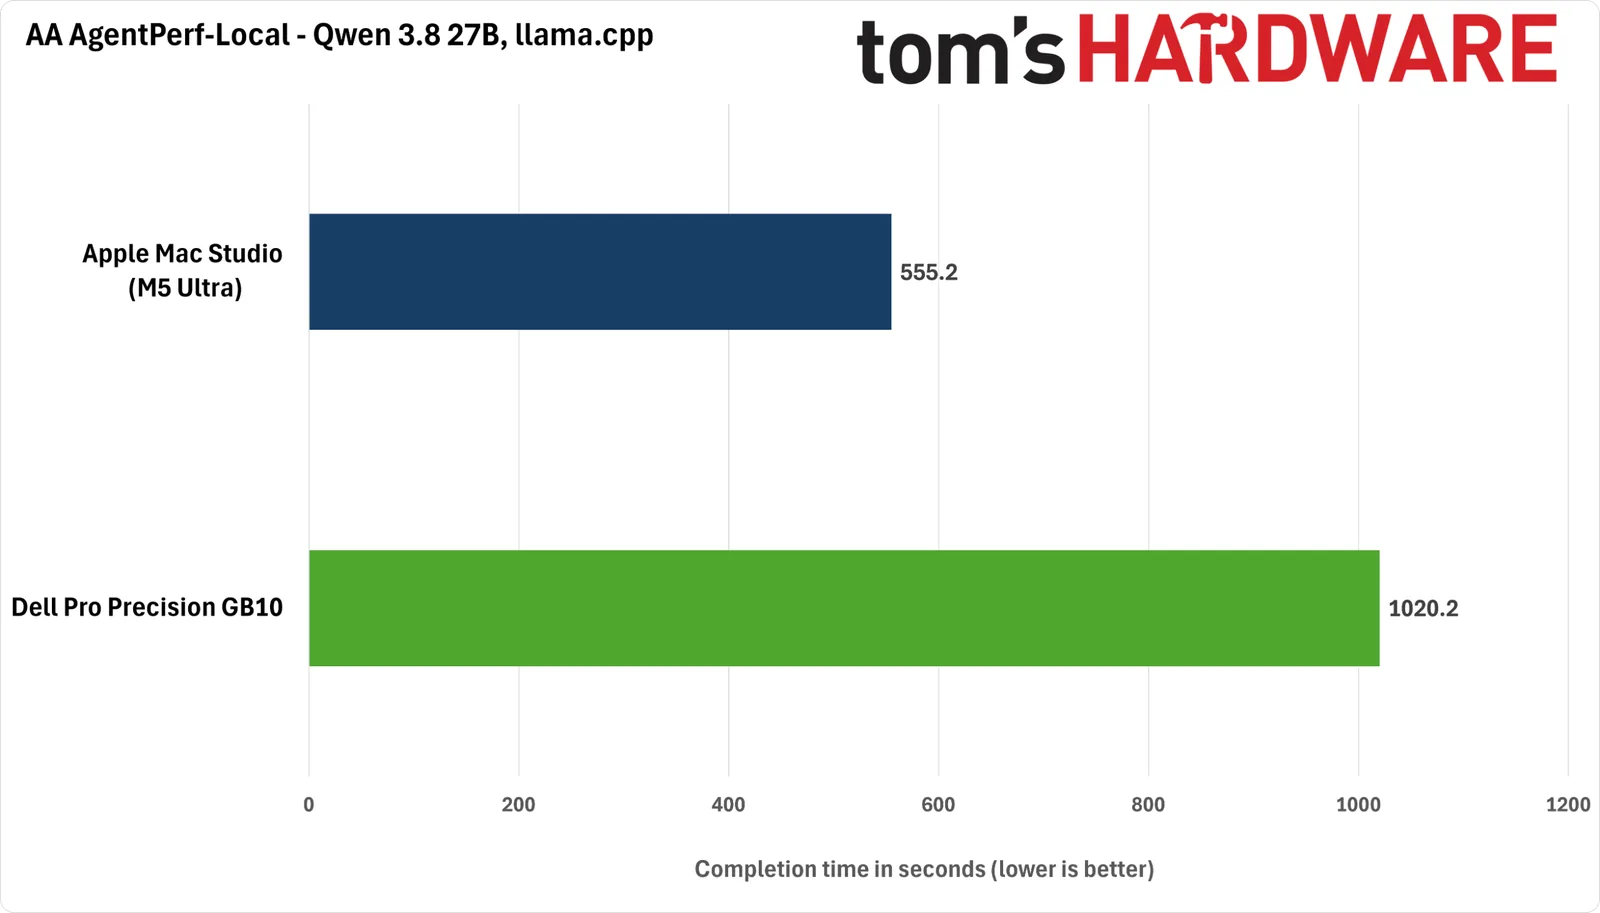
Para esta prueba siguió con el modelo denso Qwen 3.8 27B. Usó llama.cpp como motor de inferencia tanto en el Mac Studio como en un Dell Pro Precision GB10, un equipo casi idéntico al DGX Spark. En las dos plataformas activó la predicción de múltiples tokens (MTP) nativa del modelo para acelerar la decodificación.
Frente a un solo sistema tipo DGX Spark, el Mac Studio con M5 Ultra terminó la prueba agéntica en poco menos de la mitad del tiempo.
Podría parecer una comparación injusta por la diferencia de cómputo y de ancho de banda entre los dos. El medio la defiende por precio. Un Dell Pro Precision GB10 de 4 TB como el que probó cuesta ahora 10.000 dólares, así que enfrentarlo al Mac Studio de 12.000 dólares no es tan descabellado.
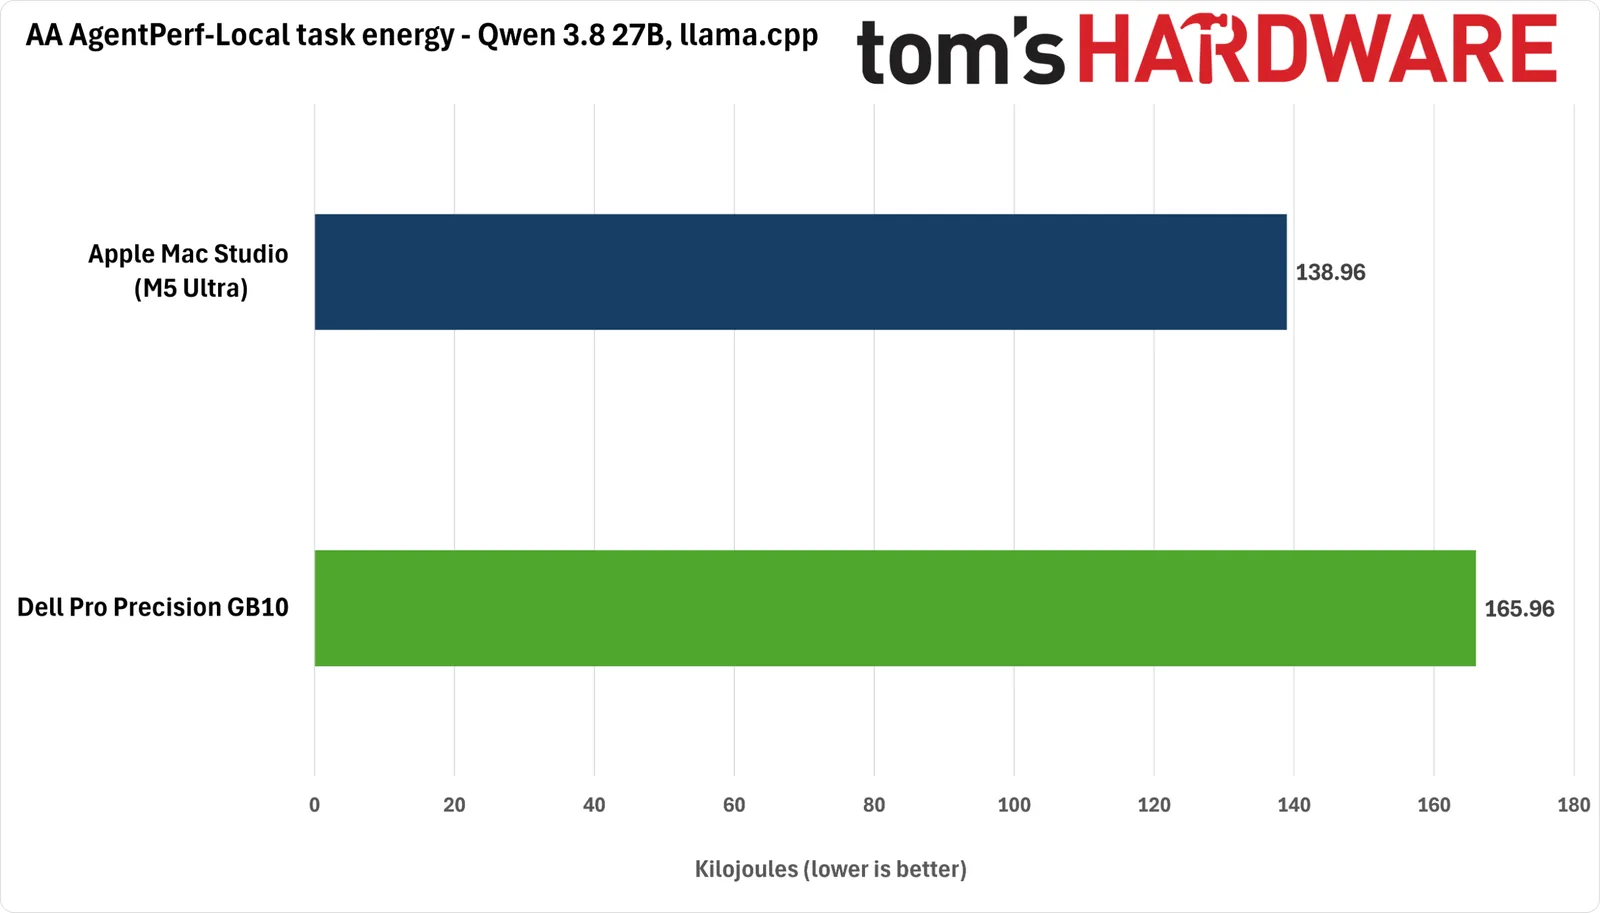
AgentPerf-Local hace una cantidad fija de trabajo en cada sistema, de modo que también permite comparar la eficiencia energética. Tom's Hardware midió el consumo en el enchufe de un Spark y del Mac Studio y lo convirtió en energía por tarea, en kilojoules.
Al menos con llama.cpp, el Mac Studio terminó AgentPerf-Local mucho más rápido que el DGX Spark y además consumió en total cerca de 16% menos energía por tarea. Otro motor de inferencia podría dar un resultado más favorable al sistema tipo Spark, pero en igualdad de condiciones la prueba deja muy bien parado al Mac Studio.
El medio multiplicó el tiempo de la tarea por la energía consumida para obtener el producto energía por demora (EDP) de cada sistema. Un EDP más bajo reúne en una sola cifra un tiempo corto y un consumo bajo. El EDP del Mac Studio fue menos de la mitad del que logró el DGX Spark con este modelo denso y esta carga.
¿Qué pasa con DeepSeek V4.1 Flash y GLM 5.3 Flash?
Qwen 3.8 27B no necesita 256 GB de RAM, ni siquiera 128 GB, para funcionar. Para exigir de verdad al Mac Studio, Tom's Hardware eligió dos modelos abiertos más grandes, que hoy están cerca de la cima de las pruebas de capacidad, GLM 5.3 Flash y DeepSeek V4.1 Flash 1017.
El Mac Studio con M5 Ultra puede cargar de forma nativa versiones cuantizadas de ambos en sus 256 GB de RAM. En el caso de GLM 5.3 fue una cuantización de cuatro bits, y en DeepSeek V4.1 Flash una de dos bits hecha por Unsloth. Ni siquiera esas versiones caben en un solo DGX Spark de 128 GB.
Ahí entra la capacidad de agrupar equipos de la plataforma de Nvidia. El medio ya había mostrado cómo juntar dos Spark aumenta la capacidad de inferencia local, y esa posibilidad pesa al compararlos con un Mac Studio como este.
El problema fue que el alza rápida de precios de los sistemas GB10 complicó el análisis de valor durante las pruebas. Por ejemplo, Lenovo dejó todos sus ThinkStation PGX como "próximamente" mientras el medio hacía las mediciones. Y los Dell Pro Precision GB10 que agrupó cuestan 10.000 dólares cada uno. Tom's Hardware dice no tener motivos para creer que el resto de los GB10 del mercado vayan a quedar mucho más baratos cuando pase esta volatilidad.
Se mire como se mire, un par de DGX Spark con SSD de 4 TB va a costar bastante más que un solo Mac Studio, aunque los 20.000 dólares de un grupo de dos Dell estén en el extremo alto del mercado. Según el medio, 15.000 dólares o más es una referencia más razonable, y aun así es 25% más dinero que un solo Studio con M5 Ultra.
Todavía no hay pruebas agénticas completas para estos modelos grandes. Aun así, el procesamiento del prompt y la velocidad de decodificación sirven para estimar qué sistema respondería más rápido en un flujo agéntico.
DeepSeek V4.1 Flash, ventaja para el grupo de Spark
Como hay pocos motores de inferencia compatibles con Apple Silicon, Tom's Hardware tuvo que usar llama.cpp para DeepSeek V4.1 Flash 1017. Peor aún, aun con la cuantización de dos bits, el Mac Studio no logra cargar a la vez los pesos del modelo y el modelo de decodificación especulativa DSpark que acelera la salida de tokens, así que se queda rendimiento en la mesa.
En cambio, la receta para servir DeepSeek V4.1 Flash en el grupo de dos Spark aprovecha la decodificación especulativa DSpark y el motor de inferencia TensorFold, que rinde más que llama.cpp.
Incluso con soporte MLX, llama.cpp corre lento con DeepSeek V4.1 Flash en el Mac Studio comparado con el grupo de DGX Spark. Entre un procesamiento del prompt más lento y una decodificación sin ayuda, el Mac quedaría en desventaja en trabajo agéntico con este modelo.
La receta comunitaria para dos Spark que publicó Mia's AI Lab con TensorFold es una gran ventaja para los dueños de esos equipos, aun considerando el trabajo extra de armar y administrar un grupo.
Donde el Mac con llama.cpp necesita entre 10 y 25 minutos para procesar los contextos más largos que se probaron con DeepSeek V4.1 Flash, el grupo de Spark con esa receta necesita como máximo menos de cinco minutos para el mismo trabajo, y TensorFold también es mucho más rápido en la decodificación. Para quien quiera correr este modelo en local, hoy un par de Spark es el ganador claro, según el medio.
GLM 5.3 Flash, y el efecto de TensorFold en el Mac
GLM 5.3 Flash es otro de los modelos abiertos líderes para inteligencia local. Su MTP no exige un modelo borrador aparte, así que en el Mac Studio se puede acelerar la decodificación sin los problemas de memoria que aparecieron con DeepSeek V4.1 Flash. Para el grupo de Spark, Tom's Hardware usó una receta preparada por Mia's AI Lab.
GLM 5.3 Flash corre mucho mejor en llama.cpp que DeepSeek V4.1 Flash, pero aun así el grupo de DGX Spark procesa los prompts mucho más rápido en todos los casos. La ventaja de ancho de banda de memoria del M5 Ultra hace que el Mac entregue más tokens por segundo en la decodificación, pero lo más probable es que cualquier turno agéntico termine antes en el grupo de Spark.
Para GLM 5.3 Flash existe además una receta de TensorFold para Apple Silicon. Con ella el medio pudo medir cuánto rendimiento extra aportan una cuantización de cuatro bits específica para MLX y un motor de inferencia que en teoría rinde más.
Esa receta dispara el rendimiento del Mac Studio frente a llama.cpp. Los tiempos de procesamiento del prompt con TensorFold se acercan bastante a los del grupo de Spark, y la decodificación es en promedio tres veces más rápida.
Tom's Hardware espera que con el tiempo lleguen mejores motores de inferencia y recetas para DeepSeek V4.1 Flash 1017 en el M5 Ultra, a medida que la comunidad ponga a sus agentes de código a trabajar sobre este hardware, porque el potencial de Apple Silicon está.
Balance
Un solo Mac Studio con M5 Ultra puede entregar un rendimiento y una eficiencia en IA local muy superiores a los de un solo DGX Spark cuando todas las piezas calzan. Y la comparación no es tan absurda como parece.
Los precios de los sistemas de memoria unificada suben al punto de que un solo Dell Pro Precision GB10 con SSD de 4 TB ya pasa los 10.000 dólares, cerca de los 12.000 dólares de la configuración de Mac Studio que se probó. El medio espera que la tendencia siga a medida que se agrave la escasez de RAM y de memoria NAND.
Pero la experiencia general de Tom's Hardware muestra que el rendimiento del M5 Ultra no está garantizado con cualquier modelo ni con cualquier motor de inferencia, en especial con los modelos grandes que uno querría cargar en 256 GB de RAM.
Con llama.cpp y modelos más chicos como Qwen 3.8 27B, el procesamiento del prompt de este Mac vuela. Para modelos más grandes como GLM 5.3 Flash y DeepSeek V4.1 Flash 1017 conviene asegurarse de tener a mano una receta de inferencia de mejor rendimiento. TensorFold corre GLM 5.3 Flash muy bien, pero todavía no soporta DeepSeek.
Como el medio ya había remarcado en su reseña del Mac Studio con M4 Max, el ancho de banda de memoria es solo uno de los factores del rendimiento en inferencia. Hay que mirar todo el conjunto de hardware y software para juzgar el rendimiento y la compatibilidad de modelos de estos equipos de memoria unificada, que son muy caros.
Aunque Apple está cerrando las brechas de su hardware para inferencia, el desarrollo y el soporte en torno a MLX todavía tienen camino por recorrer antes de alcanzar la madurez, el rendimiento y la variedad de modelos y motores que ofrece el hardware de Nvidia.
El valor duradero de la plataforma DGX Spark, más allá de su rendimiento y de su capacidad de crecer, es que la comunidad desarrolla y da soporte a tanto software y tan rápido que casi siempre hay una forma de correr un modelo nuevo poco después de que sus pesos aparecen en Hugging Face. Eso, siempre que se tengan suficientes Spark para agrupar y reunir la memoria necesaria.