Google presentó Gemini 4 Argon, su nuevo modelo de frontera, y las primeras mediciones independientes lo dejan a la altura de los rivales de OpenAI y Anthropic, con victorias en algunas pruebas importantes. No toma una ventaja clara, según el análisis que publicó The Decoder el 1 de octubre, pero para un modelo de frontera sale relativamente barato, al menos con el precio de lanzamiento.
Argon es el primer modelo de frontera de Google en más de siete meses, después de Gemini 3.1 Pro. Con él la empresa vuelve al grupo de los tres laboratorios de IA más avanzados, aunque Anthropic probablemente sigue adelante. El desarrollo fue largo y difícil, al punto de que Gemini 3.5, un modelo de frontera que ya estaba anunciado, se saltó por completo.
La mayoría tendrá que esperar
Argon llega primero a un grupo de "defensores de ciberseguridad de confianza" dentro del programa Fairwind. Ellos y los equipos internos de Google reciben el modelo sin las salvaguardas de ciberseguridad. Google justifica el despliegue gradual con un "enfoque por etapas" que, según la empresa, exigen las capacidades de IA de este nivel. La compañía también participa en el programa voluntario del gobierno de Estados Unidos que da acceso a las agencias antes del lanzamiento público.
Lo que reporten esos primeros usuarios alimentará los mecanismos de seguridad del modelo. Recién después Google planea abrirlo a desarrolladores, empresas y consumidores, partiendo por los clientes de pago de la API y los suscriptores de Google AI Ultra. No hay fecha. La empresa solo dice que será "lo antes posible".
¿Cuánto cuesta Gemini 4 Argon?
El precio ya está fijado, al menos como tarifa de lanzamiento. Son 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida. Los tokens de entrada en caché cuestan 95% menos, lo que deja unos 10 centavos por millón. Gemini 3.8 Flash tenía un descuento de caché de 90%. Con eso Google queda muy por debajo de los otros modelos de frontera en precio por token, aunque no en consumo de tokens, como se ve más abajo. Después de la promoción el precio regular sube a 4 y 20 dólares.
| Precio por millón de tokens | Entrada | Salida |
|---|---|---|
| Gemini 4 Argon (promoción) | 2 dólares | 10 dólares |
| Gemini 4 Argon (regular) | 4 dólares | 20 dólares |
| GPT-6 Astra | 10 dólares | 50 dólares |
| Claude Fable 5.1 | 10 dólares | 50 dólares |
| Claude Opus 5.5 | 4 dólares | 20 dólares |
Google también subió el límite de salida de 64.000 a un millón de tokens, y lo presenta como el primero de la industria. La idea es que si el modelo puede generar cientos de miles de tokens en una sola trayectoria, puede pensar con más detalle los problemas difíciles y resolverlos de una pasada. Para eso Google agrega a la API de Gemini una función nueva, Long Decode Continuation, que pausa las respuestas largas y las retoma con solicitudes sucesivas para que el razonamiento no choque con un tiempo límite.
La ventana de contexto de entrada se mantiene en un millón de tokens. Argon acepta texto, imágenes, video y audio como entrada, pero solo entrega texto.
Empata con GPT-6 Astra, pero gasta más tokens
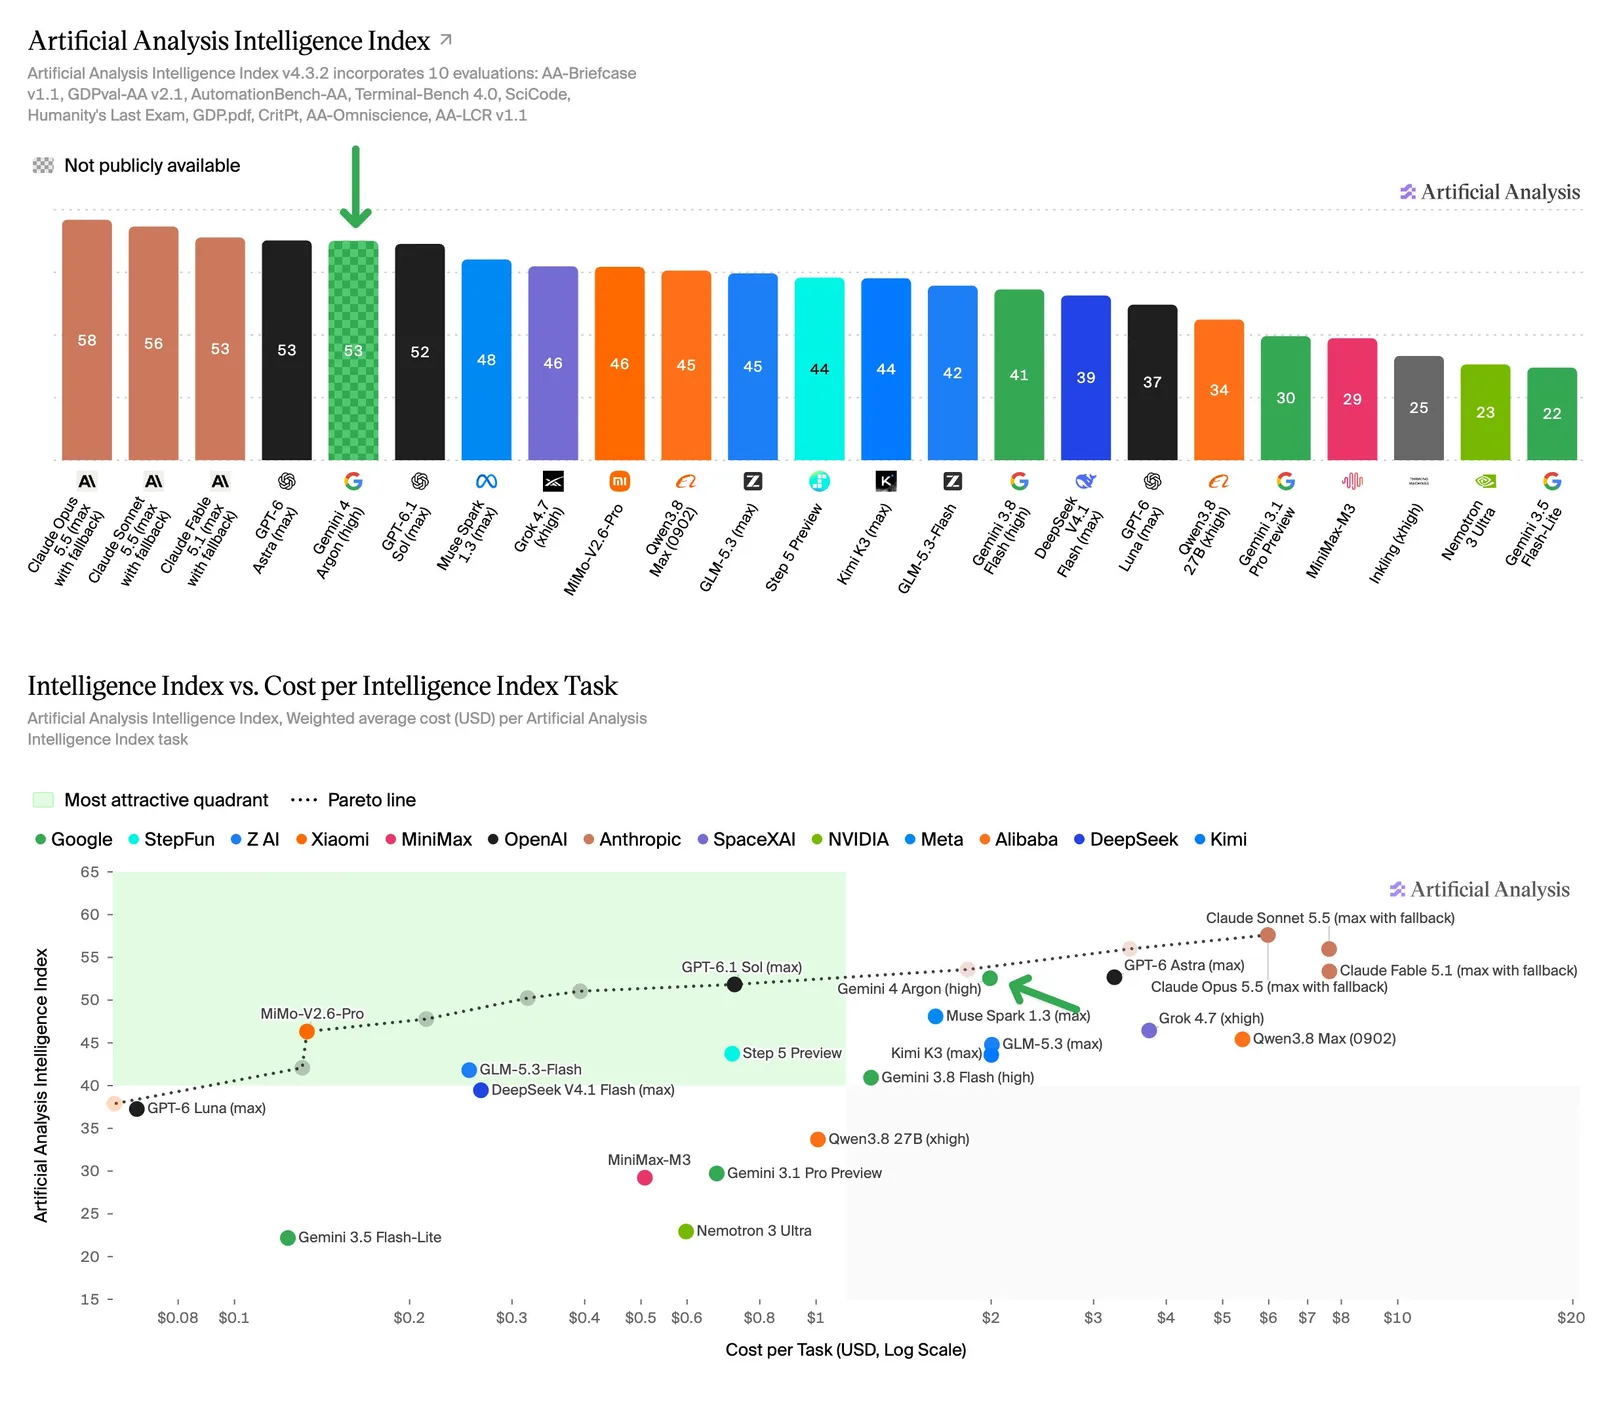
Artificial Analysis entregó una primera evaluación independiente. En su nivel de razonamiento más alto disponible, "High", Gemini 4 Argon marca 53 puntos en el Artificial Analysis Intelligence Index. Eso lo empata con GPT-6 Astra (max) de OpenAI y con Claude Fable 5.1, y lo deja un punto sobre GPT-6.1 Sol (max).
Los modelos de Anthropic siguen arriba. Claude Opus 5.5 tiene 58 puntos y Claude Sonnet 5.5, 56. Contra el último modelo de frontera de Google, Gemini 3.1 Pro Preview, Argon subió 23 puntos. "High" suele ser el nivel de razonamiento más alto de los modelos Gemini, aunque a veces también hay un modo especial "Deep Think".
Con el precio de promoción, una tarea del Intelligence Index cuesta 1,99 dólares. Es el 60% de lo que cuesta con GPT-6 Astra (3,26 dólares), pero 2,7 veces más que con GPT-6.1 Sol. Cuando termine el descuento el costo sube a 3,98 dólares, cerca de 20% más que GPT-6 Astra. La ventaja de precio viene de la tarifa por token y no de la eficiencia, porque Argon usa en promedio 62.000 tokens de salida por tarea, contra 27.000 de GPT-6 Astra.
Argon también avanzó en tareas agénticas, que según Artificial Analysis eran un punto débil de los modelos Gemini. En AutomationBench-AA, la variante de Artificial Analysis, queda primero con 77,5%, seis puntos sobre Claude Sonnet 5.5 (max). En Terminal Bench 4 llega a 57%, un salto de 53 puntos sobre Gemini 3.1 Pro Preview. Igual queda detrás de Claude Sonnet 5.5 (64%), Claude Opus 5.5 (60%) y GPT-6 Astra (59%).
Artificial Analysis destaca además su baja tasa de alucinación. En AA-Omniscience, una prueba que mide conocimiento factual y cómo el modelo maneja lo que no sabe, Argon alucina en el 15% de los casos. GPT-6 Astra (max) llega a 51% y GPT-6.1 Sol (max) a 54%. Argon tiende mucho más a admitir que no sabe una respuesta que a adivinar mal. Su precisión, en cambio, llega solo a 50%, cinco puntos menos que Gemini 3.1 Pro Preview y 13 menos que GPT-6 Astra (max, 63%). En el puntaje global de esa prueba Argon queda en 42 puntos, casi igual que GPT-6 Astra (43) y GPT-6.1 Sol (42).
Las cifras de Google y del Vals Index
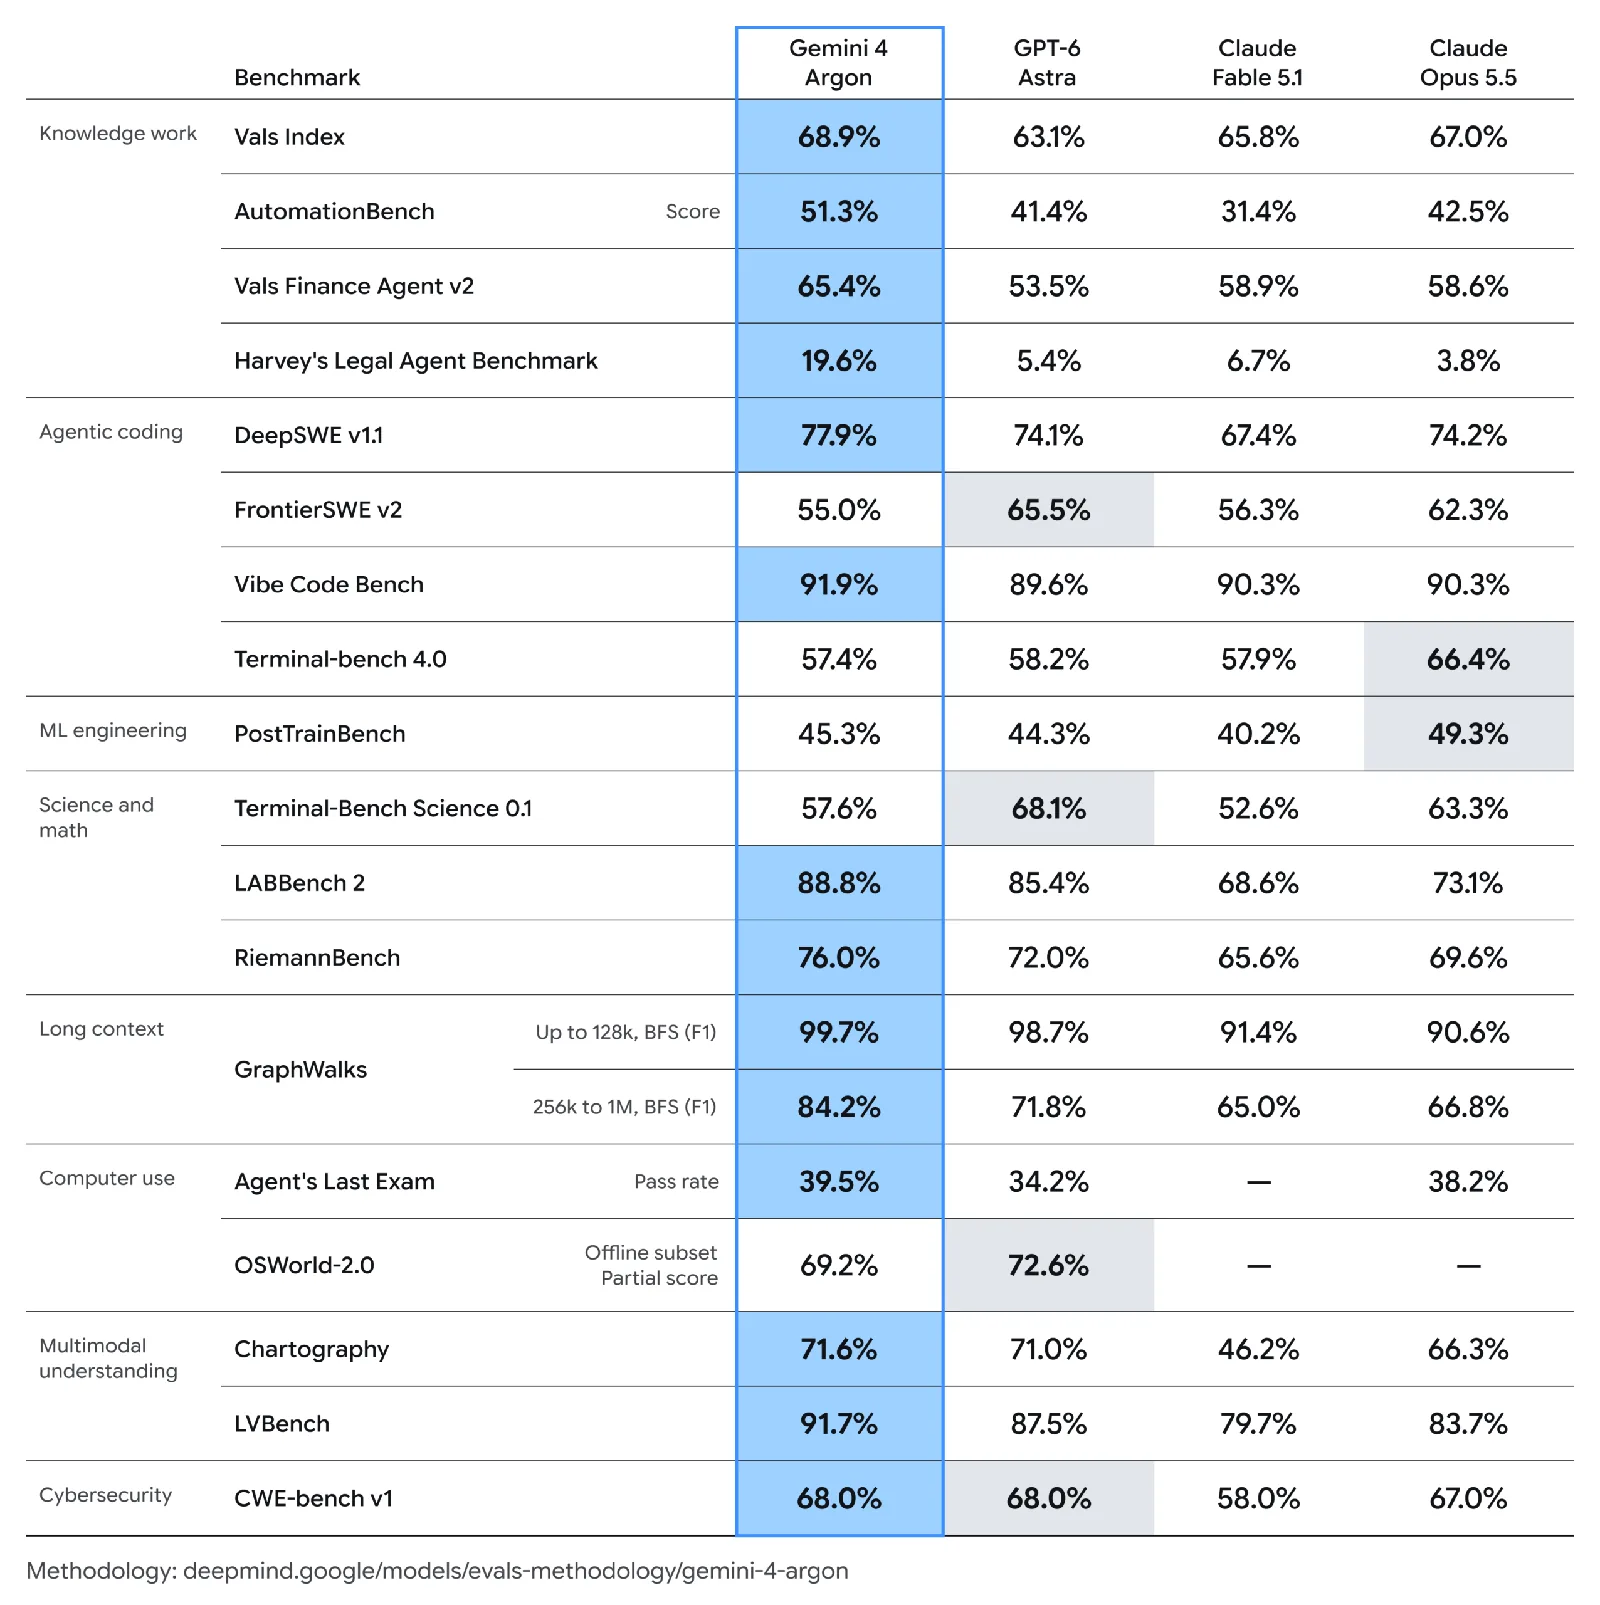
Los resultados internos de Google muestran un panorama más favorable. Argon lidera la mayoría de esas pruebas, a veces por mucho.
Argon también encabeza el Vals Index. Con 68,9%, queda primero según Vals AI y se convierte en el primer modelo Gemini en liderar ese índice. Termina entre los cinco primeros en 20 de las 22 pruebas evaluadas, con buen desempeño en finanzas, derecho, programación y seguridad. En esa misma medición, eso sí, Sonnet 5.5, el modelo de gama media de Anthropic, supera a Opus 5.5, el modelo más alto de la empresa, así que conviene tomarla con cautela.
Como siempre, los modelos de IA tienen que probarse en el uso real, y el rendimiento depende del modelo y también del software que lo rodea. Ese es hoy el punto débil de Google, porque la aplicación Gemini sigue detrás de Claude Cowork y ChatGPT Work.
Primero en las preferencias humanas de texto
En Arena, donde personas comparan respuestas de modelos de dos en dos, a Argon le va bien. En Text Arena, Gemini 4 Argon (High) queda primero con 1.525 puntos, 20 más que Claude Opus 4.6 (High), que está segundo. Eso lo pone como candidato fuerte para tareas de escritura, después de una larga sequía de modelos competitivos para redactar y con Opus 5.5 todavía sin alcanzar a Opus 4.6 en esas clasificaciones. El modelo anterior de Google, Gemini 3.8 Flash (High), estaba en el undécimo lugar.
Según Arena, Argon lidera en programación, consultas difíciles, seguimiento de instrucciones, consultas largas y escritura creativa. También queda primero en todos los campos profesionales evaluados y en las consultas en inglés, chino, ruso y en el conjunto de idiomas distintos del inglés.
En desarrollo web los resultados son más modestos. En Code Arena WebDev, Argon marca 1.679 puntos y queda octavo. Son 96 puntos más que Gemini 3.8 Flash (High), que estaba en el puesto 29, pero no llega a los primeros lugares.
En relación precio y rendimiento, Arena pone a Argon por delante. Con una tarifa combinada de 8 dólares por millón de tokens, mueve la frontera de Pareto de Text Arena y hoy es el modelo con mejor costo por rendimiento de esa clasificación.