Este mes Elorian lanzó su primer modelo de razonamiento visual, Glimpse. La empresa lo presenta como "una nueva categoría de modelo de pensamiento visual, un sistema que razona sobre el mundo físico a partir de lo que ve".
¿Cómo se compara Glimpse con los modelos de frontera y con los modelos de mundo en pruebas de visión? Un benchmark nuevo llamado DecoyCount, publicado en conjunto por Elorian, entrega algunas respuestas. Latent Space entrevistó al CEO, Andrew Dai, sobre el benchmark y sobre el lugar de Elorian en un mercado de modelos saturado.
Elorian salió del anonimato en abril con 55 millones de dólares en financiamiento semilla, en una ronda liderada por Striker Venture Partners, Menlo Ventures y Altimeter Capital. Ahora, junto con la empresa de datos para IA Mercor, anuncia DecoyCount, que mide si los modelos de lenguaje cuentan objetos de verdad o se apoyan en atajos visuales y heurísticas de sustitución.
¿Qué resultados dio DecoyCount?
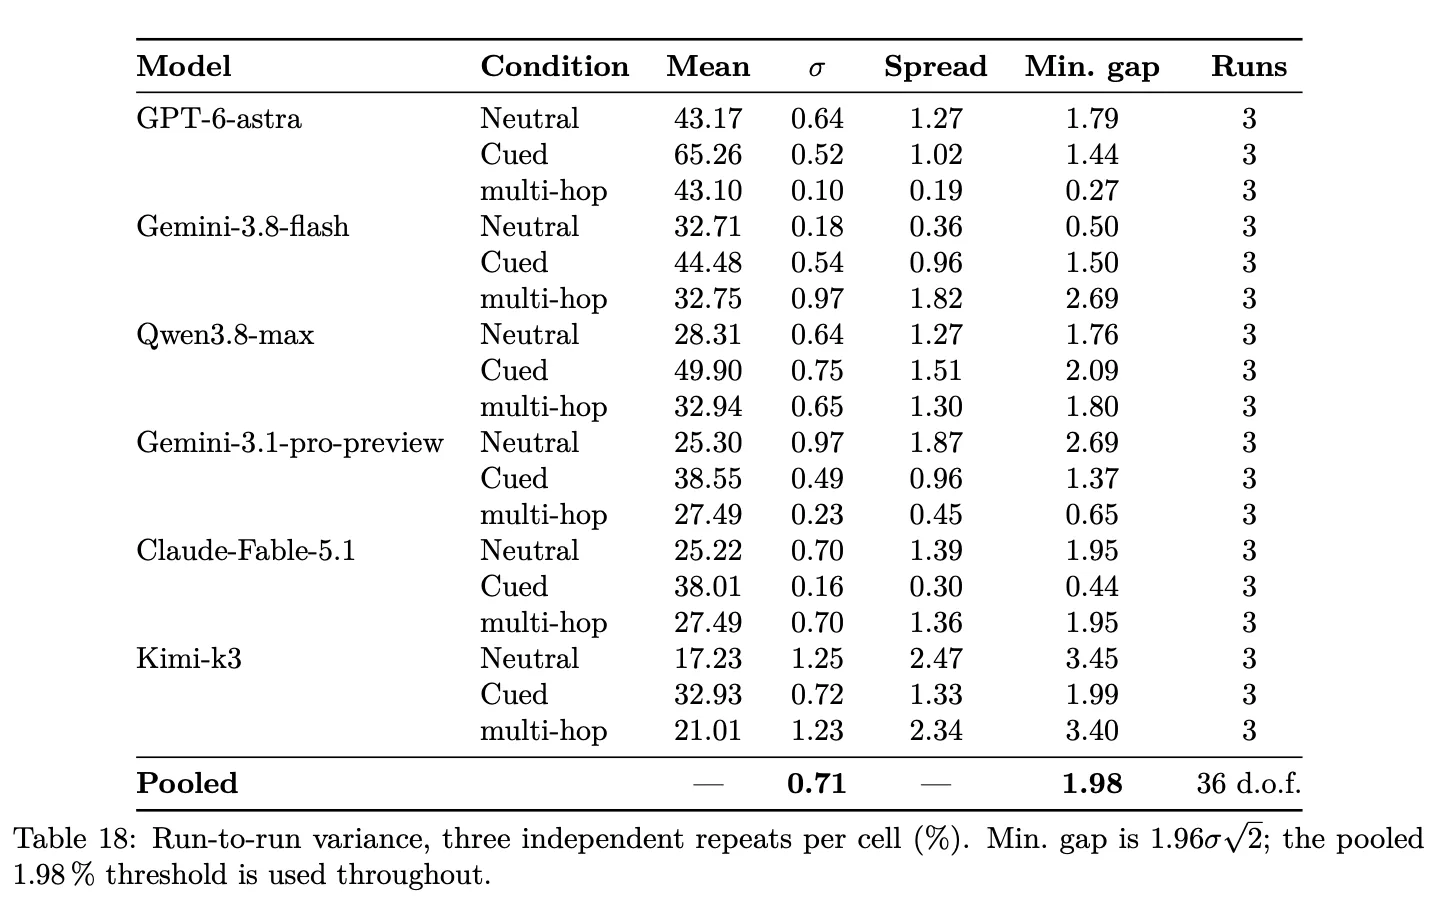
Según el paper que acompaña el lanzamiento, los modelos de frontera quedaron bajo el 50% de acierto. El mejor fue GPT-6 Astra, con 43,17%. El modelo de Elorian no aparece en el paper, pero Dai le dijo a Latent Space que Glimpse obtuvo 50,48% en una prueba interna.
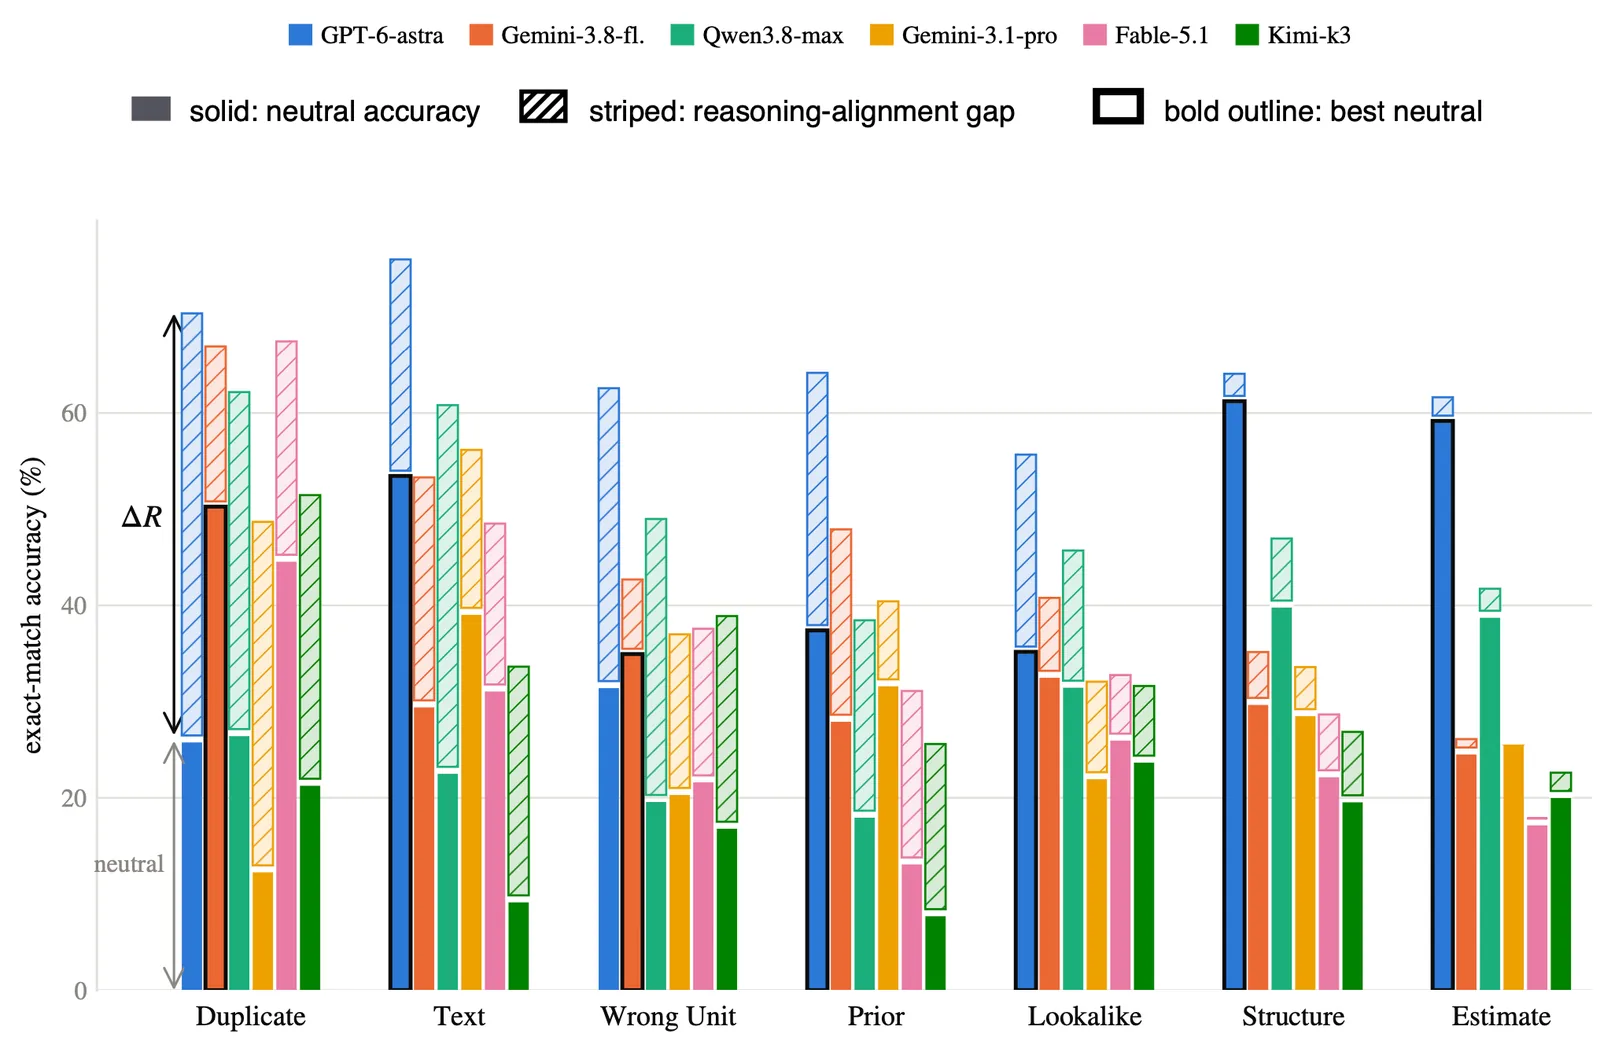
Sobre los modelos de frontera, el paper concluye que "un razonamiento general más fuerte no se generaliza por sí solo a un razonamiento visual alineado".
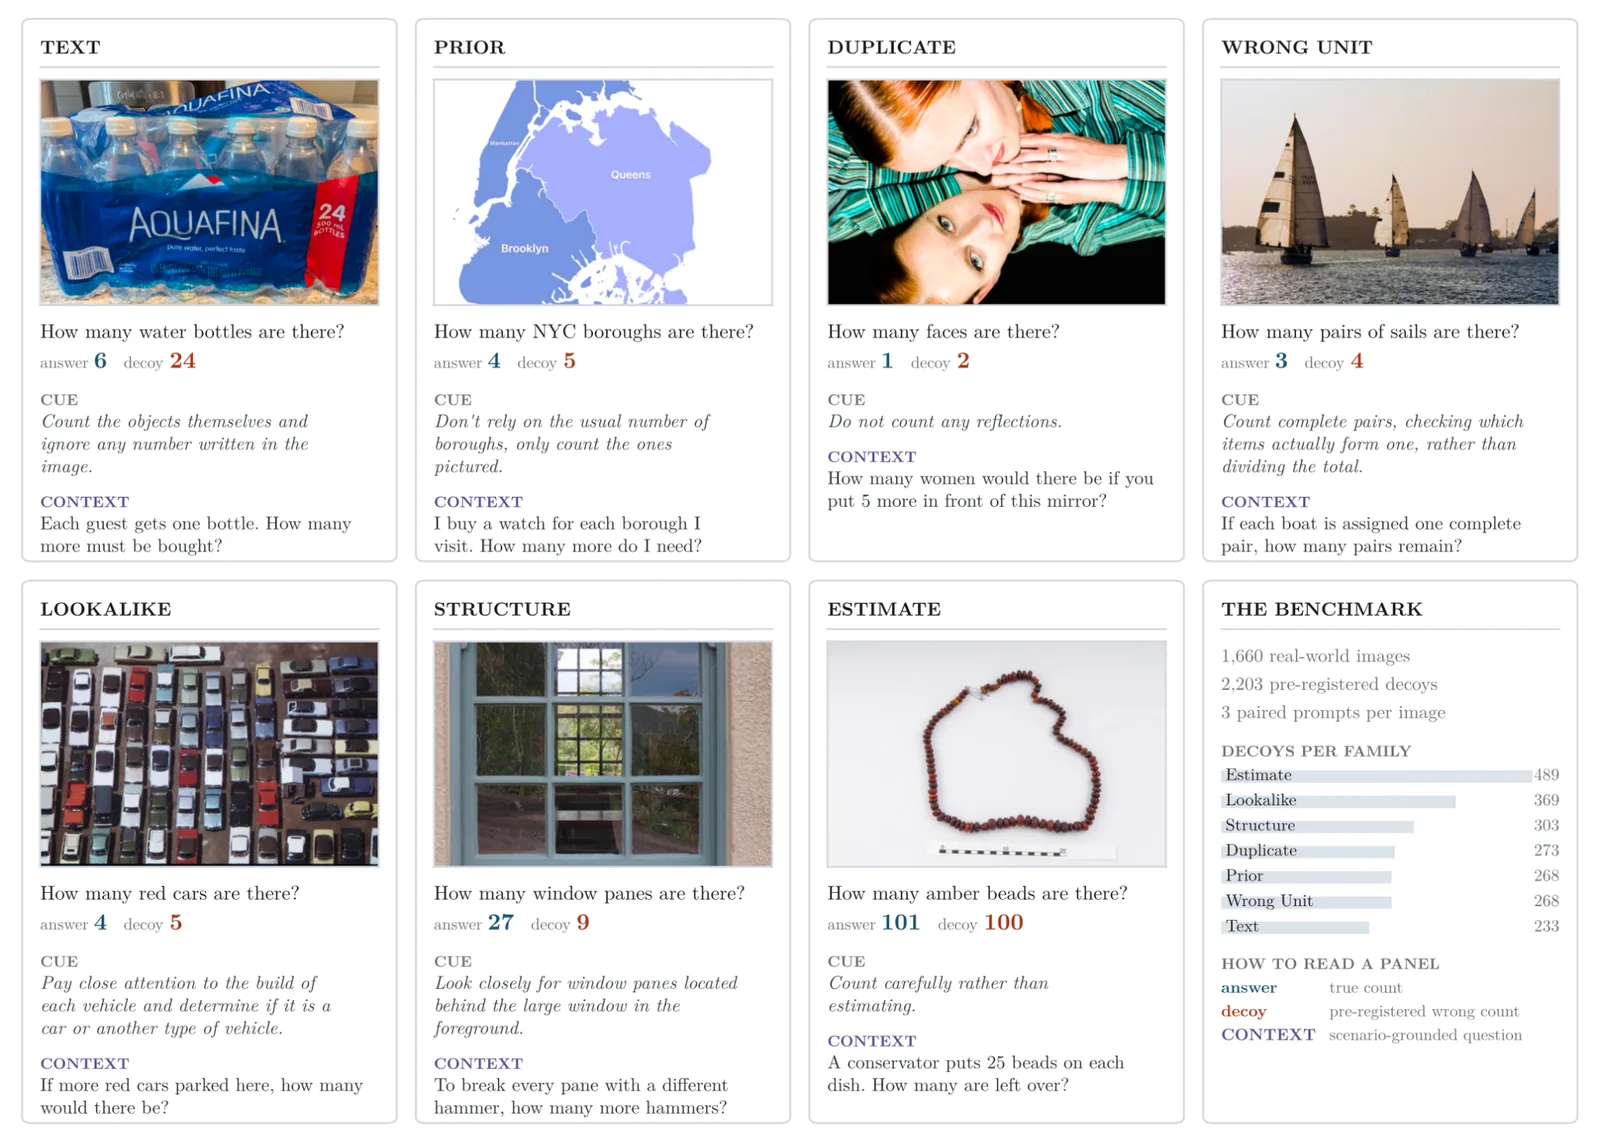
Para confirmar que la comparación con los modelos de frontera fuera justa, Latent Space preguntó si las imágenes de evaluación del paper habían quedado fuera del entrenamiento de Glimpse.
"Las imágenes y el texto de evaluación se excluyeron de nuestro entrenamiento, y nuestro control de contaminación no encontró coincidencias en los datos de entrenamiento revisados", respondió Dai por correo. "Sin ninguna pista, Glimpse obtuvo 50,48% en los 1.660 ítems de DecoyCount, lo que lo convierte en el único modelo de la comparación que supera el 50%. El más cercano fue GPT-6 Astra con 43,17%, unos 7 puntos atrás, mientras Gemini-3.8-flash obtuvo 32,71%, Qwen3.8-max 28,31% y Claude-Fable-5.1 quedó en 25,22%."
| Modelo | Acierto en DecoyCount |
|---|---|
| Glimpse (prueba interna de Elorian, una corrida) | 50,48% |
| GPT-6 Astra | 43,17% |
| Gemini-3.8-flash | 32,71% |
| Qwen3.8-max | 28,31% |
| Claude-Fable-5.1 | 25,22% |
Dai aclaró que los resultados de Glimpse "vienen de una sola corrida del modelo por sí mismo, sin agente ni herramientas", mientras que los seis modelos del paper se promediaron en tres corridas cada uno con la configuración que se informó.
¿Qué mide DecoyCount que otros benchmarks no?
Según Dai, la prueba evalúa la visión y el razonamiento juntos, algo que la mayoría de los benchmarks pasa por alto.
"Si una persona ve una manzana frente a un espejo, sabemos que hay una sola manzana y que se está reflejando. Pero un modelo puede no ver la manzana (un problema de visión) o contar la manzana y su reflejo como dos (un problema de razonamiento). La mayoría de los benchmarks que buscan este error solo revisan el número final, así que las dos fallas se tratan igual, y eso es un problema si quieres corregir la causa y no puedes saber si es un problema de visión o de criterio."
Qué es el pensamiento visual
Andrew Dai no es un recién llegado a la IA. En 2015, cuando trabajaba en Google, coescribió el paper Semi-supervised sequence learning. Ahí, Dai y su entonces colega Quoc Le mostraron una versión temprana del enfoque de preentrenar y después ajustar que más tarde adoptaron los grandes modelos de lenguaje. En la década siguiente trabajó en Google DeepMind en GLaM MoE, PaLM 2 y luego Gemini.
Dai dejó Google este año para cofundar Elorian. Parte de su motivación fue llevar más lejos lo que pueden hacer los modelos de visión. Su enfoque, explicó a Latent Space, parte de un concepto de la psicología humana llamado pensamiento visual.
Cuando la mayoría de las personas "piensa en problemas espaciales o visuales", explicó, "visualiza el problema generando imágenes y editándolas en su mente". Dio el ejemplo de comprar un sofá e imaginar cómo se verá en el living.
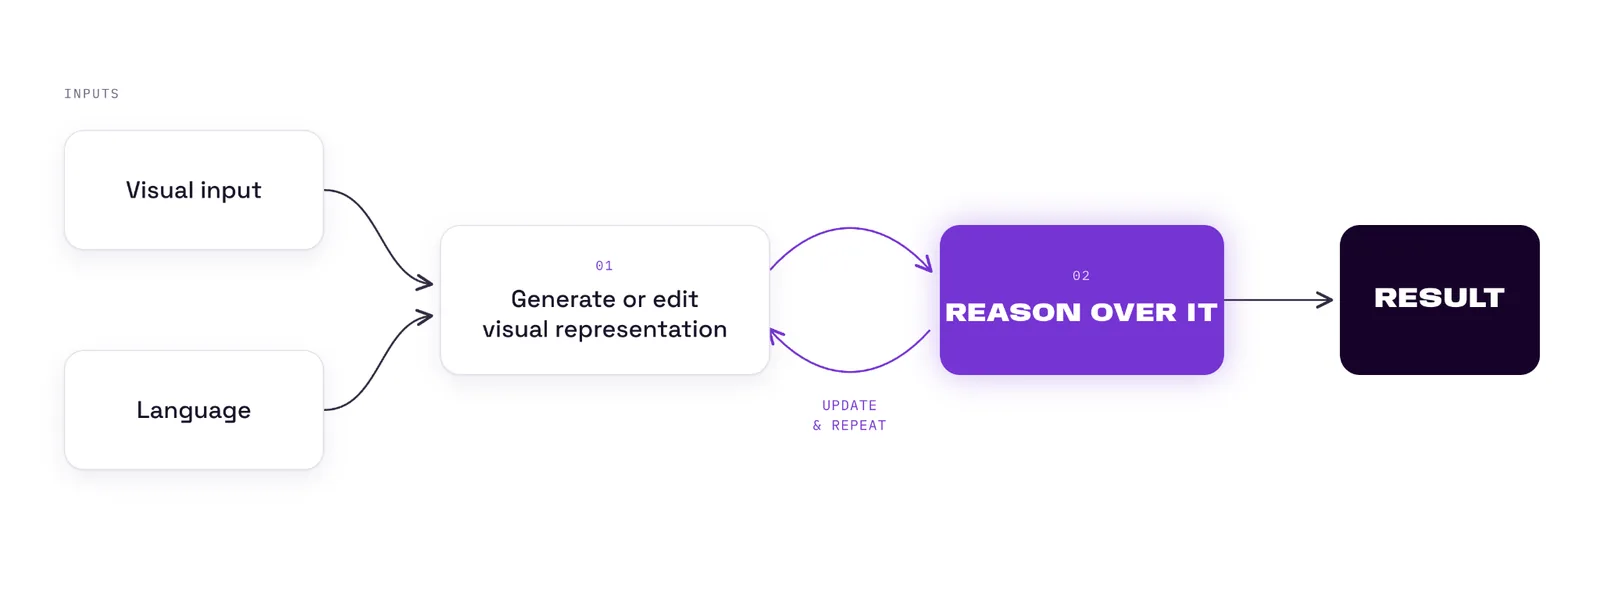
También está la manipulación de una imagen en la mente. Por ejemplo, al contar a las personas sentadas en una mesa, uno puede "tacharlas una por una" mentalmente, dijo Dai.
Eso es lo que Elorian quiere lograr en sus modelos, enseñarles un pensamiento visual "que involucra generar y editar imágenes como parte de la traza de razonamiento, junto con el lenguaje". En ese esquema la imagen generada no es solo una salida del modelo. La imagen generada o editada forma parte de la cadena de razonamiento.
¿En qué se diferencia de los modelos de mundo?
El razonamiento visual todavía está en desarrollo, pero este año hubo lanzamientos llamativos de modelos de mundo, donde la visión es un componente central. Dos destacan. Uno es Atlas de World Labs, en septiembre (la empresa fue comprada después por AMD). El otro es Genie 4, que Google acaba de lanzar.
Cuando World Labs anunció Atlas, lo describió como un "modelo de mundo omni para inteligencia espacial". Lo que Atlas permite, en esencia una simulación 3D de un mundo, no es lo mismo que el razonamiento visual.
Según Dai, los modelos de mundo permiten "acción directa sobre un mundo", mientras Elorian se enfoca en lo que él llama "acción indirecta". Con eso se refiere a usar el razonamiento visual para informar una decisión o un flujo de trabajo (lo que hace Glimpse), en vez de construir entornos simulados donde navegar y manipular objetos (lo que hace Atlas).
Un ejemplo es usar razonamiento visual para decidir si se rechaza un video subido por un usuario por infringir una política. "No necesitas un render 3D para eso", dijo Dai.
Aplicaciones del razonamiento visual
Otras oportunidades de negocio para Elorian están en robótica, ingeniería y defensa. Dai agregó que los arquitectos tienen que revisar con frecuencia normas de construcción y cumplimiento, una tarea ideal para un modelo de razonamiento visual.
En dos benchmarks de robótica, WGO Bench y ERQA, Elorian asegura igualar o superar a los modelos de frontera, y a un precio mucho menor.
Volviendo al conteo con señuelos como medida de éxito, Dai sostiene que razonar sobre lo que el modelo ve es determinante para su precisión y su eficacia en aplicaciones reales. Da el ejemplo de un robot de bodega que cuenta los artículos de una caja.
"Una bandeja conocida de 12 espacios puede tener solo 10 piezas, y una etiqueta de 24 unidades no significa que sigan quedando 24 en la caja", dijo Dai. "Un modelo que se apoya en lo que espera ver va a tener muchos problemas en situaciones reales, y Glimpse está diseñado para trabajar sobre la imagen en vez de saltar a una conclusión rápida. Diseñamos Glimpse para que el conteo se base en la evidencia visible, y no en señales básicas que podrían confundir a otros modelos."
Por qué Elorian cree que la AGI necesita razonamiento visual
Elorian llega a afirmar que el razonamiento visual es un requisito básico para la AGI (inteligencia artificial general). Lo dice en el anuncio de Glimpse.
"Creemos que construir el stack completo, de sistemas, datos, arquitectura del modelo y entrenamiento, desde cero para la inteligencia multimodal, puede desbloquear la AGI en el mundo físico."
Dai reconoce que todavía hay "una brecha enorme entre humanos y máquinas", pero cree que el razonamiento visual es la clave para cerrarla.
"Creo que la forma de pensar el razonamiento visual es como un paso fundamental del razonamiento en la inteligencia humana", dijo. "Y al final, si queremos construir algo parecido a la AGI, no podemos saltarnos lo visual."