Un benchmark nuevo muestra que los mejores agentes de IA resuelven cálculos de física teórica con la misma precisión que los especialistas líderes de cada subárea. Los investigadores que lo armaron dicen que a los agentes les falta "gusto" para elegir problemas, y que esa es una de las razones por las que todavía no aparecen descubrimientos de verdad.
Treinta y cinco investigadores del International Centre for Theoretical Sciences (ICTS), la Universidad de Harvard, KU Leuven y Google DeepMind, entre otras instituciones, publicaron TheoPhysEval. Son 50 problemas de investigación en física teórica, sin publicar y con respuesta verificable. Según los autores, un experto líder en la subárea tardaría un día o menos en resolver un problema típico sin ayuda de IA, y un especialista de un campo vecino tardaría bastante más.
El equipo probó agentes de IA comerciales sin darles pistas humanas. GPT-6-Astra, corriendo en el entorno de programación Codex de OpenAI, quedó primero. Encontró la respuesta correcta en 49 de 50 problemas (98%), con un costo promedio de menos de 3 dólares por problema y algo menos de 116 dólares por el benchmark completo.
¿Qué tipo de problemas trae el benchmark?
La colección deja fuera a propósito las grandes preguntas abiertas y se concentra en lo que los autores llaman problemas de "darle a la manivela", donde se aplican métodos conocidos a una pregunta levemente modificada. Los colaboradores a menudo cambiaban algunos valores de un cálculo de uno de sus propios papers recientes para que el resultado nuevo no se pudiera adivinar a partir del anterior. Según los investigadores, este tipo de problemas suele entregarse a estudiantes de doctorado como primer paso en la investigación.
Un ejemplo de la investigación sobre agujeros negros muestra cuánto exigen todavía. Para resolverlo hay que encontrar un paper antiguo, llevar sus ecuaciones de un espaciotiempo de cinco dimensiones a uno de cuatro y después calcular el resultado con un programa hecho a medida. El coordinador Suvrat Raju, coautor del paper antiguo, necesitó cerca de un día. Los autores estiman que, antes de los agentes modernos, solo un puñado de expertos tenía a la vez el conocimiento de física y la experiencia con esos métodos computacionales, y aun ellos habrían necesitado varios días.
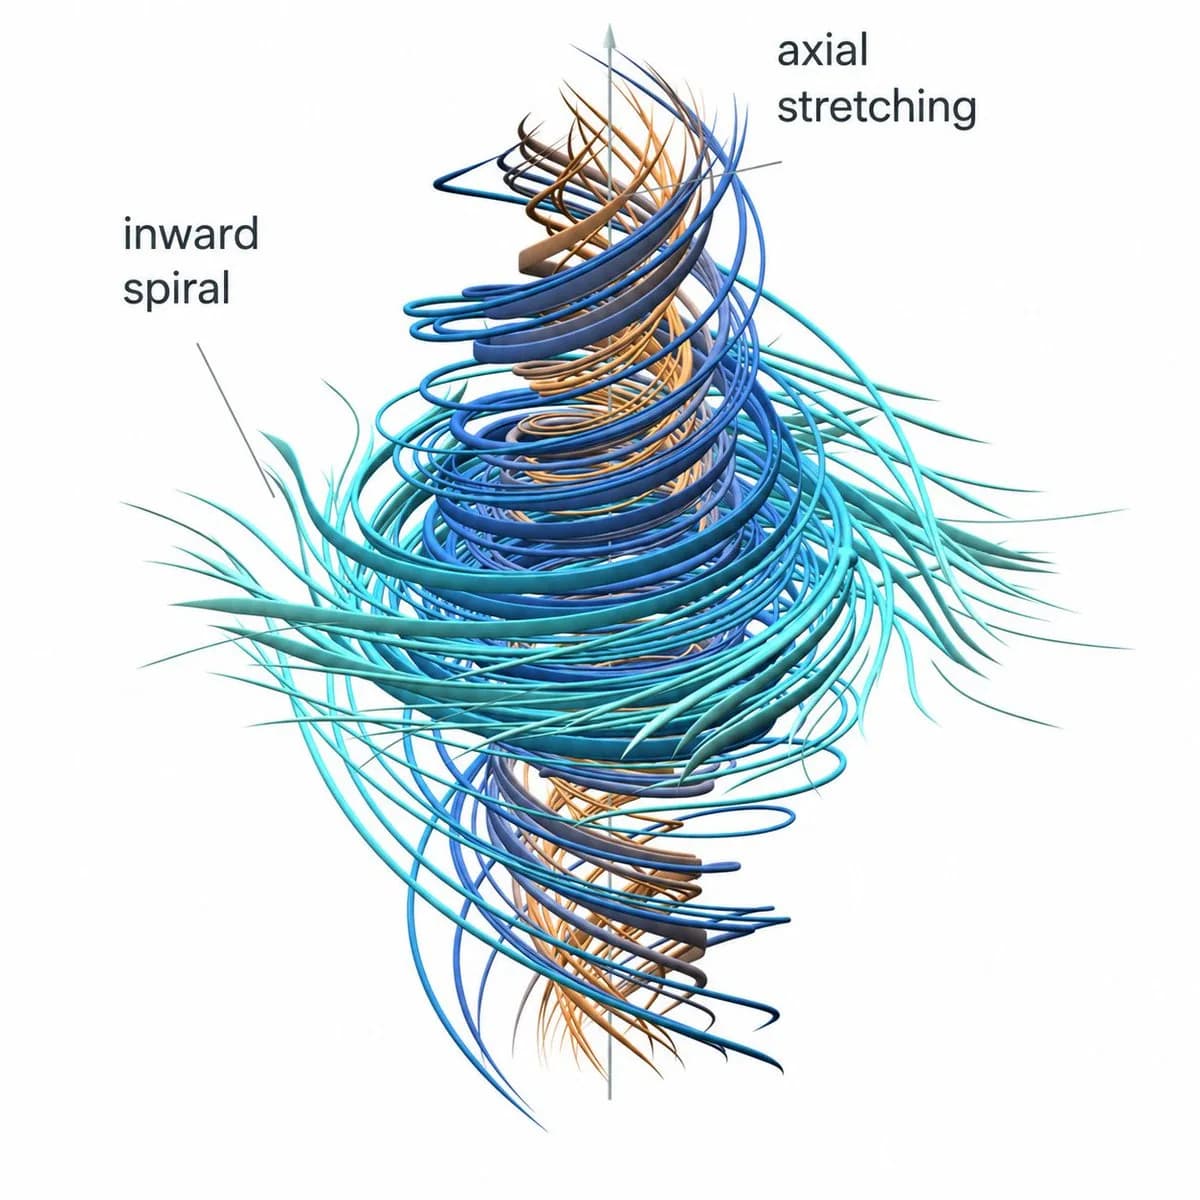
Los problemas cubren once subáreas de la física teórica, desde flujos de fluidos y procesos biológicos hasta física de partículas y cosmología. Cada agente hizo la prueba dos veces, una en condiciones realistas con búsqueda web y otra aislado, sin acceso a internet.
¿Cómo les fue a los demás modelos?
| Modelo | Entorno | Acierto con búsqueda web |
|---|---|---|
| GPT-6-Astra | Codex | 98% |
| Opus 5.5 | Claude Code | 92% |
| Gemini 3.8 Flash | 68% | |
| DeepSeek-V4.1-Flash | 54% | |
| GLM 5.3 | 42% |
Opus 5.5 de Anthropic, corriendo en Claude Code, quedó segundo con 92%. Gemini 3.8 Flash de Google llegó a 68%, mientras que los modelos de pesos abiertos DeepSeek-V4.1-Flash y GLM 5.3 alcanzaron 54% y 42%. Los modelos más débiles a veces cometían errores que un experto habría detectado de inmediato. En el problema del agujero negro, Gemini y GLM copiaron sin cambios las fórmulas del paper antiguo durante la corrida con búsqueda web. Esas fórmulas valen para cinco dimensiones, no para las cuatro que pedía el problema.
El acceso a internet cambió sorprendentemente poco. Sin búsqueda web, Astra y Opus sacaron 92% cada uno. Muchos problemas dependen de fórmulas de papers que por lo general los modelos no recibían. Los autores lo toman como señal de que los modelos de lenguaje líderes memorizaron, en la práctica, gran parte de la literatura de física teórica.
Con búsqueda web, Astra resolvió todo salvo un problema que no resolvió ningún modelo. Pedía una ecuación que produjera una curva dada. La solución de los expertos usa formas matemáticas especiales que solo cuentan como la ecuación diferencial pedida en un sentido amplio. Los autores admiten que el problema puede parecer "injusto", pero lo consideran realista porque los investigadores a menudo tienen que deducir la física de fondo a partir de datos imprecisos.
Varios errores de la IA eran errores de la pauta
En varios problemas, las consultas posteriores con los expertos revelaron errores pequeños y difíciles de ver en sus propias soluciones de referencia. Una vez corregidos, la respuesta de Astra resultó correcta en todos los casos.
Ese patrón podría explicar una aparente contradicción. Los agentes rinden mejor en TheoPhysEval que en otros benchmarks de física, como CritPt, aunque los autores consideran que sus problemas son en promedio más difíciles. Un estudio reciente encontró que algunos benchmarks de física teórica se corrigen mal y en ciertos casos subestiman mucho lo que pueden hacer los modelos.
Quien quiera revisar los resultados puede descargar los problemas y la configuración de la prueba como conjunto de datos en Hugging Face.
¿Por qué no hay descubrimientos todavía?
Los autores escriben que algunos de los modelos actuales más fuertes podrían haber superado ya a los mejores investigadores humanos en cálculos concretos, incluso en campos especializados. Lo llaman un hito mayor.
El efecto se nota aún más en matemáticas, señalan, donde los agentes de IA ya resolvieron problemas abiertos importantes. Según OpenAI, eso incluye el problema de Navier-Stokes sobre las ecuaciones que describen el flujo de fluidos, uno de los famosos Problemas del Milenio. La física teórica todavía no ha visto un avance comparable.
Los autores explican que un cálculo concreto con resultado verificable llega recién al final del proceso de investigación. Antes alguien tiene que construir una teoría y hacerle las preguntas "correctas". Cuando un problema resulta demasiado difícil, un buen investigador se cambia a uno relacionado que sea más simple e igual de interesante. Los agentes actuales no son buenos en eso.
Los físicos comparten además un sentido común, aunque lejos de unánime, de qué hace interesante un problema. Los agentes no parecen tener todavía ese "gusto". Cuando se les pide diseñar problemas nuevos, se pierden en detalles que a un humano le parecerían aburridos.
Los investigadores subrayan que estas observaciones no se pueden cuantificar y que no son un pronóstico. Creen que los agentes de IA podrían hacer investigación de primer nivel por su cuenta en un futuro cercano, pero que para eso hará falta más que la capacidad de resolver problemas.
La IA ya cambia la formación de los físicos
Los autores ya ven consecuencias para la formación. Hasta hace poco, algunos problemas del benchmark habrían funcionado bien como primeros proyectos de investigación para quienes recién empiezan. Eso ya no es apropiado, salvo que el objetivo sea explícitamente trabajar el material.
También apuntan a un problema estructural. La física teórica siempre ha necesitado mucho menos dinero que la experimental, y eso ha mantenido relativamente parejas las oportunidades en el área. Los agentes capaces podrían cambiarlo. Los problemas del benchmark todavía son baratos de resolver, y la corrida completa de Astra costó cerca de 116 dólares, pero los autores esperan que la necesidad de recursos suba fuerte con problemas más difíciles. Llegado ese punto, el presupuesto de un grupo podría pesar más en lo que logra, incluso en física teórica, y eso abre preguntas sobre acceso e igualdad de oportunidades.
Las matemáticas ya tienen ese debate, por ejemplo en torno a la Declaración de Leiden. Los autores sostienen que la física teórica también debería darlo antes de que la IA trastoque el área. Al menos una escuela de la física ha pedido hasta ahora a los investigadores "callarse y calcular". Si el gusto y la visión empiezan a pesar más, puede que los físicos tengan que "detenerse a pensar".