NVIDIA lanzó el 15 de octubre Nemotron 3.5 Super VL, un modelo abierto de 120.000 millones de parámetros que, según la compañía, completa tareas más rápido y con mayor precisión que el resto de su categoría en agentes especializados que funcionan todo el tiempo.
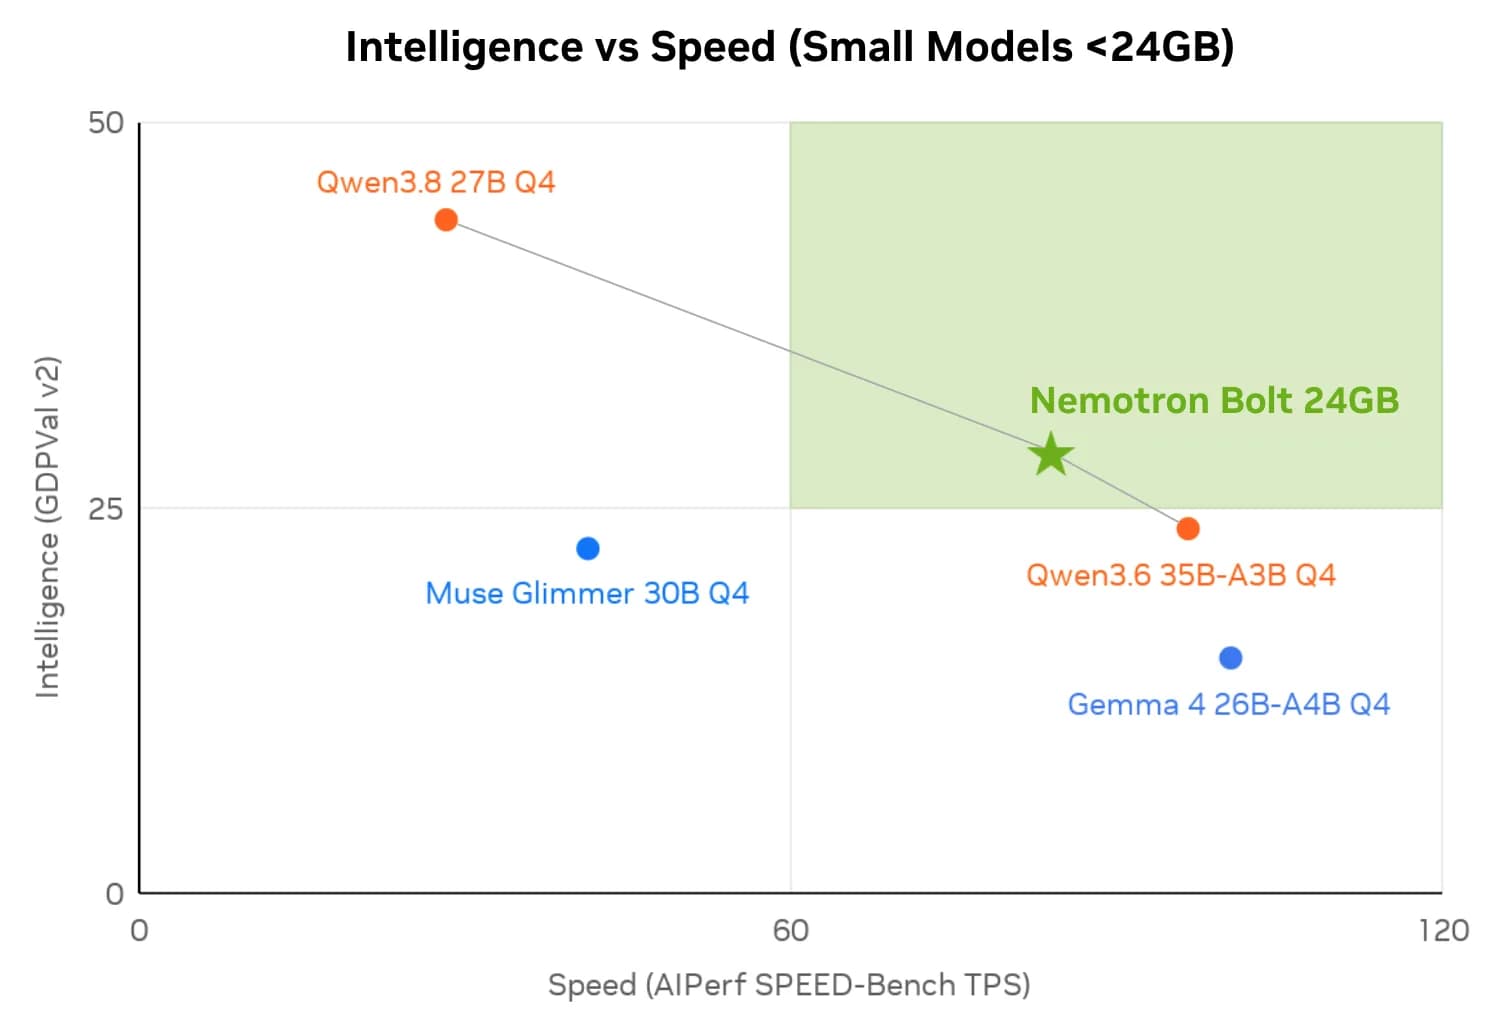
Lo acompañan dos modelos para el borde. Nemotron 3.5 Bolt 74B-A9B 24GB busca equilibrar inteligencia y velocidad por cada GB de memoria en cargas agénticas locales. Nemotron 3.5 Bolt E4B 4GB está optimizado en inteligencia por GB para agentes conversacionales rápidos.
Super VL y Bolt 74B-A9B ya están disponibles. Bolt E4B llega el 23 de octubre. Entre los tres modelos abiertos cubren todo el rango de despliegue de agentes, desde servidores empresariales grandes hasta dispositivos de borde y hardware local.
La idea de NVIDIA es que cualquier organización que quiera correr agentes sobre su infraestructura tenga un modelo abierto y optimizado para su nivel, sin elegir entre capacidad y facilidad de despliegue.
Super VL y Bolt se suman a la familia Nemotron junto a Lightning y Ultra. Lightning, lanzado en agosto, atiende cargas de alto rendimiento. Ultra se encarga de las tareas de razonamiento más difíciles, y Bolt lleva la inteligencia al borde.
Super VL, precisión de frontera con un quinto del tamaño
Super VL se desarrolló junto a la Nemotron Coalition. NVIDIA afirma que su precisión en tareas agénticas multimodales (seguir instrucciones, usar herramientas, flujos de negocio de varios pasos y comprensión visual) es comparable a la de su modelo de razonamiento más grande, con cerca de un quinto de los parámetros.
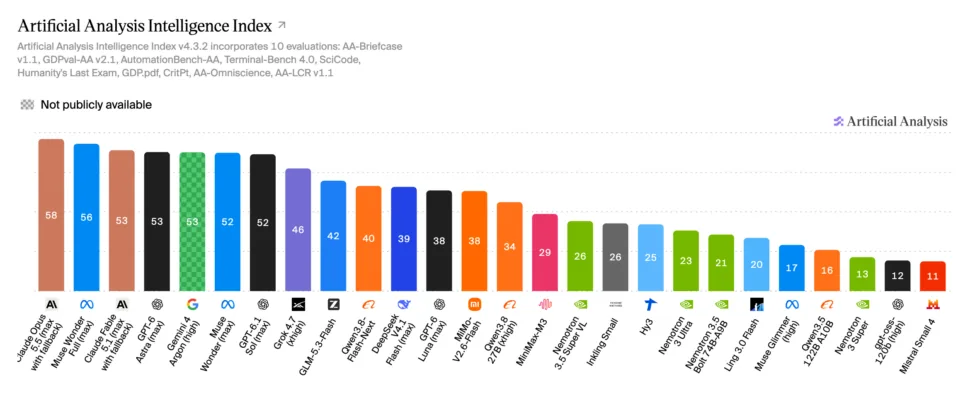
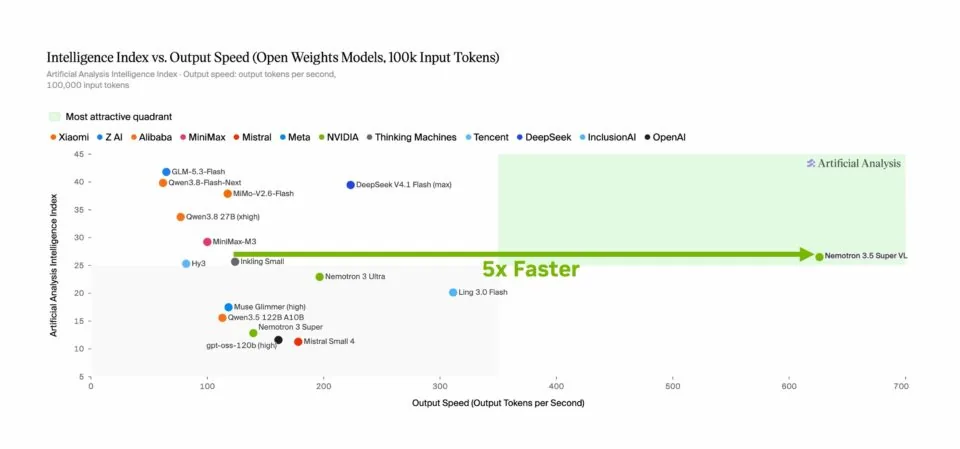
NVIDIA lo presenta como el modelo agéntico abierto más rápido de su clase, 5 veces más rápido que el siguiente. Eso permite a los agentes empresariales completar tareas de alto volumen en flujos que se extienden por días o semanas.
A diferencia de los modelos cerrados de frontera, Super VL se puede post-entrenar con datos propios, desplegar en infraestructura propia y supervisar por completo.
Bolt, inteligencia agéntica en el borde
Bolt 74B-A9B 24GB está pensado para correr tareas agénticas cotidianas en local sobre NVIDIA RTX o DGX Spark. Usa cuantización nativa de 2 bits para caber en 24 GB de memoria y funcionar al lado de otras aplicaciones.
Frente a modelos con una huella de memoria parecida, NVIDIA dice que logra un buen equilibrio. Es lo bastante capaz para la mayoría de los trabajos y bastante más rápido que los modelos más inteligentes.
Con Bolt 74B-A9B 24GB, los usuarios pueden delegar proyectos a los entornos de agentes locales más usados (desde investigar en la web hasta redactar o depurar código) sin mandar esas cargas a la nube. Es el modelo abierto número 1 de su clase en PinchBench y el número 2 en BrowseComp.
Bolt E4B 4GB apunta a agentes físicos y conversacionales sobre GeForce RTX, Jetson y RTX/DGX Spark. Combina conversación natural con capacidades agénticas de varios turnos para asistentes de voz locales rápidos, personajes interactivos e interfaces embebidas.
¿Quién está adaptando Super VL?
Según NVIDIA, decenas de organizaciones de distintas industrias están post-entrenando Super VL con sus propios datos, herramientas, políticas y flujos de trabajo para subir la precisión en tareas específicas.
Scale AI post-entrenó el modelo para el agente de financiamiento a proveedores de Skydance y para el agente de due diligence de fusiones y adquisiciones de EY. AfterQuery lo adaptó para Hebbia en el análisis de contratos de crédito. AI21 y Alice lo post-entrenaron para resistencia a ataques de ciberseguridad. Mercor lo entrenó sobre el benchmark de programación APEX-SWE, para agentes que planifican, escriben y depuran código. ModelScope permite afinarlo con su framework ms-swift para aplicaciones multimodales específicas.
Otras organizaciones que lo están adaptando son Ramp, para inteligencia sobre documentos financieros; Dream, para investigación de ciberseguridad y análisis de vulnerabilidades; Lila Sciences, para descubrimiento científico y búsqueda, y R1, para análisis de reclamos médicos y gestión del ciclo de ingresos. TrainLoop lo post-entrenó con datos de dermatología de Nolla, la primera empresa autorizada para que una IA redacte recetas iniciales a pacientes.
Entre las plataformas de software que integran Nemotron 3.5 Super VL están:
- Atlassian, para búsqueda agéntica entre aplicaciones como Jira y Confluence.
- CrowdStrike, que lo adapta para defensa agéntica (blue teaming) en seguridad empresarial.
- Dassault Systèmes, en diseño de ingeniería y simulación.
- Perplexity, para búsqueda y tareas agénticas en Perplexity Search y Computer.
- Salesforce, que lo adapta para agentes que digitalizan y automatizan trámites gubernamentales en entornos seguros mediante Missionforce Operations.
- Synopsys, cuyo software de verificación de diseño de semiconductores interopera con el modelo.
¿Qué ve realmente Super VL?
Las capacidades de visión y lenguaje de Super VL apuntan a lo que un agente encuentra en la práctica. Reconocimiento óptico de caracteres, tablas, gráficos e información estructurada dentro de documentos visuales.
El modelo procesa una página web, extrae el texto, lee gráficos y devuelve conclusiones sobre lo que encuentra. Lo mismo hace con PDF y otros documentos habituales en el trabajo de un agente. Al juntar la comprensión de texto y de imagen en un solo modelo, los agentes no necesitan repartir tareas entre sistemas separados y el contexto se mantiene del documento al dato y a la decisión.
Abierto para controlar seguridad y privacidad
El modelo se publica con pesos abiertos, conjuntos de datos abiertos y recetas de entrenamiento. Las organizaciones pueden correrlo donde lo exijan sus requisitos de seguridad y residencia de datos, y adaptarlo sin depender de las restricciones de un proveedor.
NVIDIA pone dos ejemplos. En seguros, un agente adaptado puede revisar reclamos en busca de señales de fraude de forma repetida. En servicios financieros, un agente puede revisar puntajes de crédito y marcar actividad según los criterios de préstamo de la propia institución. El modelo y los datos se quedan dentro de la empresa.
La personalización se apoya en NVIDIA NeMo, flujos en Python y conjuntos de datos abiertos.
Super VL se entrenó con unos 26 billones de tokens entre preentrenamiento (conjuntos de datos aquí) y preentrenamiento continuado. Después pasó por un post-entrenamiento con cerca de 3,8 millones de muestras y aprendizaje por refuerzo en decenas de entornos.
NVIDIA también publica en Hugging Face conjuntos de datos sobre uso agéntico de herramientas, finanzas, seguimiento de instrucciones, contexto largo, equidad y comprensión de visión y lenguaje, además de los entornos de aprendizaje por refuerzo de NeMo Gym.
NVIDIA NIM empaqueta el modelo como microservicio listo para producción, con configuraciones validadas y soporte empresarial, y se actualiza cada dos semanas con parches de seguridad y mejoras de rendimiento. Corriendo sobre NVIDIA Dynamo, según la compañía, una organización puede atender hasta 8 veces más usuarios con 85% menos de latencia.
Super VL ya está disponible en Hugging Face, OpenRouter, la comunidad de ModelScope y como NVIDIA NIM.
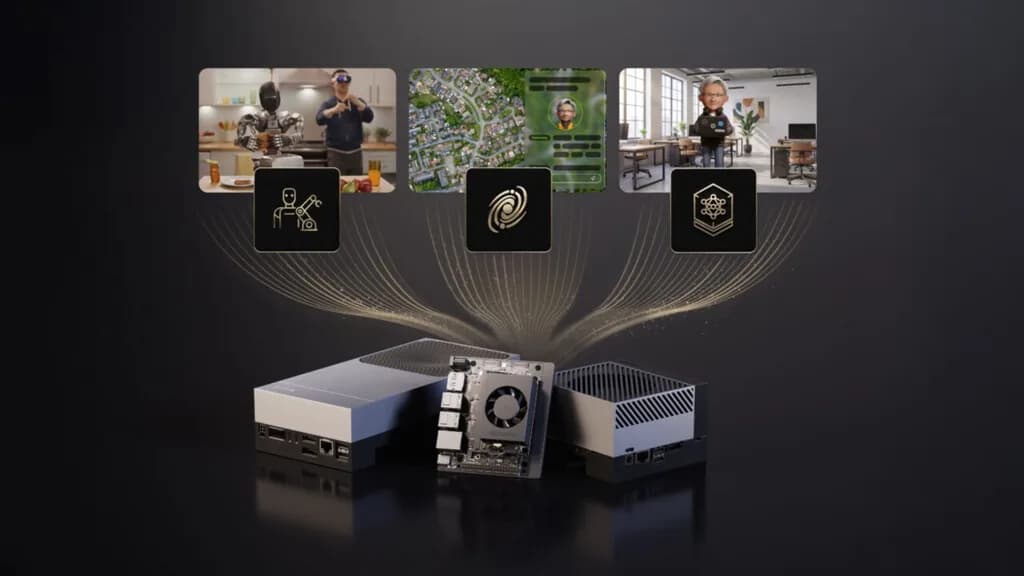
Corre en DGX Spark, DGX Station y RTX
Nemotron 3.5 Super VL funciona en todo el hardware de NVIDIA. En DGX Spark, DGX Station, RTX PRO y sistemas RTX para inteligencia local en el escritorio, en NVIDIA Jetson en el borde, y en centros de datos y la nube.
Nemotron 3.5 Bolt 74B-A9B 24GB ya está en Hugging Face, con soporte para llama.cpp, Ollama, LM Studio, Unsloth y vLLM. Está hecho para los portátiles NVIDIA RTX Spark, que llegan el 16 de octubre, y también corre en PC con GeForce RTX, DGX Spark, DGX Station y estaciones RTX PRO.
Los pesos abiertos de Super VL están en Hugging Face, y el detalle de la arquitectura está en el blog técnico de NVIDIA.