NVIDIA corrió el modelo Qwen3.6-27B sobre un único kit de desarrollo Jetson AGX Thor en el benchmark MLPerf Inference v6.1 Edge Agentic y completó las 1.007 vueltas de la carga de rendimiento en 24 minutos y 36 segundos, con 52,33 tokens por segundo. La referencia publicada en llama.cpp para el mismo equipo tarda 2 horas y 37 minutos, así que la diferencia es de 6,4 veces. El resultado usa el runtime TensorRT Edge-LLM, cuantización NVFP4, predicción de múltiples tokens (MTP) basada en árbol y reutilización de caché KV.
Los agentes de IA se están moviendo desde los centros de datos en la nube hacia vehículos, robots y otros dispositivos de borde. A diferencia de un chatbot que responde un solo prompt, un agente trabaja a través de una secuencia de pasos. Selecciona herramientas, evalúa sus resultados y sigue razonando dentro de una conversación cada vez más larga.
Ese flujo impone exigencias nuevas a la inferencia en el borde. El modelo tiene que generar tokens rápido, procesar de forma eficiente historiales compartidos largos y producir llamadas a herramientas válidas dentro de un presupuesto acotado de consumo y de memoria.
¿Qué mide exactamente el test agéntico?
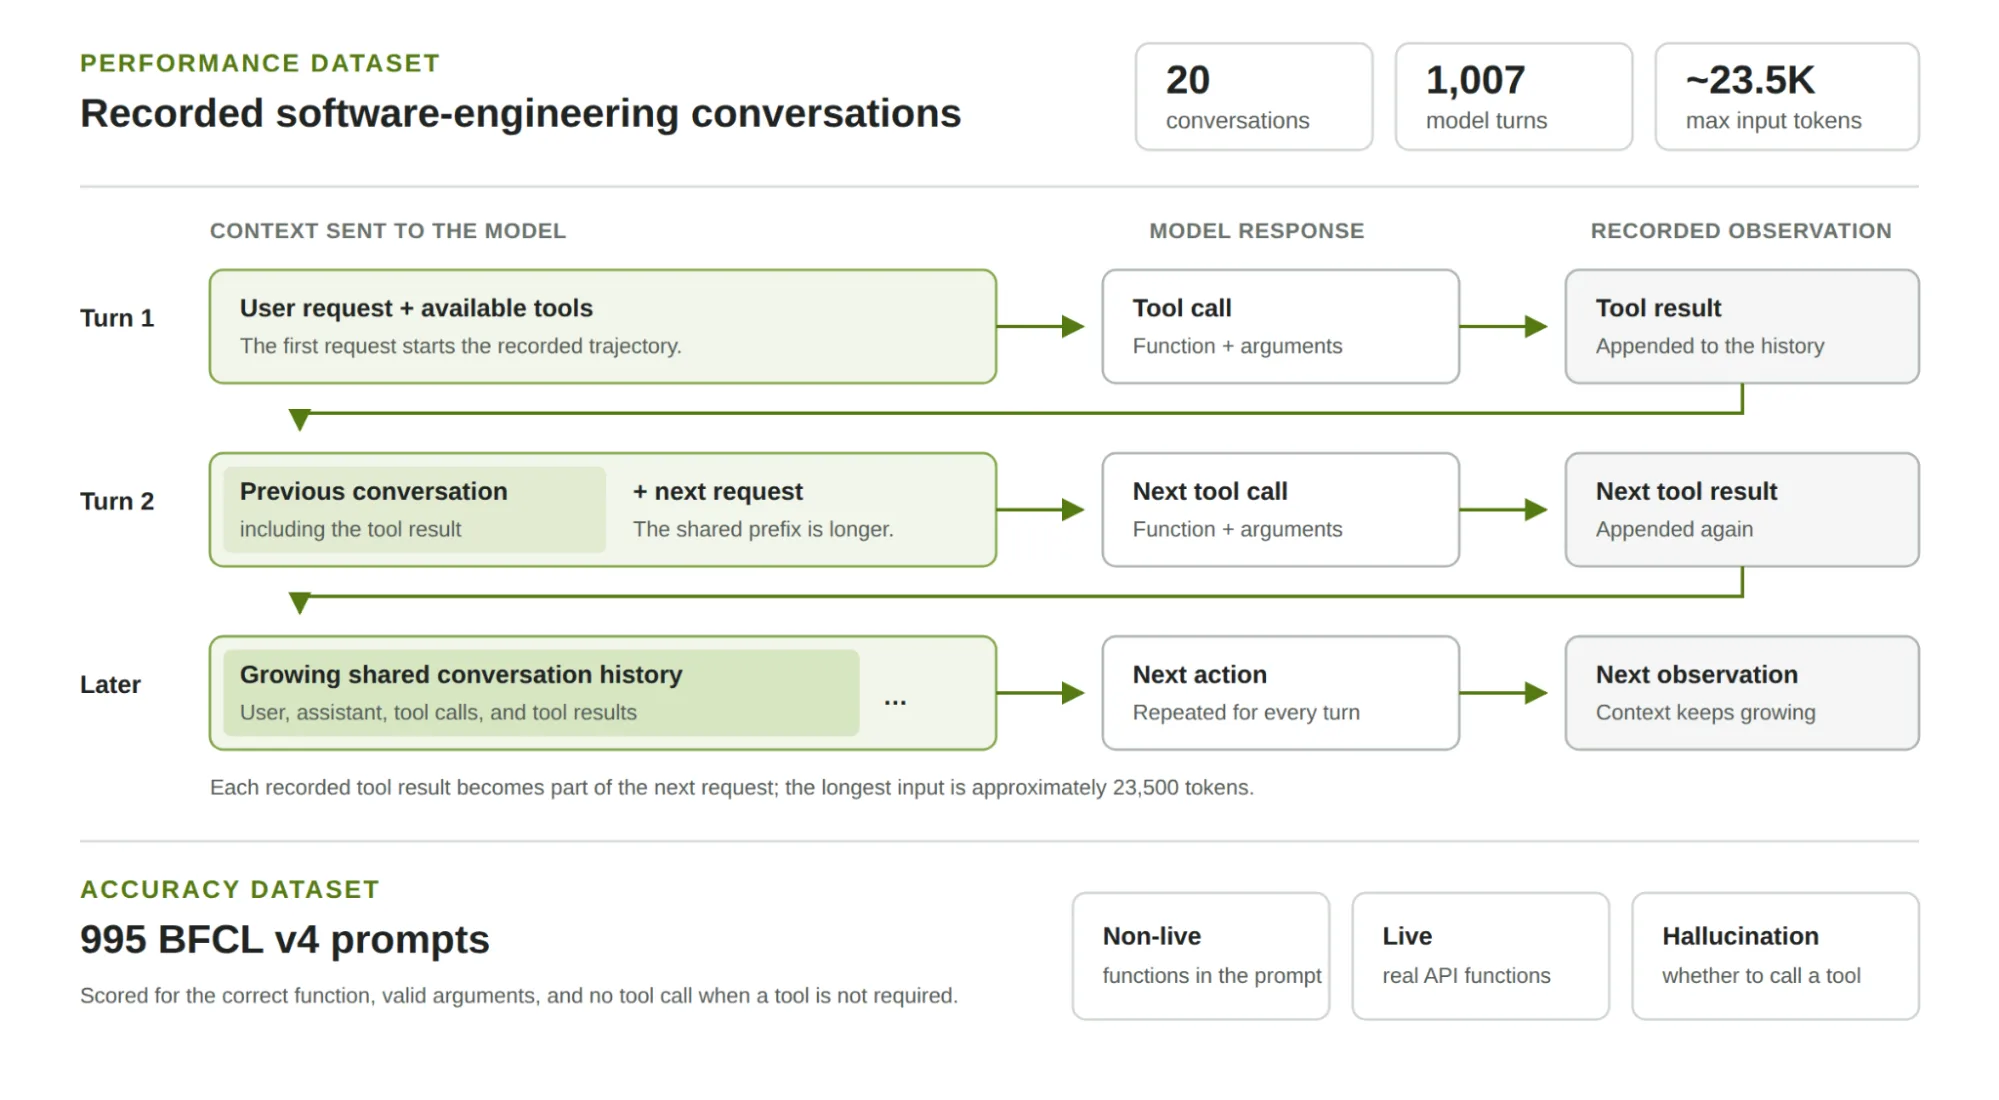
MLPerf Edge Agentic evalúa un endpoint de modelo compatible con OpenAI en dos fases, la de rendimiento y la de precisión.
La fase de rendimiento reproduce trayectorias grabadas de agentes de ingeniería de software. El modelo recibe una petición del usuario, genera una llamada a una herramienta, observa el resultado de esa herramienta y continúa la misma conversación. La carga contiene 20 conversaciones y 1.007 vueltas generadas. El largo de entrada crece a lo largo de las vueltas y llega a unos 23.500 tokens, así que el procesamiento de contexto largo pesa dentro de la medición. También se mide una precisión en línea basada en Intersection of Union (IoU) para asegurar que la fase de rendimiento está ejecutando el agente de forma correcta.
La fase de precisión usa prompts del Berkeley Function Calling Leaderboard (BFCL) v4, solo de una vuelta y con el razonamiento apagado, para equilibrar precisión y tiempo de evaluación en dispositivos de borde. Ahí se evalúa si el modelo elige la función correcta, genera argumentos válidos y evita llamar a una herramienta cuando no hace falta ninguna.
El resultado sobre el Jetson AGX Thor
El envío de TensorRT Edge-LLM usó Qwen3.6-27B en modo SingleStream sobre un kit de desarrollo Jetson AGX Thor con 128 GB de memoria unificada, en el modo de consumo MAXN.
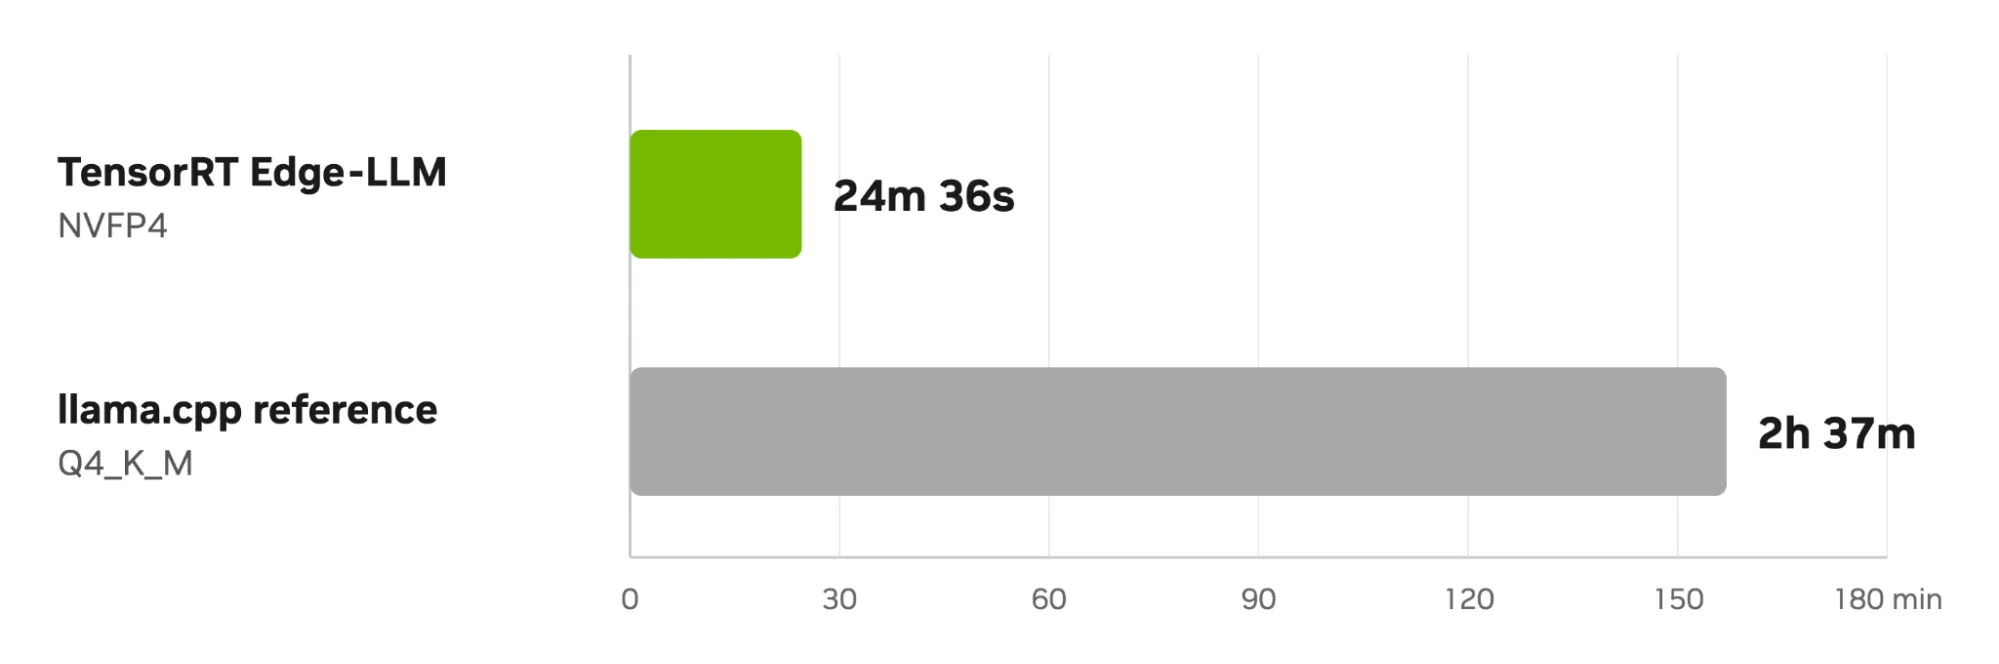
El ejemplo Edge Agentic de MLCommons publica además una corrida de referencia en llama.cpp sobre el mismo Jetson AGX Thor, que usa Qwen3.6-27B con cuantización Q4_K_M y termina en 2 horas y 37 minutos. El envío de TensorRT Edge-LLM completa la carga en 24 minutos y 36 segundos, es decir 6,4 veces menos tiempo.
| Corrida | Cuantización | Tiempo de la carga completa |
|---|---|---|
| TensorRT Edge-LLM | NVFP4 (W4A4), caché KV en FP8 | 24 min 36 s |
| Referencia llama.cpp | Q4_K_M | 2 h 37 min |
Por qué la cuantización NVFP4 acelera al Qwen3.6-27B
Se sabe que la decodificación de un modelo de lenguaje con lotes pequeños en plataformas de borde queda limitada sobre todo por el ancho de banda de la DRAM. Achicar el tamaño de los pesos y de las activaciones reduce la huella de memoria de los kernels y por esa vía sube el rendimiento de decodificación.
El modelo Qwen3.6-27B enviado usa NVFP4 para pesos y activaciones, incluida la cabeza del modelo de lenguaje, y FP8 para la caché KV. NVFP4 es un formato de punto flotante de 4 bits que soporta la GPU NVIDIA Blackwell del Jetson AGX Thor. TensorRT Edge-LLM recurre a kernels optimizados para acelerar el modelo cuantizado mientras mantiene la precisión que exige MLPerf.
La representación más chica del modelo también deja más de esos 128 GB de memoria unificada disponibles para el contexto largo, para el estado de la decodificación especulativa y para las cargas de la aplicación. Quien quiera partir puede tomar un checkpoint NVFP4 de Qwen3.6-27B ya calibrado. Un equipo de despliegue puede usar ese checkpoint cuantizado publicado o hacer la cuantización posterior al entrenamiento una sola vez, en cualquier sistema de desarrollo, antes de desplegar el modelo.
¿Cómo se reaprovecha la caché KV entre vueltas?
Cada petición nueva dentro de la trayectoria de un agente contiene casi toda la conversación anterior más una respuesta nueva del modelo o el resultado de una herramienta. Sin reutilización, el modelo tiene que volver a hacer el prefill del historial compartido en cada vuelta, y el costo sube a medida que la conversación crece.
TensorRT Edge-LLM identifica los prefijos de prompt reutilizables y restaura sus páginas de atención KV ya cacheadas. Qwen3.6 usa una arquitectura híbrida, así que el runtime también restaura el estado recurrente y el estado parcial de páginas KV que hacen falta para continuar la ejecución de forma correcta. Recién ahí hace el prefill únicamente del sufijo nuevo de la conversación.
La reutilización de la caché KV y del estado recurrente baja el cómputo repetido de contexto largo a lo largo de la trayectoria completa del agente. Esa optimización se complementa con el MTP en árbol, porque la reutilización de caché recorta el costo antes de que empiece la generación, mientras el MTP recorta la cantidad de pasos del modelo objetivo durante la generación.
En esta carga, cerca del 96% de los tokens de prompt se sirven con caché caliente. El runtime hace prefill de apenas unos 0,5 millones de los 13,6 millones de tokens de prompt que suman todas las vueltas.
La predicción de varios tokens en árbol
La decodificación autorregresiva estándar genera un token por cada invocación del modelo. La predicción de múltiples tokens usa un modelo borrador para predecir varios tokens futuros, que el modelo objetivo verifica después en conjunto. Los modelos recientes suelen traer pesos MTP oficiales, entrenados y distribuidos junto con el modelo principal.
Además del MTP lineal tradicional, TensorRT Edge-LLM implementa una variante basada en árbol. En vez de quedarse con una sola continuación predicha, el runtime organiza los candidatos de alta probabilidad en un árbol. El modelo objetivo verifica los candidatos en una sola pasada hacia adelante y el runtime acepta la rama que calza. Si se aceptan varios candidatos, el sistema avanza la generación en varios tokens de una vez.
Los parámetros del borrador se pueden ajustar al levantar el servidor. La configuración usada en MLPerf toma 8 pasos de borrador, los 2 mejores candidatos en cada nivel de profundidad y un árbol de verificación de 16 nodos. La verificación en árbol sirve para la llamada a funciones porque los nombres de herramientas, la sintaxis JSON y las estructuras de argumentos comunes suelen ser predecibles, mientras las ramas múltiples preservan alternativas probables para el valor de cada argumento. Comparado con un MTP lineal de 3 pasos de borrador, el MTP en árbol aporta cerca de 40% adicional de rendimiento de decodificación en esta carga.
Cómo reproducir el benchmark
La implementación usada para este envío está en la rama release/0.9.1-mlpinf de TensorRT Edge-LLM, que incluye los ajustes de exportación del modelo, los comandos de construcción del motor TensorRT, la configuración del servidor y la del cliente MLPerf.
1. Clonar TensorRT Edge-LLM e inicializar sus submódulos.
git clone --branch release/0.9.1-mlpinf \
  https://github.com/NVIDIA/TensorRT-Edge-LLM.git
cd TensorRT-Edge-LLM
git submodule update --init --recursive
2. Descargar el checkpoint NVFP4 calibrado.
huggingface-cli download \
  centml/Qwen3.6-27B-NVFP4-W4A4-mlpinf \
--local-dir "$WORK/Qwen3.6-27B-NVFP4-W4A4-mlpinf"
3. Seguir mlperf/README.md para compilar TensorRT Edge-LLM, exportar el checkpoint con la interfaz de MTP en árbol y construir los motores TensorRT base y borrador.
$VENV/bin/python -m tensorrt_edgellm.scripts.export \
  "$WORK/Qwen3.6-27B-NVFP4-W4A4-mlpinf" \
  "$WORK/onnx" \
--mtp-tree-base --skip-visual
4. Levantar el servidor TensorRT Edge-LLM compatible con OpenAI.
export REPO="$PWD"
export VENV=/path/to/venv-edgellm-export
export WORK=/path/to/mlperf-artifacts
bash mlperf/serve_edgellm.sh
5. Clonar el harness de endpoints de MLCommons, instalar sus dependencias BFCL, actualizar las rutas del modelo y del tokenizador en mlperf/config.yaml y correr el benchmark.
git clone https://github.com/mlcommons/endpoints.git
cd endpoints
python3.12 -m venv .venv
source .venv/bin/activate
pip install -e ".[dev,bfcl]"

inference-endpoint benchmark from-config \
--config "$REPO/mlperf/config.yaml"
La configuración entregada corre las fases de rendimiento y precisión con temperatura 0, semilla 42, razonamiento desactivado y concurrencia 1. La opción --accuracy-only deja solo la fase de precisión de BFCL. Los resultados completos de MLPerf Inference v6.1 para todos los envíos están en el anuncio de MLCommons.