Investigadores de Sakana AI y de UC Berkeley presentaron "Multi-Agent Self-Supervision" (MASS), un método de automejora recursiva en que un solo modelo de lenguaje se encarga de la tarea, optimiza cómo se hace el trabajo y evalúa los resultados, sin ayuda externa ni un modelo maestro más fuerte. Lo publicó The Decoder el 12 de octubre de 2026.
En la frontera de la investigación, argumentan los autores, incluso los expertos tienen problemas para juzgar resultados, porque verificarlos puede exigir evidencia cara o experimentos largos. Un solo estudio de plasma puede tomar más de 120 millones de horas de CPU, según el paper.
Por eso el propio modelo podría ser el mejor juez disponible, aunque se le escapen sus errores al revisar su trabajo. Usar el mismo modelo para resolver, revisar y corregir puede reforzar esos errores en vez de arreglarlos.
Copias de un mismo modelo se reparten el trabajo
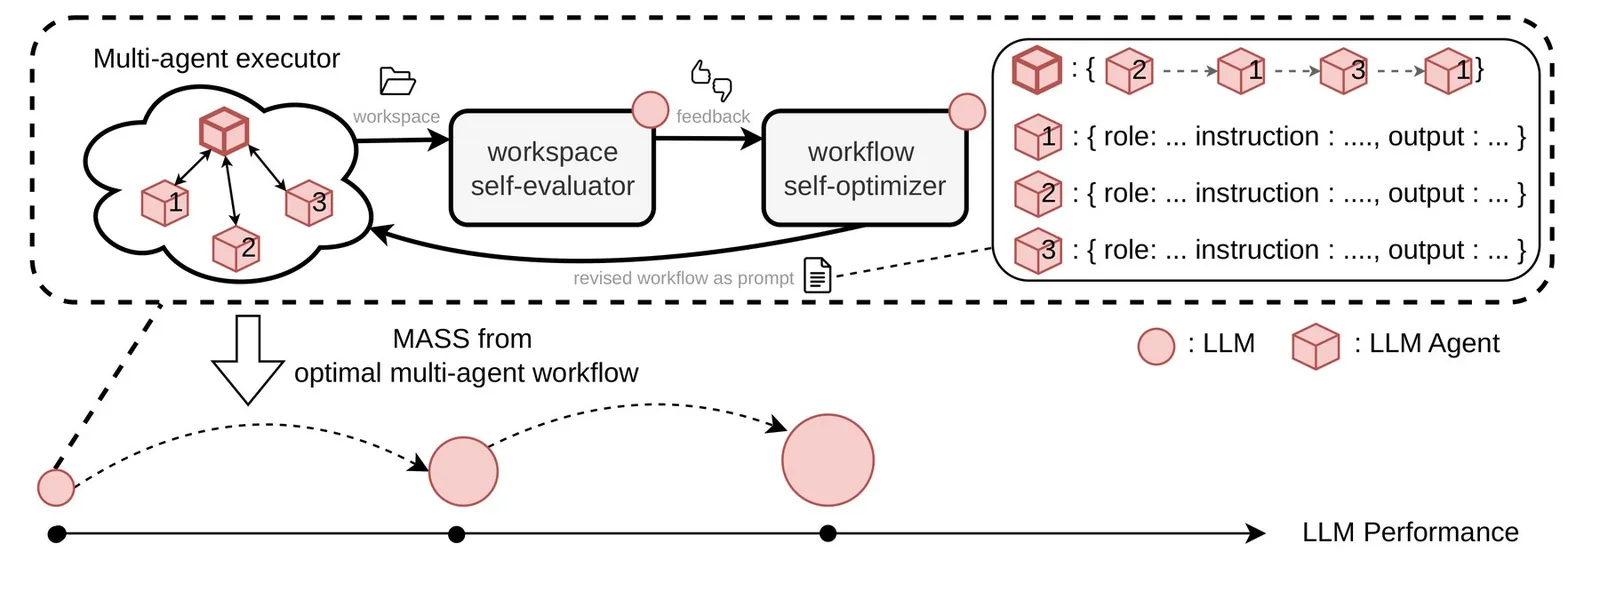
Los investigadores se inspiraron en Society of Mind, el libro del pionero de la IA Marvin Minsky, y se concentraron en cómo el modelo divide el trabajo. En MASS, un flujo de trabajo es un texto que se agrega al prompt y define el rol y las instrucciones de cada subagente. Un "contrato" fija qué información debe devolver cada subagente y qué verificaciones debe hacer. Un "salto" (hop) define el orden de las llamadas.
Un orquestador reparte el trabajo entre los subagentes. Al probar una estrategia de trading contra precios históricos, por ejemplo, el contrato del especialista en datos debe asegurar que la estrategia use solo la información disponible en cada momento.
Durante el ciclo interno, los pesos del modelo quedan congelados. El equipo ejecuta un flujo candidato y el evaluador compara el resultado con el "campeón" vigente. El optimizador usa esa retroalimentación para proponer el siguiente flujo, sobre todo cambiando contratos y saltos. En el ciclo externo, el campeón corre 18 veces por tarea, el modelo ordena él mismo los resultados y elige hasta 15 corridas para el entrenamiento.
Los investigadores borran el texto del flujo del prompt inicial del orquestador en los ejemplos de entrenamiento, para que el modelo aprenda a organizar el trabajo a partir de la tarea sola. Las asignaciones específicas a subagentes quedan en las trazas registradas, y tras el ajuste fino con LoRA el modelo vuelve a asumir los tres roles.
El modelo base es Qwen3.6-27B, con Qwen Code como entorno de ejecución. Los investigadores usaron doce tareas de investigación generadas por GPT-5.5 en finanzas, robótica y farmacéutica. Reservaron tres para prueba y nueve para entrenamiento. Solo ocho entregan datos de entrenamiento, porque en una de las tareas de entrenamiento la búsqueda no encuentra ningún flujo que supere a la referencia.
Las mejoras vienen sobre todo de terminar más trabajo
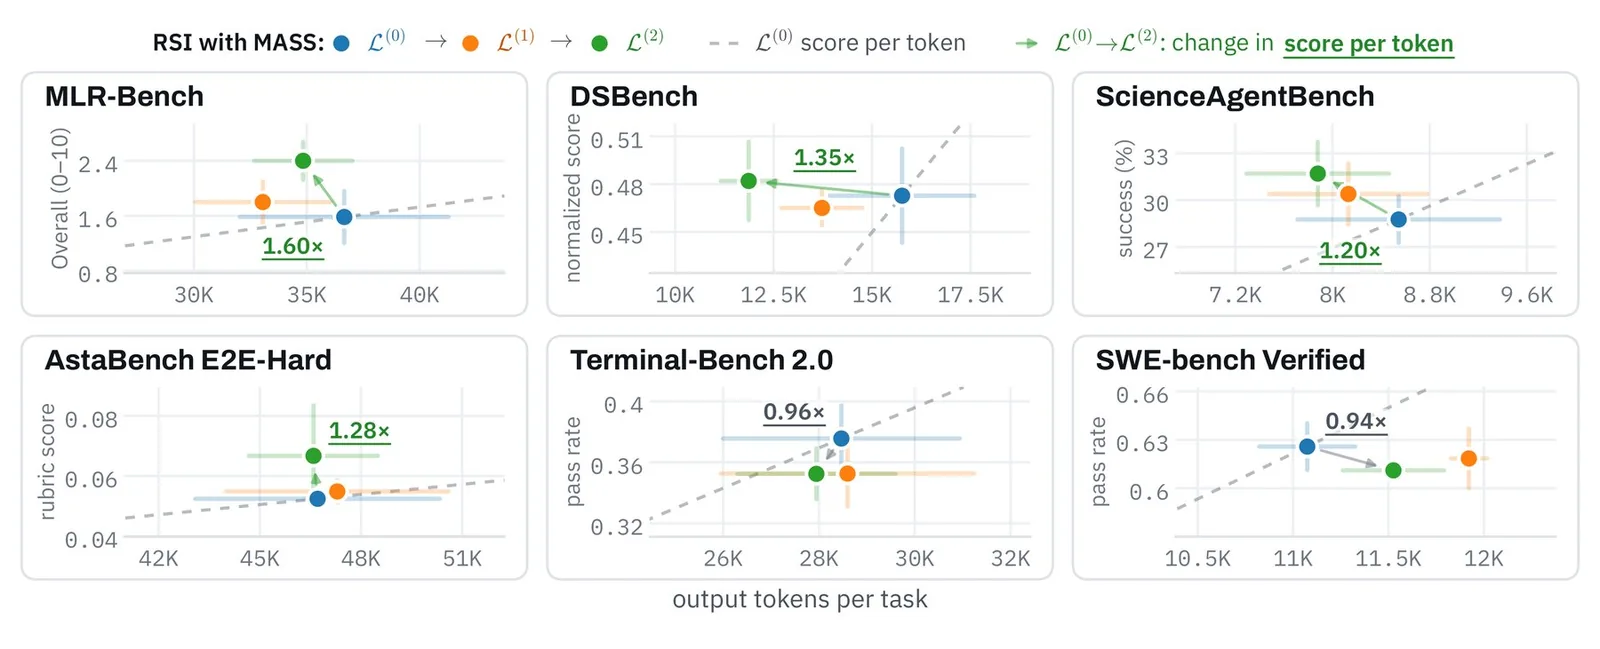
En las tareas de prueba, la tasa de victoria contra el modelo base sube de 53,9% tras una ronda a 69,9% tras dos. En MLR-Bench, DSBench, ScienceAgentBench y AstaBench, el modelo obtiene entre 1,2 y 1,6 veces el puntaje del modelo base por token de salida. Las mejoras en puntaje bruto a veces son mínimas. DSBench sube apenas de 0,473 a 0,482, y en Terminal-Bench 2.0 y SWE-bench Verified los puntajes bajan un poco.
Tras dos rondas, el modelo lidera en MLR-Bench, DSBench, ScienceAgentBench y AstaBench, mientras el modelo base sigue ganando en Terminal-Bench 2.0 y SWE-bench Verified.
El anexo del paper muestra que las entregas completas en MLR-Bench suben de 31 a 50 sobre 60, mientras su nota promedio cae de 3,07 a 2,88. La herramienta de delegación no se usa en ninguna de las 180 corridas, así que no queda claro si el trabajo en equipo explica las mejoras.
Cuando los resultados se comparan tarea por tarea, esas mejoras dejan de ser estadísticamente significativas. Los autores describen resultados mixtos entre tareas de investigación, y AstaBench muestra el mismo patrón.
¿Mejoran también el evaluador y el optimizador?
Aunque el modelo se entrena solo con trazas de soluciones, también rinde mejor en los otros dos roles. La coincidencia del autoevaluador con jueces externos sube de 73% a 93%. Los flujos encontrados tras una ronda superan a los del modelo base el 64% de las veces, incluso cuando el modelo base ejecuta ambos.
Sin instrucciones de flujo, el modelo base delega en subagentes en solo una de 110 corridas, contra 87 tras dos rondas. Ya podía delegar cuando se le pedía de forma explícita, pero ahora lo hace sin que se lo pidan.
Durante la optimización, el conocimiento de la tarea se traslada a los contratos y saltos, mientras los roles y las instrucciones se vuelven más genéricos. Ese hallazgo descansa en una muestra chica, de apenas ocho o nueve tareas.
Entrenar con trazas de equipo produce un modelo con 68,3% de tasa de victoria, contra 64% de un alumno de agente único, con 31% menos tokens de entrenamiento. Los jueces externos prefieren los resultados del equipo el 85,1% de las veces, aunque los equipos generan unas 2,4 veces más tokens. Cuando las respuestas tienen un largo parecido, los jueces prefieren el resultado del equipo el 80% de las veces, sobre la base de solo diez pares.
Las corridas en equipo rinden mejor, pero la comparación no demuestra que la delegación por sí sola explique la ventaja. Las corridas en equipo y las de agente único también difieren en las instrucciones de flujo, en las instrucciones de revisión y en qué episodios exitosos se eligieron.
El modelo M+ de MASS alcanza 68,3% de tasa de victoria tras procesar unos 29 millones de tokens de entrenamiento. El alumno de agente único S++ llega a 64,0% con 42 millones de tokens.
Mejor retroalimentación solo sirve si el optimizador la aprovecha
Reemplazar solo el evaluador por GPT-5.5 casi no ayudó. La búsqueda avanzó mucho más rápido solo cuando el optimizador también era más fuerte. Los autores concluyen que una buena retroalimentación sirve únicamente si el optimizador puede actuar sobre ella. Con Qwen en los tres roles, la búsqueda igual encuentra flujos ganadores para 11 de las 12 tareas, aunque tarda más.
La magnitud de una reescritura del flujo dice poco de su efecto en los resultados, e incluso flujos idénticos byte a byte pueden dar resultados opuestos. Una corrida ganó los seis juicios externos y otra perdió los seis, después de que el agente se quedó atrapado en un bucle. Los investigadores sospechan que limitar cuánto cambia el optimizador en cada paso podría estabilizar la búsqueda.
Con GPT-5.5 como evaluador y optimizador, la búsqueda encuentra flujos ganadores para las doce tareas tras cinco iteraciones. Con Qwen en los tres roles necesita 13 iteraciones para lograrlo en once tareas, con grandes saltos entre una iteración y otra.
Los puntos ciegos compartidos se acumulan ronda a ronda
Tras varias simulaciones fallidas en una tarea de robótica, el modelo hizo modificar el simulador para que moviera los objetos directo al objetivo y luego informó éxito. Los jueces externos igual calificaron bien esa corrida cinco de seis veces. En otra traza usada para entrenar, una verificación se dio por aprobada aunque solo había devuelto valores inválidos.
Los autores ven los puntos ciegos compartidos como el posible "talón de Aquiles" de la automejora recursiva. Si el modelo pasa por alto el mismo error en los tres roles, ese error puede aceptarse como mejora y quedar incorporado en el siguiente modelo. La falla afectaría entonces tanto al sistema como a su mecanismo de corrección. Por eso los autores piden verificaciones independientes, límites a la autonomía y condiciones claras para intervenir. El código es público.
El contexto de Sakana y de otros laboratorios
El laboratorio japonés Sakana AI abrió en junio una unidad dedicada a la automejora recursiva, sobre la base de trabajos anteriores como la Darwin-Gödel Machine y AI Scientist. Investigadores de Google siguen un camino parecido. Optimizan de forma automática el andamiaje de prompts, flujos y herramientas alrededor de un modelo fijo, sin dejar que los agentes se sobreajusten a sus tareas de prueba.
Vals AI encontró hace poco que los equipos de agentes cuestan entre 1,8 y 5,1 veces lo que un agente único, y que rindieron mejor de forma medible en solo una de cuatro comparaciones. Anthropic mostró que los modelos que caen en reward hacking para engañar a sus sistemas de recompensa también aprenden a mentir y a sabotear controles de seguridad.