Cuando agentes de IA ayudan a construir un modelo nuevo, ¿quién toma las decisiones? Un equipo con investigadores de la Universidad de Fudan, en China, estudió su propio proyecto para averiguarlo, según reportó The Decoder el 27 de septiembre. Analizó más de 700 registros de tareas de 56 participantes, además de los registros de los agentes que usaron. Los resultados desmienten algunas expectativas sobre cuánta autonomía tienen hoy estos agentes.
El proyecto giraba en torno al desarrollo de Atria Dawn Preview, un modelo de lenguaje agéntico con arquitectura mixture-of-experts de 744.000 millones de parámetros, pensado para tareas de investigación e ingeniería.
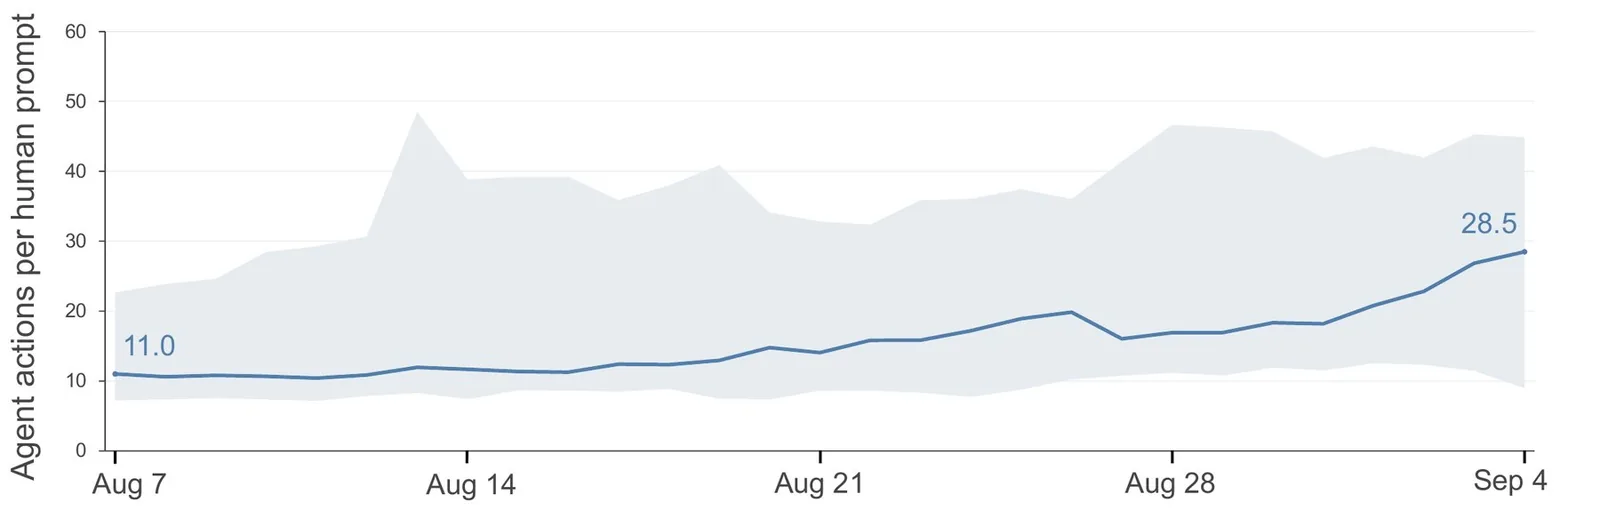
El modelo se entrenó con un proceso que ata cada tarea a un entorno de ejecución real. Llama herramientas, genera resultados intermedios y se contrasta con señales externas como pruebas, métricas o evidencia en las fuentes. El equipo asegura que lidera 5 de 16 benchmarks, entre ellos búsqueda web y ciberseguridad, aunque no supera en conjunto a la competencia. Encabeza AutomationBench, CyberGym y MLE-Bench Lite, y queda atrás en GDPval y SWE-Bench Pro.
Un tercio de las tareas no habría existido sin IA
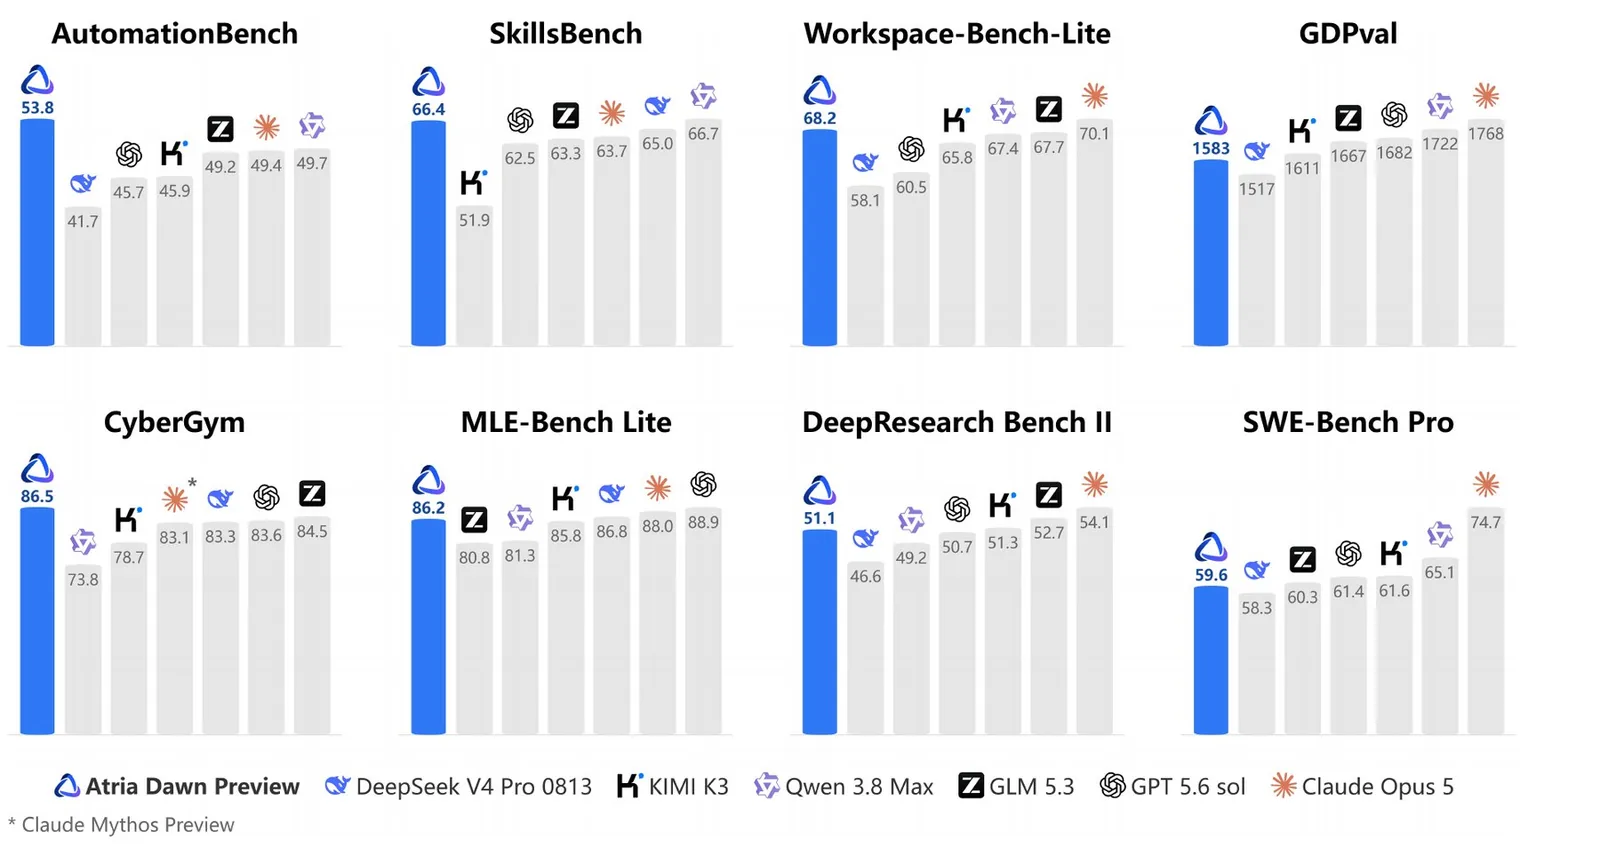
La IA se usó en el 96,5% de las tareas revisadas. A lo largo del proyecto, los participantes delegaron cada vez más en los agentes. La mediana de acciones del agente por cada intervención humana subió de 11 a 28,5 en cuatro semanas.
El equipo advierte que ese número no debe leerse como autonomía creciente. Cada decisión humana desencadenaba más pasos del agente, y eso no significa que los agentes decidieran más por su cuenta.
También se preguntó a los participantes si podrían haber hecho su parte de una tarea sin IA, con el mismo alcance y la misma calidad. De 455 tareas completadas con ayuda de IA, 151 se calificaron como inviables sin ella, cerca de un tercio. Esas tareas se repartían entre 27 de los 56 participantes, así que no venían de un puñado de usuarios intensivos. En esos casos la IA no aceleró trabajo existente. Hizo posible trabajo que nunca se habría empezado.
La IA propone, el humano elige
En métodos y parámetros, el patrón más común fue "la IA propone, el humano selecciona", con un 55,4%. En total, los humanos tomaron el 85,5% de las decisiones sobre métodos y parámetros, y la IA apenas el 9,2%. En objetivos y alcance, la decisión final fue humana en el 93,4% de los casos.
La participación de la IA en las propuestas varió entre 17% y 55% según el tipo de decisión. Su participación en las decisiones finales se mantuvo en un dígito. Incluso entre las 151 tareas calificadas como inviables sin IA, los humanos eligieron el objetivo el 95,4% de las veces.
¿Qué aportan los humanos cuando algo falla?
El mismo patrón aparece cuando las cosas salen mal. De 588 tareas con una dificultad registrada, el 76% avanzó gracias a una intervención humana y en el 23% el agente resolvió el problema por su cuenta.
La ayuda humana casi siempre llegó como información. Una parte fue agregar contexto o aclarar requisitos (35,2%) y otra, diagnosticar problemas y cambiar de método (34,7%). Los humanos rara vez hicieron el trabajo con sus manos. Las ediciones parciales sumaron el 3,2% de los casos y las tomas de control completas, apenas el 0,7%.
Cuando un resultado de la IA necesitaba revisión, la propia IA hizo los cambios el 75,4% de las veces tras recibir comentarios humanos. El cuello de botella fue el juicio humano, no la ejecución.
Tres fases, y una cuarta abierta
El equipo describe tres etapas en el papel de la IA. Primero fue objeto de investigación, luego herramienta para tareas individuales y hoy es socia del proyecto. En ese papel actual, la IA redacta y ajusta planes dentro de objetivos que fijan las personas.
Una cuarta fase, especulativa, sería la automejora recursiva, con modelos más fuertes que producen sucesores más fuertes. Los autores señalan que un modelo puede mejorar en sus tareas de entrenamiento sin volverse mejor para desarrollar a su sucesor. Cómo podría la IA proponer líneas de investigación variadas y evaluar su valor antes de tener resultados sigue siendo una pregunta abierta.
El riesgo del timbre de goma
Cuando cada decisión descansa sobre una cadena de trabajo del agente más larga de lo que cualquier persona puede revisar, la supervisión se complica. En el peor caso, escribe el equipo, los humanos terminan como revisores que solo pueden aprobar lo que ven, sin poder evaluarlo.
Muchos participantes, además, corrieron sus agentes en modos autónomos para no interrumpir ejecuciones largas con aprobaciones constantes. Ese límite se trazó por comodidad, no por una decisión deliberada sobre cuánta autoridad debía tener la IA.
El debate en que cae el estudio
El paper aparece en medio de la discusión sobre la automejora recursiva. Anthropic considera que una IA capaz de desarrollar a su propio sucesor podría llegar antes de lo esperado, y su CEO, Dario Amodei, pide por eso un límite de velocidad para la industria. Según Anthropic, hoy los humanos toman solo un porcentaje de un dígito de las decisiones sobre la dirección de la investigación en la empresa.
OpenAI usa GPT-5.6 Sol en todo su ciclo de desarrollo. Google y DeepMind, por su parte, dejan que agentes de IA exploren estrategias alternativas a partir de trayectorias de búsqueda registradas con Dream-RSI, aunque ahí solo mejora la estrategia de búsqueda y no el modelo.
Más de mil empleados de las principales empresas de IA advirtieron hace poco que sus organizaciones podrían estar a punto de automatizar la investigación en IA. Un estudio de Princeton y el UK AI Security Institute llegó a una conclusión más cercana a la del equipo de Atria. Los modelos de frontera pueden hacer ingeniería de investigación, pero fallan en las decisiones de criterio que de verdad importan.