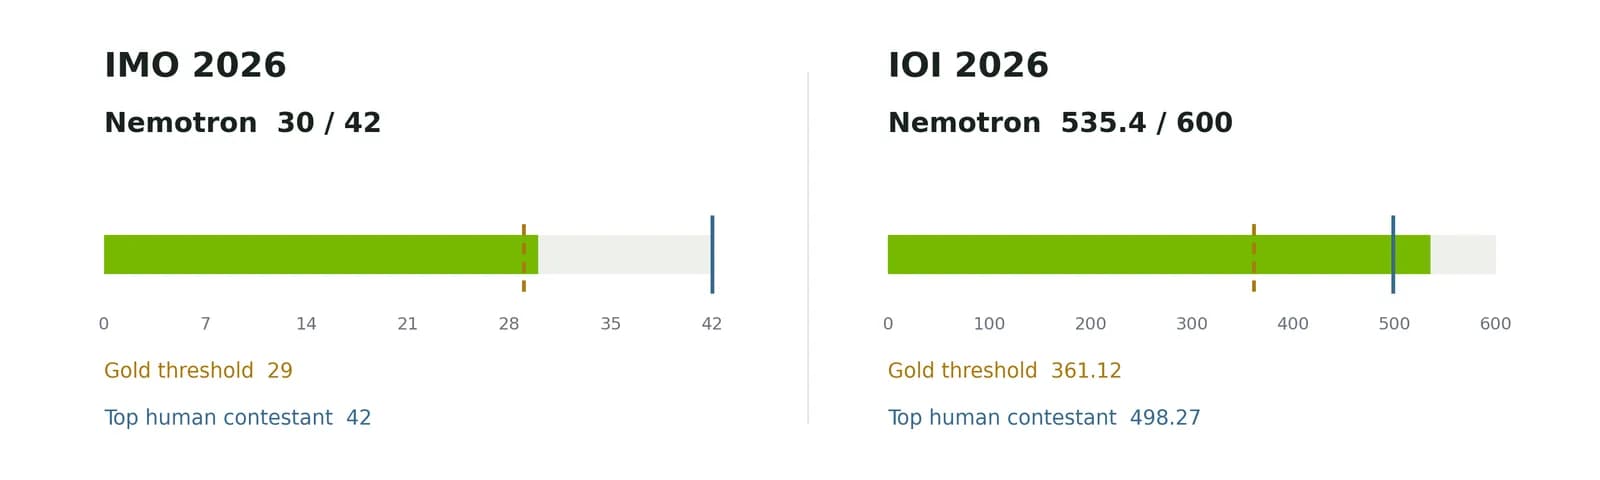
La Olimpiada Internacional de Informática (IOI) y la Olimpiada Internacional de Matemática (IMO) miden habilidades distintas. La IOI exige algoritmos y código que pasen pruebas ocultas con límites estrictos de tiempo y de envíos. La IMO pide demostraciones rigurosas escritas en lenguaje natural. Ganar en cualquiera de las dos es difícil, y el equipo de NVIDIA sostiene que rendir en ambas apunta a una capacidad más amplia.
NVIDIA publicó en el blog de Hugging Face que, partiendo de Nemotron 3, sus equipos usaron ajuste fino supervisado (SFT), aprendizaje por refuerzo (RL) e inferencia guiada por retroalimentación para construir sistemas que alcanzaron nivel de medalla de oro tanto en IMO 2026 como en IOI 2026.
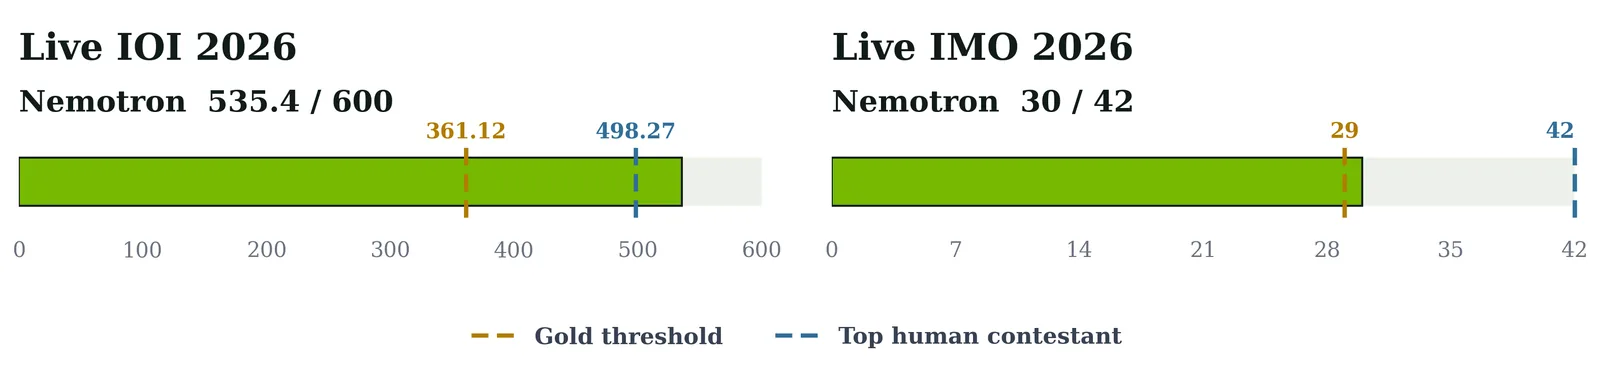
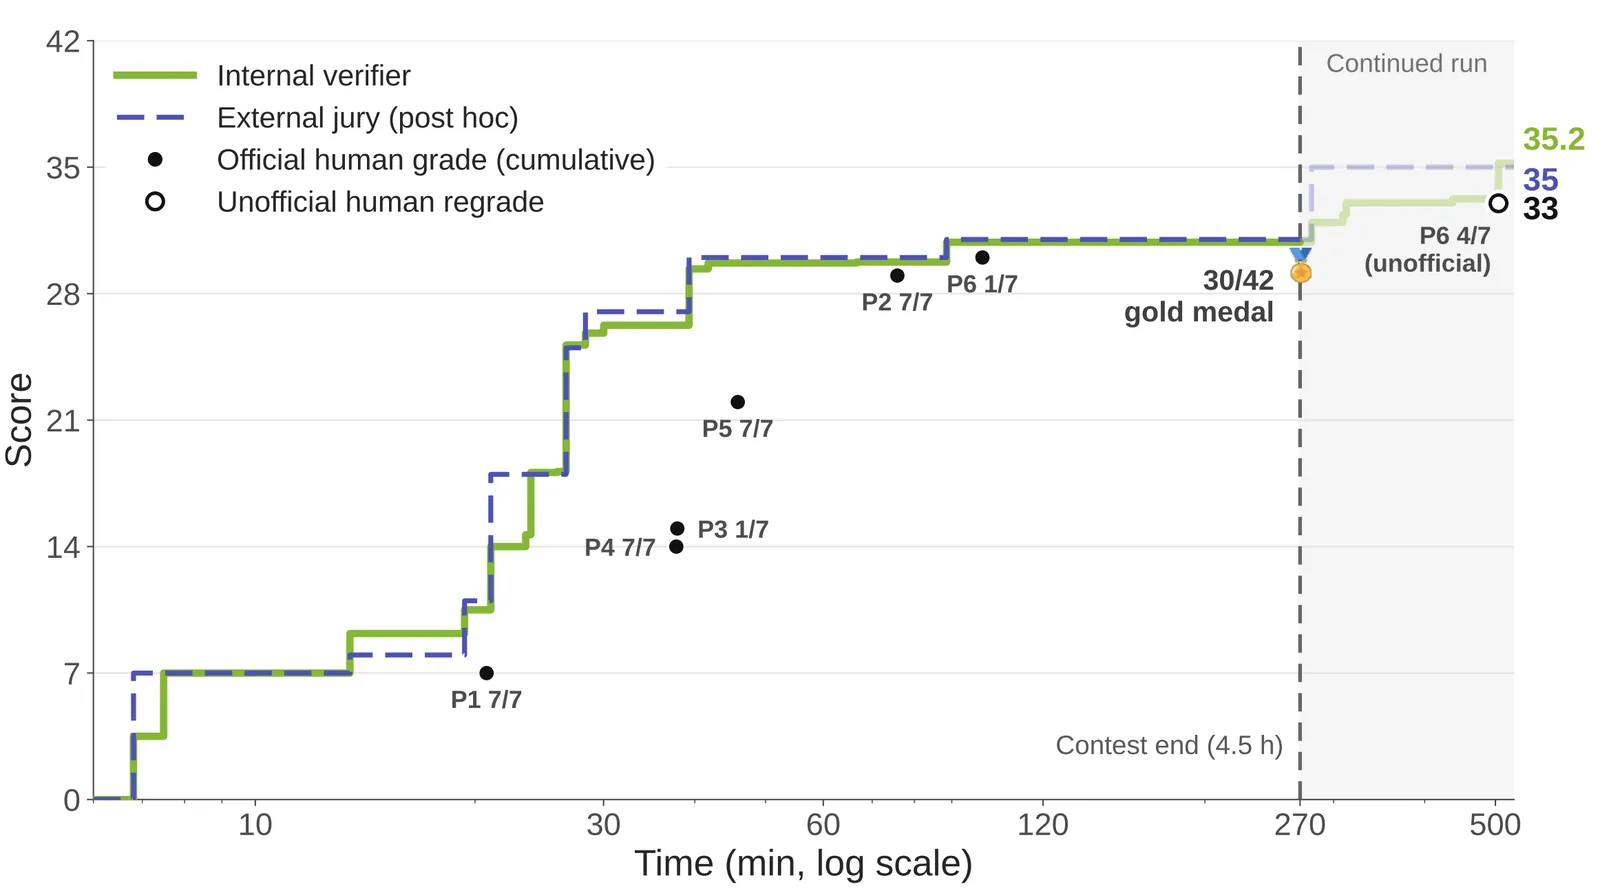
El resultado de IOI salió de una corrida en vivo, bajo las mismas restricciones de tiempo, acceso a internet y envíos que los competidores humanos. Fue una prueba no oficial y sin supervisión, y no entró en el ranking oficial de la IOI. Las demostraciones que envió el sistema de IMO, en cambio, las corrigieron los evaluadores oficiales de la olimpiada.
Una receta de especialización reutilizable
Para NVIDIA, que un modelo sea "fácil de ajustar" debería significar algo más que poder seguir entrenando un checkpoint. Debería significar que un modelo base capaz se puede adaptar a un dominio exigente con una receta clara y repetible.
En los dos proyectos esa receta tuvo cuatro partes:
- Partir de un modelo base Nemotron sólido.
- Reunir problemas del dominio y trazas de razonamiento de alta calidad.
- Aplicar métodos estándar de post-entrenamiento como SFT y, donde sirviera, RL.
- Acompañar al modelo especialista con un ciclo de inferencia que genera, evalúa y mejora respuestas candidatas.
Las corridas de entrenamiento e inferencia fueron grandes, pero el enfoque es conocido y reproducible. NVIDIA no construyó un modelo base nuevo para cada desafío. Especializó Nemotron para la tarea.
¿Cómo llegó Nemotron al oro en IOI?
Para programación competitiva, el equipo reunió 22.000 problemas y generó trazas de razonamiento sintéticas para entrenar dos especialistas. Nemotron-3-Nano-CC, con 30.000 millones de parámetros totales y 3.000 millones activos, recibió SFT y RL. Nemotron-3-Ultra-CC, con 550.000 millones de parámetros totales y 55.000 millones activos, recibió SFT.
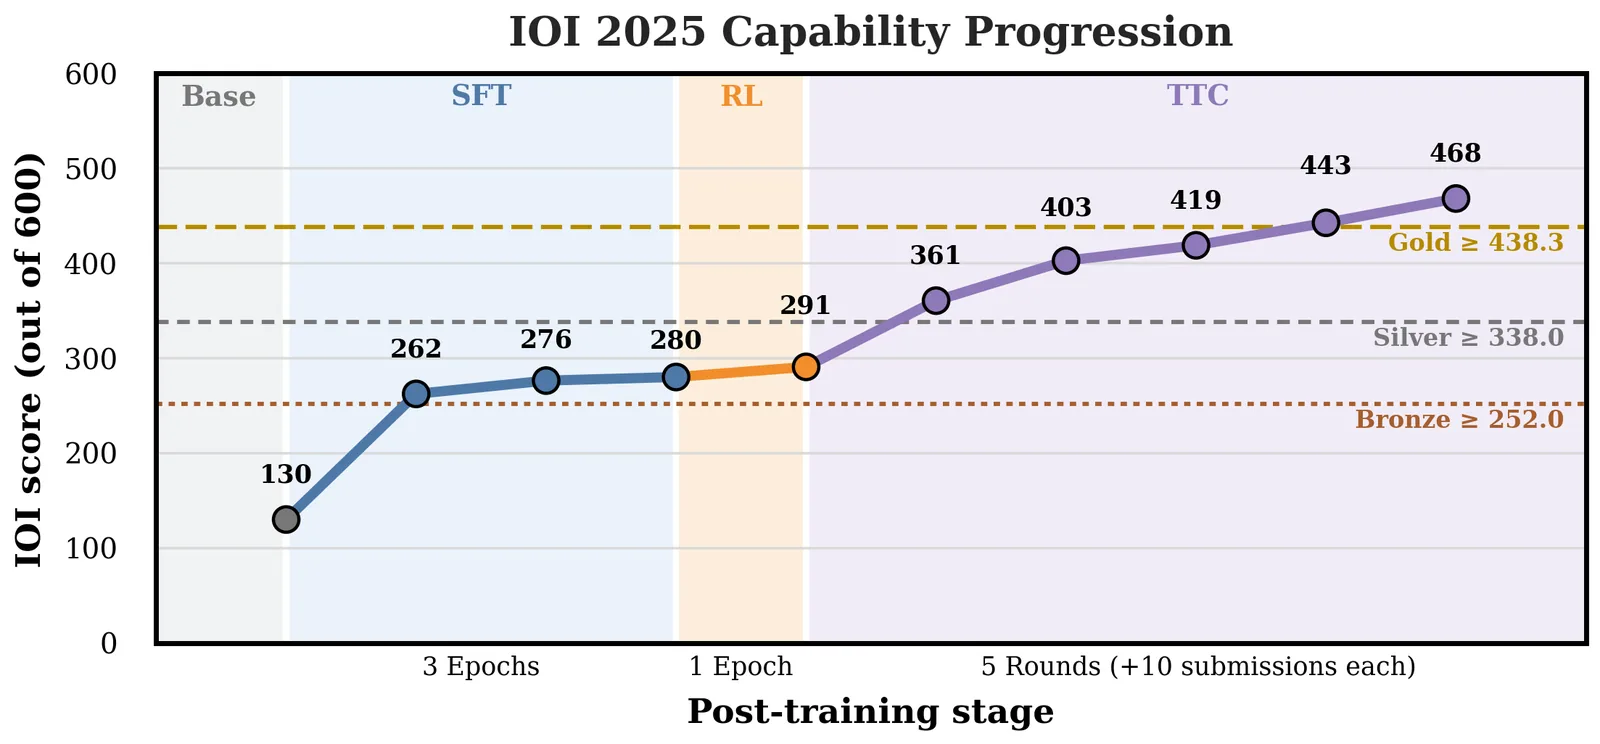
La progresión sobre los problemas de IOI 2025 muestra lo que aporta especializar. Nano subió de 130 puntos antes del post-entrenamiento a 280 después del SFT y a 291 después del RL. Con GenCorrect, la estrategia iterativa de generar, evaluar y refinar de NVIDIA, llegó a 468 puntos y superó el umbral de oro de 438,3. Ultra-CC llegó a 502 puntos con la misma estrategia en tiempo de prueba.
| Modelo y etapa | Puntaje en IOI 2025 |
|---|---|
| Nano antes del post-entrenamiento | 130 |
| Nano tras SFT | 280 |
| Nano tras RL | 291 |
| Nano con GenCorrect | 468 |
| Ultra-CC con GenCorrect | 502 |
| Umbral de medalla de oro | 438,3 |
Los experimentos también mostraron que la adaptación no tiene que verse igual a toda escala. El SFT explicó la mayor parte de la mejora de Nano, y el RL sumó una mejora menor pero constante. En el modelo Ultra, más fuerte, una sola época de SFT bastó para superar al Nano completamente post-entrenado en IOI, ICPC y LiveCodeBench Pro. Ese hallazgo orientó el sistema Ultra-CC específico para IOI 2026, que obtuvo 535,4 de 600 puntos.
Enseñarle a Nemotron a demostrar, revisar y corregir
El proyecto de IMO aplicó la misma idea a la matemática de olimpiada. A partir de Nemotron 3 Ultra, el equipo entrenó un especialista con SFT y otro con RL.
El corpus de SFT tenía 414.890 ejemplos filtrados por calidad, repartidos en 15.818 problemas de demostración distintos. No se limitaba a enseñar respuestas finales. Los datos cubrían generación de demostraciones, refinamiento, verificación y metaverificación, de modo que el modelo aprendió a construir argumentos, detectar vacíos, responder a críticas y juzgar si una demostración estaba completa. El modelo de RL se entrenó con 9.597 problemas de demostración elegidos cerca del límite de lo que el modelo podía resolver.
Los dos checkpoints post-entrenados superaron al modelo de disponibilidad general en los experimentos de desarrollo. El de SFT fue el más fuerte en la primera ronda de búsqueda, y el de RL logró el mejor resultado global como checkpoint individual. Sus fortalezas eran complementarias, así que el sistema final usó ambos especialistas junto al modelo general.
Para cada problema de la IMO, los modelos generaron demostraciones candidatas, las puntuaron, produjeron críticas y refinaron los intentos más prometedores. Una etapa aparte, con mucho cómputo, eligió la versión final que se envió. Todo el sistema trabajó en lenguaje natural, sin demostrador formal, sin herramientas externas y sin acceso a internet. Obtuvo 30 de 42 puntos, con puntaje completo en cuatro de los seis problemas, y superó el umbral oficial de medalla de oro.
El ajuste fino y el cómputo en inferencia se suman
La entrada anterior de NVIDIA sobre IOI 2025 en Hugging Face mostró cómo el cómputo en tiempo de prueba puede llevar modelos de pesos abiertos a nivel de oro. Los resultados nuevos agregan otra pieza. Una mejor especialización le entrega al sistema de inferencia mejores candidatos, mejores críticos y mejores refinamientos.
En IOI, GenCorrect convirtió lo ganado con el ajuste fino en mejoras mayores a lo largo de varias rondas de retroalimentación. En IMO, combinar los checkpoints complementarios de SFT y RL rindió más que sacar más muestras de uno solo. En los dos casos el mejor resultado vino de juntar un especialista capaz con un sistema que busca, verifica y mejora.
Según NVIDIA, las medallas no salieron solo del ajuste fino ni solo del muestreo por fuerza bruta. Salieron de diseñar en conjunto el modelo, los datos y el ciclo de inferencia.
¿Qué liberó NVIDIA en Hugging Face?
La colección Nemotron Labs IMO 2026 reúne los checkpoints de SFT y RL, los dos conjuntos de datos de entrenamiento y Nemotron-IMO-Bench, un benchmark nuevo de 200 problemas de nivel olímpico. El paper de IMO describe el entrenamiento y el sistema de generar, verificar y refinar. El repositorio NeMo-Skills incluye el flujo de inferencia de IMO, los prompts, las demostraciones enviadas y una guía de inicio reproducible.
Para programación competitiva, el modelo Nemotron-3-Ultra-CC está disponible en Hugging Face, y el paper de IOI entrega la receta de entrenamiento y la metodología GenCorrect. La evaluación y el flujo de inferencia de IOI también están en NeMo-Skills.