Un modelo MoE de 30B activa solo 3B parámetros por token
NVIDIA explica con Nemotron 3.5 Lightning en qué se diferencian los modelos densos y los de mezcla de expertos, y por qué la decisión depende del presupuesto de memoria y de la concurrencia.
16 notas publicadas

Koa se construyó sobre Nemotron, el modelo de pesos abiertos de Nvidia, y se entrenó con datos sintéticos que imitan llamadas de servicio al cliente sin usar información real de las empresas.

La cuantización NVFP4 combinada con decodificación especulativa multiplica por 6,28 el rendimiento frente a BF16, según las pruebas que NVIDIA publicó para sus placas AGX Thor y AGX Orin.

La destilación consciente de cuantización (QAD) permite llevar los pesos a 4 bits y triplicar el rendimiento sin perder la precisión del modelo original en BF16.

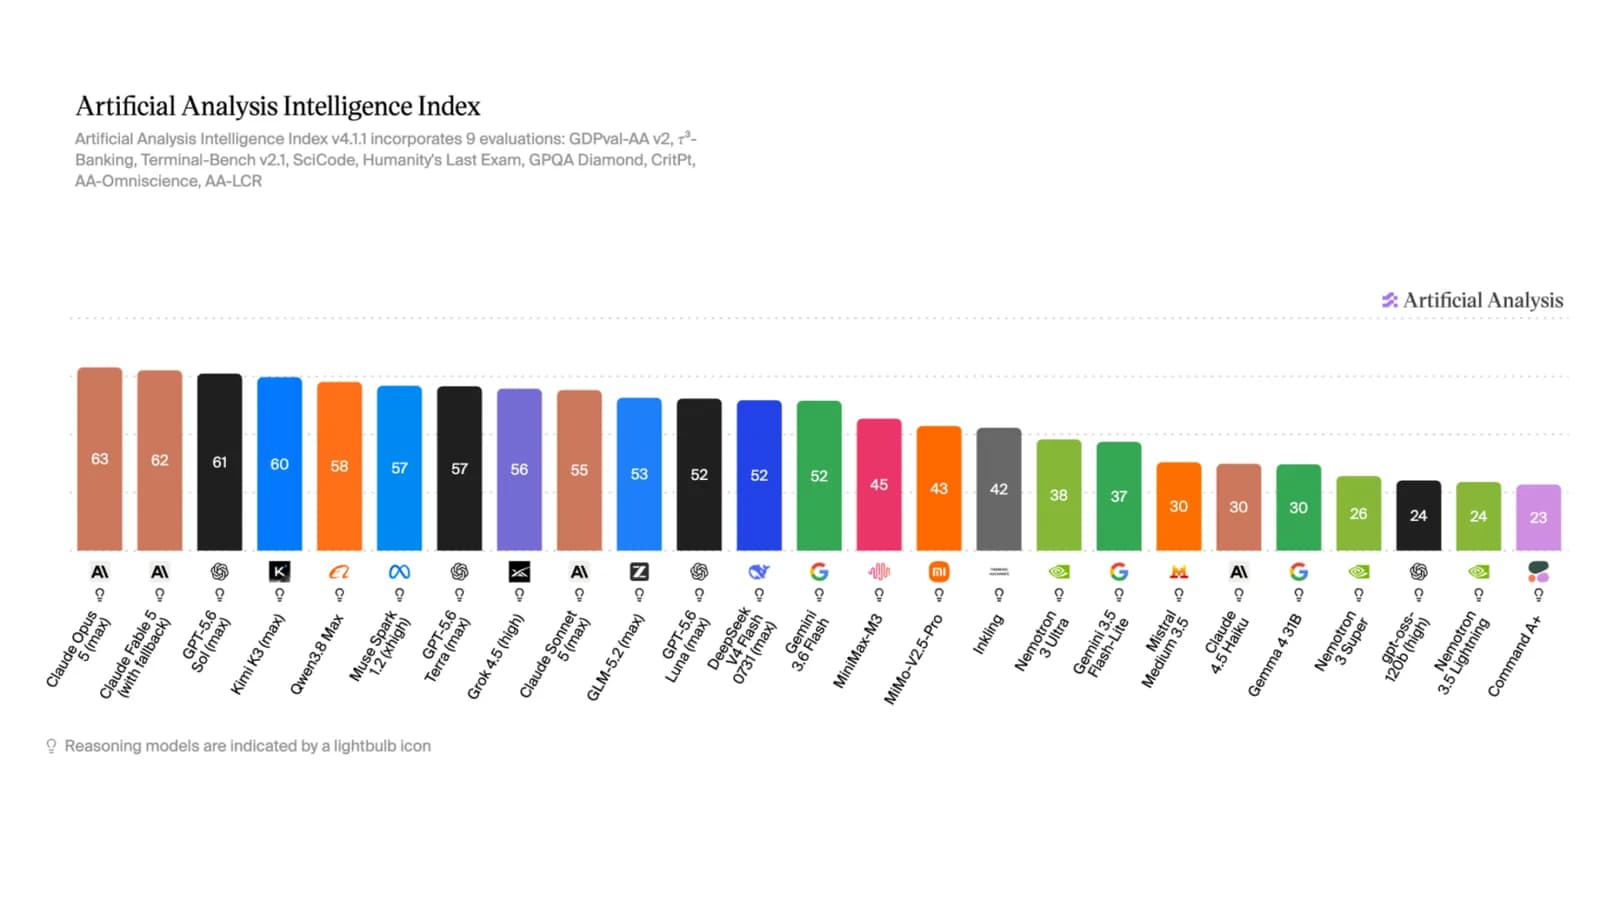
Artificial Analysis midió el modelo abierto de NVIDIA: la mayor velocidad de su clase, un salto de nueve puntos en inteligencia y un Elo agéntico superior al de modelos cuatro veces más grandes.

El gigante tecnológico presenta un modelo ligero de pesos abiertos y una herramienta para optimizar costos de ejecución en agentes de IA, impulsando su ecosistema.

NVIDIA expande su familia Nemotron con un modelo de 30B parámetros diseñado para agentes inteligentes, optimizado para ejecución local y menores costos.

NVIDIA expande su ecosistema con el modelo Nemotron 3.5 Lightning y la biblioteca NeMo Switchyard para optimizar el despliegue de agentes IA autónomos.

NVIDIA libera un modelo Mixture-of-Experts de 30.000 millones de parámetros totales y 3.000 millones activos, con hasta 4 veces más velocidad de salida que rivales de su tamaño.

El modelo de NVIDIA alcanza 97,1% de tasa de aprobacion en el benchmark CVDP usando hasta 71% menos tokens que sus rivales de codigo abierto en diseno de chips.

NVIDIA y LangChain muestran cómo la ingeniería de arnés acerca a un modelo abierto a la precisión de frontera, ajustando el entorno del agente en lugar de los pesos del modelo.

LangChain ajustó su harness Deep Agents para el modelo abierto de NVIDIA y logró paridad con los modelos cerrados a un décimo del costo de inferencia.

Los papers aceptados en la conferencia muestran que los modelos de frontera abiertos y la infraestructura abierta ya son la base del trabajo científico en inteligencia artificial.

El equipo de NVIDIA reduce el checkpoint del modelo de 550B desde 1.121 GB en BF16 a 352 GB en NVFP4, con la técnica four-over-six que recupera 98,5% de la precisión sobre Blackwell.

El nuevo modelo Mixture-of-Experts de NVIDIA promete mayor velocidad, eficiencia en contextos largos y una arquitectura diseñada para flujos de trabajo complejos.

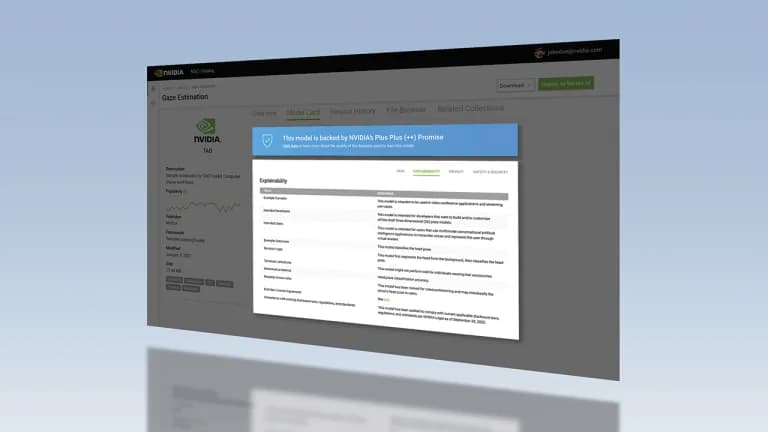
El toolkit Model Card Generator de NVIDIA construye documentación completa en formato Model Card++ a partir del código fuente, con 91% de completitud y 76% de precisión en menos de un minuto.
Otros temas que aparecen junto a #nemotron en nuestra cobertura editorial.