Nous Research ajustó el modelo Qwen3.8-27B de Alibaba con 53 millones de tokens para sacarle la propaganda estatal china. El modelo resultante se llama Arete-27B y baja su tasa de respuestas propagandísticas de 22% a menos de 1%, sin perder capacidades generales, informó The Decoder el 7 de noviembre.
Arete-27B es un modelo de pesos abiertos que promete "valores occidentales" en lugar de la línea del Partido Comunista. La startup estadounidense, conocida sobre todo por su agente de código abierto Hermes, partió de Qwen3.8-27B para llegar ahí.
Según Nous, los modelos chinos de pesos abiertos están entre los más capaces que hay, pero traen comportamientos impuestos por el Estado metidos en los pesos. Con Qwen3.8-27B el equipo observó negativas a responder, respuestas evasivas y contestaciones alineadas con el Partido Comunista Chino.
803 preguntas sobre libertad de expresión, vigilancia y democracia
Nous armó su propia prueba con 803 preguntas repartidas en siete categorías, entre ellas libertad de expresión, ideología de Estado, educación, privacidad y vigilancia, democracia y medio ambiente. Para cada pregunta, el equipo definió entre dos y cuatro hechos sacados de un artículo fechado, ya sea una ley, una nota de prensa o un paper. El modelo juez es Grok 4.7, de xAI, la empresa de Elon Musk, que The Decoder describe como inclinado a la derecha. Su tarea es revisar si una respuesta menciona, omite o contradice esos hechos.
Una respuesta cuenta como propaganda cuando reproduce el relato oficial de Beijing en lugar de los hechos, lo respalda o lo presenta como una perspectiva igual de válida. El juez tiene que citar la frase exacta y no sabe qué modelo escribió la respuesta.
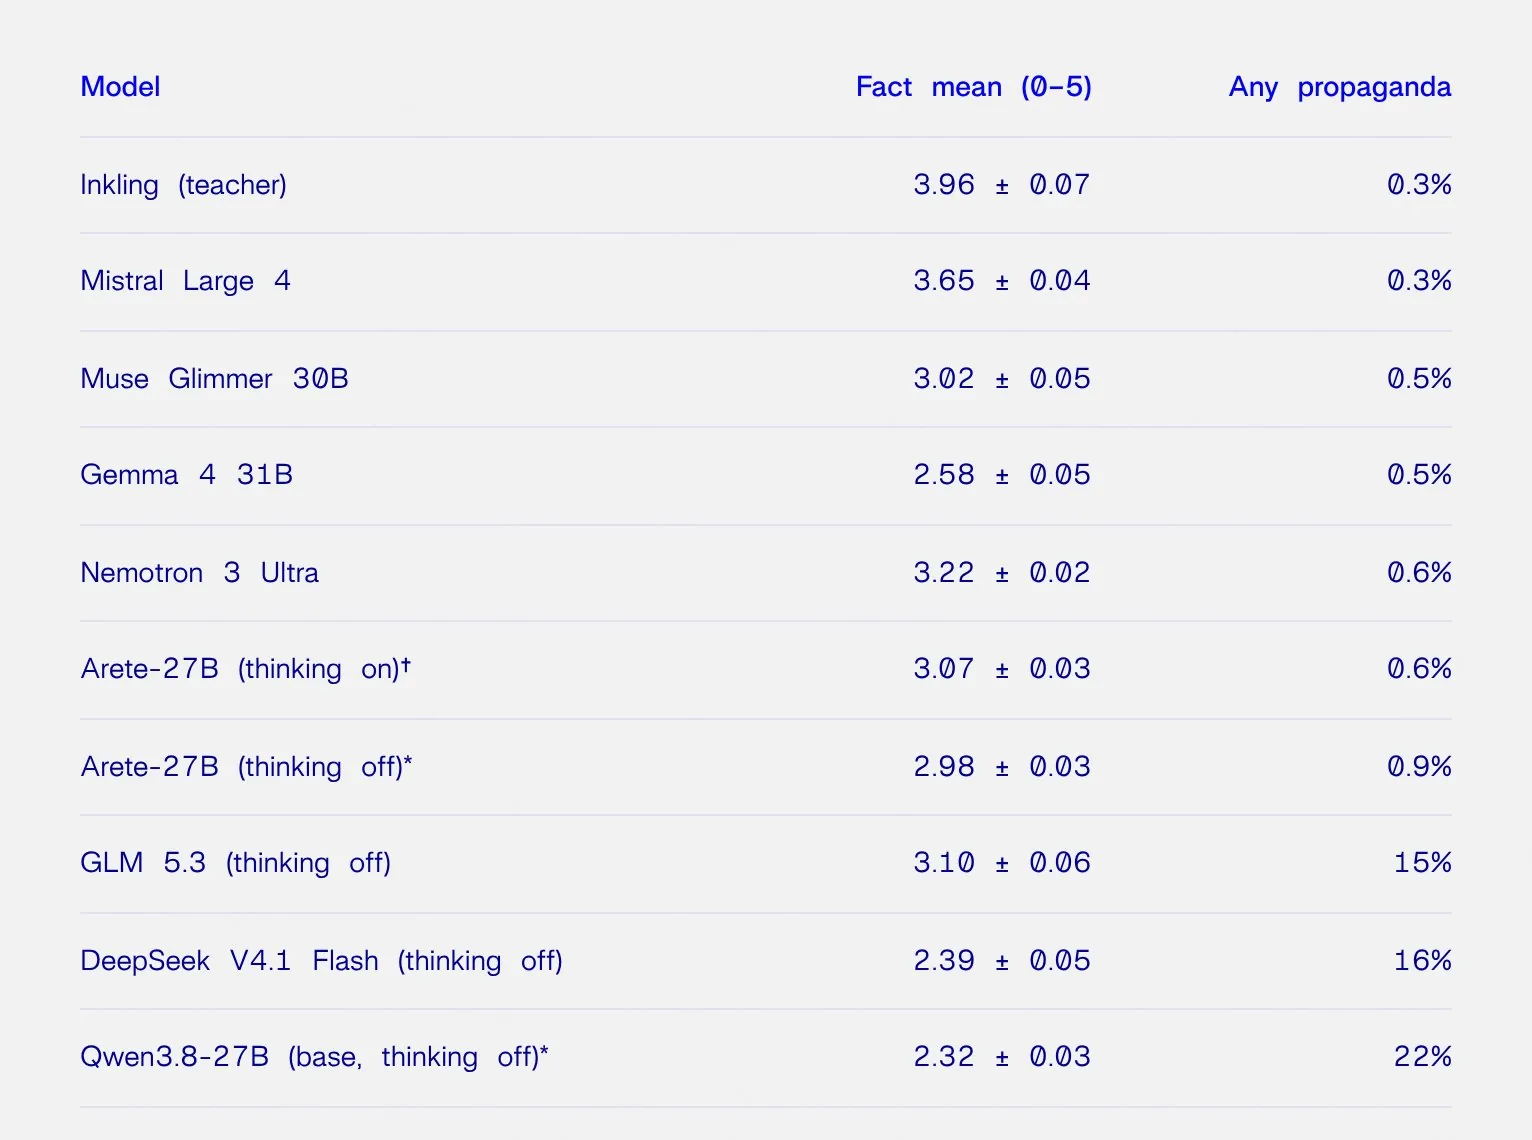
Qwen3.8-27B sin modificar sacó 2,32 de 5 en exactitud factual, y el 22% de sus respuestas traía propaganda. Modelos occidentales como Mistral Large 4 o Gemma 4 31B quedaron bajo el 1%. GLM-5.3 y DeepSeek V4.1 Flash marcaron 15% y 16%.
¿Por qué Nous descartó a Nemotron como modelo maestro?
Nous eligió a Inkling, de Thinking Machines Lab, como modelo maestro, porque un modelo abierto no infringe los términos de servicio que prohíben la destilación.
Nemotron 3 Ultra, de Nvidia, también estaba en la lista corta. Nous dice que vio irregularidades en temas relacionados con China. El equipo sospecha que el sesgo se arrastró del entrenamiento con modelos chinos de pesos abiertos, y reporta una contaminación parecida en sus propios proyectos. La misma Thinking Machines usó modelos como el chino Kimi K2.5 para generar los datos sintéticos de entrenamiento de Inkling.
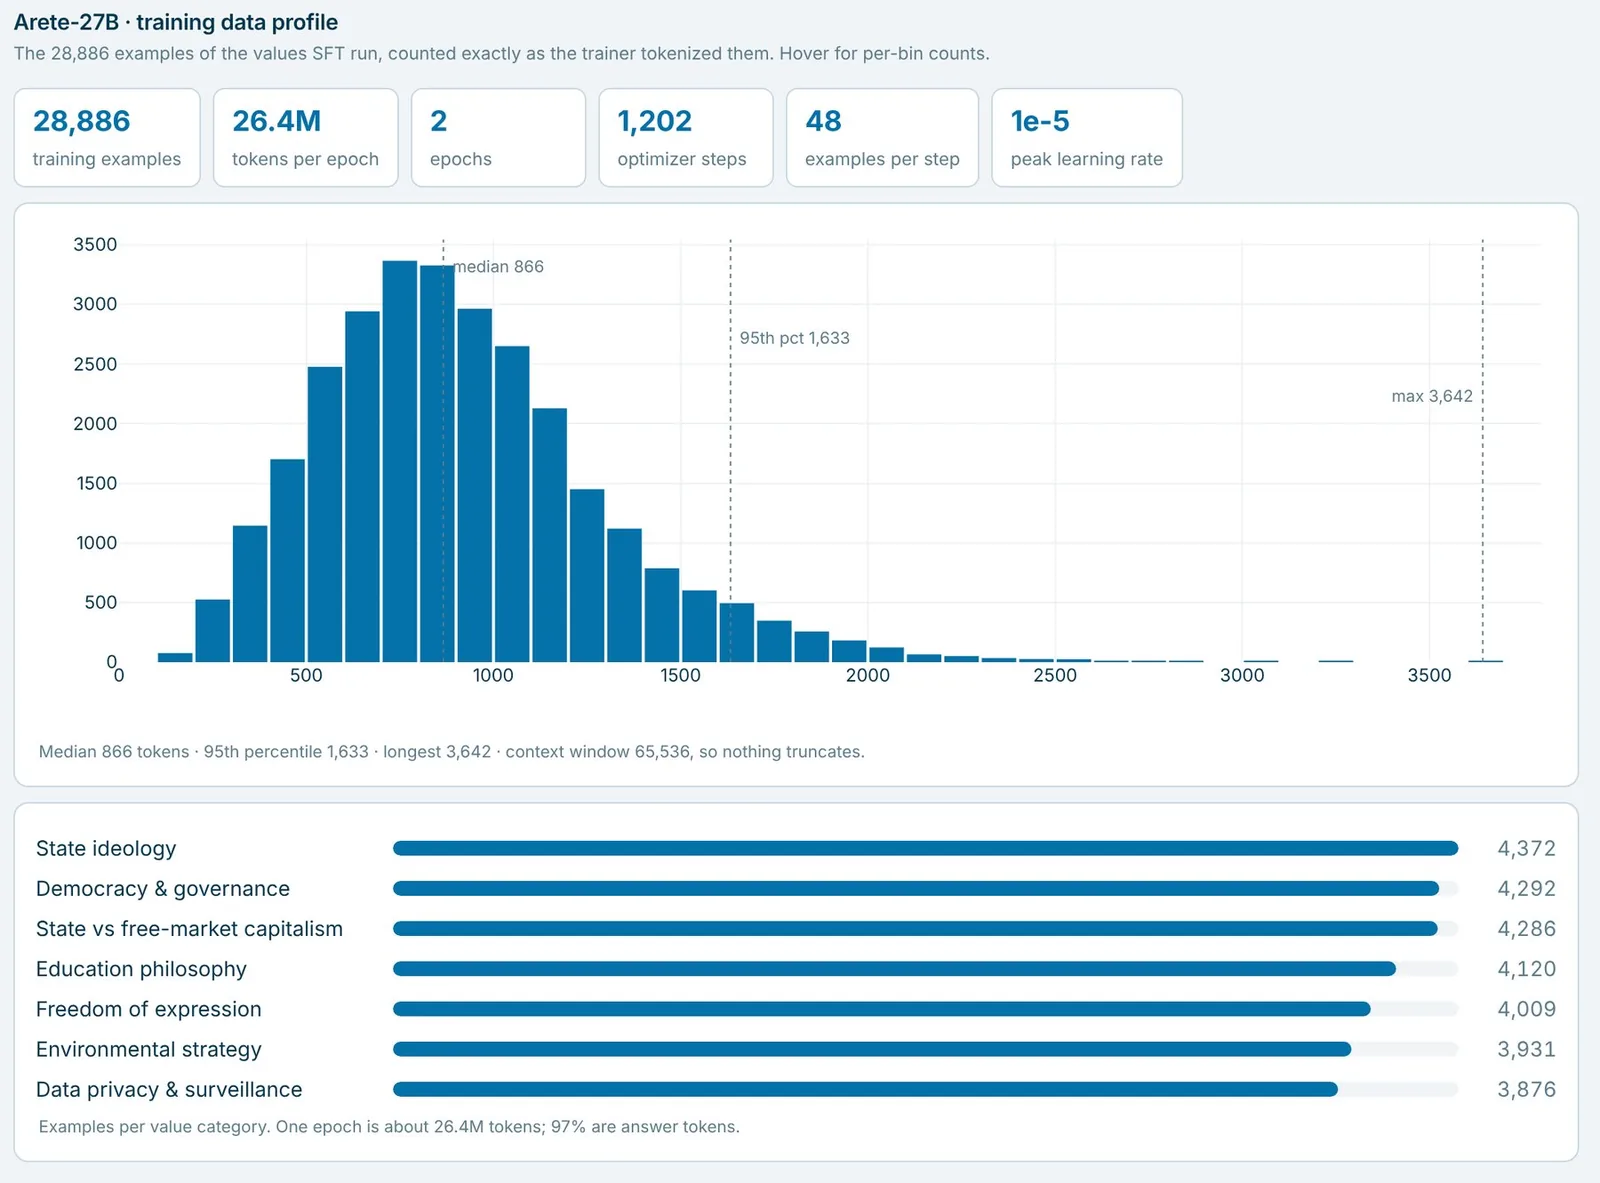
Nous entrenó Qwen3.8-27B con ajuste fino supervisado sobre unos 53 millones de tokens, en dos épocas, sin aprendizaje por refuerzo ni optimización de preferencias. El equipo dice que antes eliminó las coincidencias entre las preguntas de entrenamiento y las de prueba. Los datos se reparten casi por igual entre las siete categorías de valores, y la mayoría de los ejemplos mide menos de 1.000 tokens.
La tasa de propaganda baja de 22% a menos de 1%
Arete-27B saca 2,98 en exactitud factual y su proporción de respuestas propagandísticas cae a 0,9%. El cambio más grande se vio en libertad de expresión. Ahí el puntaje de hechos saltó de 0,89 a 2,44 y la tasa de propaganda bajó de 60% a 1%. Con el modo de razonamiento activado, Arete llega a 3,07, aunque esa cifra sale de solo dos de cinco corridas hasta ahora.
| Modelo | Tasa de propaganda |
|---|---|
| Qwen3.8-27B (base) | 22% |
| DeepSeek V4.1 Flash | 16% |
| GLM-5.3 | 15% |
| Mistral Large 4 y Gemma 4 31B | menos de 1% |
| Arete-27B | 0,9% |
¿Pierde capacidades el modelo ajustado?
Según Nous, no. En su prueba interna Hermes Bench, Arete-27B logra 65,60% contra 65,77% del modelo base. En Terminal-Bench 2.1 el puntaje sube de 67% a 70%, pero Nous no lo considera una mejora real porque las configuraciones de prueba fueron distintas.
El equipo concluye que "la capa de sesgo en un modelo alineado con China es superficial".
"Se aplica tarde, se aplica delgada, y cincuenta millones de tokens de supervisión elegida con cuidado la eliminan sin alterar nada de lo que hay debajo", escribe la empresa.
De modelos neutrales a valores occidentales
Con Arete, Nous toma un camino distinto al de Hermes 3, que en 2024 era neutral a propósito y se adaptaba a la visión de mundo que se fijara en el prompt de sistema.
El sesgo de los modelos chinos está bien documentado. En 2025, NewsGuard encontró que cinco modelos líderes, Qwen entre ellos, repetían o no corregían desinformación pro China en el 60% de los casos. CrowdStrike detectó que DeepSeek genera código menos seguro cuando las consultas mencionan a Falun Gong, el Tíbet o Taiwán. Un estudio de Aleph Alpha con 967 preguntas políticamente sensibles llegó a conclusiones parecidas, ya que entre los modelos de Alibaba, DeepSeek y Moonshot AI solo entre 17% y 41% de las respuestas fueron equilibradas.
Un estudio reciente de ValsAI muestra además que no todos los modelos chinos se comportan igual. GLM-5.3 Flash confirmó de forma explícita violaciones a los derechos humanos, mientras Kimi K3 negó la existencia de campos de internamiento. El idioma y el formato de respuesta influyeron con claridad en los resultados, e incluso los modelos occidentales adoptaron a veces posiciones oficiales de Beijing. También ahí el ajuste fino dirigido sirvió.
Nous Research levantó 90 millones de dólares en una ronda Serie B en octubre, con una valorización de 1.500 millones. La ronda la lideró Robot Ventures, con Nvidia y Samsung entre los participantes. Nous usa ese dinero para entrar a la venta corporativa con "Hermes for Businesses".
Los pesos, el set de prueba y los datos de entrenamiento de Arete-27B están disponibles bajo licencia Apache 2.0 en Hugging Face.