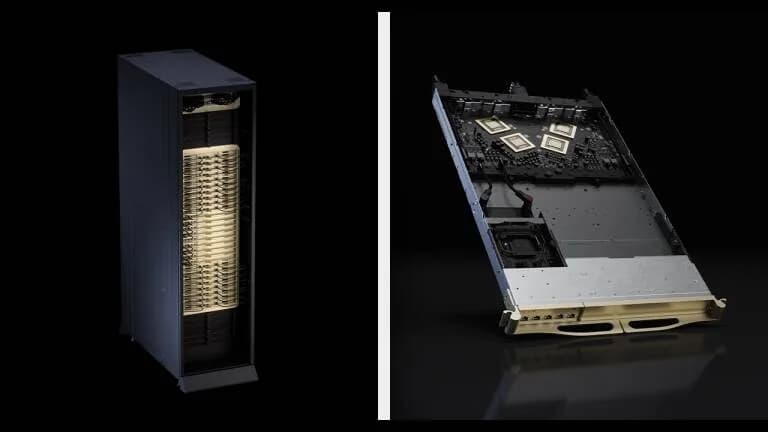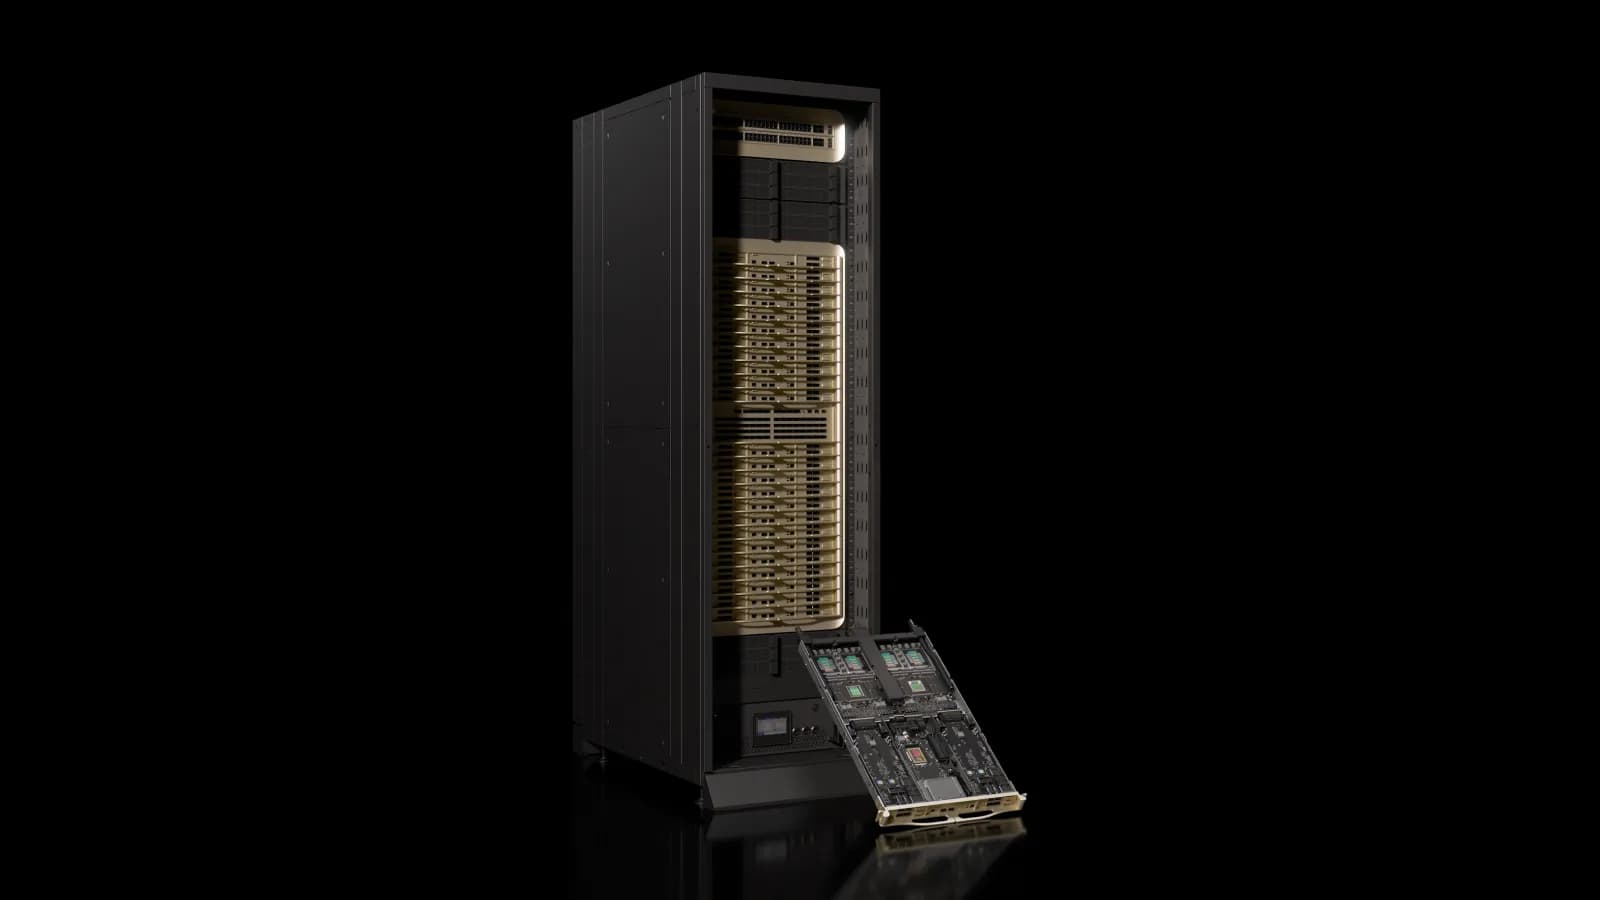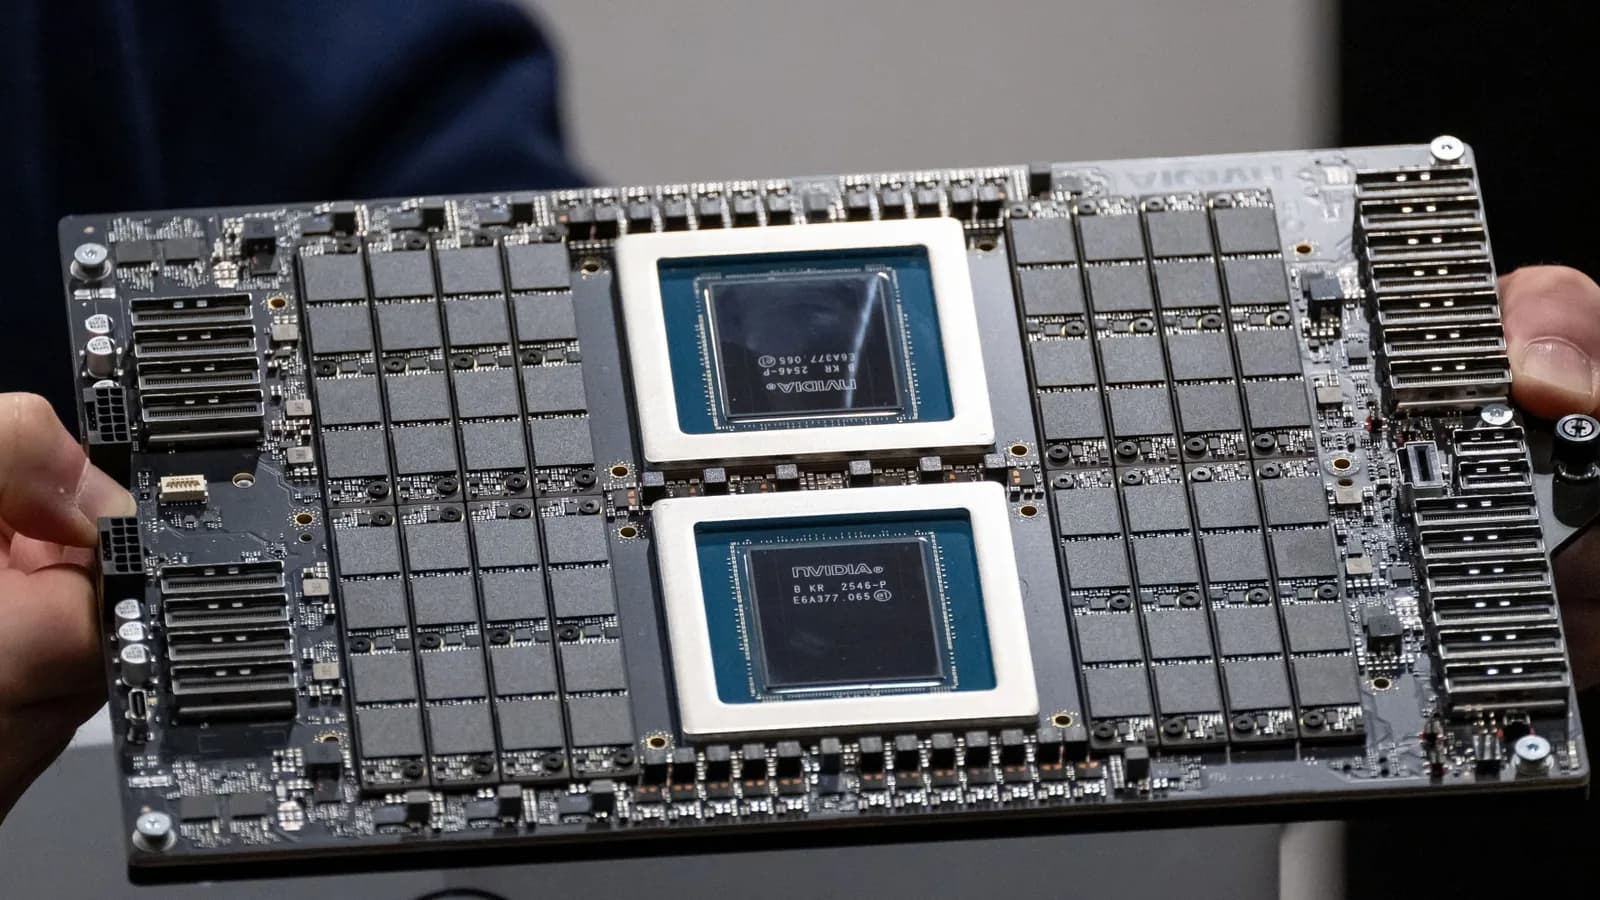
La plataforma NVIDIA Vera Rubin debutó en los benchmarks MLPerf con resultados publicados el 16 de noviembre. Nvidia ganó todas las pruebas de MLPerf Training v6.1 y, en su primera participación en MLPerf Endpoints, entregó más de 10 veces el rendimiento por watt de la generación anterior en IA agéntica, una medida de cuánto trabajo de agentes hace un sistema por cada watt que consume.
La empresa dice que el rendimiento de Vera Rubin seguirá subiendo con la optimización de su pila de software basada en CUDA.
Nvidia arrasa en MLPerf Training v6.1
MLPerf Training mide cuánto tarda un sistema en entrenar distintos modelos de IA hasta un nivel de precisión fijado de antemano.
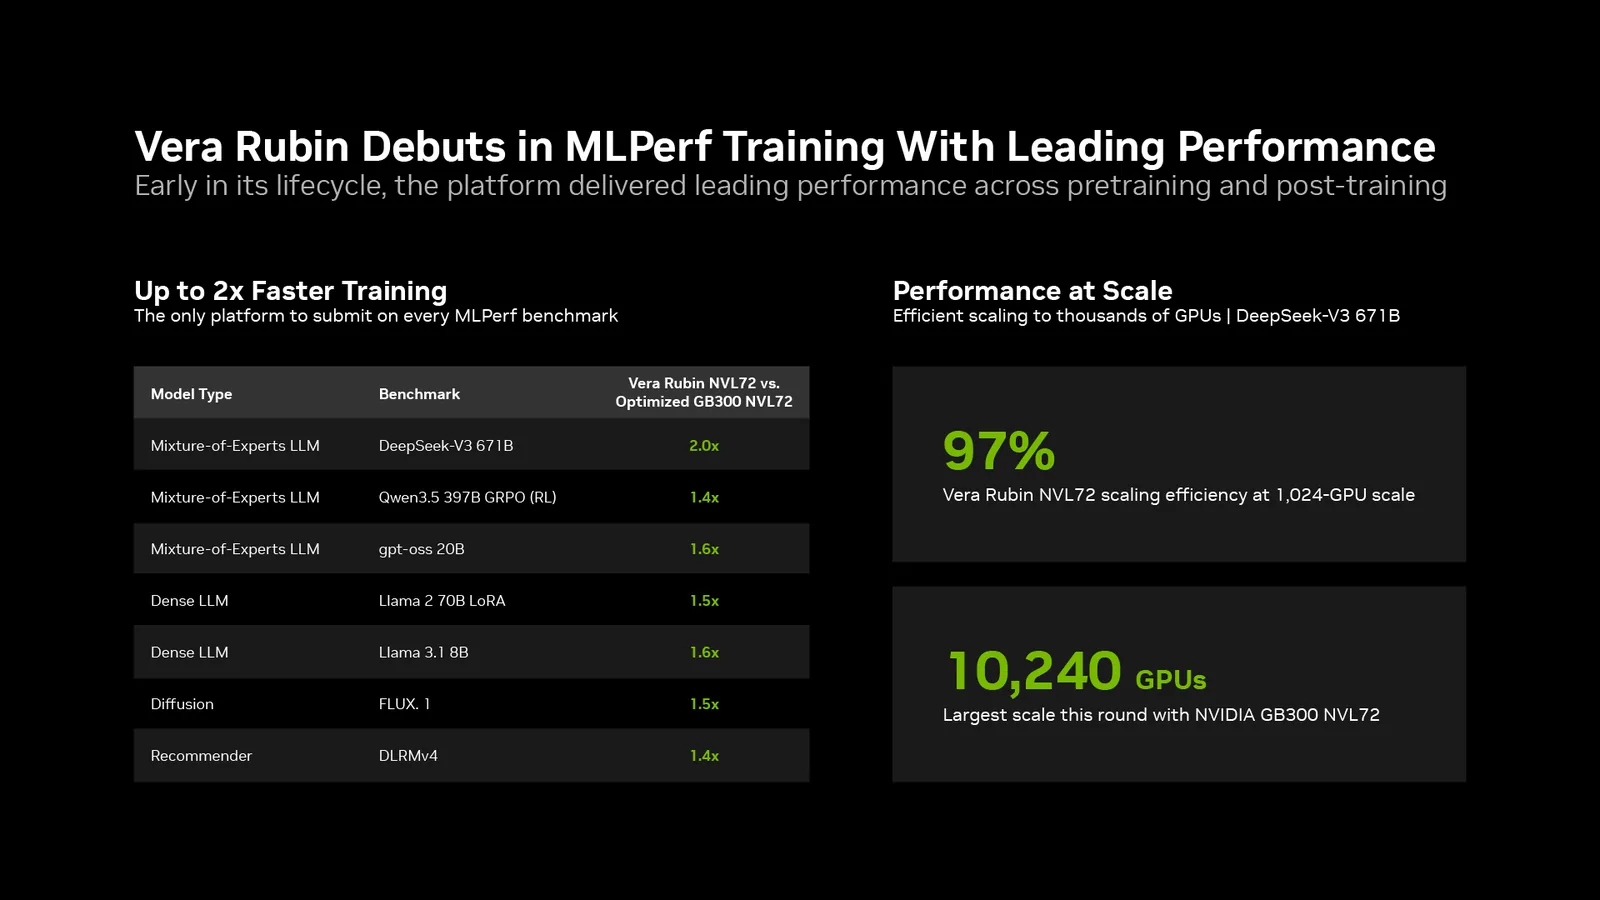
Nvidia fue la única plataforma con resultados en todos los benchmarks de esta ronda, que abarcan modelos de lenguaje grandes, generación de imágenes, sistemas de recomendación y postentrenamiento con aprendizaje por refuerzo. En su debut, el sistema Vera Rubin NVL72 rindió hasta 2 veces más por GPU que el NVIDIA GB300 NVL72.
¿Cómo escala con miles de GPU?
En el benchmark de DeepSeek-V3, Vera Rubin NVL72 pasó de 256 a 1.024 GPU con una eficiencia cercana al 97%. Cuadruplicar las GPU bajó el tiempo de entrenamiento de 16 minutos a unos cuatro.
Nvidia también corrió ese benchmark en 10.240 GPU con sistemas GB300, la mayor escala de la ronda. Microsoft Azure igualó esa cifra con 10.240 GPU de Nvidia en sistemas GB200.
Sumar GPU solo acelera el entrenamiento si trabajan bien coordinadas. Dentro de cada sistema, la red NVLink conecta las GPU para que funcionen como una sola. Entre sistemas, las redes NVIDIA Quantum-X800 InfiniBand y Spectrum-X Ethernet unen los equipos de todo el centro de datos.
¿Qué mide MLPerf Endpoints?
Un agente de viajes que planifica y reserva un viaje completo, o uno de TI que encuentra y arregla una falla antes de que alguien abra un ticket, puede razonar, llamar herramientas y revisar su trabajo muchas veces para terminar una sola tarea. Cada uno de esos pasos genera tokens.
Los centros de datos de IA están limitados por la energía disponible. Por eso, mientras más tokens por segundo genere un sistema por cada watt, más agentes puede atender.
MLPerf Endpoints prueba los sistemas con flujos reales de programación agéntica y de trabajo empresarial, y comprueba que los agentes terminen bien sus tareas. Según Nvidia, Vera Rubin lidera en todos sus benchmarks agénticos.
En un resultado provisorio con Kimi K3, un modelo abierto grande hecho para flujos agénticos, los sistemas Vera Rubin NVL72 entregaron más de 10 veces el rendimiento por watt del GB300 NVL72 a la misma velocidad de respuesta.
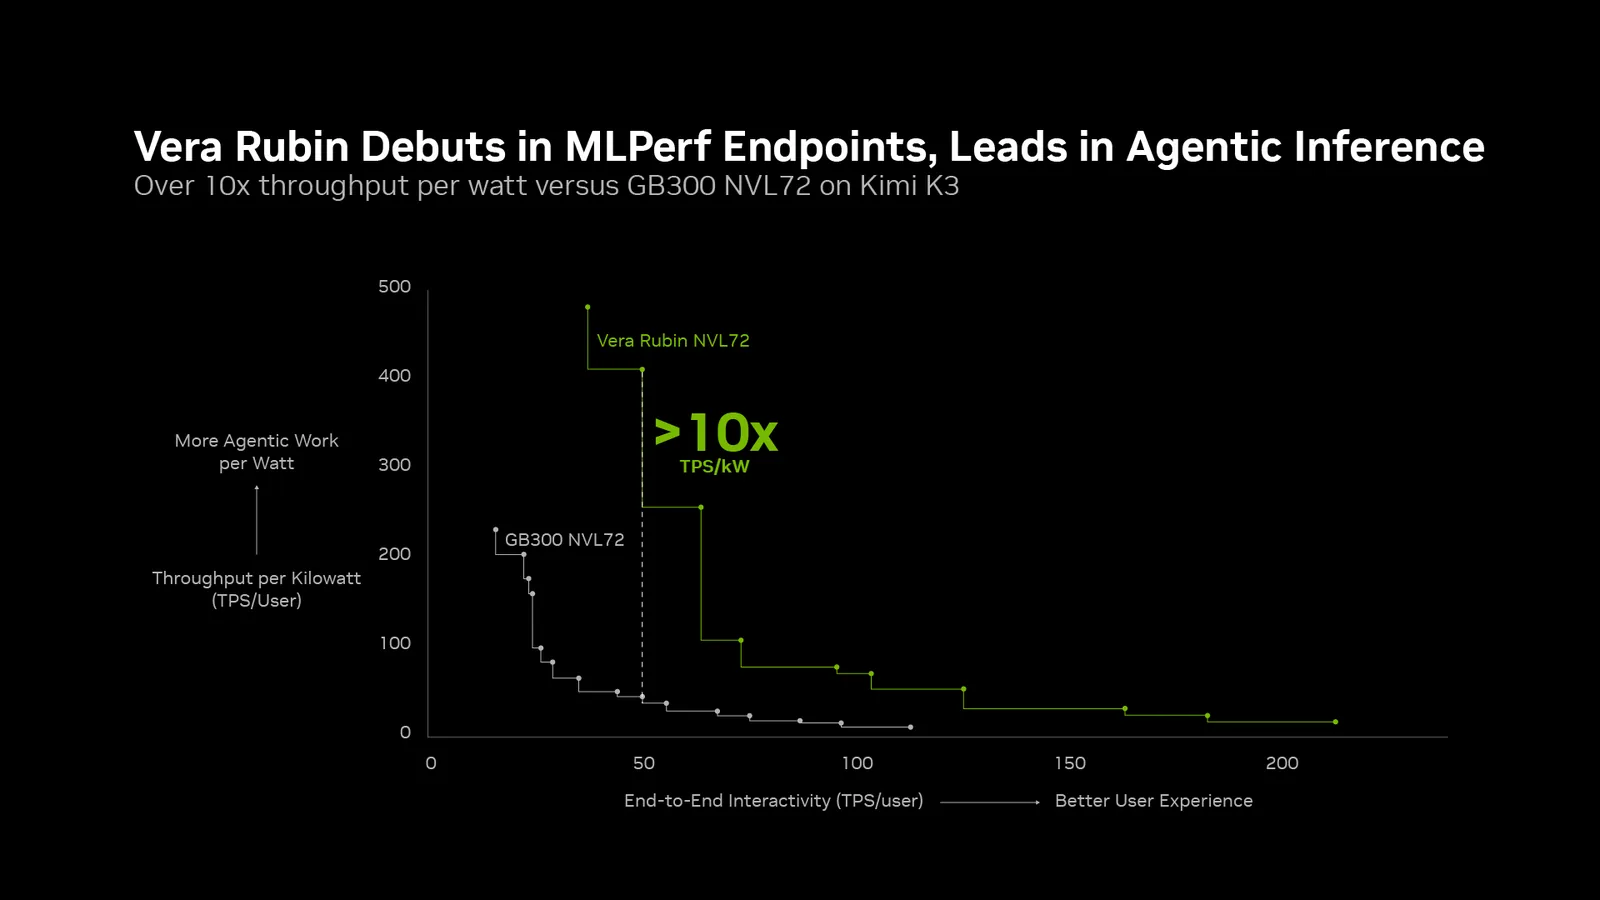
Todo servicio de IA tiene que equilibrar cuántos usuarios atiende a la vez contra qué tan rápido le responde a cada uno. Nvidia afirma que Vera Rubin desplaza esa curva completa, con más usuarios atendidos y respuestas más rápidas.
Socios y otros benchmarks
En MLPerf Training participaron 20 organizaciones con sistemas de Nvidia, entre ellas ASUS, Azure, Cisco, CoreWeave, Crusoe, Dell Technologies, Firmus, Giga Computing, Google Cloud, HPE, Inventec, Krai, Lambda, Nebius, Oracle, Quanta Cloud Technology (QCT), Supermicro, TTA y la Universidad de Florida.
Nvidia también reporta resultados de punta para Vera Rubin en benchmarks independientes como SemiAnalysis AgentX y Artificial Analysis AgentPerf.
El detalle técnico está en los blogs de MLPerf Training y MLPerf Endpoints de Nvidia.