NVIDIA lanzó CUDA 13.5 el 4 de noviembre, según su blog para desarrolladores. El cambio de mayor peso es que el soporte para NVIDIA Vera Rubin deja el acceso anticipado para desarrolladores y pasa a disponibilidad general (GA), listo para producción en empresas.
El soporte para Windows on Arm, disponible en GA desde CUDA 13.4, ahora se extiende a NVIDIA DGX Station para Windows.
La versión también da más control sobre cómo se programa el trabajo en la GPU, mediante dominios de localidad y NVIDIA Multi-Process Service (MPS). Y trae cambios en bibliotecas, compiladores, NVIDIA CUDA Tile y herramientas de desarrollo.
Dominios de localidad
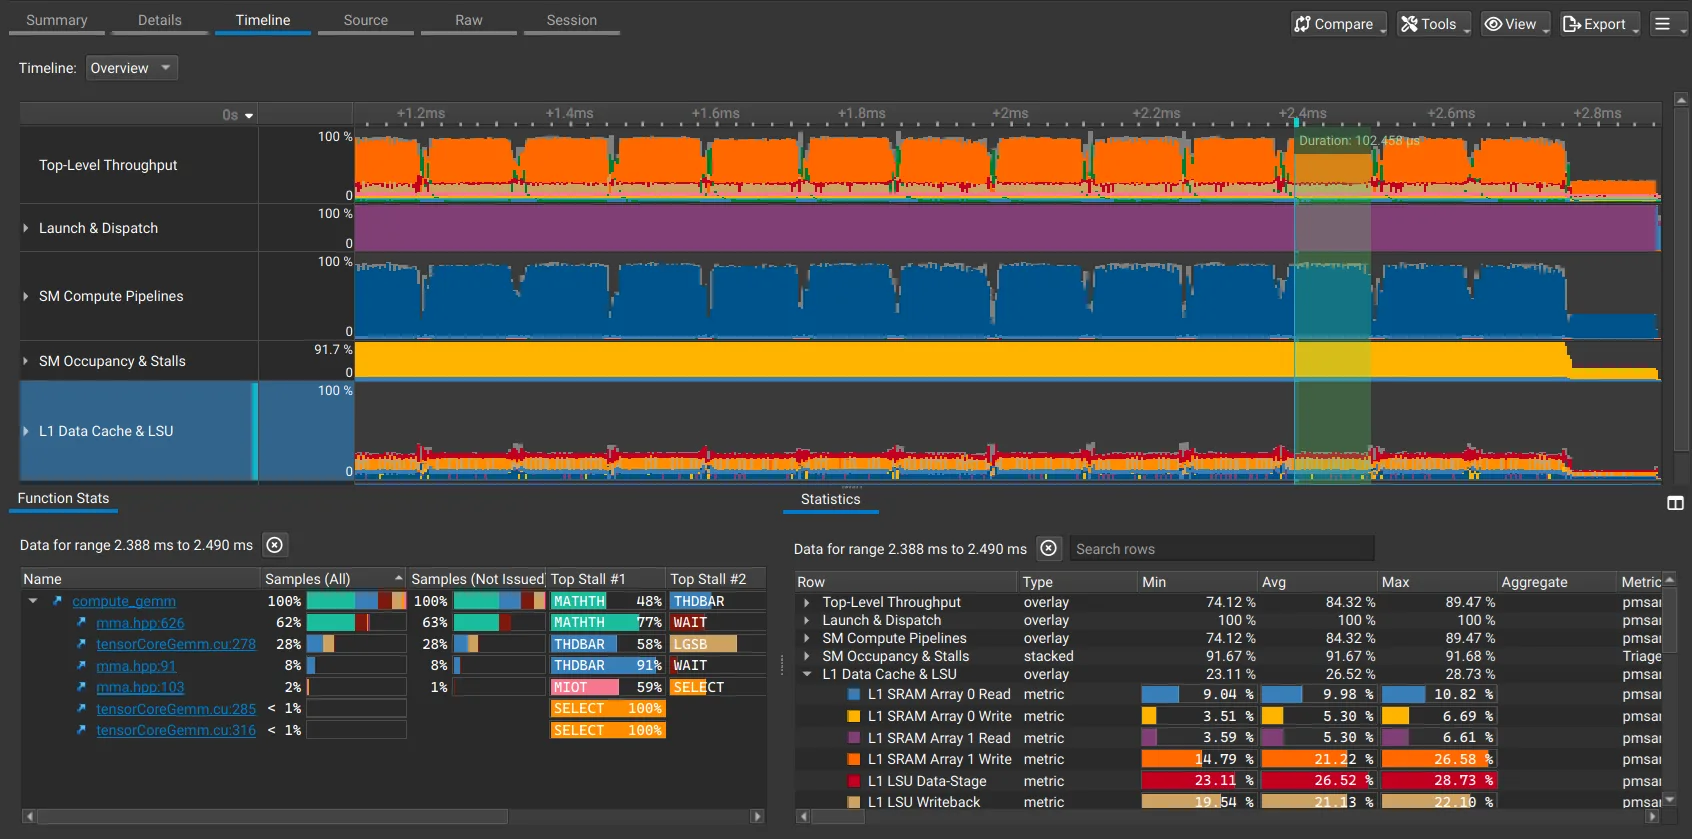
CUDA 13.5 permite elegir entre particiones uniformes de multiprocesadores de streaming (SM) en cada dominio de localidad o particiones que incluyan todos los SM disponibles. Por defecto, las particiones localizadas de green context usan la misma cantidad garantizada de SM por dominio, y los SM sobrantes quedan fuera.
El nuevo flag cudaDevSmResourceGroupLocalityDomainSupplementalSms, combinado con cudaDevSmResourceGroupLocalityDomainId, mete esos SM adicionales dentro de cada dominio seleccionado. Así una aplicación puede usar todos los SM del dispositivo al particionar por dominios, aunque las particiones resultantes queden de tamaños distintos.
Con el modo de descubrimiento de la API cudaDevSmResourceSplit(), la aplicación obtiene la cantidad de SM de cada partición y reparte el trabajo en consecuencia. La decisión queda entre la previsibilidad de un tamaño uniforme por dominio o el máximo de SM por dominio para aprovechar todo el hardware. El detalle está en la documentación de CUDA Runtime API.
¿Qué cambia en MPS v3?
MPS v3 da más control sobre cómo varias cargas comparten una GPU, desde la programación de servidores individuales hasta la asignación de recursos a grupos de clientes.
- Reparto ponderado del tiempo. El weighted timeslicing da turnos de cómputo más largos a los servidores que los necesitan. Se fija un turno base, se escala por servidor MPS y se ajusta por separado qué tan seguido la GPU cambia entre cargas.
- Balanceo de particiones de SM. Con el SM partition load balancing una carga puede usar capacidad más allá de su partición base cuando hay recursos libres. El préstamo se activa con
--max-chunks, y con--shareable=trueuna partición sin clientes conectados presta sus SM. Las dos opciones son independientes. MPS recupera lo prestado antes de reasignarlo, y la aplicación sigue viendo un tamaño de partición base estable. - Enrutamiento por cgroups. El cgroup-based routing asocia un subárbol de cgroup v2 a un espacio de nombres de MPS, y los clientes que se conectan por el socket principal del daemon quedan enrutados ahí automáticamente.
- Particiones por espacio de nombres. Con las asignaciones de partición por namespace se elige la partición de cada dispositivo una vez y se aplica a todos los clientes de ese espacio. Ya no hace falta configurar
CUDA_MPS_SM_PARTITIONcliente por cliente. La asignación del namespace tiene prioridad, y los dispositivos sin asignación mantienen la variable de entorno como respaldo. - Contabilidad de memoria por sondeo. La contabilidad por polling sirve de respaldo cuando las notificaciones de umbral de cgroup faltan o fallan. Al decidir un desalojo, MPS lee el uso y los límites actuales en vez de confiar en el estado guardado. Se fuerza con
nvidia-cuda-mps-control memacct set force_polling=trueantes de que arranque la contabilidad. Suma trabajo por cada decisión, pero ya no depende de que lleguen las notificaciones.
Copias en lote dentro de CUDA Graphs
CUDA 13.5 agrega soporte en CUDA Graph para copias de memoria 1D en lote. Las llamadas existentes a cudaMemcpyBatchAsync se pueden incluir en la captura de un stream sin cambiar su sintaxis, de modo que varias transferencias quedan grabadas y se repiten dentro de un grafo reutilizable. También se pueden agregar nodos de copia en lote de forma explícita y actualizar direcciones y tamaños compatibles sin cambiar la estructura del lote.
Modos de driver en Windows con Rubin
Desde la arquitectura Rubin, CUDA admite en Windows los modelos de driver WDDM y MCDM, este último solo para cómputo. TCC deja de estar soportado en Rubin y en las GPU posteriores. Las aplicaciones y herramientas de despliegue que asumen el modo TCC deben pasar a WDDM o MCDM.
¿Qué trae CUDA Tile?
CUDA 13.5 permite comunicación entre varias GPU directamente dentro de los kernels de CUDA Tile. Los punteros unicast dan acceso a la memoria de otra GPU conectada por NVLink. Los punteros multicast y las operaciones multimem dedicadas permiten reducciones y escrituras en varias GPU sobre redes NVSwitch con soporte NVLink SHARP. La aplicación prepara los mapeos de memoria compartida antes del lanzamiento y combina comunicación y cómputo dentro del kernel, lo que habilita multiplicaciones de matrices fusionadas y reducciones entre GPU.
La otra novedad, en vista previa pública, es la interoperabilidad entre Tile y SIMT. Hasta ahora el código Tile y el de bibliotecas SIMT solo se combinaban entre kernels distintos, con los datos pasando por la memoria global. Con esta vista previa, un kernel escrito en cuTile Python o CUDA Tile C++ puede llamar funciones de dispositivo de bibliotecas SIMT en medio de su código, sobre datos que ya están en registros o en memoria compartida. Las bibliotecas incluidas son NVSHMEM, CCCL Coop, Warp y MathDx, que agrupa cuFFTDx, cuBLASDx, cuSolverDx y nvCOMPDx. Según NVIDIA, cada biblioteca habilitará este soporte pronto.
Una biblioteca tile (.tilelib) empaqueta la interfaz y la implementación de las funciones SIMT. El compilador reparte cada tile entre hilos como la biblioteca espera, comunica los requisitos de memoria compartida y sincronización, y produce un solo kernel. En C++ la vista previa se activa compilando con nvcc --tile-preview simt y pasando el tilelib al compilador tile. En cuTile Python se usa cuda.tile_preview.foreign_call, del paquete cuda.tile_preview.
En la versión 13.5 la interoperabilidad cubre solo funciones de bibliotecas. Llamar funciones __device__ propias desde código tile queda para una versión futura, según la documentación.
CUDA Python
La biblioteca central cuda.core 1.2 incorpora copias de memoria en lote, Programmatic Dependent Launch (PDL), compilación en tiempo de ejecución más simple y actualizaciones más flexibles de CUDA Graph.
La nueva función cuda.core.utils.copy_batch() envía varias copias de búferes en una sola llamada al driver. CopyOptions controla el orden de acceso a la fuente, las pistas de ubicación de memoria y el comportamiento ante solapamientos. Este ejemplo envía dos copias independientes.
from cuda.core.utils import copy_batch

# Each source and destination pair must have matching sizes.
# Copies within the batch must not alias.
copy_batch(
    stream,
    srcs=[src_a, src_b],
    dsts=[dst_a, dst_b],
)

stream.sync()
LaunchConfig ahora expone PDL con la opción programmatic_stream_serialization. En GPU con capacidad de cómputo 9.0 o superior, kernels que cooperan pueden solapar su ejecución en el mismo stream, y un kernel dependiente empieza su trabajo independiente antes de que termine el anterior. El detalle está en la documentación de LaunchConfig.
from cuda.core import LaunchConfig, launch

config = LaunchConfig(
    grid=num_blocks,
    block=256,
    programmatic_stream_serialization=True,
)

# The kernel must implement the PDL synchronization protocol.
launch(stream, config, dependent_kernel, *kernel_args)
Las aplicaciones también pueden actualizar nodos de la definición de un grafo antes de instanciarlo y modificar nodos de un grafo ejecutable mediante vistas graph[node], sin volver a instanciarlo. Se pueden actualizar parámetros de kernel, copias de memoria, asignaciones de memoria, grafos hijos, eventos y callbacks del host.
from cuda.core import LaunchConfig
from cuda.core.graph import GraphDefinition

# Define a graph with one kernel node.
graph_def = GraphDefinition()
node = graph_def.launch(
    LaunchConfig(grid=1, block=256),
    kernel,
    output_a,
)

# Instantiate once and run with the original output buffer.
graph = graph_def.instantiate()
graph.launch(stream)
stream.sync()

# Update the executable node's arguments without reinstantiating.
graph[node].update(args=(output_b,))

# The same graph now launches the kernel with output_b.
graph.launch(stream)
stream.sync()
CCCL 3.5
El CUDA Toolkit 13.5 incluye CCCL 3.5, con APIs públicas de ajuste para CUB, escaneos de punto flotante reproducibles, una nueva selección Top-K en lote y reducciones que leen el tamaño del problema directamente desde la memoria de la GPU.
Las nuevas políticas públicas de ajuste para los algoritmos de CUB a nivel de dispositivo permiten configurar hilos por bloque, elementos por hilo, vectorización y selección de algoritmo mediante cuda::execution::tune(...) dentro de un entorno de ejecución.