Google DeepMind lanzó Gemini 4 Neon el 18 de noviembre de 2026. La compañía lo describe como un modelo con inteligencia de nivel frontera y ejecución rápida de tareas completas en ingeniería de software, trabajo de oficina y flujos científicos.
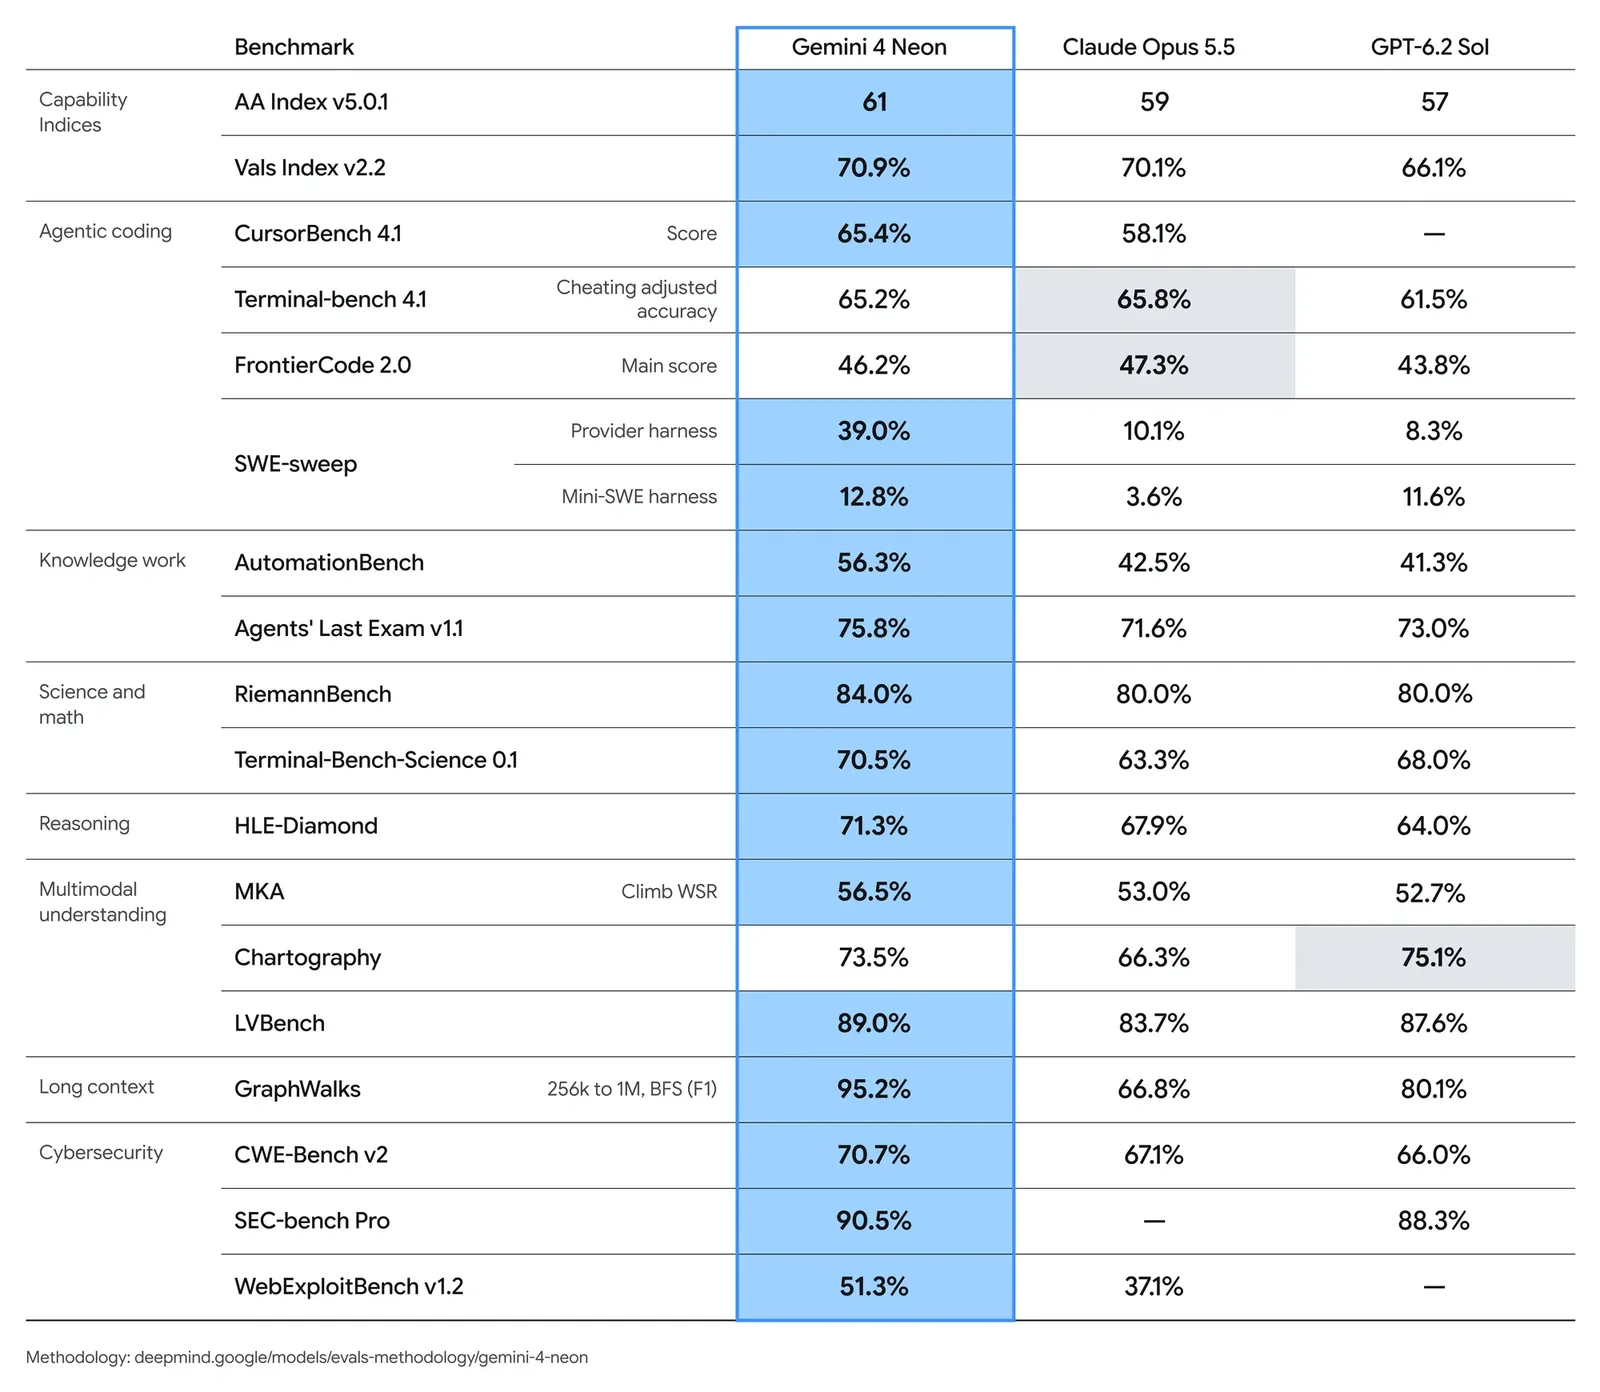
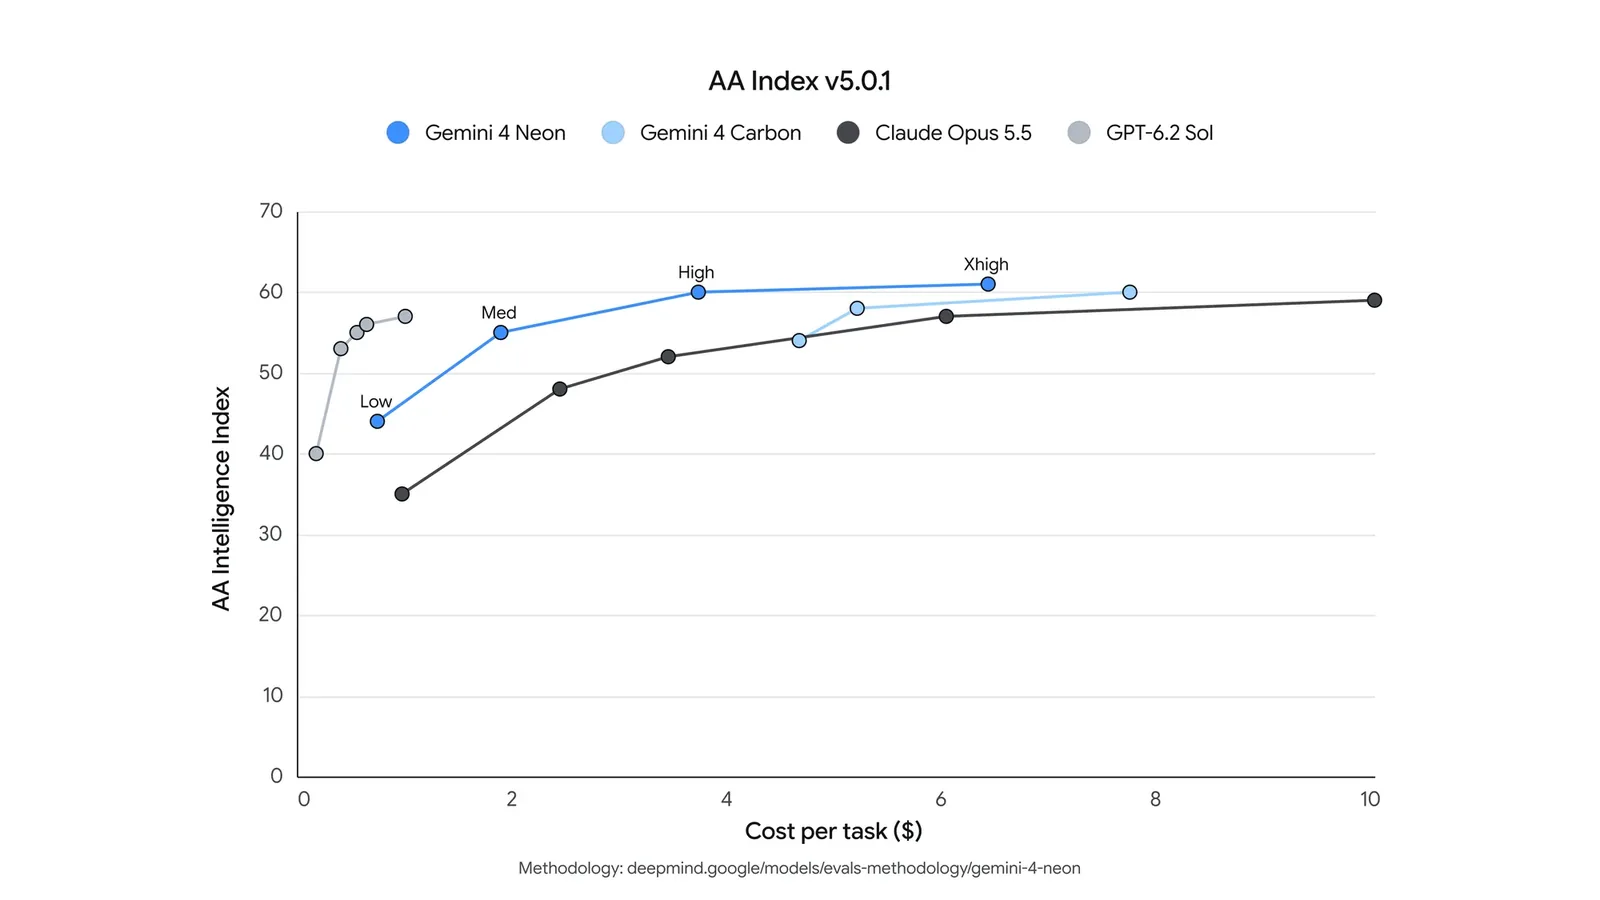
En el Artificial Analysis Intelligence Index, Neon marca 61 puntos en su nivel de razonamiento xhigh y queda tercero en la tabla general, detrás de modelos más grandes y más lentos. En el Vals Index ocupa el segundo lugar y queda sobre la frontera de Pareto, la curva que marca la mejor relación entre rendimiento y costo. Google también lo ubica segundo en capacidad de corrección a mitad de tarea (que el modelo se ajuste limpio cuando el usuario cambia una instrucción en medio del trabajo) en el nuevo Agent Arena Index. Según la empresa, Neon registró además su tasa de fabricación de datos más baja hasta ahora en las pruebas internas de Google Antigravity.
El precio es de 3 dólares por millón de tokens de entrada (0,15 dólares por millón de tokens de entrada en caché, un descuento de 95%) y 15 dólares por millón de tokens de salida, con una ventana de contexto de un millón de tokens.
Gemini 4 Neon empezó a llegar el mismo día a la API de Gemini en Google AI Studio, a Gemini para empresas (por API y en el selector de modelos), a los suscriptores pagados de Google AI Pro y Ultra en Google Antigravity y a los suscriptores Pro y Ultra de la app de Gemini.
¿Qué tan bien rinde en trabajo de oficina y ciencia?
El trabajo de una empresa vive en planillas, PDF, gráficos, audio y video. Neon puede cruzar todas esas entradas dentro de su contexto de un millón de tokens y convertirlas en entregables con estructura. En el Vals Index marca 70,9% y queda segundo, y llega al primer puesto tanto en Legal Research Bench como en Tax Agent Bench, dos pruebas de investigación legal y de tareas tributarias.
En las evaluaciones de Surge AI, Neon queda primero en la mayoría de las pruebas de finanzas, contabilidad, modelamiento en planillas y seguimiento de restricciones complejas. Marca 73,5% en Chartography, que mide la lectura de gráficos profesionales densos, y rinde a la par de los modelos líderes en Agents' Last Exam v1.1, con 75,8%.
También queda primero en dos pruebas de agentes de largo aliento. En AutomationBench de Zapier saca 56,3%, y en Vending-Bench 2 de Andon Labs, una simulación larga en la que el modelo administra un negocio, termina con 16.843 dólares. En el nuevo Agent Arena Index debuta segundo a nivel mundial con 1.336 puntos, medidos sobre más de 4.200 sesiones reales de agentes.
En razonamiento científico y matemático (análisis cuantitativo, matemáticas y problemas de investigación técnica), Google lo declara el mejor de su clase en Terminal-Bench Science con 70,5%, en RiemannBench con 84,0% y en HLE-Diamond con 71,3%.
| Prueba | Resultado de Neon | Posición según Google |
|---|---|---|
| Artificial Analysis Intelligence Index (xhigh) | 61 | 3° general |
| Vals Index | 70,9% | 2° |
| Agent Arena Index | 1.336 | 2° |
| AutomationBench de Zapier | 56,3% | 1° |
| Vending-Bench 2 | 16.843 dólares | 1° |
| RiemannBench | 84,0% | mejor de su clase |
| HLE-Diamond | 71,3% | mejor de su clase |
Pensado para código de producción
Google diseñó Neon para flujos de agentes que corren durante horas. Según la empresa, sostiene el rendimiento en tareas largas y cargadas de herramientas de principio a fin, ya sea trabajando solo o como orquestador rápido que dirige subagentes Hydrogen en paralelo dentro de Google Antigravity. Lee menos archivos de forma redundante, informa su avance mientras trabaja y maneja bien la compactación de contexto en sesiones largas.
En los flujos de desarrollo e investigación, Neon queda primero en el Coding Agent Index de Artificial Analysis con 58,6 puntos. Marca 65,2% en Terminal-Bench 4.1 y 46,2% en FrontierCode 2.0 con su nivel por defecto, high. Para código de producción, el modelo depura y refactoriza varios archivos en distintos repositorios con ediciones acotadas. En SWE-sweep ya lidera con el arnés mini-SWE (12,8%) y en Google Antigravity más que triplica ese resultado hasta 39,0%, que Google presenta como el mejor registro de la prueba.
Google mostró cuatro demostraciones hechas con el modelo dentro de Antigravity.
- Controlando Blender por MCP, Neon usó el comando /swarm para armar un mesón de laboratorio fotorrealista en 3D con los nombres de los modelos. Gemini 4 Carbon y Gemini 4 Hydrogen aparecen como llamas de mechero Bunsen, y Gemini 4 Argon y Neon como tubos de descarga de gas de alto voltaje.
- Escribió desde cero un simulador de esquí fuera de pista en primera persona con WebGL2, sobre el relieve real del Mont Blanc y Chamonix. Suma 10.200 líneas de shaders propios, física de esquí a 120 Hz en seis líneas de descenso, huellas que se marcan en la nieve, avalanchas de placa y audio espacial con Web Audio, sin un solo recurso prefabricado.
- Con /swarm, buscó fotos de archivo para recrear en 3D interactivo el estudio de Alan Turing de 1936 en el King's College de Cambridge, desde la capilla del King's por fuera hasta la sala X.8 por dentro, con una Máquina de Turing Universal funcionando sobre el escritorio.
- Un enjambre de agentes Neon convirtió una sola imagen en una Google Sheet de 100.000 celdas sin imágenes incrustadas ni Apps Script. Usa más de 500.000 fórmulas vivas para detectar bordes, mapear la profundidad en 3D y volver a iluminar la escena en seis modos interactivos.
¿Cuánto cuesta cada tarea según el nivel de razonamiento?
Google ajusta los niveles de razonamiento en cada lanzamiento para dar a los equipos un control más fino y un paso más gradual entre un nivel y el siguiente. Neon trae cuatro niveles que escalan de forma pareja, y cada equipo decide cuánta inteligencia y cuántos tokens gasta según la carga.
En su nivel por defecto, high, Neon combina un puntaje alto en el Intelligence Index de Artificial Analysis con un costo por tarea 32% menor que Carbon. En ese mismo nivel queda sobre la frontera de Pareto del Vals Index y de Agent Arena, con un costo por tarea entre 50% y 80% menor que el de los principales modelos de frontera de la competencia, según Google.
El nivel xhigh agrega razonamiento más profundo y de varios pasos para las cargas más difíciles de ingeniería, análisis y ciencia. Ahí Neon logra su puntaje de inteligencia más alto y, según la empresa, sigue costando al menos 36% menos por tarea que los modelos competidores en su configuración máxima.
Una versión para ciberdefensa
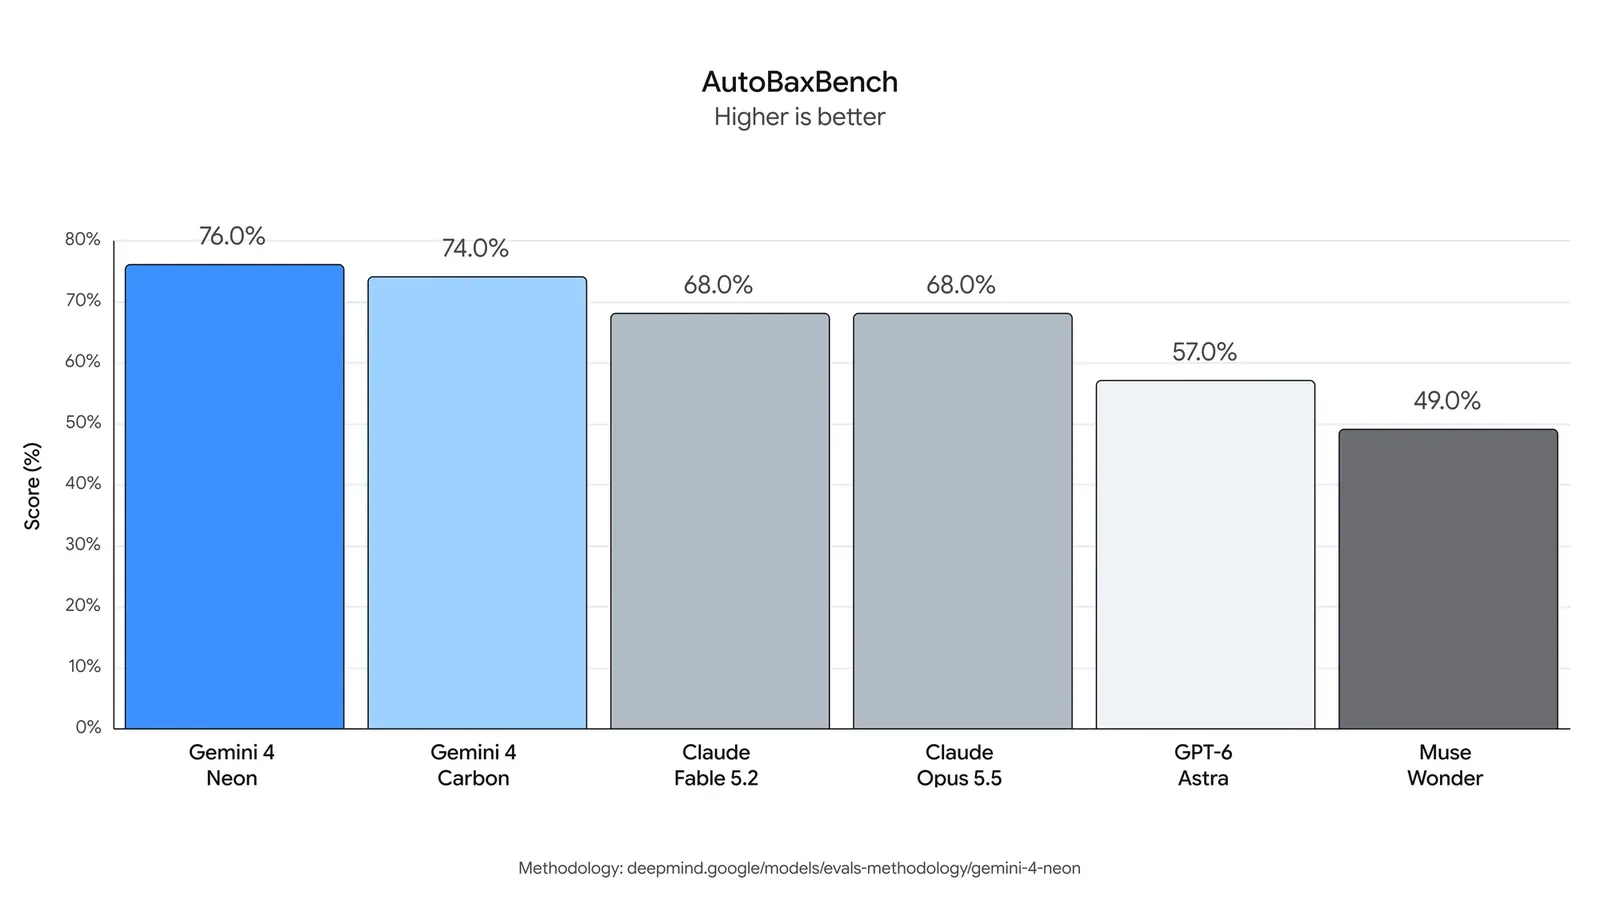
A medida que crece la programación con agentes, generar código seguro desde el comienzo se vuelve una exigencia. Según Google, Gemini 4 Neon para ciberseguridad produce código más seguro que Carbon en los desafíos fáciles, medios y difíciles de AutoBaxBench, y en el nivel difícil marca 76%, el mejor resultado registrado.
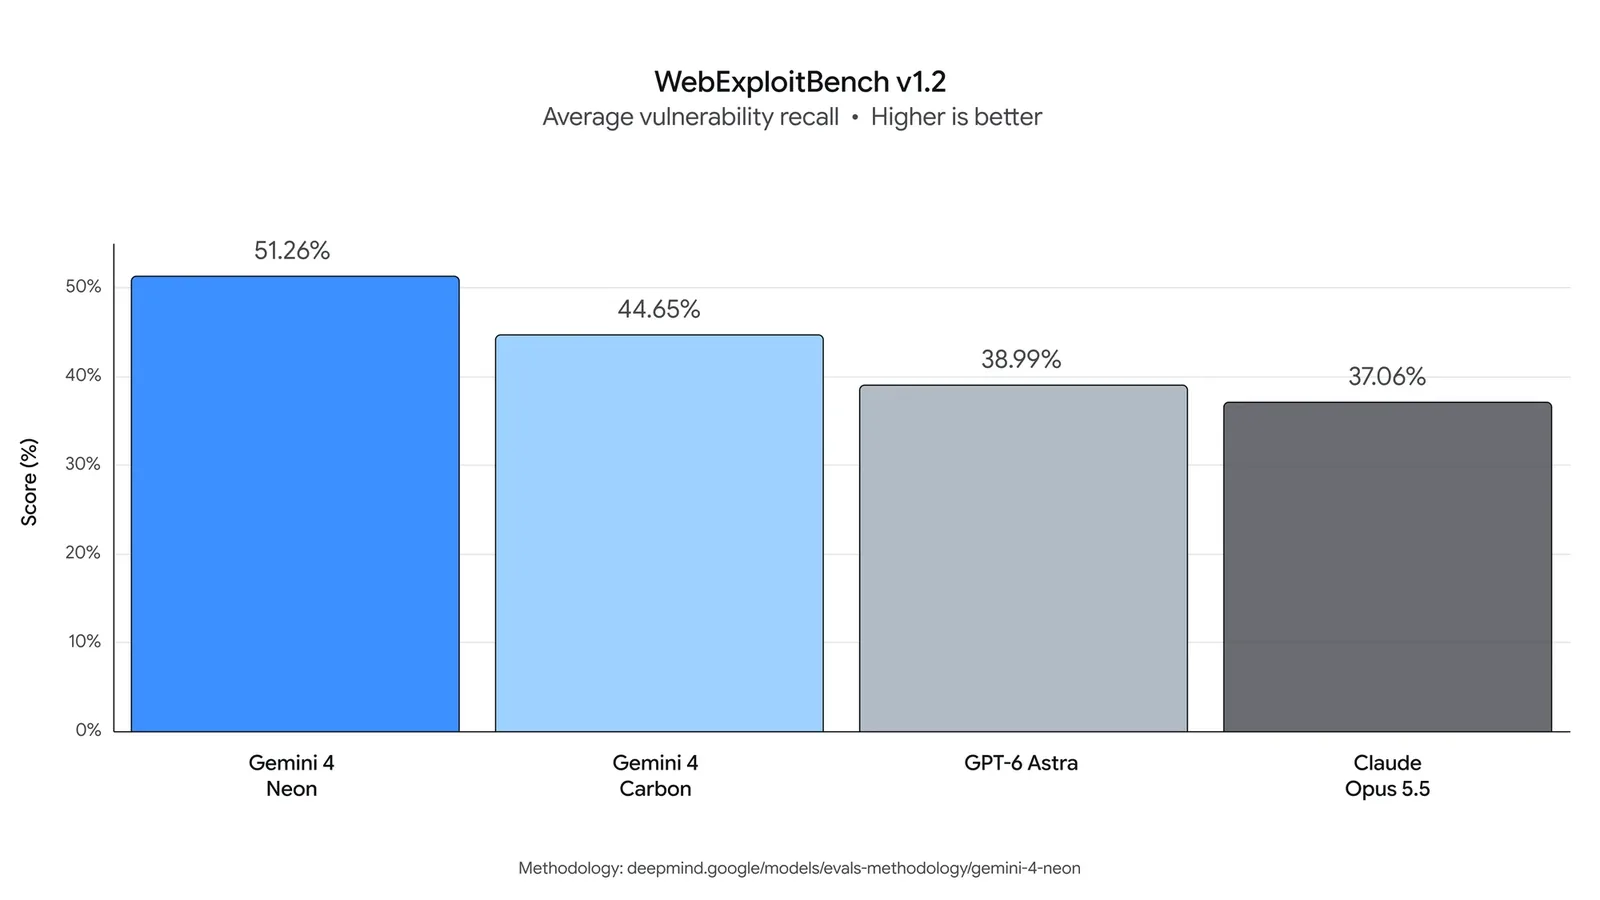
Asegurar sistemas también implica encontrar las fallas antes que los atacantes, y las pruebas de penetración son una herramienta histórica de la ciberseguridad empresarial. En WebExploitBench v1.2, Neon marca 51,26%, el mejor resultado de la prueba, a la mitad del costo de los modelos grandes de la competencia.
Para reforzar código existente, Google dice que Neon cubre todo el ciclo de endurecimiento (encontrar vulnerabilidades, validarlas y parcharlas) con más velocidad y menor costo que los modelos grandes de frontera.
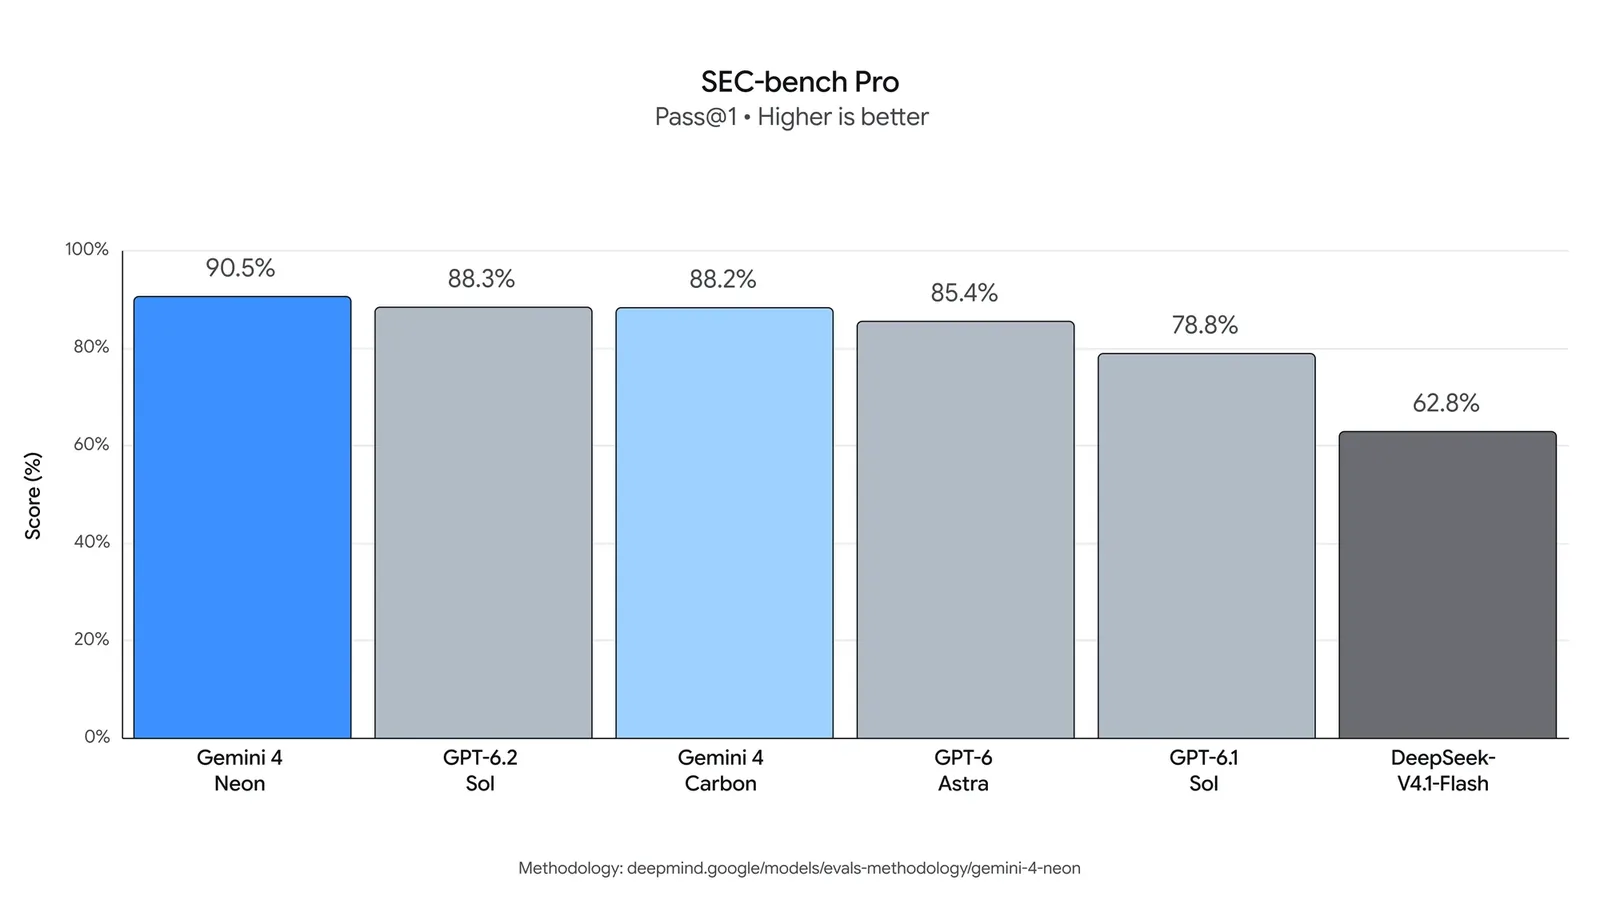
- Encontrar vulnerabilidades. Neon marca 90,5% en SEC-bench Pro, el mejor resultado de la prueba, con un costo por desafío cercano a la mitad.
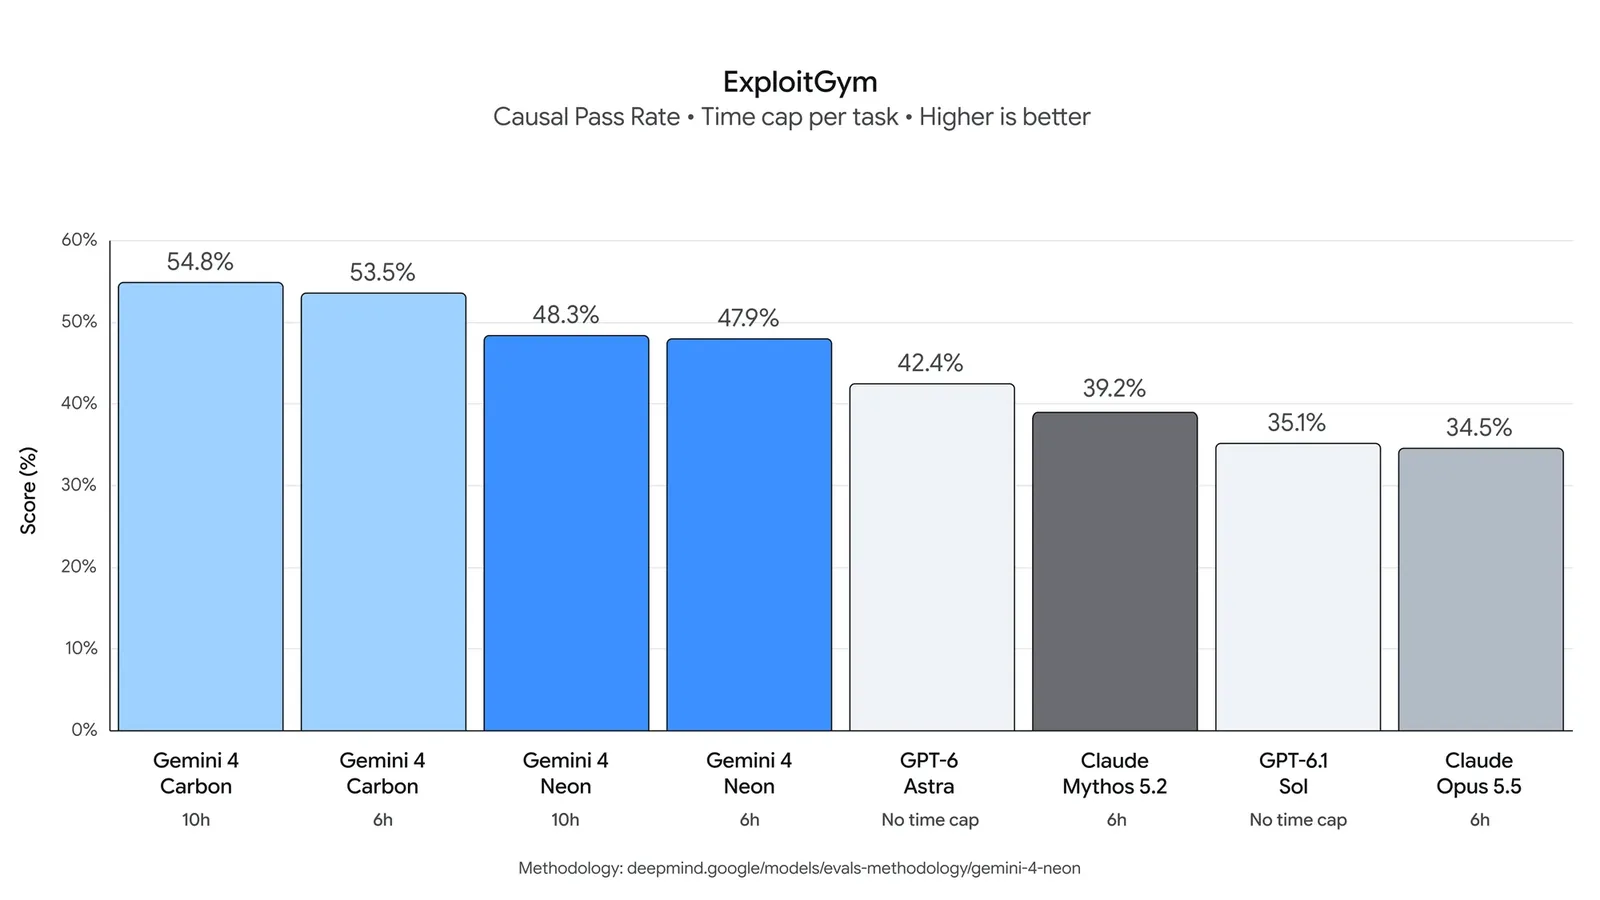
- Validar el riesgo explotándolo. Para decidir qué corregir primero, los equipos de defensa usan modelos que revisan qué fallas se pueden explotar de verdad. En ExploitGym, Neon rinde a nivel de frontera usando la mitad de los tokens que Carbon.
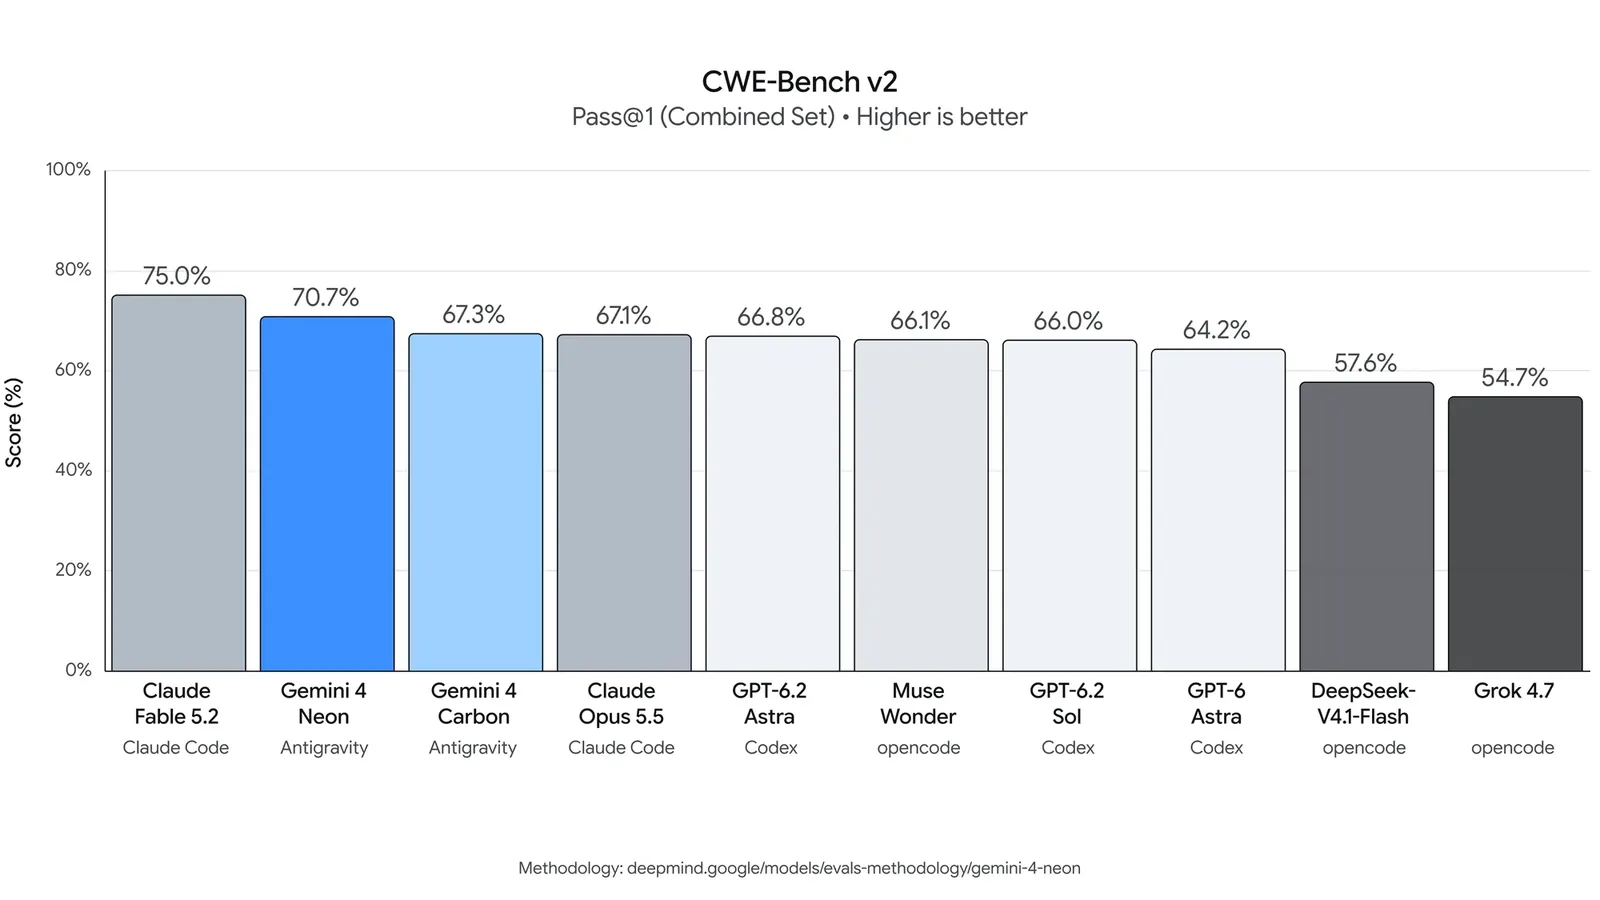
- Parchar vulnerabilidades. Corregir la causa de fondo es el último paso del ciclo. Neon llega a 70,7% en CWE-bench v2 de Collinear, 3,4 puntos más que Carbon.
La versión para ciberseguridad llegará en los próximos días a equipos de defensa de confianza, dentro del Programa Fairwind.
Salvaguardas contra el mal uso
Gemini 4 Neon se apoya en las mejoras del conjunto de seguridad de Gemini 4. Mantiene las protecciones de Gemini 4 Carbon contra el mal uso grave y la inyección de instrucciones, y Google dice que avanzó en alineamiento y en el comportamiento del modelo como agente.
Como Neon lleva capacidades de frontera a un modelo más rápido y barato, Google lo acompañó con salvaguardas en tiempo real contra el mal uso en ciberseguridad y bioseguridad, comparables a las de Carbon. Según la empresa, a la vez rechaza mucho menos trabajo legítimo en esas áreas. En Terminal-Bench 4.0 se negó a hacer apenas el 1,98% de las tareas, y en Terminal-Bench Science, el 0%.