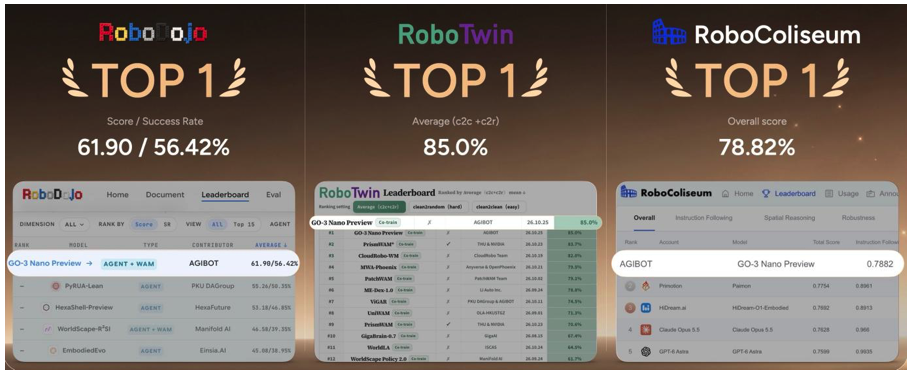
AGIBOT presentó GO-3 Preview, un modelo fundacional de IA encarnada que aprende a gran escala en todo el ciclo de vida del robot, en el preentrenamiento, en el postentrenamiento y después del despliegue. El modelo quedó primero en tres benchmarks de IA encarnada, RoboDojo, RoboTwin y RoboColiseum, y la empresa anunció que lo liberará como código abierto completo antes de fin de 2026, según informó Robotics & Automation News el 5 de noviembre.
GO-3 Preview corre sobre WRAM (World Reasoning Action Model), la arquitectura propia de AGIBOT pensada desde el inicio para robots. WRAM junta en un mismo modelo la comprensión de la tarea, la predicción de estados futuros y la generación de acciones, con el objetivo de que el robot generalice entre tareas y haga manipulación precisa.
El modelo trabaja junto a otras dos piezas de la empresa. Genie Evolver es su sistema híbrido de postentrenamiento y Genie Master es su framework de agentes encarnados. Las tres forman un sistema de aprendizaje que cubre el preentrenamiento, el postentrenamiento y el uso en el mundo real. AGIBOT le llama a este enfoque "escalamiento de ciclo de vida completo", diseñado para que los robots desarrollen capacidades generales, afinen sus habilidades al interactuar y sigan mejorando con el trabajo real.
Los modelos de lenguaje grandes avanzaron mucho en razonamiento y en tareas de conocimiento, pero trabajar en el mundo físico exige más que entender instrucciones. Tomar objetos pequeños o ensamblar componentes requiere anticipar cambios en el entorno, manejar fuerzas de contacto y ejecutar movimientos físicos precisos.
Para AGIBOT, el desafío de la IA encarnada es extender el aprendizaje a todo el ciclo de vida, además de escalar el entrenamiento del modelo. El robot tiene que aprender también en el postentrenamiento, con interacción, y seguir adaptándose después de desplegado. GO-3 Preview se diseñó con ese principio, para que el robot aprenda a hacer tareas y además mejore al hacerlas.
¿Cómo aprende GO-3 Preview en el preentrenamiento?
Una instrucción simple, como "toma la taza", esconde mucha variación. El objeto puede ser un tazón con asa o un vaso liso, y puede estar al centro de la mesa o rodeado de otras cosas. Para manejar esas variaciones el robot no puede memorizar objetos específicos ni movimientos fijos. Necesita capacidades generales que se transfieran entre tareas y entornos.
En el preentrenamiento, GO-3 Preview escala tanto los datos como las capacidades del modelo a través de WRAM, para que el robot aprenda habilidades transferibles y se adapte más rápido a situaciones que no conoce.
WRAM conecta la comprensión de la tarea, la predicción de estados futuros y la generación de acciones en una sola arquitectura. Tres diseños centrales, CoAE, SVP y KASO, trabajan juntos para que el modelo entienda qué hay que hacer, anticipe lo que puede pasar y genere las acciones necesarias para completar la tarea.
- CoAE (Control-Oriented Autoencoder) extrae representaciones visuales hechas para el control robótico, que conservan información sobre la posición, la forma y las relaciones espaciales de los objetos. Al ligar la percepción visual con la acción física, sirve de base para predecir estados futuros y generar los movimientos adecuados.
- SVP genera en un solo paso una predicción completa de los estados futuros, a partir de las observaciones actuales y de las condiciones de la tarea. El módulo de generación de acciones aprende después cómo ir del estado actual al resultado predicho. Al conectar lo que el robot observa con lo que puede pasar, SVP ayuda al modelo a anticipar cambios en vez de depender solo de la imagen del momento.
- KASO se ocupa de que en un entorno físico hay varios resultados posibles. Elige las predicciones futuras más coherentes con las acciones que de verdad se tomaron durante el entrenamiento. Esas predicciones se usan en un aprendizaje conjunto que alinea la predicción de estados futuros con la generación de acciones, para que el modelo aprenda acciones que llevan a resultados físicamente coherentes.
Sobre esos tres mecanismos, GO-3 Preview escala el aprendizaje por el lado de los datos y por el lado del modelo. En datos, aprende de fuentes heterogéneas. Los videos en primera persona grabados por humanos aportan ejemplos variados de interacción con objetos y de ejecución de tareas, y las trayectorias de robots conectan observaciones, acciones y sus resultados físicos.
En el modelo, las mejoras en capacidad de aprendizaje ayudan a ordenar esas experiencias diversas y a convertirlas en capacidades generales aplicables a tareas distintas. Según AGIBOT, el objetivo es aprovechar mejor cada experiencia frente a situaciones nuevas, más que acumular ejemplos.
Después del preentrenamiento, GO-3 Preview se adapta a tareas en modo zero-shot y few-shot. En zero-shot, aplica capacidades aprendidas a tareas nuevas sin un ajuste fino supervisado específico en robots físicos. Para operaciones más complejas, mejora con unas pocas demostraciones.
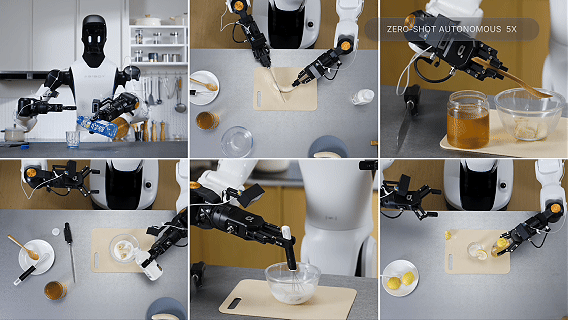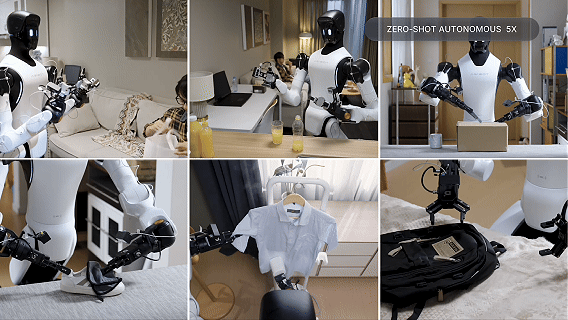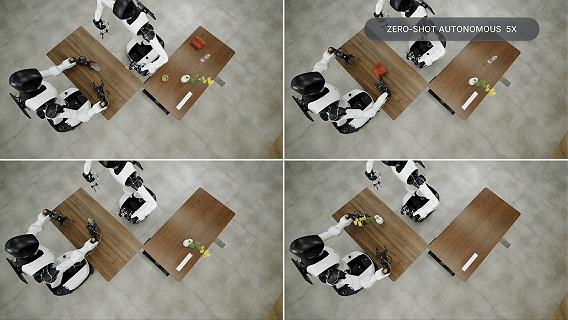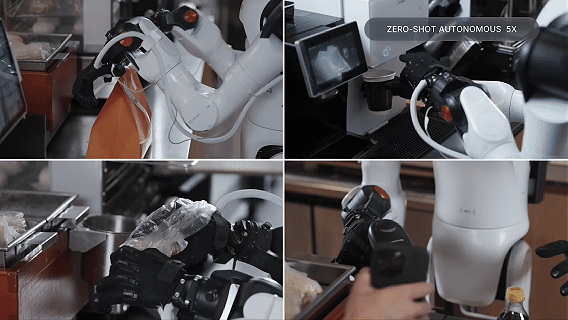
El ensamblaje de piezas LEGO es uno de los ejemplos. La tarea exige que el robot identifique cada componente, lo tome con precisión, alinee su posición y lo inserte bien. Con pocas demostraciones adicionales y algo de ajuste fino, el modelo aprende esas habilidades de manipulación precisa, mientras un agente encarnado coordina los pasos hasta completar el ensamblaje.
Postentrenamiento con robots físicos y virtuales
Las capacidades generales no alcanzan para que un robot haga bien cualquier tarea compleja. Igual que una persona afina una habilidad practicando, el robot necesita experimentar, recibir retroalimentación y mejorar sus estrategias de acción.
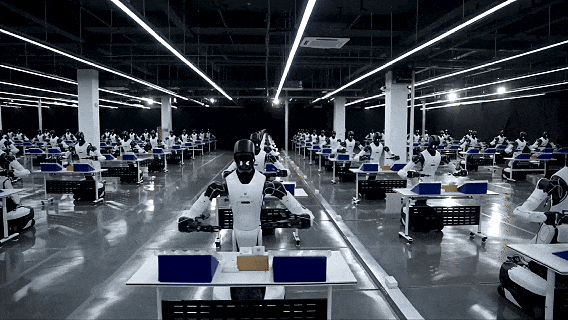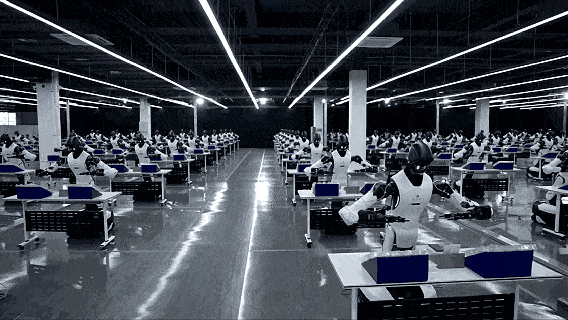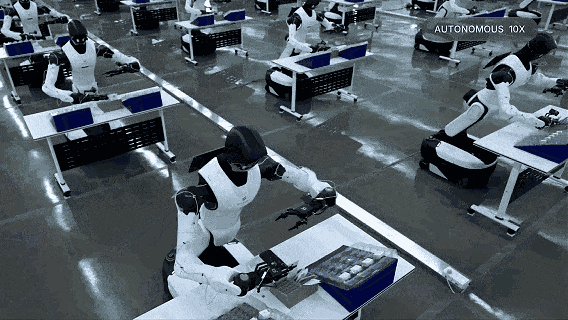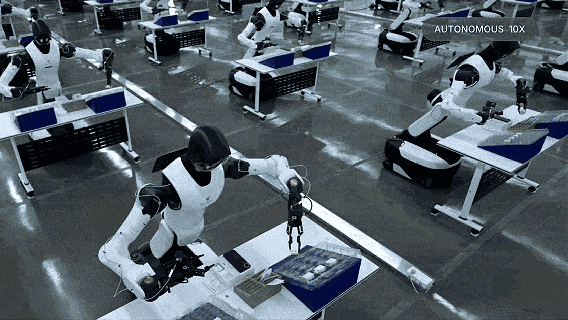
Para la etapa de postentrenamiento, AGIBOT desarrolló Genie Evolver, un sistema distribuido de entrenamiento en entornos híbridos que combina una flota de 100 robots físicos con simulación física y modelos del mundo. Al ampliar la escala y la variedad de las interacciones, el robot aprende tanto de la ejecución física como de la exploración virtual, y va ajustando sus políticas de acción con la retroalimentación. El sistema reúne tres entornos de aprendizaje.
Robots físicos que aprenden de la experiencia colectiva
En el mundo real, Genie Evolver usa CEL (Collective Experience Learning) para juntar la experiencia de ejecución de varios robots. Las trayectorias exitosas muestran acciones que funcionan, y el contexto de los intentos fallidos indica dónde hay que mejorar.
CEL recupera experiencias exitosas relevantes y actualiza estrategias compartidas, así que lo que aprende un robot le sirve a toda la flota. Cada robot ya no tiene que aprenderlo todo por su cuenta.
Simulación física para ampliar las interacciones
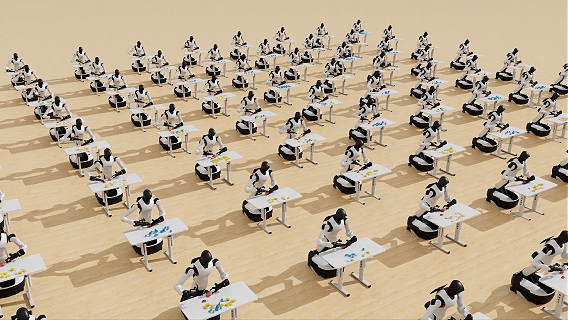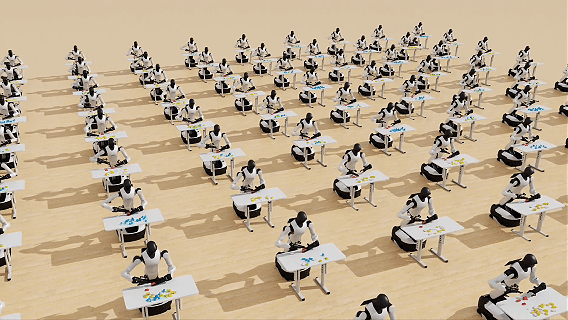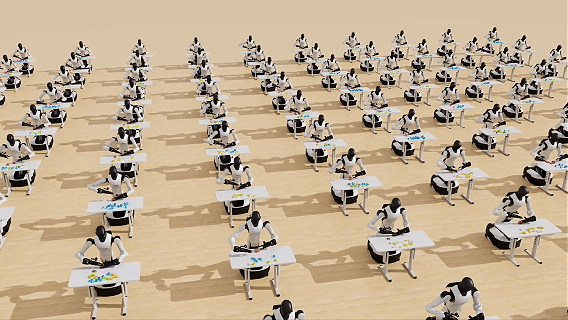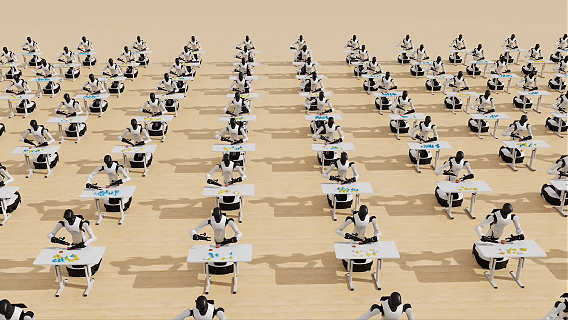
La simulación física entrega entornos controlados donde los robots practican y se evalúan en distintas condiciones. Amplía el rango de interacciones y escenarios disponibles para entrenar, y permite repetir experimentos en condiciones idénticas. Con eso se pueden probar estrategias alternativas y ganar robustez en más situaciones.
Modelos del mundo para explorar varios futuros
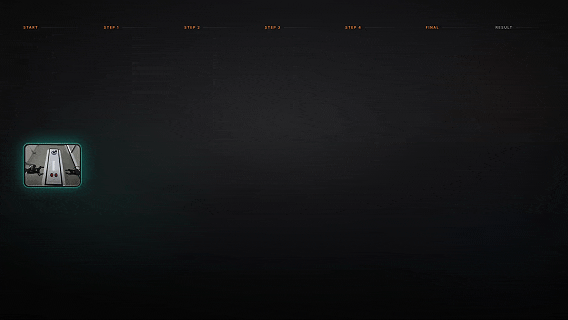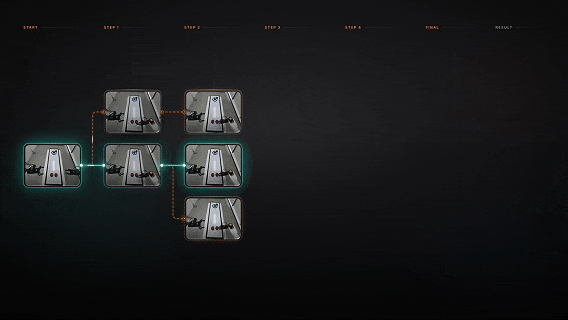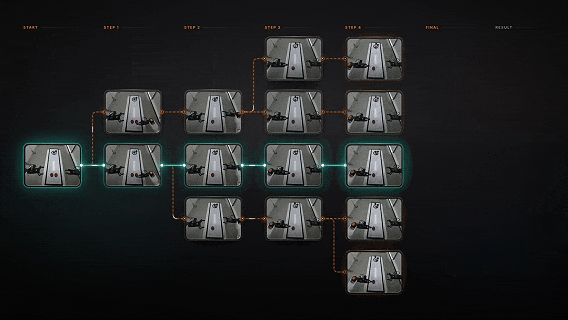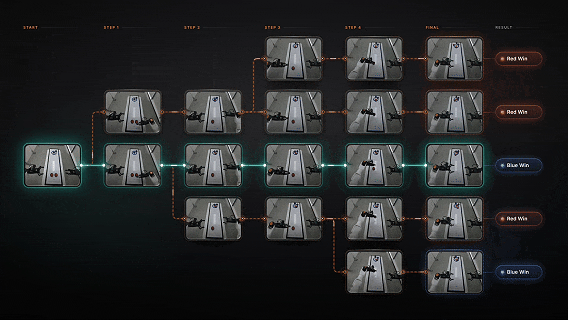
Los modelos del mundo permiten sacar más de cada experiencia real explorando resultados alternativos. En vez de tratar una interacción como una sola secuencia de acciones, Genie Evolver vuelve a los puntos de decisión críticos, prueba acciones distintas dentro del modelo del mundo y predice y compara sus resultados. Esa retroalimentación se usa para ajustar las estrategias de acción, que después se prueban en robots físicos.
Curling de mesa, bloques y lanzamientos
Los tres entornos forman un proceso de mejora continua en que la ejecución real, la simulación y la exploración de estados futuros se refuerzan entre sí. AGIBOT lo muestra con varias tareas de manipulación que exigen precisión, adaptación y decisiones rápidas.
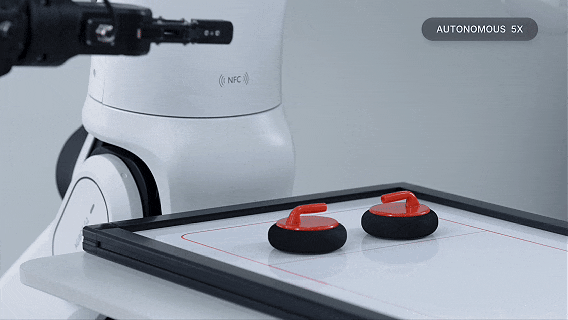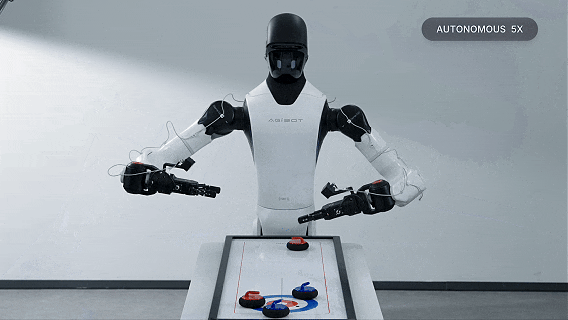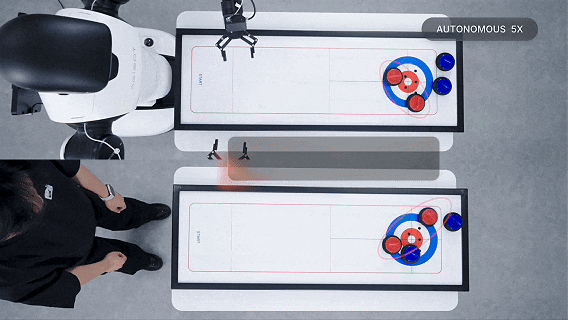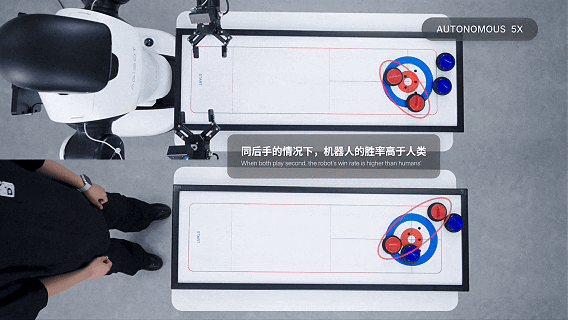
En el curling de mesa, el robot tiene que controlar la fuerza y el ángulo de cada lanzamiento. Con poca fuerza puede no mover la piedra del rival, y con demasiada puede sacar su propia piedra de la zona de puntaje. El éxito depende de dar con el equilibrio según la posición de las piedras. Según AGIBOT, tras solo unas horas de práctica que combinaron interacción real y aprendizaje con el modelo del mundo, el robot logró una tasa de victorias más alta que la de un jugador humano típico.
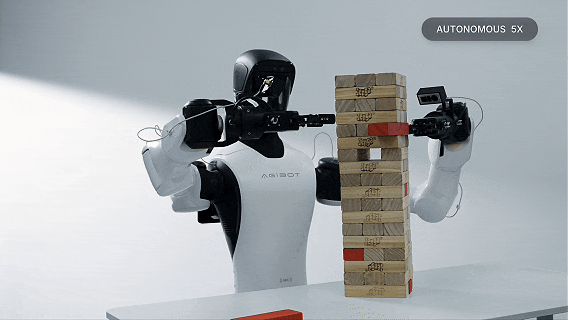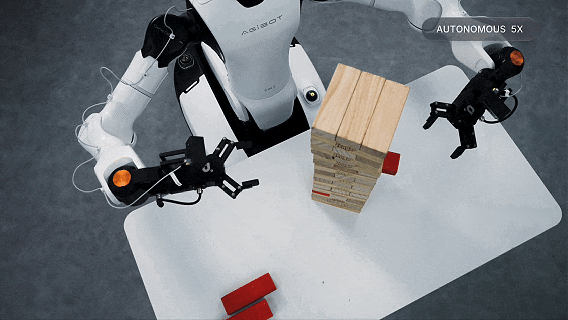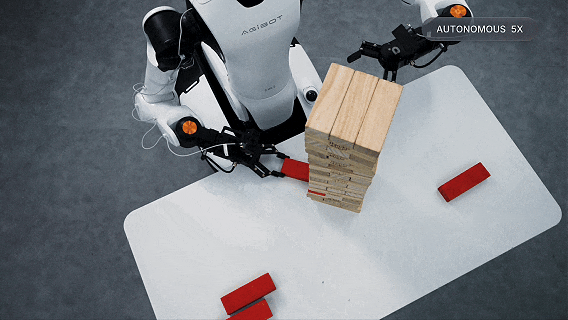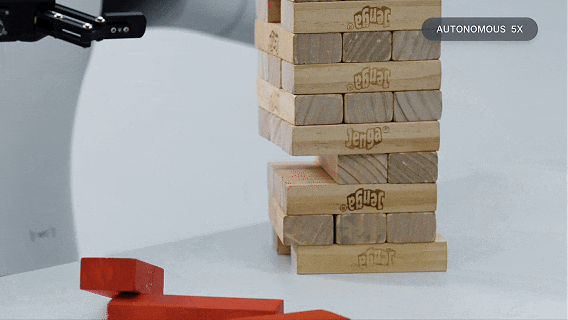
La extracción de bloques plantea otro problema, porque cada acción exitosa cambia las condiciones de la siguiente. Al sacar un bloque rojo, la posición y la orientación de los demás pueden moverse, y eso afecta las decisiones que vienen. Por eso la tarea no se puede completar con una secuencia fija de movimientos. Con la experiencia acumulada, el robot vuelve a evaluar la pila después de cada acción, ajusta su estrategia y sigue sacando los bloques objetivo hasta terminar.
Lanzar una pelota a un canasto en movimiento es la prueba más dinámica. A diferencia de un blanco fijo, el canasto que se mueve le deja al robot menos tiempo para observar, predecir y reaccionar. Tiene que ubicar rápido la posición del canasto y ajustar en tiempo real la fuerza y el ángulo del lanzamiento. Predecir bien condiciones que cambian rápido le permite coordinar sus movimientos y soltar la pelota en el momento justo.
Según AGIBOT, estas demostraciones muestran cómo GO-3 Preview mejora su manipulación con interacción repetida, retroalimentación y ajuste de estrategias.